ELECTRA: PRE-TRAINING TEXT ENCODERS AS DISCRIMINATORS RATHER THAN GENERATORS 리뷰 / 요약
Clark et al. / 2020 / ICLR
BERT와 같은 MLM(Masked Language Model)은 많은 계산을 필요로함.
Masked Token을 예측하는 것 (generate) 대신, 다른 generator에 의해 replace 된 토큰을 replace하는 구조
이 Pretrained task는 input token의 subset 이 아닌 모든 토큰들에 대해 정의 되기 때문에 MLM보다 효율적
ELECTRA
💡 **Efficiently Learning an Encoder that Classifies Token Replacements Accurately**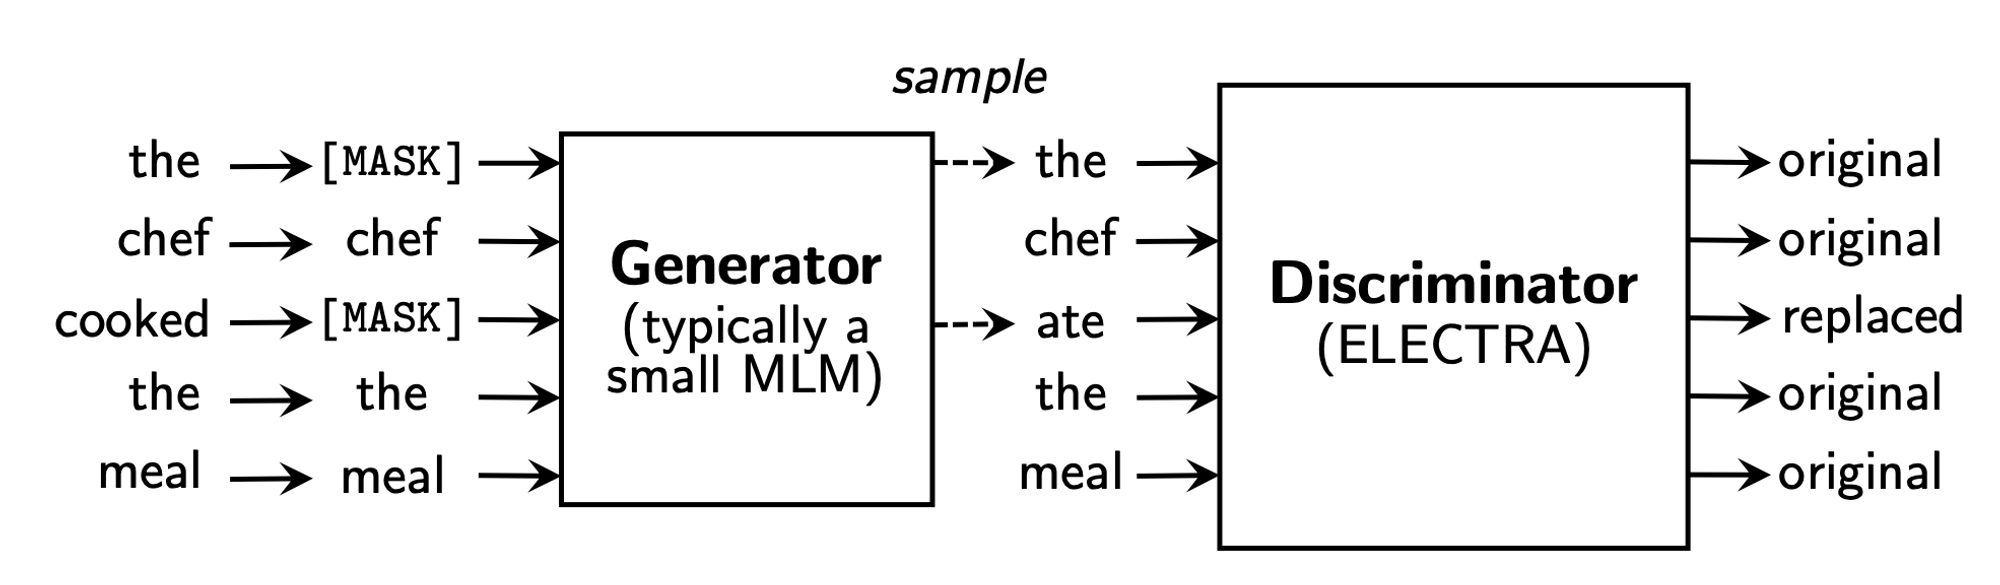
Generator는 BERT처럼 mask된 토큰을 예측하도록 학습 → Corrupted example x_corrupted를 generate
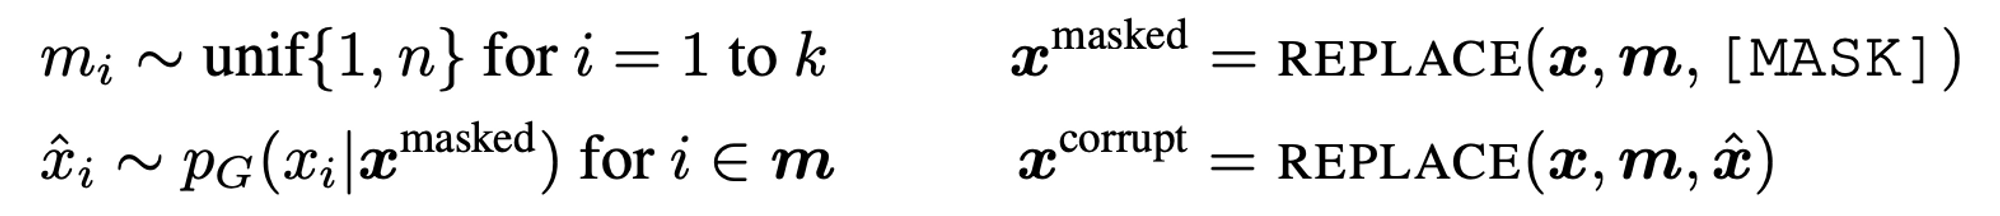
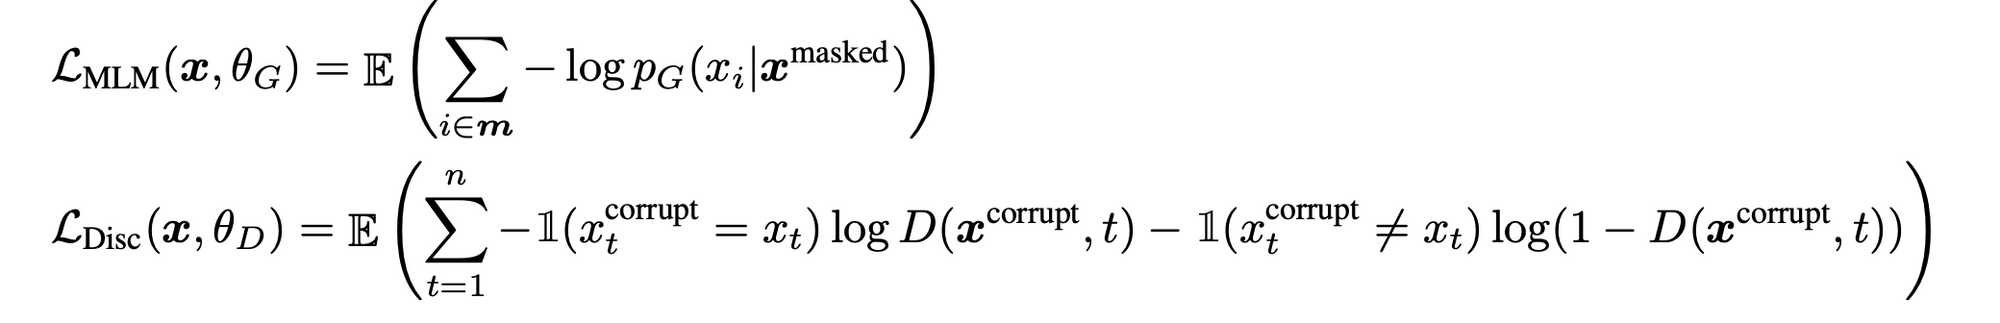
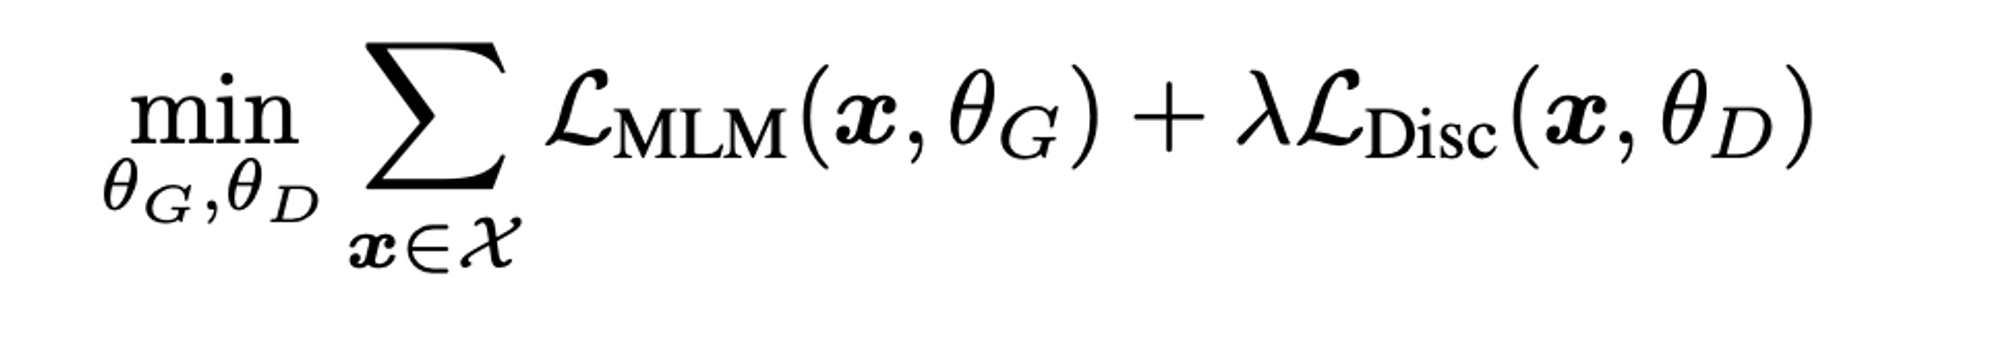
- GAN과 다른점
- generator가 mask토큰을 제대로 맞추면 discriminator는 fake가 아닌 real로 판단
- Generator objecitve is not fooling discriminator, but maximum likelihood
- not use noise vector as an input
discriminator와 generator 를 end-to-end로 학습하지는 않음. Sampling procedure때문에 back prop 어려움.
Pre-train 후에는 generator 부분을 버리고 discriminator를 fine tuning함
Experiments
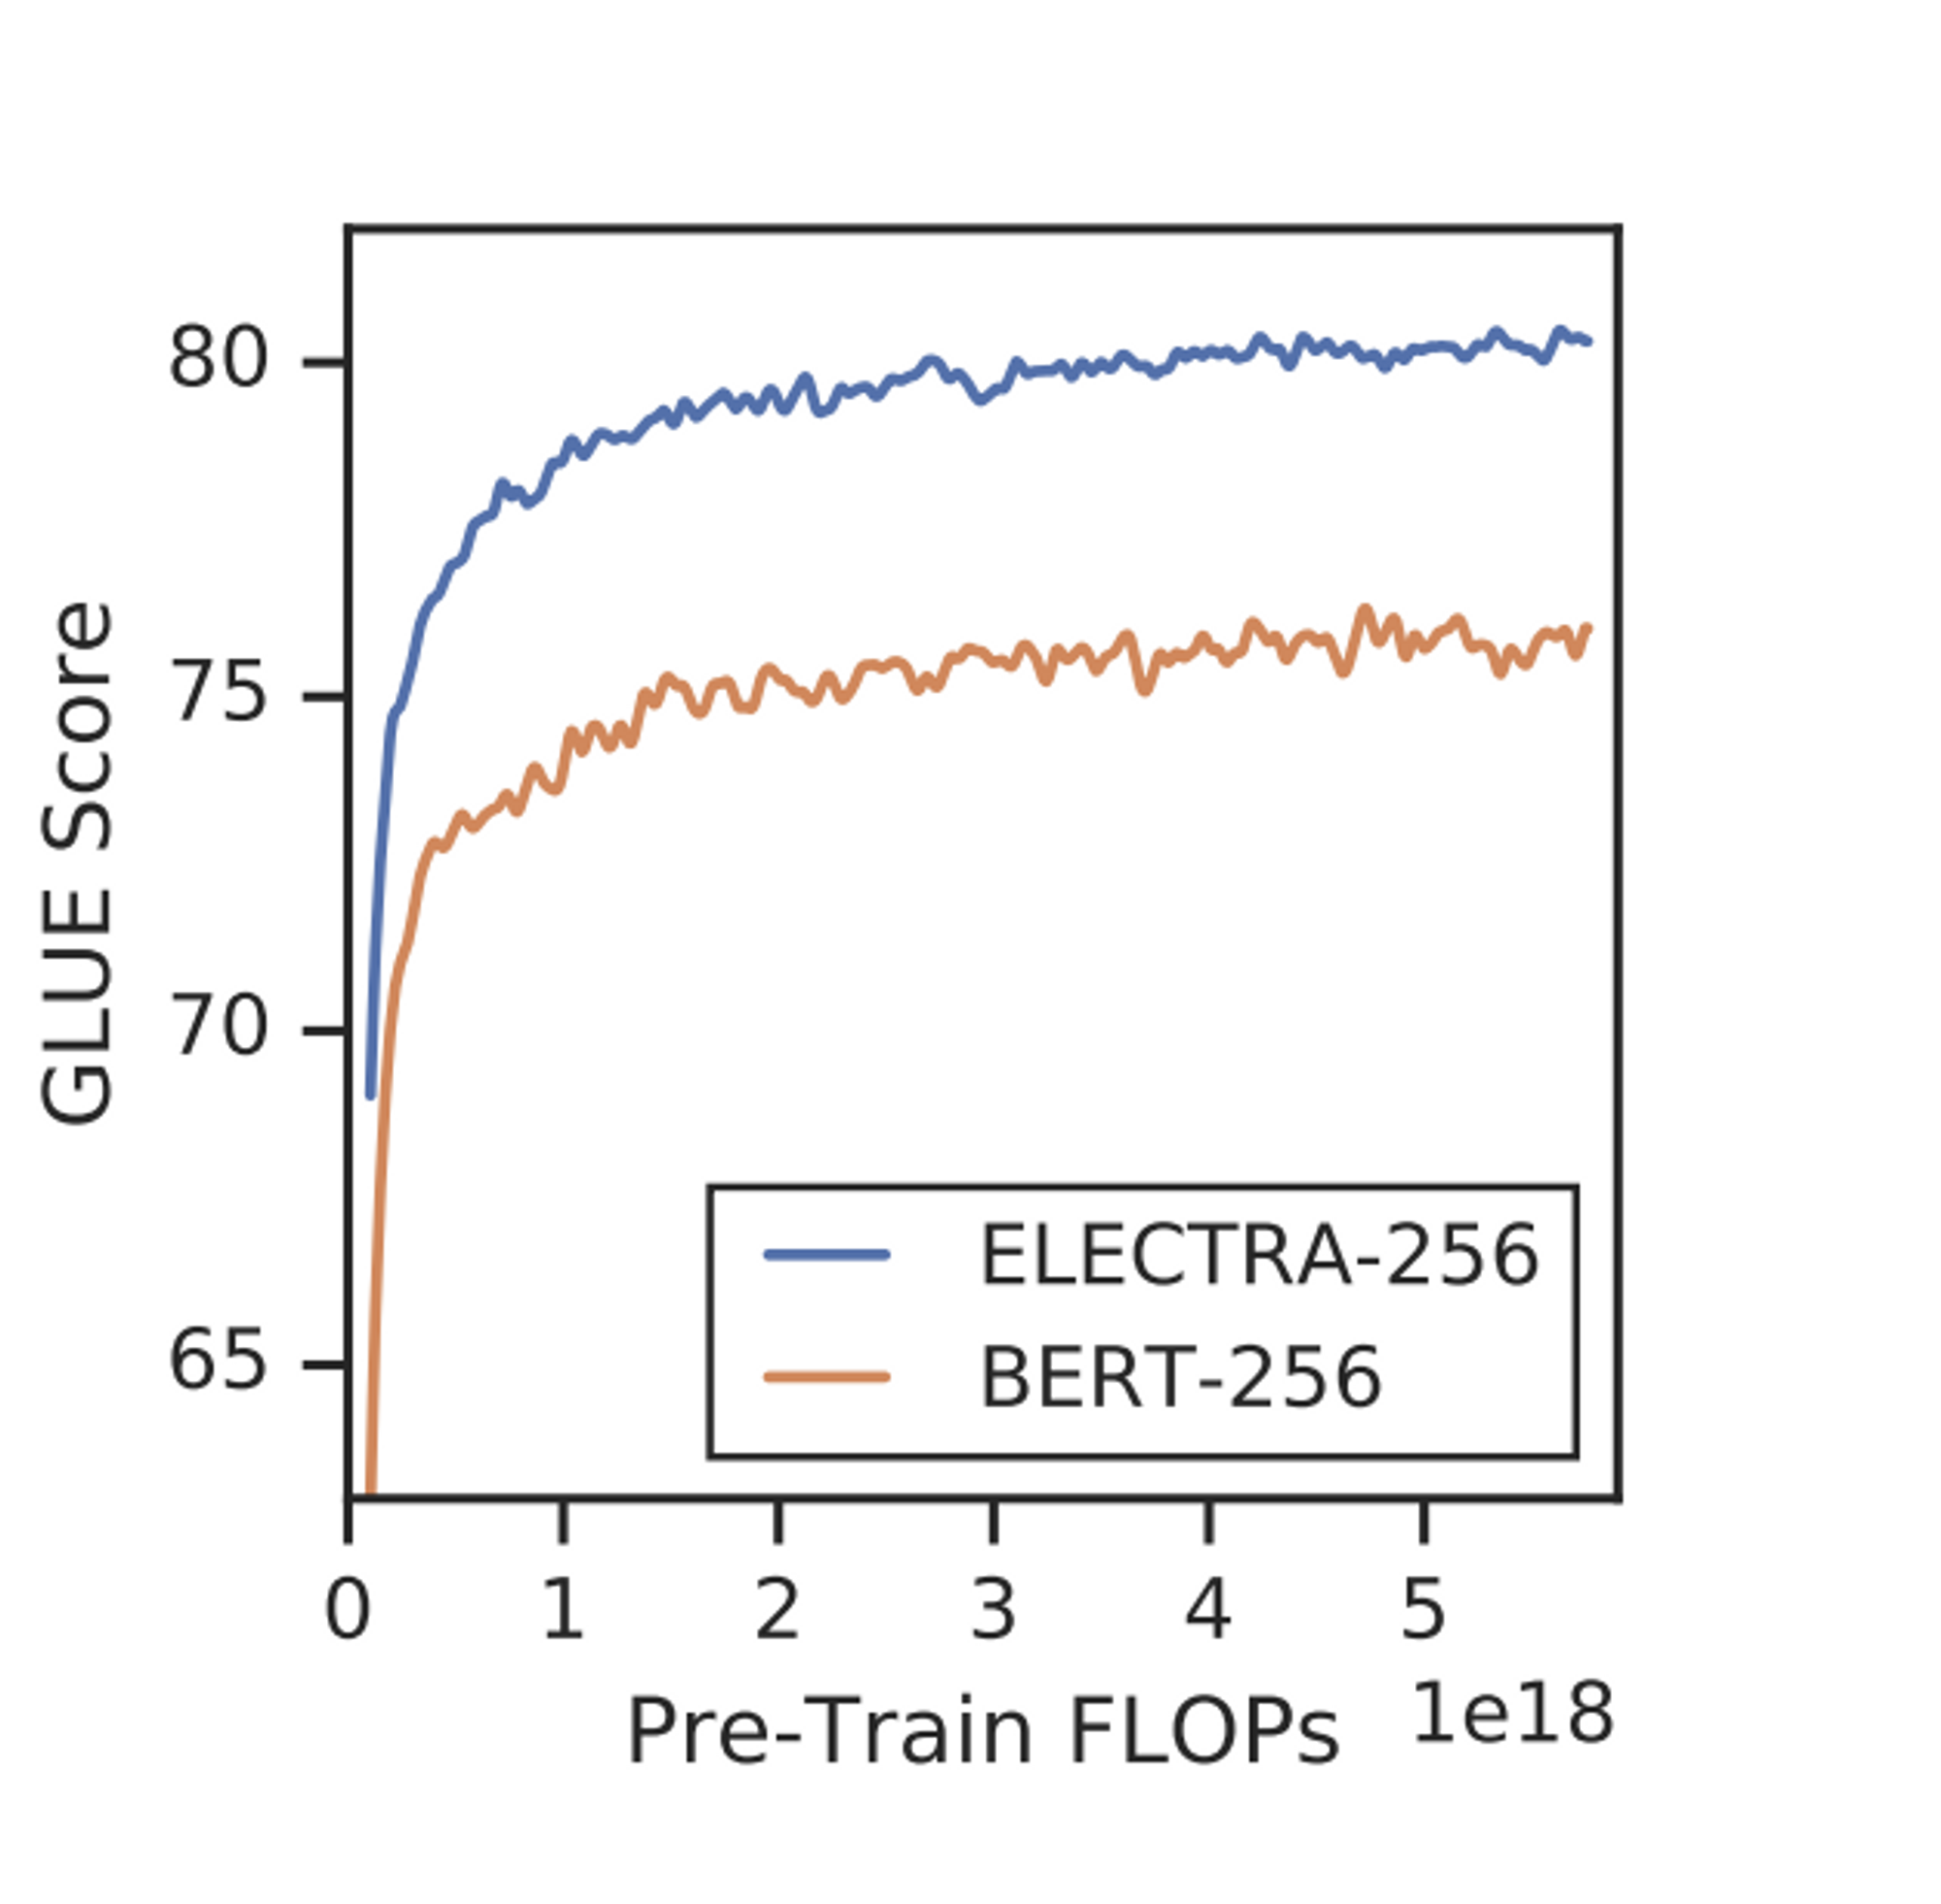
구조와 대부분의 hyperparameter를 BERT(base)와 같이 설정.
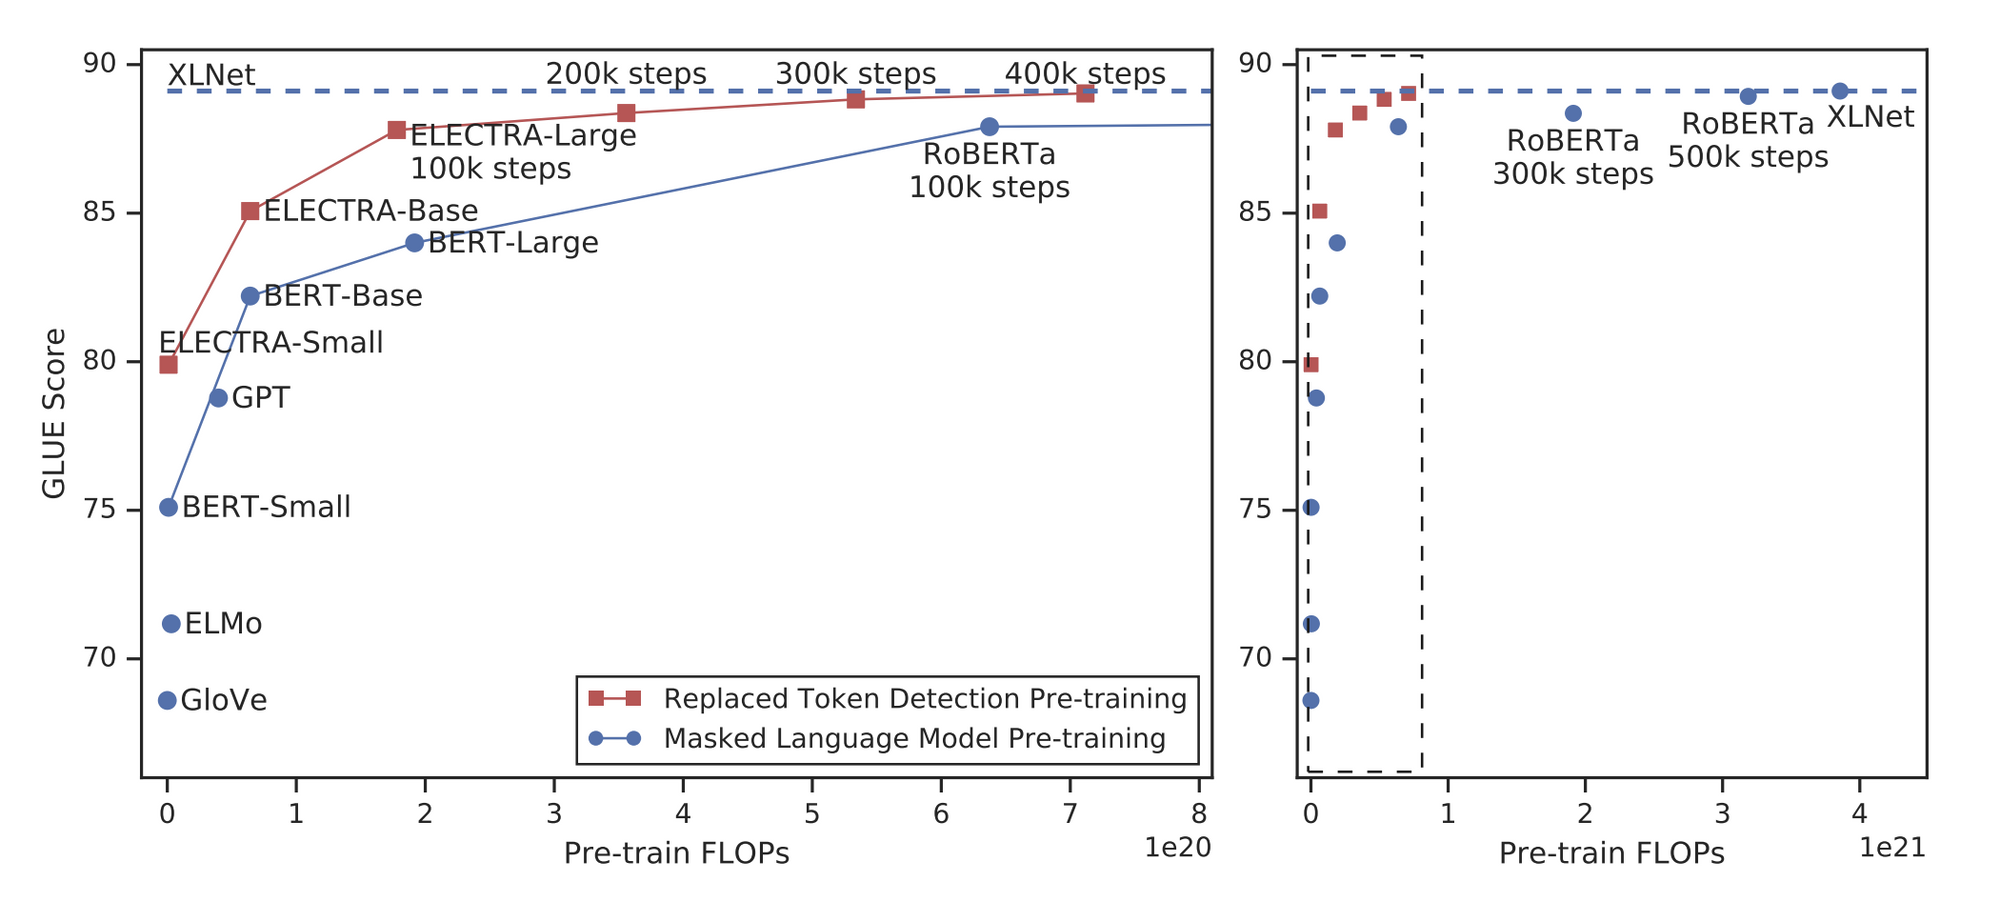
FLOP가 같을 때 ELECTRA가 우세!
Efficiency Analysis
-
ELECTRA 15%
Masked된 15%의 토큰에 대해 generate하고, 그 token에 대해서만 Discriminator loss 계산
-
Replace MLM
일단 Masked된 토큰에 대해 generate하고, 원래 토큰을 다시 generate ([MASK]대신 generator의 output으로 대체) -
All-Tokens MLM
일단 Masked된 토큰에 대해 generate하고, 원래 토큰을 다시 generate ([MASK]대신 generator의 output으로 대체). 모든 토큰에 대해 LOSS계산
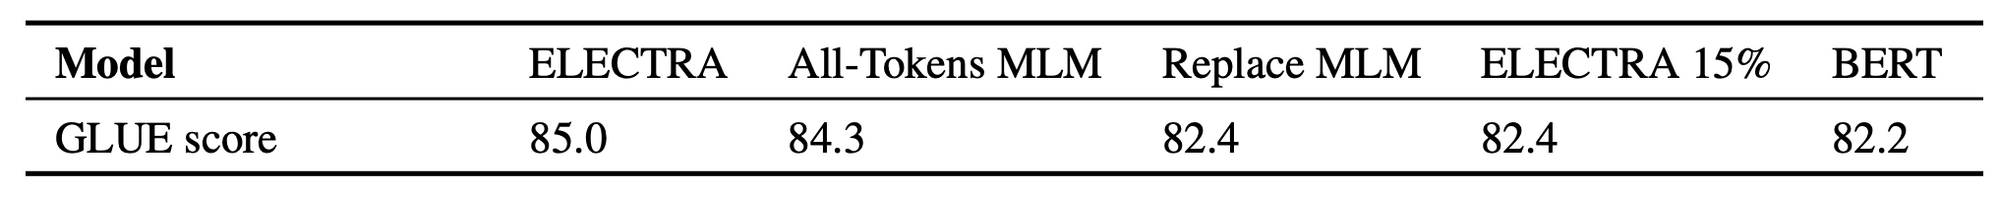
- ELECTRA 15% much worse than ELECTRA → 모든 Input 토큰에 대해 Loss 계산하는 것이 중요
- Replace MLM slightly outperforms BERTS → because of [MASK] mismatch at pre-train and fine-tune phase → BERT자체에 이 불일치를 해결하기 위한 trick들 (e.g. replace random token)이 있지만 충분하지 않음
- ELECTRA over All-Token MLM
- much better when model is smaller (when fully trained)
- more parameter-efficient than BERT because it does not have to model the full
distribution of possible tokens at each position - improvement rather than not only fast training over BERT