사실 필자는 요즘 astra와 Fable의 선택을 취향의 영역이라고 생각한다.
그리고 두 개중에 뭐가 더 낫냐고 판가름질할 시간에 그냥 둘 다 사서 쓰라고 권한다. 솔직히 진득하니 몇 달 써봐야 알지 뭐 잠깐 깔짝해놓고 뭘 알겠는가
이건 진짜 정확한 테스트도 아니고 순전히 내 개인 경험이다. 제대로 된 테스트가 아니다.
이번주 놀았나???
작업을 하던 필자는 생각보다 이번 주 남은 토큰이 꽤 넉넉하다는 것을 인지하였고(gpt, claude 가장 비싼 티어 사용 중..) 이번에는 Astra에게 구현과 테스트를 시켜보았다.
사실 평소에는 코드 구현 및 테스트에 gpt면 sol, claude면 opus를 사용하지만 오늘은 토큰이 넉넉하니 flex를 해보고 싶었다.
그리고 테스트하는 김에 fable에게도 동일하게 구현과 테스트 작업을 맡겨 두가지 모델을 비교해보고 싶다는 생각이 들었다.
솔직히 토큰이 남는 경우가 많지도 않고 지금 아니면 언제하나 싶었다.
plan → design → build → test → deploy → maintain
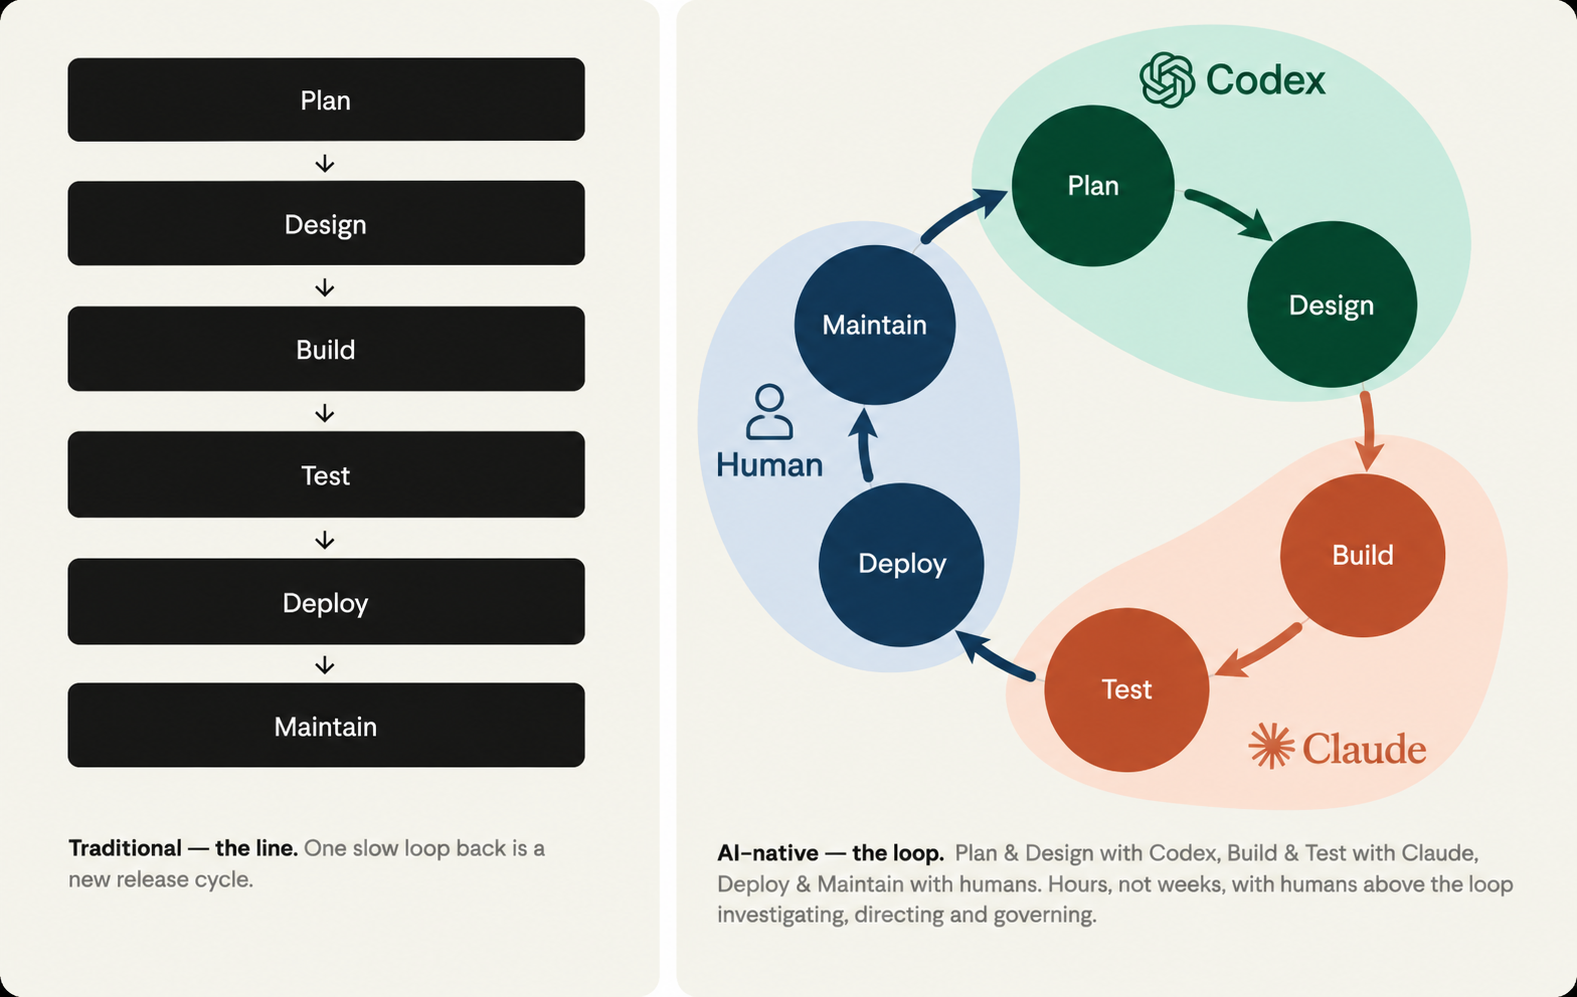
필자는 요즘에 개발 작업을 plan → design → build → test → deploy → maintain의 여섯 단계로 나눠 진행한다.
아래는 이 6가지의 간략한 설명이다.
- plan: 어떤 문제를 해결할지, 이번 작업에 어디까지 포함할지 정한다.
- design: 데이터 흐름과 처리 규칙, API와 DB 구조 등 구현할 동작을 설계한다.
- build: 설계를 코드로 옮긴다. 구현 전에 수정할 파일과 작업 순서, 지켜야 할 조건을 문서로 정리한다.
- test: 구현이 요구사항대로 동작하는지 확인하고, 기존 기능에 미치는 영향과 통합·성능 검증 결과를 기록한다.
- deploy: 검증한 변경을 배포하고, 배포 후 상태를 확인한다. 문제가 생겼을 때 되돌리는 절차도 여기에 포함한다.
- maintain: 배포 이후 운영 지표와 장애를 살펴보고, 필요한 수정과 개선을 이어간다.
이 과정에서 Codex GPT-6 Astra에는 plan, design, build의 문서 작성까지 맡긴다.
필자와 요구사항을 논의하고, 설계를 정리하고, 실제 구현에 필요한 지침을 만드는 역할로 결과를 문서화 시킨다.
실제 코드 구현과 test는 Claude Code에서 사용하는 Claude Opus 5에 맡긴다. Codex GPT-6 Astra가 작성한 세 문서를 바탕으로 구현과 검증을 진행하는 역할이다. 이후 deploy와 maintain, 즉 배포와 운영은 필자가 한다.
어떤 작업이었나
맡긴 작업은 Go로 작성된 FLOW 수집기의 템플릿 처리와 장비별 설정을 수정하는 일이었다. 수집기와 연결된 API·DB·설정 화면까지 변경하는 범위를 세 문서에 정리해두었고, 두 세션에 그 문서를 기준으로 구현하도록 요청했다.
당시 Astra에서 남긴 변경 기록을 세어보니 기존 파일 41개 수정, 신규 파일 13개 생성으로 총 54개였다. 테스트 파일 11개가 포함된 숫자이며, 자동 생성되는 API 클라이언트는 제외한 중간 집계다. 수집기·API·DB·화면을 함께 수정하고, 문서에 정한 49개 테스트 케이스와 통합·성능 검증까지 수행해야 했으므로 작업량이 큰 편이었다.
문서는 같았지만 실행 조건을 완전히 맞춘 비교는 아니었다. Astra는 설계 논의부터 이어온 세션이었고, Claude Fable 5.1에는 별도의 구현 요청을 전달했다.
실행 결과
Claude Fable 5.1은 코드 작성을 끝냈다. 작업이 멈춘 건 그다음 테스트와 검증 과정이었다. 실행한 지 약 1시간 50분이 지났을 때 5시간 한도의 100%를 사용했고, 당시 주간 사용량은 18%였다.
Codex GPT-6 Astra에는 코드 작성이 끝난 상태에서 테스트와 검증을 처음부터 다시 진행하도록 요청했다. 코드 구현에 이어 테스트와 검증까지 마쳤을 때 주간 사용량은 12%였다.
이후 추가로 발견한 문제도 수정했다. 관련 항목을 추가로 테스트하고, 수정한 코드에 대해 전체 테스트를 다시 실행한 뒤 결과를 문서로 정리했다
| 모델과 확인 시점 | 5시간 한도 | 누적 주간 사용량 | 작업 상태 |
|---|---|---|---|
| Claude Fable 5.1 | 100% 도달 | 18% | 코드 작성 완료, 테스트·검증 중 중단 |
| Codex GPT-6 Astra: 첫 검증 완료 | x | 12% | 코드 구현·테스트·검증 완료 |
| Codex GPT-6 Astra: 추가 작업 완료 | x | 15% | 추가 문제 수정, 추가 테스트와 전체 테스트 재실행, 결과 문서 작성 완료 |
마무리
같은 조건에서 모델 성능을 비교한 테스트로 보면 이번 비교는 실격이다.
Fable은 5시간 한도에 막혔고,
Astra는 그 제약 없이 끝까지 진행했다.
주간 사용량도 각 구독 한도에 대한 비율이므로, 18%와 15%를 그대로 실제 토큰 수나 비용의 차이로 환산할 수는 없다.
하지만 철저하게 사용자 편의성만 놓고 보면,
이번 작업에서는 Codex GPT-6 Astra가 이겼다.
Claude Fable 5.1은 주간 한도의 18%를 사용한 상태에서 검증을 끝내지 못했다. 반면 Astra는 추가로 발견한 문제를 고치고, 추가 테스트와 전체 테스트 재실행, 결과 문서 작성까지 마쳤는데도 주간 사용량이 15%였다.
필자의 입장에서는 한도 초기화를 기다리지 않고 맡긴 작업을 끝까지 진행할 수 있었다는 점이 가장 컸다.