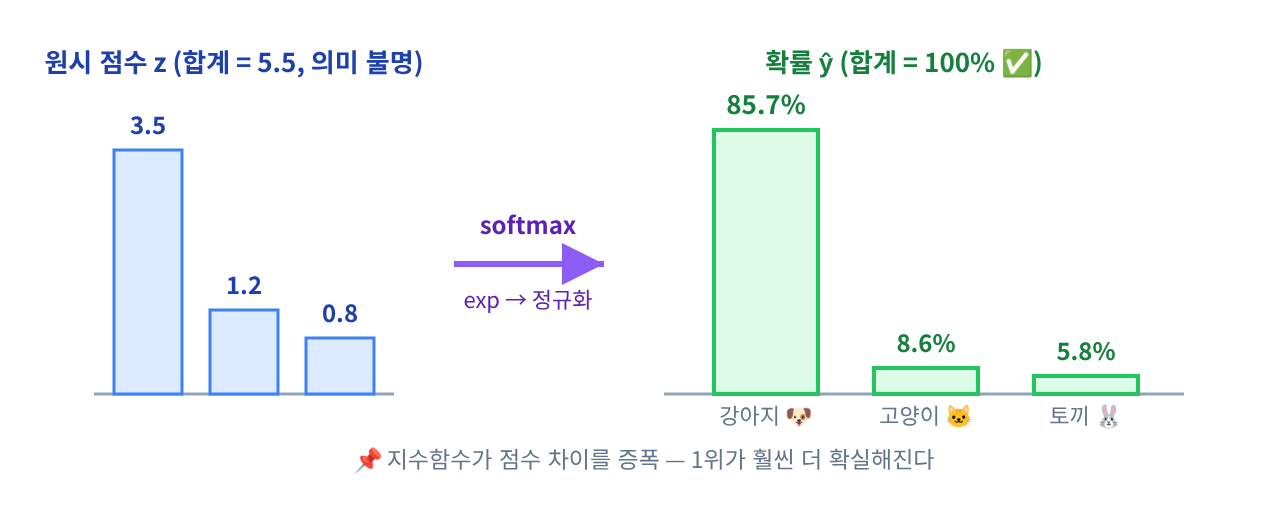
이미지 분류 모델이 "강아지 85.7%, 고양이 8.6%, 토끼 5.8%"라고 대답하는 걸 본 적 있죠? 🐶 이 숫자는 어디서 나오고, 모델은 어떻게 채점받을까요?
2부에서는 자연계의 종 모양 곡선 정규분포에서 출발해, 점수를 확률로 바꾸는 소프트맥스, 정답과의 거리를 재는 교차 엔트로피, 그리고 1부의 베이즈 정리를 실무에 쓰는 나이브 베이즈 스팸 필터까지 갑니다.
📘 이 글은 위키독스 도서 Zero to 머신러닝 딥러닝 Master 의 00-05 확률·베이즈 정리 — 병원 검사의 함정 (2부) 을 블로그용으로 다듬은 글입니다.
💻 실습 코드: GitHub · 🏠 mldict.net · ✍️ 기술 블로그
💻 이 글의 코드:
00-05-probability-bayes· Open in Colab — 핵심 코드와 실제 실행 결과는 글 아래 💻 GitHub 실습 섹션에 있습니다.
⬅️ 이전 글: #07 베이즈 정리 쉽게 이해하기 — 확률·조건부 확률과 병원 검사의 함정 (1부) \
➡️ 다음 글: #09 고유값·SVD·PCA 쉽게 이해하기 — 300페이지 책을 3페이지로 (1부)
TL;DR — 3줄 요약
- 정규분포는 평균과 표준편차 두 숫자로 정해지고, z-점수와 68-95-99.7 규칙으로 "얼마나 드문가"를 읽습니다.
- 소프트맥스는 아무 점수나 합이 1인 확률로 바꾸고,
z - z.max()를 빼는 안전장치로nan을 막습니다. - 교차 엔트로피로 채점하면 기울기가 놀랍도록 단순한 가 됩니다. 00-04의 경사하강법과 바로 연결돼요.
🔗 1부 복습: 확률은 "경우의 수의 비율", 조건부 확률은 "분모를 좁힌 확률", 베이즈 정리는 "사전 확률 × 우도 ÷ 증거로 믿음을 갱신하는 저울"이었습니다. 1부를 아직 못 보셨다면 #07 베이즈 정리 쉽게 이해하기부터 읽고 오세요.
📍 00-05-D · 4단계 — 정규분포: 자연계의 종 모양 곡선
🔎 ① 핵심 정의 — 무엇인가?\
정규분포(Normal Distribution)는 키·몸무게·시험 점수·측정 오차처럼 "평균 근처에 값이 가장 많이 몰려 있고, 멀어질수록 드물어지는" 데이터가 따르는 종 모양 분포입니다. 🔔
❓ 왜 필요한가?\
지금까지는 주사위처럼 결과가 딱딱 떨어지는 경우만 다뤘습니다. 그런데 키는 170cm, 170.1cm, 170.15cm… 무한히 많은 값이 가능합니다. 이럴 때는 "각 값의 확률" 대신 "값들이 어떻게 퍼져 있는지 전체 모양"이 필요한데, 그것이 확률 분포입니다.
⏰ 언제 사용하는가?\
🔹 신경망 가중치 초기화 (평균 0, 작은 표준편차의 정규분포에서 뽑음)\
🔹 노이즈 모델링 (확산 모델·VAE의 핵심)\
🔹 이상치 탐지 (를 벗어나면 의심)\
🔹 데이터 정규화 (00-04에서 배운 그 정규화!) 🔗
💜 더 쉽게 이해하기 — 🎯 양궁 과녁
양궁 선수가 화살을 100발 쏘면, 화살 자국은 과녁 중심(평균 ) 근처에 가장 빽빽하고 밖으로 갈수록 드물어집니다. 🏹
여기서 "얼마나 넓게 퍼졌는가"가 표준편차 입니다.\
• 작음 → 촘촘하게 몰림 = 명사수 🎯 (뾰족한 종)\
• 큼 → 넓게 흩어짐 = 초보자 😅 (납작한 종)중요한 건, 중심 위치()와 퍼짐 정도() 단 두 숫자만 알면 과녁 전체 모습을 완전히 그릴 수 있다는 점입니다. 그래서 정규분포를 라고 짧게 씁니다. 📐
🔢 진행 과정 — 정규분포 다루기 4단계
- 데이터의 평균 와 표준편차 를 구한다
- 관심 있는 값 가 평균에서 몇 떨어졌는지 계산한다 → z-점수
- 68-95-99.7 규칙으로 흔한 값인지 드문 값인지 판단한다
- 필요하면 정확한 확률을 누적분포함수(CDF)로 구한다
🔬 수학공식 ⑤ — 확률밀도함수(PDF)와 표준화
정규분포의 확률밀도함수
무섭게 생겼지만 세 부품으로 나눠 보면 간단합니다.\
• : 평균에서 얼마나 떨어졌나 (제곱이므로 좌우 대칭! 🪞)\
• : 멀어질수록 급격히 작아진다 (종 모양의 정체)\
• : 전체 넓이를 정확히 1로 맞추는 정규화 상수\
\
변수 정의\
• (뮤) : 평균 — 종의 중심 위치\
• (시그마) : 표준편차 — 종의 폭\
• : 분산 — 표준편차의 제곱 ⚠️ 둘을 혼동하지 마세요!\
• : 확률밀도 — 확률 자체가 아니라 "그 근처의 빽빽함"\
\
표준화(z-점수) — 어떤 정규분포든 로 변환하는 마법📌 z의 의미: "평균에서 표준편차 몇 개만큼 떨어졌는가". 면 "평균보다 2σ 위"라는 뜻이고, 이는 상위 약 2.3%에 해당합니다.\
\
📌 00-04와 연결: 경사하강법에서 입력을(X - X.mean())/X.std()로 정규화했던 것이 바로 이 z-점수 공식입니다! 🔗
⚠️ "확률밀도"는 확률이 아닙니다\
는 "키가 정확히 170cm일 확률이 5%"라는 뜻이 아닙니다. 연속 분포에서 정확히 한 점일 확률은 0입니다(170.0000...cm인 사람은 없으니까요). 밀도는 "넓이를 재기 위한 높이"이고, 실제 확률은 구간의 넓이(적분)로 구합니다. 📏
📖 수학적 의미 — 68-95-99.7 규칙\
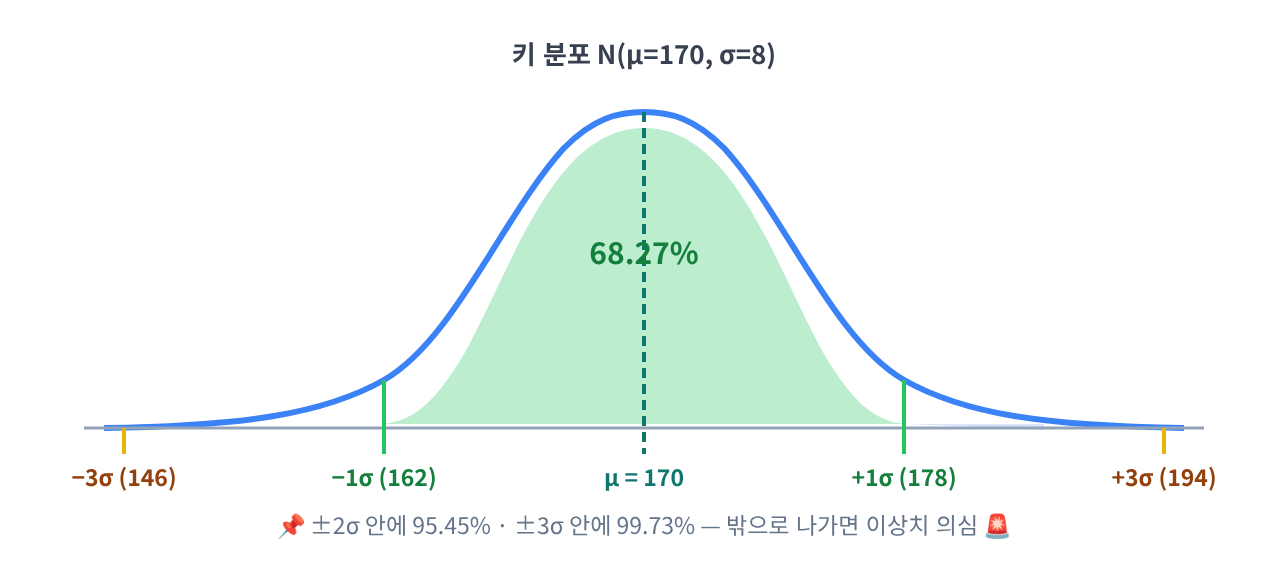
평균을 중심으로 얼마나 많은 데이터가 들어 있는지는 외워둘 만한 세 숫자가 있습니다.
| 범위 | 포함 비율 | 키 예시 (μ=170, σ=8) | 해석 |
|---|---|---|---|
| 약 68.27% | 162 ~ 178cm | 🙂 아주 흔한 키 (3명 중 2명) | |
| 약 95.45% | 154 ~ 186cm | 😯 벗어나면 상위/하위 2.3% | |
| 약 99.73% | 146 ~ 194cm | 🚨 벗어나면 이상치 의심 |
💡 직관적 의미 — 두 숫자로 세상을 읽기\
평균과 표준편차 단 두 개만 알면 "이 값이 흔한지 드문지"를 즉시 판단할 수 있습니다. 예를 들어 키 186cm는 이므로 상위 약 2.3%입니다. 반면 178cm는 으로 상위 약 16%, 훨씬 흔하죠. 🎯
📐 시각화 ⑥ — 종 모양 곡선과 68-95-99.7 규칙
⚙️ 구현 원리 — 공식 직접 구현 → 라이브러리로 검증\
PDF 공식을 직접 파이썬으로 옮겨보고, scipy.stats.norm.pdf와 비교합니다. 두 값이 같으면 공식을 제대로 이해했다는 증거입니다. 이것이 00-04에서 "공식 미분 vs 수치 미분"을 비교했던 것과 같은 습관입니다. 🔗
🔗 프레임워크 관점
| 개념 | NumPy | SciPy | PyTorch | TensorFlow |
|---|---|---|---|---|
| 난수 생성 | rng.normal(μ,σ,n) | norm.rvs() | torch.randn | tf.random.normal |
| 직접 구현 | norm.pdf(x,μ,σ) | Normal().log_prob | tfp.distributions | |
| CDF(누적확률) | 직접 구현 | norm.cdf(x) ⭐ | Normal().cdf | tfp ... .cdf |
| 가중치 초기화 | rng.normal | — | nn.init.normal_ | RandomNormal |
🐍 Python — PDF 직접 구현 + 68-95-99.7 검증 + 중심극한정리
import numpy as np
import math
from scipy import stats

def normal_pdf(x, mu, sigma):
    """
    정규분포 확률밀도함수를 공식 그대로 구현합니다.
        f(x) = 1/(σ√(2π)) · exp(-(x-μ)²/(2σ²))

    비유:
    과녁 중심(μ)에서 멀어질수록 화살 자국이
    급격히 드물어지는 정도를 수식으로 나타낸 것입니다.
    """
    coefficient = 1 / (sigma * math.sqrt(2 * math.pi))   # 정규화 상수
    exponent = -((x - mu) ** 2) / (2 * sigma ** 2)     # 지수 부분
    return coefficient * math.exp(exponent)

def z_score(x, mu, sigma):
    """z = (x-μ)/σ — 평균에서 표준편차 몇 개만큼 떨어졌는가"""
    return (x - mu) / sigma

mu, sigma = 170, 8

# ══════ ① 공식 직접 구현 vs SciPy 비교 ══════
print("--- PDF 검증 (직접 구현 vs SciPy) ---")
for x in [170, 178, 186]:
    mine = normal_pdf(x, mu, sigma)
    lib = stats.norm.pdf(x, mu, sigma)
    print(f"  x={x}: 직접 {mine:.6f} / SciPy {lib:.6f}"
          f" / z={z_score(x,mu,sigma):+.1f}")

# ══════ ② 68-95-99.7 규칙을 데이터로 검증 ══════
rng = np.random.default_rng(42)
heights = rng.normal(mu, sigma, 100_000)   # ⚠️ 2번째 인자는 '표준편차'

print("\n--- 68-95-99.7 규칙 검증 ---")
for k in [1, 2, 3]:
    # |x-μ| ≤ kσ 인 데이터의 비율 (불리언 평균 = 비율!)
    empirical = np.mean(np.abs(heights - mu) <= k * sigma)
    theory = stats.norm.cdf(k) - stats.norm.cdf(-k)
    print(f"  ±{k}σ: 실측 {empirical:.4f} / 이론 {theory:.4f}")

# ══════ ③ "186cm 이상"인 사람의 비율 ══════
print(f"\n186cm 이상 이론값: {1 - stats.norm.cdf(2):.4f}", "(z=2)")
print(f"186cm 이상 실측값: {np.mean(heights >= 186):.4f}")

# ══════ ④ 중심극한정리 — 왜 정규분포가 흔한가? ══════
# 주사위(전혀 종 모양이 아님!)를 n개 굴려 평균을 내면
# n이 커질수록 그 평균은 정규분포에 가까워집니다
print("\n--- 중심극한정리: 주사위 n개의 평균 ---")
for n in [1, 2, 5, 30]:
    means = rng.integers(1, 7, (20_000, n)).mean(axis=1)   # 행마다 평균
    print(f"  주사위 {n:2d}개 → 평균 {means.mean():.3f}, "
          f"표준편차 {means.std():.3f} (이론 {1.7078/math.sqrt(n):.3f})")
🔗 GitHub에서 코드 보기 — 00_05_probability_bayes.py L166–L219
📘 코드 이해 — 공식의 각 부품이 코드 어디에
| 수학공식 | 코드 | 역할 |
|---|---|---|
1/(sigma*math.sqrt(2*math.pi)) | 전체 넓이를 1로 맞추는 상수 | |
-((x-mu)**2)/(2*sigma**2) | 거리의 제곱 → 좌우 대칭 | |
math.exp(exponent) | 멀수록 급감 → 종 모양 | |
(x - mu)/sigma | 표준화 (00-04의 정규화와 동일) | |
np.mean(np.abs(h-mu) <= k*s) | 불리언 평균 = 비율 ⭐ | |
1 - stats.norm.cdf(2) | CDF = 왼쪽 누적 넓이 |
🧩 코드 설명 — NumPy/SciPy 기초
•
rng.normal(mu, sigma, n)⚠️ — 두 번째 인자는 표준편차 이지 분산 이 아닙니다. 분산 64가 주어졌다면math.sqrt(64)=8을 넣어야 합니다. 가장 흔한 버그입니다!\
\
•stats.norm.cdf(x)— 누적분포함수. "x보다 작을 확률"을 돌려줍니다. 그래서 "x보다 클 확률"은1 - cdf(x)입니다. PDF(밀도)와 CDF(확률)를 구분하세요.\
\
•rng.integers(1,7,(20_000, n))— 크기를 튜플로 주면 2차원 배열이 만들어집니다. 20,000행 × n열, 즉 "주사위 n개 굴리기를 20,000번 반복"입니다.\
\
•.mean(axis=1)⭐ —axis=1은 가로(행) 방향 평균입니다. 각 행(=한 번의 시행에서 굴린 주사위 n개)의 평균을 구해 20,000개 결과를 얻습니다.axis=0이면 세로(열) 방향이라 완전히 다른 결과가 나옵니다!\
\
•{z:+.1f}—+기호는 양수에도 부호를 붙여 출력합니다. z-점수는 방향(위/아래)이 중요하므로 유용합니다.
✅🟩 실행 결과
--- PDF 검증 (직접 구현 vs SciPy) ---
  x=170: 직접 0.049868 / SciPy 0.049868 / z=+0.0
  x=178: 직접 0.030246 / SciPy 0.030246 / z=+1.0
  x=186: 직접 0.006749 / SciPy 0.006749 / z=+2.0

--- 68-95-99.7 규칙 검증 ---
  ±1σ: 실측 0.6817 / 이론 0.6827
  ±2σ: 실측 0.9536 / 이론 0.9545
  ±3σ: 실측 0.9970 / 이론 0.9973

186cm 이상 이론값: 0.0228 (z=2)
186cm 이상 실측값: 0.0233

--- 중심극한정리: 주사위 n개의 평균 ---
  주사위  1개 → 평균 3.492, 표준편차 1.709 (이론 1.708)
  주사위  2개 → 평균 3.490, 표준편차 1.207 (이론 1.208)
  주사위  5개 → 평균 3.499, 표준편차 0.762 (이론 0.764)
  주사위 30개 → 평균 3.497, 표준편차 0.310 (이론 0.312)
🔍 결과 해석
① 공식 구현이 정확 — 직접 만든 normal_pdf가 SciPy와 소수점 6자리까지 일치합니다. 공식을 제대로 이해했다는 증거입니다. ✅
② 68-95-99.7이 실제로 성립 — 실측 0.6817/0.9536/0.9970이 이론 0.6827/0.9545/0.9973과 거의 같습니다. 미세한 차이는 10만 개 표본의 무작위 흔들림일 뿐입니다(1단계 대수의 법칙 🔗).
③ 중심극한정리(CLT)의 마법 ⭐ — 주사위 하나의 분포는 납작한 균등분포로 종 모양과 거리가 멉니다. 그런데 여러 개의 평균을 내면 신기하게도 종 모양이 되고, 퍼짐(표준편차)이 에 비례해 줄어듭니다. 이론값 과 실측이 정확히 맞아떨어집니다.\
👉 이것이 "왜 세상에 정규분포가 이렇게 흔한가"에 대한 답입니다. 키·시험 점수·측정 오차는 모두 수많은 작은 요인들의 합이기 때문에, 원래 요인이 무슨 모양이든 결과는 종 모양이 됩니다. 🔔✨
🛠️ 실습 4 🟢🔵
① 범위를 로 바꿔 실행하고 이론값 95.45%와 비교하세요.\
② 키 194cm인 사람의 z-점수와 상위 몇 %인지 구하세요. (정답: , 상위 약 0.13%)\
③ 시험 점수가 평균 60점·표준편차 15점일 때, 90점은 상위 몇 %인가요? (정답: , 약 2.3%)\
④ 🚀 CLT 실험에서n=1과n=30의 히스토그램을matplotlib으로 그려 모양이 어떻게 달라지는지 눈으로 확인하세요.
🐞 실수하기 쉬운 부분 & 디버깅 포인트
❌ 실수 ① 표준편차 vs 분산 혼동 ⭐ 가장 흔함\
왜 틀리나?rng.normal(170, 64, n)처럼 분산을 넣으면, 표준편차 64짜리(퍼짐이 8배!) 데이터가 만들어집니다. 원인: NumPy는 표준편차를 받는데 수학책은 처럼 분산으로 표기하기 때문입니다. 수정: 분산이 주어지면 반드시math.sqrt(분산). 확인법:print(data.std())가 의도한 값인지 보세요.❌ 실수 ② PDF를 확률로 착각\
를 "5% 확률"로 읽으면 안 됩니다. 확인법: 를 아주 작게 하면 PDF 값이 1을 넘어갑니다(예: 이면 약 3.99). 확률이라면 불가능한 일이죠. 밀도는 넓이를 재기 위한 높이입니다.❌ 실수 ③
axis방향 착각\
CLT 코드에서.mean(axis=0)으로 쓰면 n개의 값만 나와 완전히 다른 결과가 됩니다. 확인법:print(means.shape)가(20000,)인지 확인하세요.❌ 실수 ④ 정규분포가 아닌데 68-95 규칙 적용\
소득·주가 수익률처럼 한쪽으로 치우친(skewed) 데이터에 이 규칙을 쓰면 크게 틀립니다. 수정: 히스토그램을 먼저 그려 종 모양인지 눈으로 확인하세요. 👀
📍 00-05-E · 5단계 — 소프트맥스와 교차 엔트로피: AI는 확률로 대답한다 🔵 중급
🔎 ① 핵심 정의 — 무엇인가?\
• 소프트맥스(Softmax): 신경망이 뱉은 아무 범위의 원시 점수를 합이 정확히 1인 확률로 바꾸는 함수\
• 교차 엔트로피(Cross-Entropy): 그렇게 나온 예측 확률이 정답과 얼마나 다른지 재는 손실 함수
❓ 왜 필요한가?\
신경망의 마지막 층은 [3.5, 1.2, 0.8] 같은 의미를 알 수 없는 숫자를 뱉습니다. 음수도 나오고 합도 제각각이라 "확률"이라고 부를 수 없습니다. 이걸 "강아지 86%, 고양이 9%, 토끼 6%"로 바꿔야 사람이 이해하고, 얼마나 틀렸는지 숫자 하나로 요약해야 00-04의 경사하강법으로 학습시킬 수 있습니다.
⏰ 언제 사용하는가?\
모든 분류 모델의 마지막 단계. 이미지 분류, 감정 분석, 그리고 ChatGPT가 다음 단어를 고르는 순간에도 소프트맥스가 쓰입니다. 🤖
💜 더 쉽게 이해하기 — 🗳️ 선거관리위원회
후보 세 명이 심사위원에게 제각각인 점수를 받았습니다: 3.5점, 1.2점, 0.8점. 심지어 음수 점수도 가능합니다.
선관위(소프트맥스)는 이 점수들을 "합계 100%가 되는 득표율"로 변환해 발표합니다. 🗳️ 규칙은 두 가지입니다.\
① 음수여도 괜찮게 — 지수 를 씌우면 무조건 양수가 됩니다\
② 합이 100%가 되게 — 전체 합으로 나눕니다그리고 교차 엔트로피는 채점관입니다. 📝 정답이 1번 후보였는데 모델이 1번에 86%를 줬다면 "거의 맞췄네" (손실 작음). 만약 7%만 줬다면 "크게 틀렸네!" (손실 큼). 확신했는데 틀리면 벌점이 폭발적으로 커집니다. 💥
🔢 진행 과정 — 점수에서 손실까지 5단계
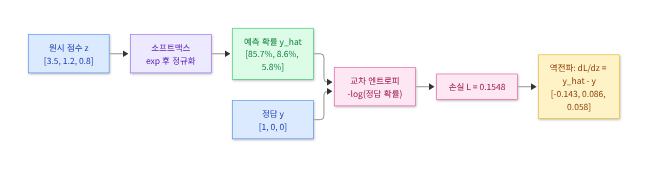
- 신경망이 원시 점수(logit) 을 출력
- 안정화: 최댓값을 빼준다 (오버플로 방지, 결과는 불변)
- 지수화: — 전부 양수로
- 정규화: 전체 합으로 나눈다 → 확률 (합 = 1)
- 채점: 정답 클래스의 확률에 를 씌운다 → 손실
🔬 수학공식 ⑥ — 소프트맥스, 그리고 "max 빼기"가 안전한 이유 증명
변수 정의\
• : 클래스 의 원시 점수(logit) — 범위 제한 없음, 음수 가능\
• : 클래스 개수\
• : 자연상수(≈2.718) — 항상 양수를 만들고 차이를 증폭\
• : 정규화 상수 — 합을 1로 맞춤\
• : 클래스 일 예측 확률, ✅\
\
💎 정리: 모든 에서 같은 수 를 빼도 결과가 변하지 않는다증명 끝! 가 분자·분모에서 깔끔하게 약분됩니다. ✨\
\
📌 왜 이게 중요한가? 이면 은 컴퓨터가 표현할 수 있는 범위를 넘어inf가 되고, 결과는nan이 됩니다. 💥 그래서 를 빼면 가장 큰 지수가 이 되어 절대 넘치지 않습니다. 수학적 정리 하나가 코드를 살리는 사례입니다. 🛡️
🔬 수학공식 ⑦ — 교차 엔트로피와 "왜 인가"
변수 정의\
• : 정답 레이블 (원-핫 인코딩: 정답만 1, 나머지 0)\
• : 소프트맥스 예측 확률\
• : 손실 — 작을수록 잘 맞춘 것\
\
① 원-핫이라서 식이 극단적으로 단순해진다\
정답이 아닌 클래스는 이라 항 전체가 사라집니다. 정답 클래스만 이므로:
즉 "정답 클래스에 확률을 얼마나 줬는가"만 보면 됩니다! 🎯\
\
② 왜 하필 로그인가?\
는 확신을 갖고 틀린 것을 가혹하게 처벌합니다.
| 정답에 준 확률 | 손실 | 해석 |
|---|---|---|
| 99% | 0.0101 | 😄 거의 완벽 |
| 90% | 0.1054 | 🙂 좋음 |
| 50% | 0.6931 | 😐 반반 (= ) |
| 10% | 2.3026 | 😟 많이 틀림 |
| 1% | 4.6052 | 😱 확신하고 대참사 |
📌 확률이 10배 낮아질 때마다 손실은 약 2.3씩 더해집니다. 0에 가까워지면 손실이 무한대로 발산하죠. 이 "가혹함"이 학습 신호를 강하게 만들어, 모델이 틀린 확신을 빠르게 교정하게 합니다. ⚡
🎁 수학공식 ⑧ — 00-04와 연결: 손실의 기울기가 놀랍도록 단순해진다 🔴⭐
00-04에서 배웠듯, 학습하려면 손실을 입력으로 미분한 기울기가 필요합니다. 소프트맥스는 분수, 교차 엔트로피는 로그… 미분이 끔찍하게 복잡할 것 같지만 기적적으로 단순해집니다.\
\
결과부터즉 "예측 확률 − 정답". 그게 전부입니다! 😮\
\
왜 이렇게 아름다운가?\
• 코드가gz = y_hat - y단 한 줄이 됩니다\
• 지수·로그를 다시 계산할 필요가 전혀 없습니다 (순전파 결과 재사용) 🚀\
• 00-04의 시그모이드 미분 가 순전파 출력만으로 계산됐던 것과 똑같은 패턴입니다 🔗\
• 00-03/0-04의 선형회귀 기울기가 "잔차 "였던 것과도 형태가 같습니다! 🎯\
\
직관적 의미\
정답 클래스()에서는 → 점수를 올려라 ⬆️\
오답 클래스()에서는 → 점수를 내려라 ⬇️\
그리고 기울기의 합은 항상 0입니다(, 이므로) — "누군가 올라가면 누군가는 내려간다"는 확률의 제로섬 성질이 그대로 드러납니다. ⚖️\
\
📌 이것이 PyTorch가nn.CrossEntropyLoss에 소프트맥스를 "포함"시켜 놓은 이유입니다. 둘을 붙여야 이 아름다운 형태로 계산할 수 있고, 따로 쓰면 느리고 불안정해집니다. 아래에서 수치미분으로 직접 검증합니다! 🔬
🗺️ 시각화 ⑦ — 점수에서 손실, 그리고 역전파까지
📐 시각화 ⑧ — 원시 점수가 확률로 바뀌는 모습
⚙️ 구현 원리\
소프트맥스는 원시 점수 배열 → 확률 배열, 교차 엔트로피는 (정답, 예측) → 숫자 하나로 구현합니다. 두 함수는 항상 짝으로 다니며 "모델 출력 → 손실"의 파이프라인을 완성합니다. 그리고 이 절의 하이라이트는, 유도한 기울기 를 00-04의 수치미분으로 검증하는 것입니다. 🔬
🔗 프레임워크 관점
| 개념 | NumPy | PyTorch | TensorFlow | JAX |
|---|---|---|---|---|
| 소프트맥스 | 직접 구현 | F.softmax(z, dim=-1) | tf.nn.softmax(z) | jax.nn.softmax |
| 교차 엔트로피 | 직접 구현 | nn.CrossEntropyLoss() ⚠️ | CategoricalCrossentropy | optax.softmax_ce |
| 기울기 | y_hat - y | 자동미분 | 자동미분 | jax.grad |
⚠️ PyTorch 사용자가 100% 겪는 함정:
nn.CrossEntropyLoss는 내부에 소프트맥스가 이미 들어 있습니다. 그래서 모델 마지막에F.softmax를 또 붙이면 소프트맥스가 두 번 적용되어 학습이 매우 느려집니다. 🐢 규칙: PyTorch에서는 모델이 raw logit을 그대로 출력해야 합니다.
🐍 Python — 소프트맥스·교차엔트로피 구현 + 기울기 검증
import numpy as np

def softmax(z):
    """
    원시 점수를 합이 1인 확률로 변환합니다.
        softmax(z_i) = exp(z_i) / Σ exp(z_j)

    비유:
    후보들의 제각각인 점수를 항상 합계 100%의 득표율로
    환산하는 선거관리위원회와 같습니다.
    """
    # ★ 최댓값 빼기: 수식 ⑥에서 증명했듯 결과는 그대로,
    #   대신 exp가 절대 넘치지 않아 안전해집니다
    exp_z = np.exp(z - np.max(z))
    return exp_z / exp_z.sum()          # 정규화 → 합이 1

def cross_entropy(y, y_hat, eps=1e-15):
    """
    L = -Σ y_i · log(ŷ_i)  — 정답과 예측의 차이를 재는 손실

    비유:
    정답에 몇 %를 줬는지 보고 채점하는 채점관입니다.
    확신하고 틀리면 벌점이 폭발합니다.
    """
    return -np.sum(y * np.log(y_hat + eps))   # eps: log(0) 방지

def softmax_ce_grad(y, y_hat):
    """수식 ⑧에서 유도한 기울기: dL/dz = ŷ - y  (단 한 줄!)"""
    return y_hat - y

# ══════ ① 기본 예측 ══════
z = np.array([3.5, 1.2, 0.8])   # 강아지, 고양이, 토끼의 원시 점수
y = np.array([1.0, 0.0, 0.0])   # 정답: 강아지 (원-핫)

y_hat = softmax(z)
print("예측 확률:", np.round(y_hat, 4), "| 합계:", round(y_hat.sum(), 6))
print(f"손실 L = {cross_entropy(y, y_hat):.4f}")

# ══════ ② 'max 빼기'가 정말 안전한지 확인 ══════
print("\n--- 오버플로 테스트 (z가 아주 클 때) ---")
big = np.array([1000.0, 1001.0, 1002.0])
with np.errstate(over='ignore', invalid='ignore'):
    naive = np.exp(big) / np.exp(big).sum()   # max를 안 뺀 위험한 버전
print("  max 안 뺀 식:", naive, "← 폭발! 💥")
print("  안전한 softmax:", np.round(softmax(big), 6))

# ══════ ③ 확신 정도에 따른 손실 변화 ══════
print("\n--- 정답에 준 확률 vs 손실 ---")
for q in [0.99, 0.9, 0.5, 0.1, 0.01]:
    print(f"  정답 확률 {q:>5.0%} → 손실 {-np.log(q):.4f}")

# ══════ ④ ★ 유도한 기울기를 수치미분으로 검증 (00-04 방식) ★ ══════
def loss_of(zz):
    """z를 받아 손실을 돌려주는 함수 (수치미분용)"""
    return cross_entropy(y, softmax(zz))

h = 1e-5
numeric_grad = np.zeros_like(z)
for i in range(z.size):        # 00-04의 numerical_gradient와 동일한 구조
    tmp = z[i]
    z[i] = tmp + h; f_plus = loss_of(z)
    z[i] = tmp - h; f_minus = loss_of(z)
    numeric_grad[i] = (f_plus - f_minus) / (2 * h)
    z[i] = tmp                   # ★ 원상복구 필수!

print("\n--- 기울기 검증: dL/dz = ŷ - y ? ---")
print("  수치미분 :", np.round(numeric_grad, 6))
print("  공식 ŷ-y :", np.round(softmax_ce_grad(y, y_hat), 6))
print("  기울기 합:", round(float(numeric_grad.sum()), 10), "← 0이어야 정상")
🔗 GitHub에서 코드 보기 — 00_05_probability_bayes.py L223–L291
📘 코드 이해 — 수식이 코드의 어느 줄인가
| 수학공식 | 코드 | 설명 |
|---|---|---|
z - np.max(z) | 수식 ⑥ 증명 — 결과 불변, 오버플로 방지 🛡️ | |
np.exp(...) | 음수도 양수로, 차이를 증폭 | |
exp_z.sum() | 정규화 상수 → 합이 1 | |
-np.sum(y*np.log(y_hat+eps)) | 원-핫이라 정답 항만 살아남음 | |
y_hat - y | ⭐ 유도 결과가 한 줄 | |
(f_plus-f_minus)/(2*h) | 00-04의 중심차분으로 채점 🔗 |
🧩 코드 설명 — Python/NumPy 기초
•
eps = 1e-15— 예측 확률이 정확히 0이면 가 되어nan이 퍼집니다. 아주 작은 값을 더해 막는 표준 방어 기법입니다. 3단계에서 분모 0을 막았던 것과 같은 철학이죠. 🛡️\
\
•y * np.log(y_hat)— 원-핫 벡터가 자동 필터 역할을 합니다. 정답이 아닌 클래스는0 * log(...)= 0이 되어 사라지므로,if문 없이 정답 항만 남습니다. 우아한 트릭입니다. ✨\
\
•np.errstate(over='ignore')— 오버플로 경고를 잠시 끄는with블록입니다. 실험을 위해 일부러 위험한 계산을 보여줄 때만 쓰고, 실제 코드에서는 절대 남용하면 안 됩니다. ⚠️\
\
•np.zeros_like(z)—z와 같은 모양·타입의 0 배열입니다. 00-04의numerical_gradient와 완전히 같은 구조입니다.\
\
•z[i] = tmp(원상복구) ⚠️ — 이 줄을 빼면 다음 성분 계산이 오염되어 에러 없이 조용히 틀립니다. 00-04에서 강조했던 그 함정입니다. 🔗
✅🟩 실행 결과
예측 확률: [0.8566 0.0859 0.0576] | 합계: 1.0
손실 L = 0.1548

--- 오버플로 테스트 (z가 아주 클 때) ---
  max 안 뺀 식: [nan nan nan] ← 폭발! 💥
  안전한 softmax: [0.090031 0.244728 0.665241]

--- 정답에 준 확률 vs 손실 ---
  정답 확률   99% → 손실 0.0101
  정답 확률   90% → 손실 0.1054
  정답 확률   50% → 손실 0.6931
  정답 확률   10% → 손실 2.3026
  정답 확률    1% → 손실 4.6052

--- 기울기 검증: dL/dz = ŷ - y ? ---
  수치미분 : [-0.143443  0.085877  0.057565]
  공식 ŷ-y : [-0.143443  0.085877  0.057565]
  기울기 합: 0.0 ← 0이어야 정상
🏆 이 장의 결승점입니다. 손으로 유도한 공식 와 00-04의 수치미분 결과가 소수점 6자리까지 완전히 일치합니다. 게다가 기울기의 합이 정확히 0이라는 것도 확인됐죠 — "누가 올라가면 누가 내려간다"는 확률의 제로섬 성질입니다. ⚖️
📌 기울기 부호도 읽어보세요: 정답인 강아지는 (음수 → 점수를 올려라 ⬆️), 오답인 고양이·토끼는 (양수 → 점수를 내려라 ⬇️). 00-04의 업데이트 식 에 넣으면 정확히 그렇게 움직입니다. 00-01부터 00-05까지가 하나의 사슬로 이어진 순간입니다! 🔗✨
💥 그리고 오버플로 테스트에서, 최댓값을 빼지 않은 순진한 구현은 에서 nan으로 무너졌지만 안전한 구현은 멀쩡히 답을 냈습니다. 수식 ⑥의 증명이 실제로 코드를 살린 것입니다. 🛡️
🛠️ 실습 5 🔵🔴
①
z를[0.5, 0.5, 3.0](토끼가 유력)으로 바꾸고 정답은 여전히 강아지일 때 손실을 구하세요. (정답: 예측 [0.0705, 0.0705, 0.859], 손실 2.652 — 크게 증가!)\
② 완벽한 예측[10, 0, 0]일 때 손실이 얼마나 작아지는지 확인하세요. (정답: 약 0.00009)\
③ 🔥 온도(temperature) 실험:softmax(z / T)에서 를 0.5, 1, 2, 5로 바꿔보세요. 가 작으면 뾰족하게(확신), 크면 평평하게(다양성) 변합니다. 이것이 ChatGPT의 "temperature" 설정입니다! 🌡️\
④ 🚀 클래스가 2개일 때 소프트맥스가 시그모이드와 같아짐을 손으로 보이세요. (힌트: — 00-04의 시그모이드! 🔗)
🐞 실수하기 쉬운 부분 & 디버깅 포인트
❌ 실수 ① 최댓값 빼기를 생략\
왜 틀리나? 점수가 커지면np.exp가inf가 되고inf/inf = nan이 됩니다. 원인: 은 float64 범위(약 ) 초과. 수정: 항상z - np.max(z). 수식 ⑥에서 결과가 같음을 증명했으니 안심하고 쓰세요.❌ 실수 ② 정규화(나누기) 누락\
합이 1이 아니면 확률이 아닙니다. 확인법:assert abs(y_hat.sum() - 1) < 1e-9를 넣으세요.❌ 실수 ③
log(0)→nan\
손실이nan이면 십중팔구 이것입니다. 수정:eps를 더하거나, 더 좋게는 log-softmax를 한 번에 계산하는 방식(프레임워크가 쓰는 방법)을 사용하세요.❌ 실수 ④ PyTorch에서 소프트맥스 이중 적용 ⭐\
nn.CrossEntropyLoss에F.softmax출력을 넣으면 두 번 적용됩니다. 에러는 안 나지만 학습이 이상하게 느려집니다. 확인법: 손실이 처음부터 근처에서 잘 안 내려가면 의심하세요. 수정: 모델은 raw logit을 출력.❌ 실수 ⑤ 배치 차원 착각\
데이터가 여러 개면axis를 지정해야 합니다.np.exp(z).sum()은 전체 합이라 배치가 섞여버립니다. 수정:sum(axis=-1, keepdims=True). 확인법: 각 행의 합이 1인지print(p.sum(axis=-1)).✅ 검산 습관: ① 합이 1인지 ② 모두 0 이상인지 ③ 유도한 기울기를 수치미분으로 채점. 이 세 가지면 충분합니다. 🛡️
🔴 심화 — 나이브 베이즈 스팸 필터: 3단계를 실무로
3단계에서 배운 오즈 형태가 실제 제품이 되는 순간을 봅시다. 스팸 필터는 메일의 단어를 하나씩 보며 우도비를 곱해 나갑니다.
💜 더 쉽게 이해하기 — 📮 우체국 분류원
노련한 분류원은 편지를 훑으며 단서를 하나씩 누적합니다. "무료" 발견 → 스팸 쪽으로 한 칸 🔴, "회의" 발견 → 정상 쪽으로 한 칸 🟢. 마지막에 저울이 어느 쪽으로 기울었는지 보고 결정합니다. ⚖️
🔬 수학공식 ⑨ — 나이브 베이즈
단어들이 서로 독립이라고 순진하게(naive) 가정하면, 우도가 곱셈으로 쪼개집니다.
말로 옮기면: 사후 오즈 = 사전 오즈 × (우도비들의 곱) — 3단계 오즈 공식에 곱셈 항이 여러 개 붙었을 뿐입니다!\
\
실무 팁 ⚠️: 단어가 수백 개면 곱이 아래로 내려가 0으로 뭉개집니다(언더플로). 그래서 로그를 씌워 곱셈을 덧셈으로 바꿉니다.📌 왜 "naive"인가? 실제로 "무료"와 "당첨"은 함께 등장하는 경향이 있어 독립이 아닙니다. 가정이 틀렸는데도 분류 성능은 놀랍도록 좋습니다 — 순위만 맞으면 되기 때문입니다. 😄
🐍 Python — 오즈를 누적하는 미니 스팸 필터
import math

# 단어별 우도비 LR = P(단어|스팸) / P(단어|정상)
#   LR > 1 이면 스팸 쪽 증거, LR < 1 이면 정상 쪽 증거
LIKELIHOOD_RATIO = {
    "무료": 10.0,   # 스팸에 10배 자주 등장
    "당첨": 20.0,   # 강력한 스팸 신호
    "회의": 0.1,    # 정상 메일에 10배 자주 등장
    "보고서": 0.2,
}

def spam_probability(words, prior=0.3):
    """
    나이브 베이즈로 스팸 확률을 구합니다.
        사후 오즈 = 사전 오즈 × ∏(우도비)

    비유:
    우체국 분류원이 단어를 하나씩 보며
    저울추를 스팸/정상 쪽으로 옮기는 것과 같습니다.
    """
    # 로그로 계산 (곱셈 → 덧셈, 언더플로 방지)
    log_odds = math.log(prior / (1 - prior))      # 사전 로그 오즈

    for w in words:
        if w in LIKELIHOOD_RATIO:
            log_odds += math.log(LIKELIHOOD_RATIO[w])   # 증거 누적!

    odds = math.exp(log_odds)                # 로그 오즈 → 오즈
    return odds / (1 + odds)                  # 오즈 → 확률

for mail in [["무료", "당첨"], ["회의", "보고서"], ["무료", "회의"]]:
    print(f"{' '.join(mail):)
🔗 GitHub에서 코드 보기 — 00_05_probability_bayes.py L295–L325
✅🟩 실행 결과
무료 당첨       → 스팸 확률 99.4%
회의 보고서     → 스팸 확률  0.9%
무료 회의       → 스팸 확률 30.0%
🔍 해석: "무료 당첨"은 우도비 배로 밀어붙여 99.4%. "회의 보고서"는 배라 오히려 정상 쪽으로 크게 기울어 0.9%. 재미있는 것은 "무료 회의"인데, 로 증거가 정확히 상쇄되어 사전 확률 30%가 그대로 남았습니다! ⚖️ 오즈 곱셈의 직관이 그대로 드러나는 사례입니다.
📝 연습문제
🧠 개념 문제
Q1 🟢 검사 정확도가 99%로 높은데도 희귀병에서 양성 판정의 신뢰도가 낮은 이유를 인원수로 설명하세요.
Q2 🔵 와 가 다른 이유를 분할표의 "방향" 개념으로 설명하세요.
Q3 🔵 소프트맥스에서 최댓값을 빼도 결과가 변하지 않는 이유를 수식으로 증명하세요.
🧮 계산 문제
Q4 🟢 주사위를 4번 던져 6이 적어도 한 번 나올 확률을 구하세요.
Q5 🔵 발병률 2%, 정확도 95%, 오탐률 10%일 때 양성 후 발병 확률을 구하세요.
Q6 🔴 Q5를 오즈 형태로 다시 풀어 같은 답이 나오는지 확인하세요.
Q7 🔵 시험 점수가 일 때, 90점은 상위 몇 %인가요?
💻 구현 문제
Q8 🔵 bayes_posterior()를 여러 시나리오 리스트로 받아 표 형태로 한 번에 출력하는 함수를 작성하세요.
Q9 🔴 배치 버전 소프트맥스를 작성하세요 — 입력이 (배치, 클래스) 2차원일 때 각 행의 합이 1이 되어야 합니다.
🚀 사고 확장 문제
Q10 🔴 1차 양성인 사람에게만 독립적인 2차 검사를 하면 최종 확률은? 왜 실제 병원이 재검사를 하는지 설명하세요.
Q11 🔴🚀 소프트맥스+교차엔트로피의 기울기가 로 단순해지는 것이, 00-03 선형회귀의 기울기가 잔차였던 것과 어떤 공통점이 있나요?
✅ 해설
A1. 10만 명 중 환자는 100명뿐이고 비환자가 99,900명입니다. 환자 중 양성은 99명이지만, 비환자의 5%만 헛짚어도 4,995명입니다. 진짜(99)가 가짜(4,995)에 50배 넘게 묻혀 비율이 1.94%로 떨어집니다. 비율은 작아도 모수가 크면 절대 인원수는 거대해집니다.
A2. 분자(교집합 160명)는 같지만 분모가 다릅니다. 는 표를 가로로 나누고(조건이 행), 는 세로로 나눕니다(조건이 열). 160/400=0.4 vs 160/200=0.8. "세로줄(|) 뒤가 분모"를 기억하세요.
A3. . 공통 인수 가 분자·분모에서 약분됩니다. ∎
A4. 여사건 사용: . 직접 세면 훨씬 복잡합니다.
A5. .\
A6. 사전 오즈 , 우도비 .\
사후 오즈 → 확률 ✅ A5와 일치합니다!A7. . 밖이 약 4.55%이고 한쪽만 보면 약 2.3%입니다. 즉 상위 2.3%.
A8. 함수는 수정할 필요 없이 호출부만 감싸면 됩니다.\
for pr, lk, fp in zip(priors, likes, fprs): print(f"{pr:.1%} {bayes_posterior(pr,lk,fp):.2%}")\
zip()이 세 리스트를 병렬로 묶어줍니다. 이렇게 함수는 작게, 조합은 밖에서 하는 것이 좋은 설계입니다.A9.
axis와keepdims가 핵심입니다.\
e = np.exp(z - z.max(axis=-1, keepdims=True))\
return e / e.sum(axis=-1, keepdims=True)\
keepdims=True가 없으면 브로드캐스트가 어긋나 엉뚱한 결과가 나옵니다. 검증:print(p.sum(axis=-1))이 전부 1인지 확인.A10. 1차 사후 확률 1.94%를 2차의 사전 확률로 넣습니다. 결과는 28.18%, 3차까지 하면 88.60%입니다. 오즈로 보면 매번 우도비 19.8배씩 곱해지는 것이죠. 1차 검사는 "싸고 넓게 거르는 그물", 2차는 "비싸고 정확한 확인" — 이 조합이 비용과 정확도를 모두 잡는 실제 의료 전략입니다. 🏥
A11. 둘 다 "예측 − 정답" 형태입니다. 선형회귀는 , 분류는 . 이는 우연이 아니라, 손실 함수와 출력 함수가 짝을 이루도록 설계되었기 때문입니다(회귀는 MSE+항등함수, 분류는 교차엔트로피+소프트맥스). 덕분에 어떤 문제든 "틀린 만큼 그 방향으로 고친다"는 같은 코드로 학습할 수 있습니다. 이것이 딥러닝 프레임워크가 다양한 문제를 동일한 인터페이스로 다루는 비결입니다. 🎯
✨ 이번 장에서 배운 내용
🎯 개념 요약
🎲 확률 — , 여사건, 대수의 법칙\
🔀 조건부 확률 — 분모를 좁히는 연산, 곱셈정리\
🏥 베이즈 정리 — 사전 × 우도 ÷ 증거, 오즈 형태\
🔁 반복 갱신 — 사후를 다음 사전으로 (1.94→28.2→88.6%)\
🔔 정규분포 — PDF, z-점수, 68-95-99.7, 중심극한정리\
🗳️ 소프트맥스 — 점수→확률, max 빼기 증명\
🎁 기울기 — (00-04와 연결)
📌 핵심 문장 3가지
① 🔀 조건부 확률은 분모를 갈아끼우는 연산이며, 와 는 분모가 달라 완전히 다른 값이다.\
\
② 🏥 베이즈 정리는 사전 확률 × 우도비로 믿음을 갱신한다 — 사건이 희귀하면 정확한 검사도 신뢰도가 낮아진다.\
\
③ 🗳️ AI 분류기는 소프트맥스로 확률을 내고 교차 엔트로피로 채점하며, 그 기울기는 놀랍도록 단순한 이다.
☑️ 개념 체크리스트 (성취 기준)
☐ 주사위에서 "5 이상이 나올 확률"을 계산할 수 있다 (정답 1/3) 🟢\
☐ "적어도 한 번"을 여사건으로 푸는 이유를 설명할 수 있다 🟢\
☐ 대수의 법칙과 오차가 로 줄어드는 것을 설명할 수 있다 🟢\
☐ 와 가 왜 다른지 분할표로 설명할 수 있다 🟢⭐\
☐ 곱셈정리에서 베이즈 정리를 직접 유도할 수 있다 🔵⭐\
☐ 발병률·정확도·오탐률로 사후 확률을 계산할 수 있다 🔵⭐\
☐ 희귀병에서 오탐률이 정확도보다 중요한 이유를 설명할 수 있다 🔴\
☐ 오즈 형태로 베이즈를 암산할 수 있다 🔴\
☐ 사후 확률을 다음 사전으로 쓰는 반복 갱신을 구현할 수 있다 🔴🚀\
☐ 정규분포 PDF를 직접 구현하고 SciPy와 대조할 수 있다 🔵\
☐ z-점수를 구하고 68-95-99.7로 흔함/드묾을 판단할 수 있다 🔵\
☐ 중심극한정리로 "왜 정규분포가 흔한가"를 설명할 수 있다 🔴\
☐ 소프트맥스에서 max 빼기가 안전한 이유를 증명할 수 있다 🔵⭐\
☐ 교차 엔트로피가 왜 를 쓰는지 손실 표로 설명할 수 있다 🔵\
☐ 를 수치미분으로 검증할 수 있다 🔴⭐🚀
🚫 실수 방지 체크리스트
☐ 계산 시 세로줄 뒤(조건)를 분모로 잡았는가\
☐ 베이즈에서 사전 확률을 빠뜨리지 않았는가 (우도만으로 결론 금지)\
☐ 분모(증거 확률)에 오탐 경로를 더했는가 — 안 하면 결과가 항상 1\
☐ 를 1이 아닌 1 - prior로 썼는가\
☐ 함수 호출에 키워드 인자를 써서 순서 실수를 막았는가\
☐ rng.integers(1, 7)처럼 끝값 포함 여부를 확인했는가\
☐ 정규분포에 표준편차를 넣었는가 (분산 아님!)\
☐ PDF를 확률로 착각하지 않았는가\
☐ .mean(axis=?)의 방향이 맞는가\
☐ 소프트맥스에서 z - np.max(z)를 했는가\
☐ 소프트맥스 출력의 합이 1인지 확인했는가\
☐ 교차 엔트로피에 eps를 더해 log(0)을 막았는가\
☐ PyTorch에서 CrossEntropyLoss 앞에 소프트맥스를 또 붙이지 않았는가\
☐ 확률 결과가 0 <= p <= 1 범위인지 assert로 검산했는가\
☐ HTML 태그가 닫혔는가 / Mermaid 노드 ID가 ASCII인가 / 수식·코드 변수명이 일치하는가
📚 추가 학습
✏️ 직접 구현 — bayes_posterior()를 안 보고 다시 짜고, 인원수 계산으로 검산하기\
🏥 몬티 홀 문제 — 유명한 확률 역설을 베이즈로 풀고 시뮬레이션으로 검증하기 (문 바꾸면 2/3!) 🚪\
📉 정규분포 그리기 — scipy.stats.norm의 PDF와 CDF를 matplotlib으로 겹쳐 그려 관계 확인하기\
🎲 중심극한정리 시각화 — 주사위 1개/2개/5개/30개 평균의 히스토그램을 나란히 그리기\
🔥 PyTorch 비교 — F.softmax·nn.CrossEntropyLoss로 5단계를 재현하고 기울기가 인지 backward()로 확인하기\
🌡️ 온도 실험 — 언어 모델의 temperature를 바꾸면 출력이 어떻게 변하는지 소프트맥스로 재현하기\
📧 미니 프로젝트 — 이메일 100개로 나이브 베이즈 스팸 필터를 만들고 sklearn.MultinomialNB와 성능 비교하기 🚀
➡️
🔮 다음 장 예고 — 00-06. SVD·PCA — 300페이지 책을 3페이지로 📚✂️
여기까지 벡터(00-01) · 행렬(00-02) · 연립방정식(00-03) · 미분(00-04) · 확률(00-05)이라는 AI의 다섯 가지 재료를 모두 모았습니다. 🎒
다음 장에서는 이 재료들을 합쳐 "거대한 데이터에서 핵심만 뽑아내는 기술"을 배웁니다. 300페이지짜리 책의 줄거리를 3페이지로 요약하듯, 1000차원 데이터를 2차원으로 압축해도 정보 대부분이 살아남는 마법 같은 일이 벌어집니다. ✨
넷플릭스가 수백만 명의 취향을 단 몇십 개의 숫자로 요약해 추천하는 비밀, 그리고 이미지 압축과 노이즈 제거의 원리가 모두 여기에 있습니다! 🎬🔍
💻 GitHub 실습 — 코드로 직접 확인하기
📂 이 장의 코드 폴더: book/00-math-overview-for-beginners/00-05-probability-bayes
책에 실린 코드를 장(절)별로 모아 둔 폴더입니다. 아래 파일을 열어 보거나, Colab에서 바로 실행해 보세요.
| 파일 | 용도 | 링크 |
|---|---|---|
00_05_probability_bayes.py | 책의 코드 블록 6개를 순서대로 모은 실행 스크립트 (# %% 셀 구분) | 코드 보기 |
00_05_probability_bayes.ipynb | 같은 코드를 블록당 셀 1개로 담은 주피터 노트북 | 보기 · Colab |
README.md | 코드 블록 목록 · 실행 방법 · 검증 결과 | 보기 |
🎬 medium-series/07-2-normal-softmax-ce/ | Medium 시리즈 예제 — 같은 주제를 블로그용으로 다듬은 실습 | 폴더 · Colab |
🧪 저장소 검증 상태: ✅ 실행 OK
🔑 핵심 코드 1 — 소프트맥스·교차 엔트로피와 기울기 ŷ − y
📄 00_05_probability_bayes.py L225–L259 · Block 5 (📍 00-05-E · 5단계 — 소프트맥스와 교차 엔트로피: AI는 확률로 대답한다 🔵 중급)
def softmax(z):
    """
    원시 점수를 합이 1인 확률로 변환합니다.
        softmax(z_i) = exp(z_i) / Σ exp(z_j)

    비유:
    후보들의 제각각인 점수를 항상 합계 100%의 득표율로
    환산하는 선거관리위원회와 같습니다.
    """
    # ★ 최댓값 빼기: 수식 ⑥에서 증명했듯 결과는 그대로,
    #   대신 exp가 절대 넘치지 않아 안전해집니다
    exp_z = np.exp(z - np.max(z))
    return exp_z / exp_z.sum()          # 정규화 → 합이 1

def cross_entropy(y, y_hat, eps=1e-15):
    """
    L = -Σ y_i · log(ŷ_i)  — 정답과 예측의 차이를 재는 손실

    비유:
    정답에 몇 %를 줬는지 보고 채점하는 채점관입니다.
    확신하고 틀리면 벌점이 폭발합니다.
    """
    return -np.sum(y * np.log(y_hat + eps))   # eps: log(0) 방지

def softmax_ce_grad(y, y_hat):
    """수식 ⑧에서 유도한 기울기: dL/dz = ŷ - y  (단 한 줄!)"""
    return y_hat - y

# ══════ ① 기본 예측 ══════
z = np.array([3.5, 1.2, 0.8])   # 강아지, 고양이, 토끼의 원시 점수
y = np.array([1.0, 0.0, 0.0])   # 정답: 강아지 (원-핫)

y_hat = softmax(z)
print("예측 확률:", np.round(y_hat, 4), "| 합계:", round(y_hat.sum(), 6))
print(f"손실 L = {cross_entropy(y, y_hat):.4f}")
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Windows · Python 3.11.2 · numpy 2.4.6 · scipy 1.17.1, 앞 블록부터 순서대로 실행)
예측 확률: [0.8566 0.0859 0.0576] | 합계: 1.0
손실 L = 0.1548
🔑 핵심 코드 2 — 나이브 베이즈 스팸 필터
📄 00_05_probability_bayes.py L295–L326 · Block 6 (🔴 심화 — 나이브 베이즈 스팸 필터: 3단계를 실무로)
import math

# 단어별 우도비 LR = P(단어|스팸) / P(단어|정상)
#   LR > 1 이면 스팸 쪽 증거, LR < 1 이면 정상 쪽 증거
LIKELIHOOD_RATIO = {
    "무료": 10.0,   # 스팸에 10배 자주 등장
    "당첨": 20.0,   # 강력한 스팸 신호
    "회의": 0.1,    # 정상 메일에 10배 자주 등장
    "보고서": 0.2,
}

def spam_probability(words, prior=0.3):
    """
    나이브 베이즈로 스팸 확률을 구합니다.
        사후 오즈 = 사전 오즈 × ∏(우도비)

    비유:
    우체국 분류원이 단어를 하나씩 보며
    저울추를 스팸/정상 쪽으로 옮기는 것과 같습니다.
    """
    # 로그로 계산 (곱셈 → 덧셈, 언더플로 방지)
    log_odds = math.log(prior / (1 - prior))      # 사전 로그 오즈

    for w in words:
        if w in LIKELIHOOD_RATIO:
            log_odds += math.log(LIKELIHOOD_RATIO[w])   # 증거 누적!

    odds = math.exp(log_odds)                # 로그 오즈 → 오즈
    return odds / (1 + odds)                  # 오즈 → 확률

for mail in [["무료", "당첨"], ["회의", "보고서"], ["무료", "회의"]]:
    print(f"{' '.join(mail):<12} → 스팸 확률 {spam_probability(mail):.1%}")
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Windows · Python 3.11.2 · numpy 2.4.6 · scipy 1.17.1, 앞 블록부터 순서대로 실행)
무료 당첨        → 스팸 확률 98.8%
회의 보고서       → 스팸 확률 0.8%
무료 회의        → 스팸 확률 30.0%
☁️ Colab에서 바로 실행
👉 Open in Colab — 00_05_probability_bayes.ipynb · 설치 없이 브라우저에서 셀을 위에서부터 순서대로 실행하세요.
🖥️ 내 컴퓨터에서 실행하기
git clone https://github.com/otoloism/Zero_to_ML_Master.git
cd Zero_to_ML_Master
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
pip install -r book/requirements.txt   # 책 전체용 (PyTorch 등 포함, 용량 큼)
# 이 장만 실행한다면 이것만으로 충분합니다: pip install numpy scipy
cd book/00-math-overview-for-beginners/00-05-probability-bayes
python 00_05_probability_bayes.py
⭐ GitHub Star / Fork
⭐ 코드가 도움이 되셨다면 GitHub 저장소에 Star를 눌러 주세요. 새 장의 코드가 올라올 때 가장 먼저 알 수 있습니다.
🍴 직접 고쳐 보며 실험하고 싶다면 Fork 해서 내 저장소에서 마음껏 바꿔 보세요. 오류 제보·개선 제안은 Issues로 환영합니다!
🔮 다음 글 예고
다음 글은 00-06 SVD·PCA (1부) — 300페이지 책을 3페이지로 📚 입니다. 행렬을 곱해도 방향이 변하지 않는 고유벡터, 어떤 행렬이든 세 조각으로 쪼개는 SVD와 랭크-k 근사, 그리고 데이터의 가장 중요한 방향을 찾는 PCA까지 NumPy로 직접 검증합니다.
⬅️ 이전 글: #07 베이즈 정리 쉽게 이해하기 — 확률·조건부 확률과 병원 검사의 함정 (1부) \
➡️ 다음 글: #09 고유값·SVD·PCA 쉽게 이해하기 — 300페이지 책을 3페이지로 (1부)
📚 더 깊이 공부하고 싶다면
이 시리즈는 수학을 놓았던 비전공자가 AI를 직접 구현하기까지의 공부 기록을 그대로 옮긴 연재입니다. 원문 책, 코드, 개념 사전을 함께 보면 훨씬 빨리 늡니다. 🚀
| 바로가기 | 이런 분께 | |
|---|---|---|
| 📘 책 (위키독스, 무료) | Zero to 머신러닝 딥러닝 Master | 5권 · 20개 장 · 163개 절 전체를 순서대로 읽고 싶은 분 |
| 📄 이 글의 원문 | 00-05 확률·베이즈 정리 — 병원 검사의 함정 (2부) | 연습문제·해설까지 전부 보고 싶은 분 |
| 💻 실습 코드 (GitHub) | otoloism/Zero_to_ML_Master | .py·.ipynb를 Colab에서 바로 돌려보고 싶은 분 |
| 🏠 머신러닝 백과사전 | mldict.net | 본문 속 핵심 개념을 카드로 다시 확인하고 싶은 분 |
| ✍️ 기술 블로그 | wikidocs.net/blog/@mldict | 새 글 알림을 가장 먼저 받고 싶은 분 |
⭐ 도움이 되셨다면 velog 팔로우와 GitHub Star를 눌러 주세요. 다음 글을 쓰는 가장 큰 힘이 됩니다. 궁금한 점은 댓글로 편하게 남겨 주세요! 🙌