[Zero to ML Master #35] 파이썬 자료형 완전 정복 — 변수는 이름표, list·tuple·dict·set 고르는 법과 형변환·초보자 3대 에러 (02권 2부)
Zero to 머신러닝 딥러닝 Master
b = a 한 줄을 쓰고 b에 값을 하나 추가했더니 a까지 바뀌어 있던 적 있나요? 😱 파이썬을 처음 배울 때 가장 많이 겪는, 그리고 딥러닝 코드에서 역전파를 망가뜨리기도 하는 버그입니다.
원인은 하나예요. 대부분의 입문서가 "변수는 값을 담는 상자" 라고 가르치지만, 파이썬에서 변수는 물건에 붙이는 이름표입니다. 이번 글에서는 이 한 문장으로 숫자와 리스트가 다르게 움직이는 이유를 풀고, int·float·str부터 list·tuple·dict·set까지 "언제 무엇을 골라야 하는가" 를 정리합니다.
📘 이 글은 위키독스 도서 Zero to 머신러닝 딥러닝 Master 의 02-02 📦 2부 — 데이터를 담는 그릇: 자료형 을 블로그용으로 다듬은 글입니다.
💻 실습 코드: GitHub · 🏠 mldict.net · ✍️ 기술 블로그
💻 이 글의 코드:
02-02-data-types· Open in Colab — 핵심 코드와 실제 실행 결과는 글 아래 💻 GitHub 실습 섹션에 있습니다.
⬅️ 이전 글: #34 파이썬은 왜 AI의 표준 언어가 됐을까 — 탄생 이야기·Zen of Python·5대 특징과 Colab·venv 개발 환경 구축 (02권 1부) \
➡️ 다음 글: #36 if·elif·else와 for·while·컴프리헨션 — ReLU가 조건문인 이유와 에폭 루프의 시작 (02권 3부)
TL;DR — 3줄 요약
- 파이썬의
=는 복사가 아니라 이름표 붙이기입니다. 숫자·문자열은 고칠 수 없어서(임뮤터블) 재할당하면 새 물건이 생기고, 리스트·딕셔너리는 고칠 수 있어서(뮤터블)b = a뒤b.append()가a도 바꿉니다. 독립된 사본이 필요하면.copy()를 씁니다. - 순서가 필요하면 list, 바뀌면 안 되면 tuple, 이름으로 찾으면 dict, 중복 제거는 set입니다. dict와 set은 해시 덕분에 데이터가 많아도 찾는 속도가 거의 일정하고, 그래서 키는 임뮤터블만 됩니다.
/는 항상 실수,//는 몫,%는 나머지입니다. 설정값은get()으로 안전하게 읽고, 에러 메시지(SyntaxError·IndentationError·ValueError/TypeError)는 마지막 줄부터 읽으세요.
🔗 지난 글 복습: #34 파이썬은 왜 AI의 표준 언어가 됐을까 (02권 1부)에서 파이썬의 탄생 이야기와 Zen of Python, Colab·venv로 첫 코드를 실행하는 환경까지 갖췄습니다. 이번 글은 그 위에서 데이터를 담는 그릇, 자료형을 다룹니다.
02-02-D 변수 = 상자가 아니라 "이름표"
🎯 이 단원이 이 장에서 가장 중요합니다. 여기를 이해하면 4부 함수·메모리의 N·O·P단원(A~AG 단원표는 #33 참고)의 어려운 내용이 전부 자동으로 풀립니다.
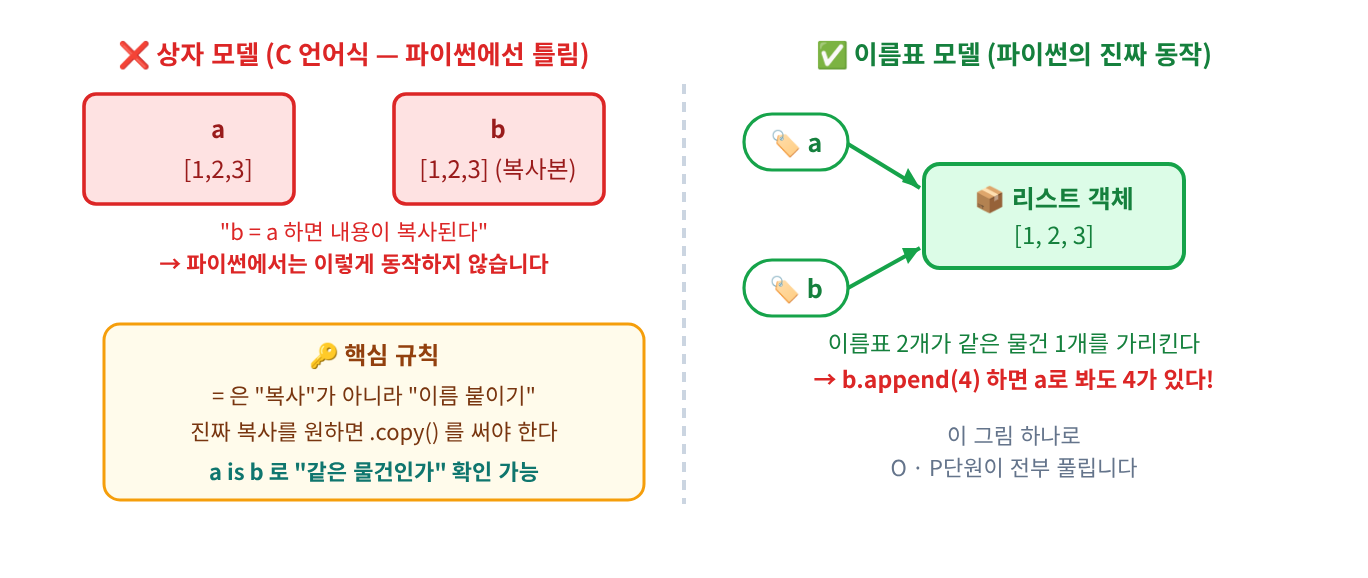
대부분의 입문서는 "변수는 값을 담는 상자"라고 가르칩니다. 이 설명은 C 언어에서는 맞지만 파이썬에서는 틀렸습니다. 그리고 이 오해가 나중에 가장 흔한 버그를 만듭니다.
🔍 더 쉽게 이해하기 — 🏷️ 택배 상자와 이름표
창고에 물건(객체)이 놓여 있고, 여러분은 거기에 이름표(변수)를 붙입니다.\
\
a = [1, 2, 3]→ 창고에 리스트를 놓고 "a"라는 이름표를 붙였다\
b = a→ 같은 물건에 "b"라는 이름표를 하나 더 붙였다 (물건 복사 아님!)\
\
🤯 그래서b.append(4)를 하면? a로 봐도 4가 들어있습니다. 물건이 하나뿐이니까요.\
"변수 = 상자"라고 생각하면 이 현상이 절대 이해되지 않습니다. "변수 = 이름표"라고 생각하면 너무나 당연합니다.
🖼️ 시각화 — 상자 모델(틀림) vs 이름표 모델(맞음)
💻 코드 — 직접 확인하기
Python — D-1: 이름표 실험
# ── 실험 1: 숫자(임뮤터블) ──
x = 10
y = x               # 같은 10에 이름표 하나 더
y = y + 1           # 11이라는 '새 물건'을 만들고 y를 그쪽으로 옮김
print("x, y:", x, y)  # x는 그대로 10

# ── 실험 2: 리스트(뮤터블) ──
l1 = [1, 2, 3]
l2 = l1             # 같은 리스트에 이름표 하나 더
l2.append(4)       # 물건 '내용'을 직접 수정!
print("l1, l2:", l1, l2)
print("같은 물건인가?", l1 is l2)   # is = 같은 객체인지 확인

# ── 실험 3: 진짜 복사하기 ──
l3 = l1.copy()      # 새 물건을 만들어 내용만 베낌
l3.append(5)
print("l1, l3:", l1, l3)
print("같은 물건인가?", l1 is l3)
🔗 GitHub에서 코드 보기 — 02_02_data_types.py L12–L29
▶ 실행 결과
x, y: 10 11
l1, l2: [1, 2, 3, 4] [1, 2, 3, 4]
같은 물건인가? True
l1, l3: [1, 2, 3, 4] [1, 2, 3, 4, 5]
같은 물건인가? False
🧠 코드 이해 — 왜 숫자는 안 옮고 리스트는 옮았나
| 코드 | 창고에서 벌어진 일 | 결과 |
|---|---|---|
y = y + 1 | 11이라는 새 물건을 만들고 y 이름표를 그쪽으로 옮김 | x는 여전히 10 ✅ |
l2.append(4) | 기존 물건의 내용을 직접 수정 (새 물건 안 만듦) | l1도 같이 바뀜 ⚠️ |
l1.copy() | 새 물건을 만들고 내용만 베껴 담음 | 서로 독립 ✅ |
👉 차이는 "새 물건을 만드느냐(재할당)" vs "기존 물건을 고치느냐(수정)"입니다. 숫자·문자열은 고칠 수 없어서(임뮤터블) 항상 새로 만들고, 리스트·딕셔너리는 고칠 수 있어서(뮤터블) 제자리에서 바뀝니다. 자세한 이유는 O단원에서 다룹니다.
🤖 딥러닝 연결 — 이걸 모르면 반드시 겪는 버그
PyTorch에서 b = a 후 b += 1(in-place 연산)을 하면 a도 같이 바뀌어 역전파가 망가집니다.\
그래서 PyTorch는 a.clone(), NumPy는 a.copy()를 제공합니다. "같은 물건인가 다른 물건인가"를 항상 의식하는 습관이 딥러닝 디버깅의 절반입니다.
⭐ 오늘의 한 줄 — 파이썬의 =는 "복사"가 아니라 "이름 붙이기"입니다.
02-02-E 기본 자료형과 연산자
🔢 5+2가지 기본 자료형
| 자료형 | 뜻 | 예시 | 딥러닝에서 |
|---|---|---|---|
| int 정수 | 소수점 없는 숫자 | 25, -3, 0 | 에폭 수, 클래스 라벨, 배치 크기 |
| float 실수 | 소수점 있는 숫자 | 0.5, 3.14 | 가중치·학습률·손실 (거의 전부!) |
| str 문자열 | 글자 | "딥러닝" | 파일 경로, 로그, 토큰 |
| bool 참거짓 | True / False | True | 마스크, 조건 판정 (🔗 ReLU 미분!) |
| None 없음 | "값이 없다"는 값 | None | 기본값, "아직 계산 안 됨" 표시 |
| list 리스트 | 순서 있는 묶음 (수정 가능) | [90, 85, 92] | 손실 기록, 배치 모으기 |
| dict 딕셔너리 | 이름표 붙은 묶음 | {"lr": 0.01} | 하이퍼파라미터, 모델 가중치 저장 |
💻 코드 — 자료형 실습
Python — E-1: 기본 자료형
# ① 정수(int) — 소수점 없는 숫자
age = 25
print(type(age))            # type() = 자료형을 알려주는 함수

# ② 실수(float) — 신경망 가중치는 거의 전부 float!
weight = 0.5
print(type(weight))

# ③ 문자열(str) — 따옴표로 감싼 글자
name = "딥러닝"
print(name + " 시작!")      # + 는 문자열을 이어 붙인다

# ④ 리스트(list) — 대괄호 [], 순서대로 담기
scores = [90, 85, 92, 78]
print(scores[0], len(scores))   # 인덱스는 0부터! len=개수

# ⑤ 딕셔너리(dict) — 중괄호 {}, 이름표로 꺼내기
student = {"이름": "김철수", "나이": 15, "점수": 92}
print(student["이름"])
🔗 GitHub에서 코드 보기 — 02_02_data_types.py L33–L51
▶ 실행 결과
<class 'int'>
<class 'float'>
딥러닝 시작!
90 4
김철수
➕ 연산자 — 특히 헷갈리는 세 가지
Python — E-2: 연산자
print(7 + 3, 7 - 3, 7 * 3, 7 / 3)   # 사칙연산 (/ 는 항상 실수!)
print(7 // 3)     # // 몫  (버림 나눗셈)
print(7 % 3)      # %  나머지 (짝/홀 판정에 필수)
print(7 ** 3)     # ** 거듭제곱 (7의 3제곱)
print(round(7/3, 4))   # round(값, 자릿수) 반올림
🔗 GitHub에서 코드 보기 — 02_02_data_types.py L55–L59
▶ 실행 결과
10 4 21 2.3333333333333335
2
1
343
2.3333
⚠️ 초보자 함정 세 가지
①
/는 항상 실수를 만듭니다.6 / 2는3이 아니라3.0입니다. 정수 몫이 필요하면//를 쓰세요.\
②7/3 = 2.3333333333333335— 마지막 5는 오타가 아닙니다. 컴퓨터가 실수를 2진수로 저장하며 생기는 부동소수점 오차입니다. 그래서 실수를==로 비교하면 안 됩니다.\
③%(나머지)는 딥러닝에서 자주 씁니다.if epoch % 50 == 0:→ "50 에폭마다 로그 출력". 🔗 01-13 코드에서 이미 봤죠.
⭐ 오늘의 한 줄 — 신경망의 가중치는 float, 라벨과 에폭은 int. 이 구분만 알면 dtype 오류의 절반이 사라집니다.
02-02-F 📦 상자 비유 심화 — 다섯 가지 수납가구 완전 정복
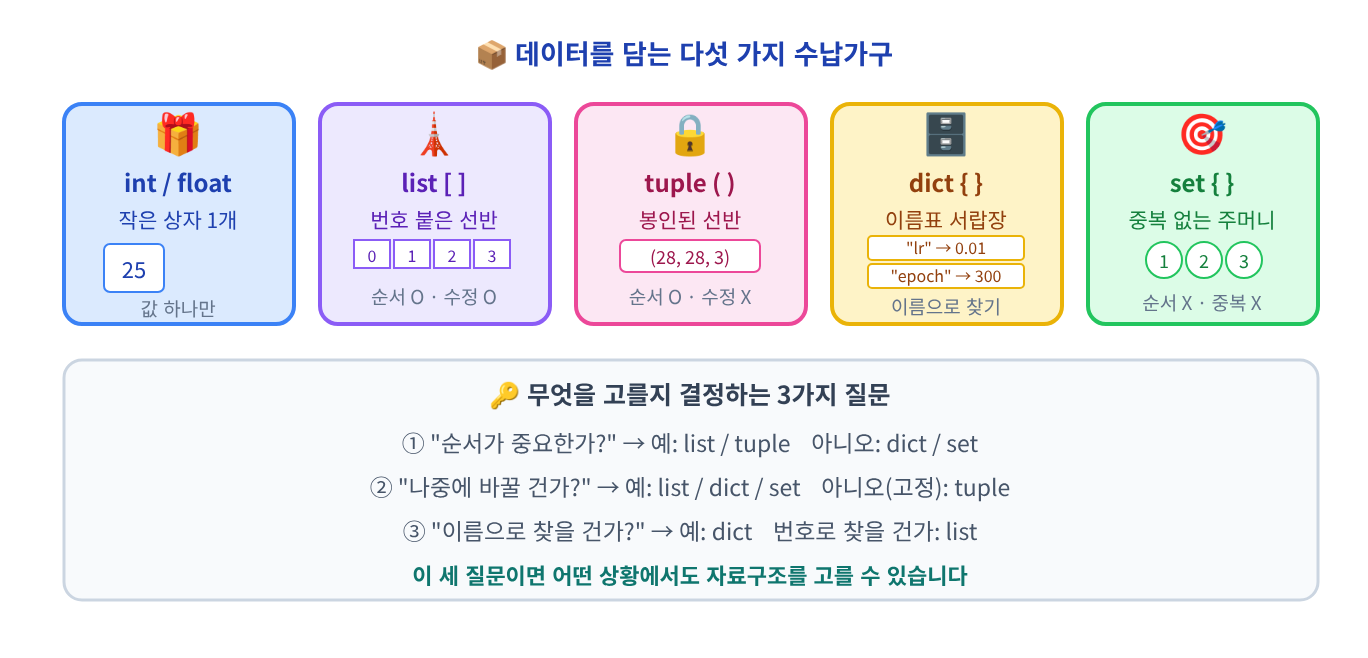
"int는 작은 상자, list는 선반, dict는 서랍장" — 여기까지는 많이 들어봤을 겁니다. 그런데 진짜 중요한 건 "언제 무엇을 골라야 하는가"입니다. 각 수납가구의 성격·속도·제약까지 파고들어 봅시다.
🏠 다섯 가구를 한눈에
🎁 ① int / float — "작은 상자 하나"의 진짜 의미
🔍 더 깊이 — 왜 이 상자는 "봉인"되어 있나
숫자 상자에는 특이한 성질이 있습니다. 내용물을 바꿀 수 없습니다(임뮤터블).\
\
📮 우표 비유 — 100원짜리 우표를 200원으로 고쳐 쓸 수 없습니다. 200원 우표를 새로 사야 하죠.\
x = 100→x = 200은 "100을 200으로 고친 것"이 아니라 "200이라는 다른 우표에 이름표를 옮긴 것"입니다.\
\
🎯 왜 이렇게 만들었나? 숫자1,2,"hello"같은 값은 프로그램 전체에서 수천 번 재사용됩니다. 고칠 수 없게 만들면 같은 값은 같은 물건 하나를 공유할 수 있어 메모리가 절약되고, 누가 몰래 고칠 걱정도 없습니다.\
실제로 파이썬은 작은 정수(-5~256)를 미리 만들어두고 재사용합니다. 이걸 "인터닝"이라고 합니다.
🗼 ② list — "번호 붙은 선반"의 장단점
🔍 더 깊이 — 🏬 백화점 물품보관함
백화점 물품보관함은 0번, 1번, 2번… 번호가 붙어 있습니다.\
✅ 장점 — "37번 칸 주세요" 하면 즉시 꺼내줍니다. 몇 개가 있든 속도가 같습니다.\
❌ 단점 — "빨간 가방 어디 있죠?" 하면 전부 열어봐야 합니다. 1만 개면 1만 번.\
\
🔢 인덱스는 왜 0부터? "선반 시작점에서 몇 칸 떨어졌나"를 세기 때문입니다. 첫 칸은 0칸 떨어진 곳이죠. 이 방식이 컴퓨터 내부 주소 계산에 가장 효율적입니다.\
📌scores[0]= 첫 번째,scores[3]= 네 번째,scores[-1]= 맨 마지막(뒤에서 1번째)
🔒 ③ tuple — "봉인된 선반"은 왜 필요한가
🔍 더 깊이 — 📜 계약서와 메모지
📝 메모지(list) — 언제든 고쳐 씁니다. 편하지만 누가 몰래 고쳐도 모릅니다.\
📜 계약서(tuple) — 한번 도장 찍으면 못 고칩니다. 불편하지만 안전이 보장됩니다.\
\
🎯 튜플이 필요한 세 가지 순간\
① 절대 바뀌면 안 되는 값 — 이미지 크기(28, 28, 3), 좌표(x, y)\
② 딕셔너리의 키로 쓸 때 — 키는 반드시 임뮤터블이어야 합니다 (I단원에서 이유 설명)\
③ 함수가 값을 여러 개 반환할 때 —return a, b는 사실 튜플을 돌려주는 것입니다\
\
NumPy의arr.shape이(3, 2)처럼 튜플인 이유 — 배열의 모양은 함부로 바뀌면 안 되기 때문입니다.
🗄️ ④ dict — "이름표 서랍장"이 마법처럼 빠른 이유
🔍 더 깊이 — 📚 도서관 사서 vs 마법 서랍장
100만 권 도서관에서 "파이썬 입문"을 찾는다고 합시다.\
🐌 list 방식 — 1번 책부터 하나씩 확인. 최악의 경우 100만 번.\
⚡ dict 방식 — 책 제목을 숫자로 바꾸는 계산(해시)을 해서, "37번 서가로 가세요"라고 즉시 알려줍니다. 한 번에 끝!\
\
🔑 이것이 해시(hash)입니다. 이름표를 넣으면 위치가 툭 튀어나오는 계산이죠. 그래서 딕셔너리는 데이터가 아무리 많아도 찾는 속도가 거의 일정합니다.\
\
⚠️ 대신 두 가지 제약이 생깁니다\
① 키는 중복 불가 — 같은 서랍에 두 물건을 넣을 수 없습니다\
② 키는 임뮤터블만 가능 — 키가 바뀌면 계산 결과도 바뀌어 물건을 영영 못 찾습니다. 그래서 list는 키로 못 쓰고 tuple은 됩니다.\
"왜 리스트는 딕셔너리 키가 안 되나요?" — 이제 답할 수 있습니다.
🎯 ⑤ set — "중복 없는 주머니"
🔍 더 깊이 — 🎟️ 입장 도장
놀이공원 입구에서 손등에 도장을 찍습니다. 같은 사람이 두 번 찍어도 도장은 하나죠. 그게 집합입니다.\
\
🎯 언제 쓰나\
· 중복 제거 —set([1,2,2,3])→{1,2,3}(한 줄로 끝!)\
· "이 안에 있나?" 초고속 확인 — dict와 같은 해시 방식이라 순식간\
· 교집합·합집합 — 두 데이터의 공통 항목 찾기\
NLP에서 "문서에 쓰인 단어 종류"를 뽑을 때 set 한 줄이면 끝납니다.
📊 다섯 가구 비교표 — 최종 정리
| 가구 | 기호 | 순서 | 수정 | 중복 | 꺼내는 법 | 딥러닝 실사용 |
|---|---|---|---|---|---|---|
| 🎁 int/float | — | — | ❌ | — | 그대로 | 학습률, 손실값 |
| 🗼 list | [ ] | ✅ | ✅ | ✅ | 번호 [0] | 손실 기록 losses.append() |
| 🔒 tuple | ( ) | ✅ | ❌ | ✅ | 번호 [0] | arr.shape = (3, 2) |
| 🗄️ dict | {k:v} | ✅* | ✅ | 키❌ | 이름 ["lr"] | state_dict() 가중치 저장 |
| 🎯 set | { } | ❌ | ✅ | ❌ | 순회만 | 단어 사전(vocabulary) 만들기 |
* Python 3.7부터 딕셔너리는 입력한 순서를 기억합니다. 단, "번호로 꺼내기"는 여전히 안 됩니다.
⭐ 오늘의 한 줄 — 순서가 필요하면 list, 고정이면 tuple, 이름으로 찾으면 dict, 중복 제거는 set.
🛑 잠깐! 초보자 체크포인트 ①
여기까지가 2부의 절반입니다. 아래 세 가지만 확인하고 넘어가세요.\
☐ a = b가 "복사"가 아니라 "이름표 붙이기"라는 걸 설명할 수 있다\
☐ 리스트 인덱스가 0부터 시작하는 이유를 말할 수 있다\
☐ "이름으로 찾을 땐 dict, 번호로 찾을 땐 list"를 예를 들어 설명할 수 있다\
→ 하나라도 막히면 D · F단원을 5분만 다시 읽고 오세요. 뒤로 갈수록 이게 계속 쓰입니다.
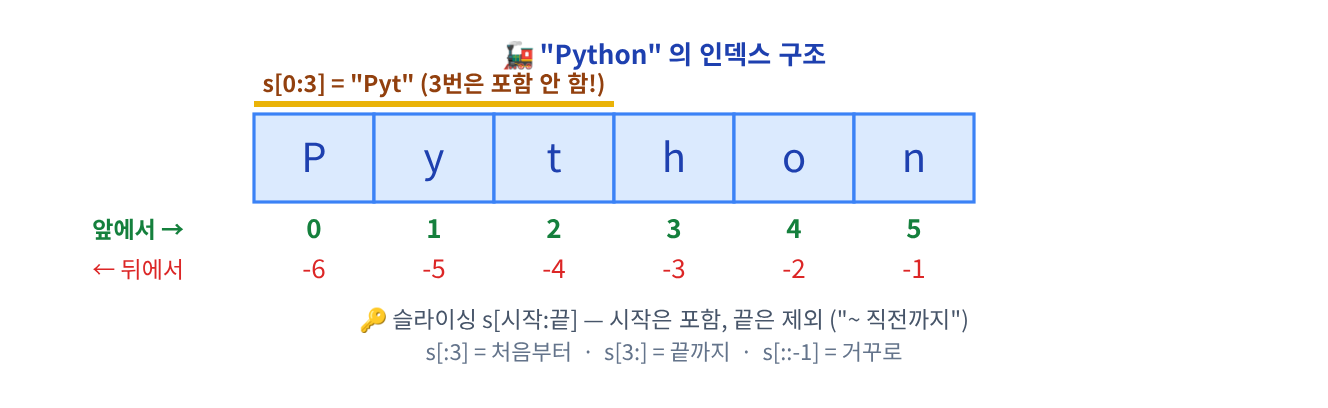
02-02-G 문자열 완전 정복 — 인덱싱 · 슬라이싱 · 포맷 · 메서드
🔍 더 쉽게 이해하기 — 🚂 글자 기차
문자열은 글자 한 칸씩 연결된 기차입니다. 각 칸에 번호가 붙어 있죠.\
"Hello"→ [H][e][l][l][o] → 번호 0 1 2 3 4\
· 인덱싱 = 한 칸만 떼어오기s[0]→"H"\
· 슬라이싱 = 여러 칸을 잘라오기s[0:3]→"Hel"\
📌 뒤에서 셀 땐 음수를 씁니다.s[-1]→ 마지막 글자"o"
🖼️ 시각화 — 인덱스와 슬라이싱
💻 코드 — 문자열 다루기
Python — G-1: 인덱싱 · 슬라이싱 · 메서드
s = "Hello Python"

# ── 인덱싱 & 슬라이싱 ──
print(s[0], s[-1])       # 첫 글자, 마지막 글자
print(s[0:5])            # 0~4번 ("5번 직전까지")
print(s[6:])              # 6번부터 끝까지
print(s[::-1])            # 거꾸로 뒤집기 (유명한 트릭!)

# ── 자주 쓰는 메서드 ──
print(s.upper(), s.lower())       # 대문자/소문자로
print(s.find("Python"))            # 위치 찾기 (없으면 -1)
print(s.replace("Hello", "Hi"))    # 바꾸기
print(s.split(" "))               # 쪼개서 리스트로 (토큰화의 기본!)
print("aaabbc".count("a"), len(s)) # 개수 세기, 전체 길이

# ── 문자열 포맷 3가지 방식 ──
print("{0:*^20}".format("안녕"))  # * 로 채워 가운데 정렬(20칸)
print(f"{3.14159:.2f}")              # f-string: 소수점 2자리 (권장!)
🔗 GitHub에서 코드 보기 — 02_02_data_types.py L63–L80
▶ 실행 결과
H n
Hello
Python
nohtyP olleH
HELLO PYTHON hello python
6
Hi Python
['Hello', 'Python']
3 12
*********안녕*********
3.14
🐍 코드 설명 — 알아두면 좋은 것들
| 문법 | 설명 |
|---|---|
f"{값:.2f}" | f-string — 문자열 앞에 f를 붙이면 중괄호 안에 변수를 바로 넣을 수 있습니다. 가장 읽기 쉬워 현대 파이썬의 표준입니다. |
"{0:*^20}" | 0=첫 번째 인자, *=채울 문자, ^=가운데 정렬(<왼쪽 >오른쪽), 20=전체 폭. 표 만들 때 유용합니다. |
\n, \t | 이스케이프 문자 — \ 뒤 글자는 특수 의미. \n=줄바꿈, \t=탭, \\=역슬래시 자체. |
s.split(" ") | 공백으로 쪼개 리스트를 만듭니다. NLP 토큰화의 가장 원시적인 형태가 바로 이것입니다. |
s[::-1] | 슬라이싱의 세 번째 값은 보폭(step). -1이면 뒤에서부터 → 문자열 뒤집기. |
🔎 유용한 판별 메서드들
isalpha()전부 문자인가 ·isdigit()전부 숫자인가 ·isalnum()문자나 숫자인가 ·isspace()전부 공백인가 ·startswith()~로 시작하나 ·endswith()~로 끝나나\
📌 사용자 입력 검증에 자주 씁니다.if not user_input.isdigit(): print("숫자만 입력하세요")\
💡 모든 문자열 기능이 궁금하다면dir(str)을 실행해보세요. 쓸 수 있는 함수 목록이 전부 나옵니다.
⭐ 오늘의 한 줄 — 슬라이싱 [시작:끝]은 "끝 직전까지"이고, 포맷은 f-string 하나만 익혀도 충분합니다.
02-02-H 리스트와 튜플 — 메서드 · 패킹 · 2차원 리스트
🗼 리스트 메서드 — 선반 관리 도구
| 메서드 | 하는 일 | 비유 |
|---|---|---|
append(x) | 맨 뒤에 하나 추가 | 선반 끝에 물건 하나 올리기 |
extend([x,y]) | 여러 개를 풀어서 추가 | 상자를 열어 내용물만 올리기 |
insert(i, x) | i번 자리에 끼워넣기 | 중간에 새치기 |
remove(x) | 값으로 찾아 첫 번째 삭제 | "빨간 컵 빼줘" |
pop(i) | 꺼내면서 값도 돌려줌 | 뽑아서 손에 쥐기 |
sort() / reverse() | 정렬 / 뒤집기 | 선반 정리 / 순서 반대로 |
x in lst | 있는지 확인 (True/False) | "이거 선반에 있어?" |
⚠️ append vs extend — 가장 헷갈리는 한 쌍
a = [1, 2]일 때\
📦a.append([3, 4])→ [1, 2, [3, 4]] — 리스트를 통째로 하나의 원소로 넣음\
📤a.extend([3, 4])→ [1, 2, 3, 4] — 상자를 풀어서 내용물만 넣음\
"상자째로 올릴 것인가, 풀어서 올릴 것인가" — 이 한 문장이면 절대 안 헷갈립니다.
💻 코드 — 리스트 실습
Python — H-1: 리스트 메서드
lst = [3, 1, 2]

lst.append(4);        print(lst)   # 뒤에 하나 추가
lst.extend([5, 6]);  print(lst)   # 풀어서 추가
lst.insert(1, 99);   print(lst)   # 1번 자리에 끼우기
lst.remove(99);       print(lst)   # 값 99를 찾아 삭제
print(lst.pop(0), lst)          # 0번을 꺼내고 값도 반환
lst.sort();             print(lst)   # 오름차순 정렬
lst.reverse();          print(lst)   # 뒤집기
print(4 in lst)                    # 4가 있는지 확인
🔗 GitHub에서 코드 보기 — 02_02_data_types.py L84–L93
▶ 실행 결과
[3, 1, 2, 4]
[3, 1, 2, 4, 5, 6]
[3, 99, 1, 2, 4, 5, 6]
[3, 1, 2, 4, 5, 6]
3 [1, 2, 4, 5, 6]
[1, 2, 4, 5, 6]
[6, 5, 4, 2, 1]
True
🔒 튜플 — 패킹과 언패킹
🔍 더 쉽게 이해하기 — 🎒 짐 싸기와 짐 풀기
📦 패킹(packing) = 여러 물건을 가방 하나에 싸기 →
t = (1, 2, 3)\
🎁 언패킹(unpacking) = 가방을 열어 물건을 각자 자리에 놓기 →a, b, c = t\
\
🤯 놀라운 사실 — 함수가 값을 두 개 반환하는return 1, 2는 사실 튜플 패킹이고,x, y = f()는 튜플 언패킹입니다. 파이썬에서 "값 여러 개 반환"은 전부 튜플입니다!
Python — H-2: 튜플과 언패킹
t = (1, 2, 3)          # 패킹: 셋을 하나로 묶음
a, b, c = t                # 언패킹: 하나를 셋으로 품
print(a, b, c)

def min_max(numbers):
    """최솟값과 최댓값을 함께 돌려줍니다."""
    return min(numbers), max(numbers)   # 사실은 튜플 반환!

low, high = min_max([5, 2, 9])   # 언패킹으로 받기
print(low, high)

# 튜플은 수정 불가! (아래를 실행하면 TypeError)
# t[0] = 99  →  TypeError: 'tuple' object does not support item assignment
🔗 GitHub에서 코드 보기 — 02_02_data_types.py L97–L109
▶ 실행 결과
1 2 3
2 9
🧮 2차원 리스트 — 행렬의 예고편
Python — H-3: 2차원 리스트와 행렬 덧셈
# 2차원 리스트 = 리스트 안에 리스트 (표 모양!)
a = [[10, 20], [30, 40], [50, 60]]

for i in range(len(a)):            # 세로 크기(행)
    for j in range(len(a[i])):     # 가로 크기(열)
        print(a[i][j], end=' ')
    print()

# ── 행렬 덧셈: 세 가지 스타일 ──
arr1 = [[1, 2], [2, 3]]
arr2 = [[3, 4], [5, 6]]

# ① 풀어쓰기 (초보자에게 가장 명확)
answer = []
for i in range(len(arr1)):
    row = []
    for j in range(len(arr1[i])):
        row.append(arr1[i][j] + arr2[i][j])
    answer.append(row)
print("① 풀어쓰기 :", answer)

# ② zip 사용 (짝지어 꺼내기)
answer2 = [[x + y for x, y in zip(r1, r2)]
           for r1, r2 in zip(arr1, arr2)]
print("② zip      :", answer2)

# ③ NumPy (7부에서 배울 방법 — 이게 진짜입니다!)
import numpy as np
print("③ NumPy    :", (np.array(arr1) + np.array(arr2)).tolist())
🔗 GitHub에서 코드 보기 — 02_02_data_types.py L113–L141
▶ 실행 결과
10 20
30 40
50 60
① 풀어쓰기 : [[4, 6], [7, 9]]
② zip      : [[4, 6], [7, 9]]
③ NumPy    : [[4, 6], [7, 9]]
🤖 딥러닝 연결 — 왜 이 세 방법을 다 보여줬나
①번은 이해하기 좋고, ②번은 짧게 쓰기 좋고, ③번은 압도적으로 빠릅니다(AD단원에서 28배 차이를 직접 측정합니다).\
🔗 zip은 여러 컬렉션을 짝지어 묶어줍니다. zip([1,2],['a','b']) → [(1,'a'),(2,'b')]. 길이가 다르면 짧은 쪽에 맞춰집니다.\
딥러닝 학습 루프의 for x, y in zip(X, T)가 바로 이것입니다 — 입력과 정답을 짝지어 꺼내기.
⭐ 오늘의 한 줄 — append는 상자째, extend는 풀어서. 그리고 return a, b는 사실 튜플입니다.
02-02-I 딕셔너리와 집합
🗄️ 딕셔너리 — 키와 값의 짝
딕셔너리는 키(key) : 값(value)이 짝을 이루어 하나의 객체를 만듭니다. 키로 값에 접근하죠. 키는 중복될 수 없고, 값은 무엇이든 가능합니다.
Python — I-1: 딕셔너리 다루기
config = {"lr": 0.01, "epochs": 300}

# ── 꺼내는 함수들 ──
print(list(config.keys()))     # 모든 키
print(list(config.values()))   # 모든 값
print(list(config.items()))    # (키, 값) 쌍 — 반복문에서 애용!

# ── get() : 없어도 오류가 안 난다 (중요!) ──
print(config.get("batch_size", 32))  # 없으면 기본값 32
# config["batch_size"]  →  KeyError 발생!

# ── 추가 · 수정 · 삭제 ──
config.update({"batch_size": 64})   # 추가(있으면 수정)
print(config)
print(config.pop("lr"), config)      # 꺼내면서 삭제

# ── 반복문에서 items() 활용 ──
for key, value in config.items():
    print(f"  {key} = {value}")
🔗 GitHub에서 코드 보기 — 02_02_data_types.py L145–L163
▶ 실행 결과
['lr', 'epochs']
[0.01, 300]
[('lr', 0.01), ('epochs', 300)]
32
{'lr': 0.01, 'epochs': 300, 'batch_size': 64}
0.01 {'epochs': 300, 'batch_size': 64}
  epochs = 300
  batch_size = 64
💡
[]vsget()— 실무에서 갈리는 선택🚨
config["없는키"]→ KeyError로 프로그램이 죽습니다\
😌config.get("없는키", 기본값)→ 조용히 기본값을 돌려줍니다\
설정값을 읽을 땐get()이 안전합니다. 반대로 "반드시 있어야 하는 값"이라면[]로 일부러 터뜨려 버그를 빨리 찾는 것도 전략입니다.
🎯 집합 — 중복 없는 주머니
Python — I-2: 집합 연산
s1 = set([1, 2, 2, 3])   # 중복 2가 자동으로 사라짐!
s2 = {2, 3, 4}

print(s1)          # 중복 제거 결과
print(s1 & s2)     # & 교집합 (둘 다 있는 것)
print(s1 | s2)     # | 합집합 (전부 모으기)
print(s1 - s2)     # - 차집합 (s1에만 있는 것)

s1.add(99)                 # 추가
s1.discard(99)             # 삭제(없어도 오류 안 남)
print(s1)
🔗 GitHub에서 코드 보기 — 02_02_data_types.py L167–L177
▶ 실행 결과
{1, 2, 3}
{2, 3}
{1, 2, 3, 4}
{1}
{1, 2, 3}
🤖 딥러닝 연결 — 이 둘이 실제로 쓰이는 곳
🗄️ 딕셔너리 — PyTorch의 model.state_dict()는 "층 이름 → 가중치 텐서" 딕셔너리입니다. 모델 저장·불러오기가 전부 이걸로 이뤄집니다.\
🎯 집합 — NLP에서 vocab = set(all_words) 한 줄로 단어 사전을 만듭니다. 중복 제거가 공짜죠.\
📌 단어 → 번호 매핑도 딕셔너리입니다: {"고양이": 0, "개": 1, ...}
⭐ 오늘의 한 줄 — dict는 items()로 순회하고 get()으로 안전하게 읽으며, set은 중복 제거 한 줄 도구입니다.
02-02-J 형변환과 초보자가 만나는 3대 에러
🔄 형변환 — 그릇을 바꿔 담기
Python — J-1: 형변환
print(int("42"))        # 문자 "42" → 숫자 42
print(float("3.14"))    # 문자 → 실수
print(str(123))         # 숫자 → 문자
print(bool(0))          # 0은 False, 나머지 숫자는 True
print(list("abc"))      # 문자열 → 글자 리스트
print(tuple([1, 2]))    # 리스트 → 튜플(봉인)
print(set([1,1,2]))     # 리스트 → 집합(중복 제거)
🔗 GitHub에서 코드 보기 — 02_02_data_types.py L181–L187
▶ 실행 결과
42
3.14
123
False
['a', 'b', 'c']
(1, 2)
{1, 2}
🚨 초보자가 반드시 만나는 3대 에러
🔴 ① SyntaxError — "문법이 틀렸어요"
SyntaxError: invalid syntax\
원인 — 괄호를 안 닫았거나, 콜론(:)을 빠뜨렸거나, =와 ==를 혼동\
해결 — 에러가 난 줄의 바로 윗줄부터 확인하세요. 괄호 안 닫음은 다음 줄에서 에러가 납니다.
🔴 ② IndentationError — "들여쓰기가 이상해요"
IndentationError: unexpected indent\
원인 — 탭과 공백을 섞어 썼거나 들여쓰기 칸 수가 안 맞음\
해결 — 공백 4칸으로 통일하세요(PEP8 규칙, Y단원). 에디터에서 "탭을 공백으로 변환" 설정을 켜두면 평생 안 만납니다.\
📌 파이썬은 들여쓰기로 코드 블록을 구분하는 유일한 주류 언어입니다. 그래서 이 에러가 특별히 중요합니다.
🔴 ③ ValueError / TypeError — "그건 못 바꿔요"
ValueError: invalid literal for int() with base 10: 'abc'\
원인 — int("abc")처럼 변환할 수 없는 값을 넣음\
해결 — 사용자 입력은 항상 try-except로 감싸세요(W단원). 또는 isdigit()으로 미리 확인.
🤖 딥러닝 연결 — dtype 오류
NumPy·PyTorch에서 가장 흔한 에러도 형(型) 문제입니다.\
RuntimeError: expected scalar type Float but found Long → 정수 텐서를 실수 자리에 넣은 것입니다.\
해결: x.float() 또는 np.array(..., dtype=float). "가중치는 float"라는 E단원 규칙을 기억하세요.
⭐ 오늘의 한 줄 — 에러 메시지는 적이 아니라 안내문입니다. 마지막 줄부터 읽으세요.
🔜 다음 부 예고 — 02-03. 🔁 3부 — 흐름 제어: 조건과 반복
데이터를 담는 그릇을 모두 갖췄습니다. 다음 부에서는 그 데이터를 조건에 따라 고르고, 반복해서 처리하는 법을 배웁니다. 신경망 학습의 에폭 루프가 바로 여기서 시작됩니다.
💻 GitHub 실습 — 코드로 직접 확인하기
📂 이 장의 코드 폴더: book/02-hello-python/02-02-data-types
책에 실린 코드를 장(절)별로 모아 둔 폴더입니다. 아래 파일을 열어 보거나, Colab에서 바로 실행해 보세요.
| 파일 | 용도 | 링크 |
|---|---|---|
02_02_data_types.py | 책의 코드 블록 10개를 순서대로 모은 실행 스크립트 (# %% 셀 구분) | 코드 보기 |
02_02_data_types.ipynb | 같은 코드를 블록당 셀 1개로 담은 주피터 노트북 | 보기 · Colab |
README.md | 코드 블록 목록 · 실행 방법 · 검증 결과 | 보기 |
🧪 저장소 검증 상태: ✅ 실행 OK
🔑 핵심 코드 1 — 이름표 실험 — 숫자는 새 물건, 리스트는 같은 물건 (is·copy)
📄 02_02_data_types.py L12–L29 · Block 1 (02-02-D 변수 = 상자가 아니라 "이름표" — 실험 1: 숫자(임뮤터블))
# ── 실험 1: 숫자(임뮤터블) ──
x = 10
y = x               # 같은 10에 이름표 하나 더
y = y + 1           # 11이라는 '새 물건'을 만들고 y를 그쪽으로 옮김
print("x, y:", x, y)  # x는 그대로 10

# ── 실험 2: 리스트(뮤터블) ──
l1 = [1, 2, 3]
l2 = l1             # 같은 리스트에 이름표 하나 더
l2.append(4)       # 물건 '내용'을 직접 수정!
print("l1, l2:", l1, l2)
print("같은 물건인가?", l1 is l2)   # is = 같은 객체인지 확인

# ── 실험 3: 진짜 복사하기 ──
l3 = l1.copy()      # 새 물건을 만들어 내용만 베낌
l3.append(5)
print("l1, l3:", l1, l3)
print("같은 물건인가?", l1 is l3)
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Linux · Python 3.13.5 · numpy 2.5.3, 앞 블록부터 순서대로 실행)
x, y: 10 11
l1, l2: [1, 2, 3, 4] [1, 2, 3, 4]
같은 물건인가? True
l1, l3: [1, 2, 3, 4] [1, 2, 3, 4, 5]
같은 물건인가? False
🔑 핵심 코드 2 — 딕셔너리로 하이퍼파라미터 관리 — keys·get·update·pop·items
📄 02_02_data_types.py L145–L163 · Block 8 (02-02-I 딕셔너리와 집합)
config = {"lr": 0.01, "epochs": 300}

# ── 꺼내는 함수들 ──
print(list(config.keys()))     # 모든 키
print(list(config.values()))   # 모든 값
print(list(config.items()))    # (키, 값) 쌍 — 반복문에서 애용!

# ── get() : 없어도 오류가 안 난다 (중요!) ──
print(config.get("batch_size", 32))  # 없으면 기본값 32
# config["batch_size"]  →  KeyError 발생!

# ── 추가 · 수정 · 삭제 ──
config.update({"batch_size": 64})   # 추가(있으면 수정)
print(config)
print(config.pop("lr"), config)      # 꺼내면서 삭제

# ── 반복문에서 items() 활용 ──
for key, value in config.items():
    print(f"  {key} = {value}")
▶ 실행 결과 — 위 코드를 실행한 출력 (직접 실행: Linux · Python 3.13.5 · numpy 2.5.3, 앞 블록부터 순서대로 실행)
['lr', 'epochs']
[0.01, 300]
[('lr', 0.01), ('epochs', 300)]
32
{'lr': 0.01, 'epochs': 300, 'batch_size': 64}
0.01 {'epochs': 300, 'batch_size': 64}
  epochs = 300
  batch_size = 64
☁️ Colab에서 바로 실행
👉 Open in Colab — 02_02_data_types.ipynb · 설치 없이 브라우저에서 셀을 위에서부터 순서대로 실행하세요.
🖥️ 내 컴퓨터에서 실행하기
git clone https://github.com/otoloism/Zero_to_ML_Master.git
cd Zero_to_ML_Master
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
pip install -r book/requirements.txt   # 책 전체용 (PyTorch 등 포함, 용량 큼)
# 이 장만 실행한다면 이것만으로 충분합니다: pip install numpy
cd book/02-hello-python/02-02-data-types
python 02_02_data_types.py
⭐ GitHub Star / Fork
⭐ 코드가 도움이 되셨다면 GitHub 저장소에 Star를 눌러 주세요. 새 장의 코드가 올라올 때 가장 먼저 알 수 있습니다.
🍴 직접 고쳐 보며 실험하고 싶다면 Fork 해서 내 저장소에서 마음껏 바꿔 보세요. 오류 제보·개선 제안은 Issues로 환영합니다!
🔮 다음 글 예고
다음 글은 #36 if·elif·else와 for·while·컴프리헨션 — ReLU가 조건문인 이유와 에폭 루프의 시작 (02권 3부) 입니다. if·elif·else로 갈림길에서 길을 고르는 법과 for·while 반복문, continue·break, 리스트 컴프리헨션을 배웁니다. ReLU가 사실 조건문 한 줄이라는 것, 그리고 신경망 학습의 에폭 루프가 바로 이 반복문에서 시작된다는 것까지 이어집니다.
⬅️ 이전 글: #34 파이썬은 왜 AI의 표준 언어가 됐을까 — 탄생 이야기·Zen of Python·5대 특징과 Colab·venv 개발 환경 구축 (02권 1부) \
➡️ 다음 글: #36 if·elif·else와 for·while·컴프리헨션 — ReLU가 조건문인 이유와 에폭 루프의 시작 (02권 3부)
📚 더 깊이 공부하고 싶다면
이 시리즈는 수학을 놓았던 비전공자가 AI를 직접 구현하기까지의 공부 기록을 그대로 옮긴 연재입니다. 원문 책, 코드, 개념 사전을 함께 보면 훨씬 빨리 늡니다. 🚀
| 바로가기 | 이런 분께 | |
|---|---|---|
| 📘 책 (위키독스, 무료) | Zero to 머신러닝 딥러닝 Master | 5권 · 20개 장 · 163개 절 전체를 순서대로 읽고 싶은 분 |
| 📄 이 글의 원문 | 02-02 📦 2부 — 데이터를 담는 그릇: 자료형 | 연습문제·해설까지 전부 보고 싶은 분 |
| 💻 실습 코드 (GitHub) | otoloism/Zero_to_ML_Master | .py·.ipynb를 Colab에서 바로 돌려보고 싶은 분 |
| 🏠 머신러닝 백과사전 | mldict.net | 본문 속 핵심 개념을 카드로 다시 확인하고 싶은 분 |
| ✍️ 기술 블로그 | wikidocs.net/blog/@mldict | 새 글 알림을 가장 먼저 받고 싶은 분 |
⭐ 도움이 되셨다면 velog 팔로우와 GitHub Star를 눌러 주세요. 다음 글을 쓰는 가장 큰 힘이 됩니다. 궁금한 점은 댓글로 편하게 남겨 주세요! 🙌