4주차: 해시테이블과 그래프
출처
📚 쉽게 배우는 자료구조 with 파이썬
🏞️ 해시테이블 이미지 출처: kkd927님의 티스토리
🏞️ 그래프 이미지 출처: 팡트루야님의 티스토리, vagabondms님의 벨로그

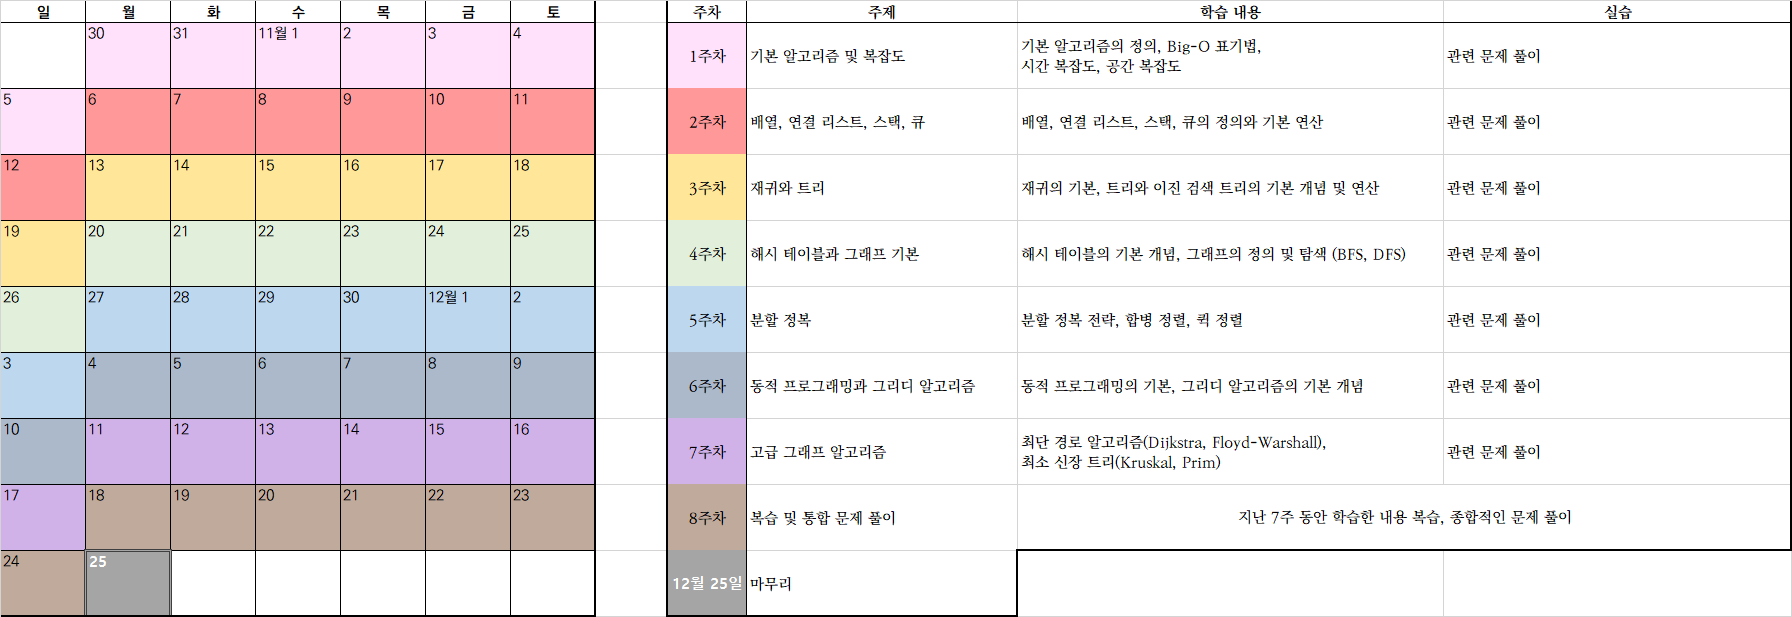
해시 테이블은 극단적으로 효율적인 자료 구조이다!
배열에 n개의 키를 저장한다면 키를 검색, 삽입, 삭제하는데에 평균 O(n) 시간, 또는 그 이상이 든다. 이를 개선한 것이 검색 트리다. 일반적인 검색 트리는 검색, 삭제, 삽입에 평균 O(logn)의 시간이 들고, 최악의 경우 O(n)시간이 든다. 최악의 경우에도 O(logn)의 시간이 들게 만든게 AVL트리, 레드-블랙 트리, B-트리 등의 균형 검색 트리이다. 그러나 이마저도 부족하다. 저장된 자료의 양에 상관 없이 평균 상수 시간 작업이 가능하게 할 수 없을까? 해시 테이블을 사용하면 가능하다! 해시 테이블은 자료의 검색, 삭제, 삽입 모두 평균 상수시간이 가능하게 하여 극단적 효율에 다다른 자료구조다. 이 비결은, 키끼리 비교해 자리를 찾는 것이 아니라 키 자신의 값에 따라 자리가 결정되는 것이다.
해시 테이블
토글에서는 언급했지만, 해시 테이블이 기존 자료구조와 달리 극단적으로 효율적인 상수시간의 복잡도를 가질 수 있었던 것은 기존 키 값과의 비교가 아닌, 자기 자신의 값에 의해 자리가 결정되기 때문이다.
👉🏻 해시 테이블에서는, 키(key)를 해시 함수에 따라 계산한 값(value)으로 자리를 찾는다.
👉🏻 새로운 값을 넣을 때, 그 주소에 이미 다른 값이 있다면 이를 충돌이라 한다.
해시 테이블의 ADT
- __table[], __numItems
- search(x), insert(x), delete(x), isEmpty(), clear()
해시 함수
바람직한 해시 함수는, 입력 키를 해시 테이블 전체에 고루 분산시켜 저장해야 한다.
두 키가 상대적으로 비슷하다고 해서, 그 해싯값도 상대적으로 비슷하지 않아야 충돌할 확률이 낮아진다.
해시 함수의 가장 대표적인 예로, 나누기 방법과 곱하기 방법이 있다.
1) 나누기 방법
h(x) = x%m- x: 키값
- m: 테이블의 크기
m은 2의 거듭제곱에 가깝지 않은 소수를 택하는 것이 좋다. 만일 m=2^p 이라면, 비슷한 수들이 인접한 자리에 위치할 것인데, 이렇게 되면 좋은 해시 함수가 아니다. 해시값은 입력 키의 모든 비트를 이용하는 것이 확률적으로 좋은 분포를 갖게 하는데 유리하다.
2) 곱하기 방법
h(x) = (xA%)*m- A: 0과 1 사이의 임의의 상수 (사전에 지정)
- m: 테이블의 크기
곱하기 방법은 나누기 방법과 달리 m의 크기를 아무렇게나 잡아도 상관 없기에, 컴퓨터의 이진수 환경에 맞게 2의 거듭제곱으로 잡는 것이 자연스럽다.
대신 A값이 해시값 분포에 영향을 준다. 크누스는 잘 작동하는 A값으로 0.6180339887을 제안했다.
해시테이블 충돌 해결
충돌 해결에는 체이닝과 개방 주소 방법이 있다.
1) 체이닝
같은 주소로 해싱되는 키를 하나의 연결 리스트에 매달아 관리한다.
따라서 해시 테이블 크기가 m이면 m개의 연결 리스트가 따로 존재할 수 있다.
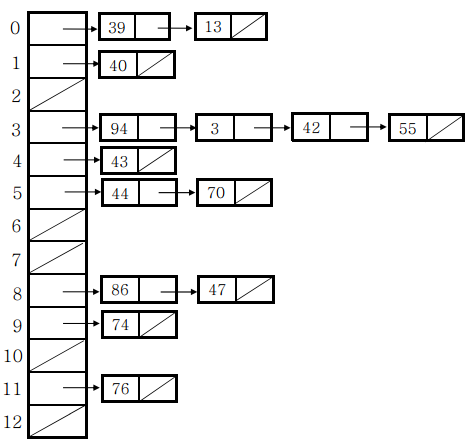
이미지는 시간상 따로 만들지 못하고 게시글 맨 위에 출처 밝히고 퍼왔다. 시간 날 때 따로 만들 예정.
체이닝을 사용하는 해시 테이블의 작업
insert(x):
	리스트 table[h(x)]의 맨 앞에 x를 삽입

search(x):
	리스트 table[h(x)]에서 x값 가지는 키 검색

delete(x):
	리스트 table[h(x)]에서 x의 노드 삭제
체이닝은 적재율이 1을 넘어도 사용할 수 있다는 장점이 있다.
2) 개방 주소 방법
체이닝과 달리 추가 공간을 사용하지 않고, 어떻게든 주어진 테이블 공간에서 해결한다.
충돌이 발생한 경우, 다음 해시 함수를 계속 계산해서 다른 자리를 확인한다.
👉🏻 개방 주소 방법을 사용하는 해시 테이블의 작업
insert(x):
	i <-0
    repeat
    	j <- h1(x)
        if (table[j] = null or table[slot] = DELETE)
        	table[j] <- x
            return j
        else i++
    until (i=m)
    error "table overflow"

search(x):
	i <-0
    repeat
    	j <- h1(x)
        if (table[j] = x) return j
        else i++
    until (table[j] = null or i = m)
    return NOT_FOUND

delete(x):
	i <-0
    repeat
    	j <- h1(x)
        if (table[j] = x)
        	table[j] <- DELETED;
        	break
    	else i++
	until (table[j] = null or i = m)
개방 주소 방법은 주어진 공간만 사용할 수 있으므로 적재율이 1을 넘을 수 없다.
적재율이 어느 정도 이상 높아지면 효율이 급격히 떨어지므로, 설정해 둔 적당한 임계점을 넘어가면 크기를 두 배로 키우는 것이 일반적이다.
개방 주소 방법의 충돌 해결 방법: 선형 탐색, 이차원 탐색, 더블 해싱...👉 Python에서 해시테이블을 가장 효율적으로 사용할 수 있는 방법
: 딕셔너리(dict) 를 이용하는 것!
- 딕셔너리 검색&인덱싱 시간복잡도는 O(1)이다.
- 리스트의 경우 인덱싱 시간복잡도는 O(1)이지만, 검색은 O(n)의 시간복잡도가 든다.
그래프
현상이나 사물을 정점(노드)과 간선으로 표현한 것. 방향, 무방향 모두 존재한다.
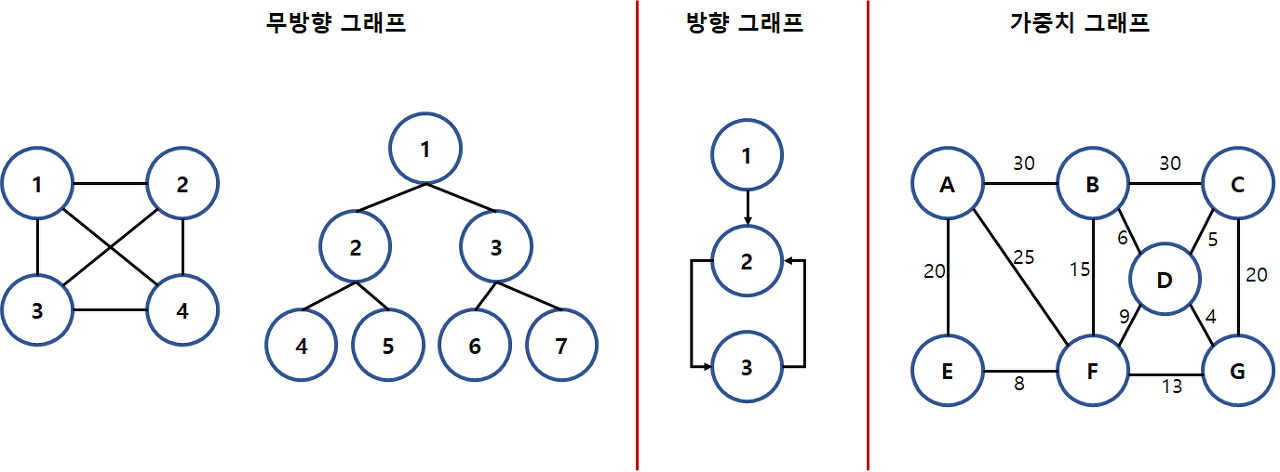
- 집합 V와 이들 사이에 존재하는 간선 집합 E로 구성된 그래프 G를 보통 G=(V, E)로 표시한다.
- 정점 u와 정점 v를 잇는 무방향 간선은 {u->v}로,
- 정점 u와 정점 v를 잇는 방향 간선은 (u->v)로 표시한다.
그래프의 순회
그래프를 순회하는 대표적인 방법은 BFS(너비 우선 탐색)와 DFS(깊이 우선 탐색)가 있다.
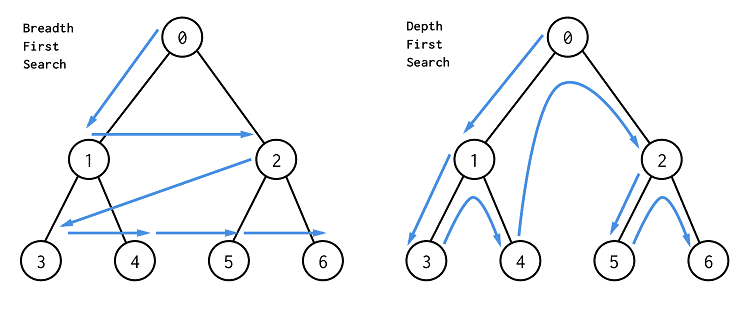
BFS (너비 우선 탐색)
차례로 살펴보면 다음과 같다.
(1) 시작 정점을 방문한다.
(2) 시작 정점에 인접한 정점을 모두 방문한다.
(3) 방문한 정점들의 인접한 정점을 모두 방문한다.
(4) 이를 반복하다 방문하지 않은 정점이 없어 더이상 갈곳이 없다면 끝낸다.
👉🏻 BFS 알고리즘은 다음과 같이 큐 자료구조를 활용한다.
BFS(G, s):
	for each v
    	v.visited <- NO
    s.visited <- YES   (S: 시작 정점)
    enqueue(Q, s)
    while (Q != NULL)
    	u <- dequeue(0)
        for each v in u.adj   (u.adj: 정점 u의 인접 정점 집합)
        	if (v.visited = NO)
            	v.visited <- YES
                enqueue (Q, v)
- 시작 정점을 제외한 모든 정점을 NO라고 둔다.
- 큐의 맨 앞에 있는 정점 s(초기: 시작정점)를 빼내고, 이에 인접한 정점 중 방문하지 않은 정점을 YES로 표시하고 큐에 넣는다.
- 이 작업을 반복한다.
- BFS()가 수행되는 동안, 정점 s에서 도달 가능한 모든 정점은 enqueue()와 dequeue()를 통해 한번씩 큐에 들어갔다가 나온다.
DFS (깊이 우선 탐색)
차례로 살펴보면 다음과 같다.
(1) 시작 정점을 방문한다.
(2) 시작정점에 인접한 정점 중 하나를 방문한다(2라고 한다).
(3) 정점2에 인접하면서 방문하지 않은 정점을 방문한다(3이라고 한다).
(4) 정점3에 인접한 정점은 2개이고, 이 중 하나를 방문한다(4라고 한다).
(5) 정점4에 인접한 정점이 없다고 할 때, 왔던 길로 되돌아간다. 정점3에 인접한 정점 중 방문하지 않은 정점은 하나이고, 이를 방문한다(5라고 한다).
(6) 정점5에 인접한 정점이 없다고 할 때, 왔던 길로 되돌아간다. 정점3에 인접한 정점 중 방문하지 않은 정점이 없으므로 정점 2로 되돌아간다.
(7) 이렇게 반복하며 더 이상 방문할 정점이 없다면 끝낸다.
DFS 알고리즘은 다음과 같이 재귀로 구현한다.
DFS(G, v):
v.visited <- YES
for each x in v.adj    (v.adj: 정점 v의 인접 정점 집합)
	if (x.visited = NO) DFS(G,x)
문제풀이 링크 - 해시테이블 기본, BFS와 DFS