1. Introduction
1.1 소개
Wav2Vec과 Whisper의 차이
-
학습 방식:
- Wav2Vec은 자기지도 학습 (self-supervision) 모델.
- Whisper는 약지도 학습 (weak supervision) 모델.
-
학습 데이터 규모:
- Wav2Vec: 1백만 시간의 비라벨링 음성 데이터.
- Whisper: 68만 시간의 약지도 음성 데이터.
- 117,000시간: 다국어 전사.
- 125,000시간: 다국어 번역.
- 나머지: 영어 전사 및 번역 데이터.
-
모델 구조:
- Wav2Vec: Encoder 전용 모델.
- 후처리 및 별도 Decoder 필요.
- Whisper: Encoder-Decoder 통합 모델.
- Fine-tuning 없이 바로 사용 가능(Zero-Shot).
- Wav2Vec: Encoder 전용 모델.
Whisper의 목표
- 약지도 데이터를 활용해 Wav2Vec과 같은 자기지도 학습 모델의 성능 격차를 줄이는 것.
- 다국어 및 다중 작업(multitask) 학습으로 범용성과 견고성을 확보.
Whisper의 장점
- Zero-Shot 환경에서도 높은 성능 제공.
- Fine-tuning 없이 다양한 도메인에서 바로 사용 가능.
- 통합 설계를 통해 후처리 필요성 감소.
2. 접근
2.1 Data Processing
데이터 전처리를 최소화 하였음
: OpenAI 연구진은 audio와 text 데이터에 대해 전처리를 거의 하지 않았음.
목표: 모델의 학습 능력 활용
- 표준화되지 않은(raw) 텍스트와 오디오 데이터를 학습하며 발화(utterance)와 전사(transcribed form) 간의 관계를 스스로 이해하도록 설계함.
ITN(Inverse Text Normalization) 제거
-
기존 음성 인식 시스템에서 자연스러운 전사를 위해 사용되는 ITN 과정을 제거하여 speech recognition pipeline을 단순화함.
-
예시: 12월 23일,이 아니라 실제 발화 내용인 십이월 이십삼일로 하는 것
Whisper는 기존 음성 인식 모델이 일반적으로 수행하는 전처리 단계를 의도적으로 생략하여 데이터셋 구성에 있어 다음과 같은 장단점을 가짐.
Machine-Generated Transcription Filtering
: 기계 생성 전사 데이터가 혼합되면 모델 성능에 부정적 영향을 미친다는 선행 연구 결과를 바탕으로, OpenAI 연구진은 다음과 같은 필터링 기법을 적용했음.
단순 규칙 기반 필터링
- 모두 대문자(all-uppercase) 또는 모두 소문자(all-lowercase) 전사 제외.
- 쉼표와 같은 구두점이 전혀 포함되지 않은 전사 제외.
- 언어 감지 모델 활용(CLD2-발화 = 영어 / 스크립트 = 영어 인지 확인하는 모델)
WER 기반 수동 검토
- 학습 중간에, WER이 높은 데이터셋은 추가 검토
Fuzzy Deduplication을 사용
- 유사 전사 데이터 삭제
- 자동 생성 컨텐츠 삭제 유도
평가 데이터셋을 훈련 데이터셋과 아예 분리하여 zero shot 환경 구축
30초 단위 전사, 발화되지 않는 무음의 환경도 포함.
2.2 Model
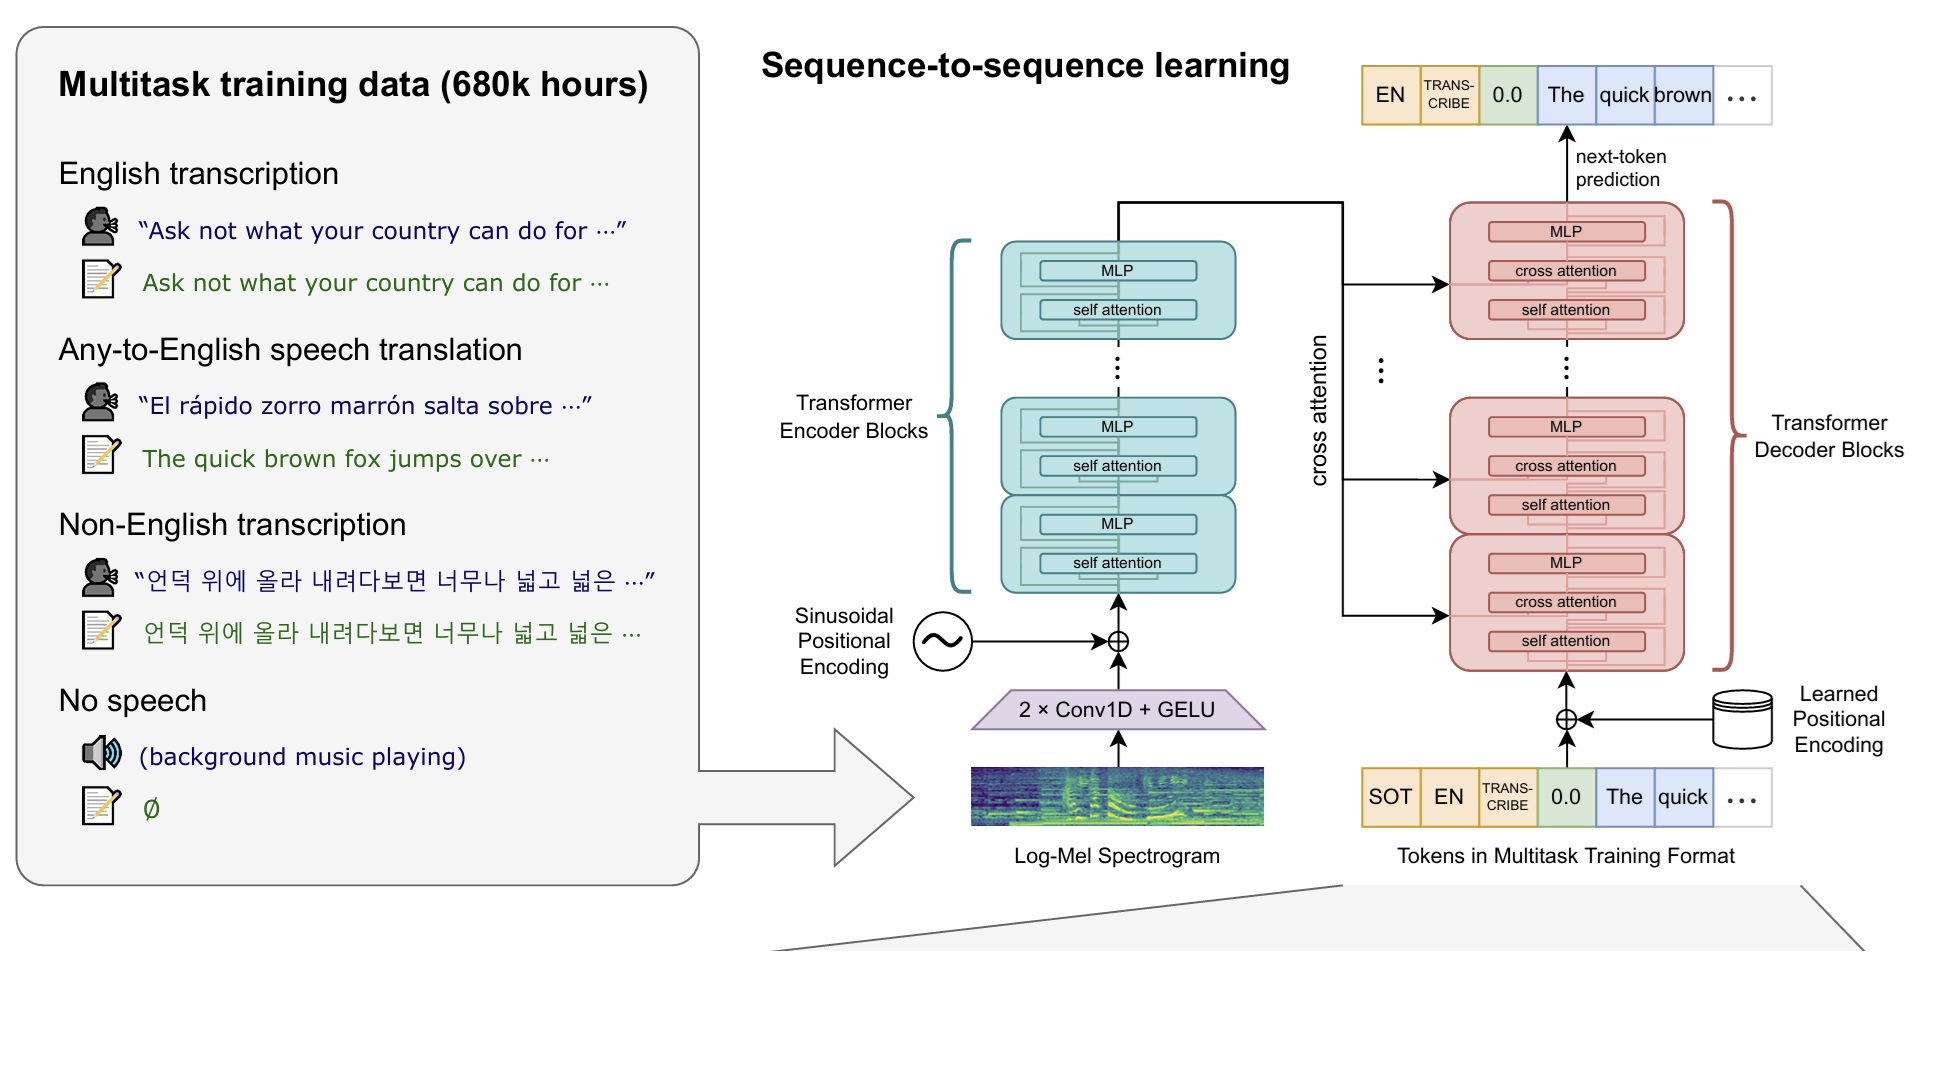
기반 아키텍처: Transformer
Sampling Rate: 16 kHz
Log-Mel Spectrogram:
- 80채널 스펙트로그램 생성.
- 윈도우 크기: 25밀리초.
- 스트라이드: 10밀리초.
- 생성된 스펙트로그램을 -1 ~ 1 사이로 정규화.
Convolution Layers:
- 2개의 Conv 레이어를 Log-Mel Spectrogram에 적용.
- Conv 레이어는 필터 너비 3과 스트라이드 2를 사용.
- 활성화 함수: GELU (Gaussian Error Linear Unit).
Tokenizer: GPT-2에서 사용된 BPE(Byte Pair Encoding) 기반 텍스트 토크나이저 사용.
2.3 Multitask Format
음성 인식(speech recognition)에는 단순히 audio-to-word prediction뿐 아니라, voice activity detection, speaker diarization, inverse text normalization과 같은 다양한 태스크가 포함됨.
일반적으로 모델들은 특정 태스크에 맞게 fine-tuning 되어 설계되며, 동시에 여러 태스크를 수행하지 못하는 한계가 있음.
Whisper의 멀티태스크 처리 방식
Whisper는 모든 태스크를 단일 모델에서 처리하도록 설계되었으며, 이를 위해 task와 조건(conditioning information)을 decoder의 input에 sequence 정보로 포함하여 제공함.
이를 통해 transcription, translation, timestamp prediction 등 여러 태스크를 한 모델에서 수행 가능하게 만듦.
Decoder 훈련에 사용되는 Token 종류
- Text Token: 전사된 텍스트를 나타내는 토큰.
- Special Token: 태스크와 조건을 지정하는 데 사용됨.
<|nospeech|>: 해당 오디오에 음성이 없음을 나타냄.<|transcribe|>: 오디오를 전사(transcription)할 것을 지정.<|translate|>: 오디오를 번역(translation)할 것을 지정.<|startoftranscript|>: 전사 시작을 나타냄.<|notimestamps|>: 타임스탬프를 제외할 것을 지정.<|endoftranscript|>: 전사 종료를 나타냄.
- Timestamp Token: 타임스탬프 예측에 사용되며, Whisper는 20ms 단위로 시간을 양자화(quantize)하여 처리.
눈여겨볼 점
Whisper의 특이점은 태스크와 조건 정보(task와 conditioning information)를 special token으로 제공하여, 단일 모델에서 멀티태스크를 효과적으로 수행할 수 있도록 설계했다는 점.
이는 기존 음성 인식 시스템에서 복잡한 파이프라인을 단순화하는 데 크게 기여함.
2.4 Training Details
Whisper는 다양한 크기의 모델을 훈련하여 모델 확장(scaling) 특성을 연구함.
모델은 FP16 기반 데이터 병렬 처리와 dynamic loss scaling, activation checkpointing 기법을 사용하여 훈련되었음.
훈련 설정
- Optimizer: AdamW
- Gradient Clipping: 사용
- Learning Rate 스케줄:
- 초기 2048 업데이트 동안 워밍업(warm-up).
- 이후 선형적으로 0으로 감소.
- 배치 크기: 256개 세그먼트
- 훈련 반복: 총 2~3 에포크 (220 업데이트)
- 제한된 에포크로 인해 과적합(overfitting) 우려는 적음.
- 데이터 증강 및 정규화: 사용하지 않음. 대신 데이터셋의 다양성(diversity)을 활용하여 일반화와 견고성을 확보.
3. Experiments
3.1 Zero-Shot Evaluation
Whisper의 목표는 특정 데이터셋의 미세 조정(fine-tuning) 없이도 다양한 분포와 환경에서 높은 성능을 발휘하는 견고한 음성 처리 시스템을 개발하는 것.
-
다양한 음성 처리 데이터셋을 활용해, Whisper가 도메인, 태스크, 언어 전반에서 일반화 성능을 갖추고 있는지 평가.
-
Zero-shot 설정: 데이터셋의 학습(train) 데이터는 전혀 사용하지 않고, 테스트 데이터만으로 평가.
3.2 Evaluation Metrics
-
평가 지표: WER (Word Error Rate)
- WER은 문자열 편집 거리 기반으로, 사소한 형식적 차이도 벌점으로 간주함.
- Whisper와 같은 zero-shot 모델에는 불리하게 작용할 수 있음.
-
문제 해결:
- WER 계산 전 텍스트를 표준화(standardization)하여 의미적 차이가 아닌 형식적 차이에 따른 벌점을 최소화.
- 이를 위해 수작업으로 반복 검토를 거쳐 텍스트 정규화기를 개발.
: 이는 텍스트 전처리가 아니라 평가 전 후처리에 해당