엔코아 AIO 3기 프리코스 - 파이썬 2일차.
오늘은 Python 기초 Ch.4를 학습했다.
[오늘 다룬 범위]
시퀀스 자료형: 리스트, 튜플, 세트, 딕셔너리
제어문: for문, while/break/continue, List comprehension
시퀀스 자료형
1. 리스트(List)
리스트는 파이썬에서 가장 유연한 자료형이라고 했다. 서로 다른 자료형의 항목을 섞어 담을 수 있고, 대괄호로 요소를 담고, 순서(인덱스)가 있어서 인덱싱·슬라이싱이 되고, 가변(mutable) 자료형이라 인덱싱·슬라이싱으로 요소 값 자체를 직접 수정할 수 있다는 게 핵심 개념이었다.
<실습>
squares = [1, 4, 9]를 만들고len()으로 길이 확인, 인덱싱(squares[0],squares[-1])과 슬라이싱(squares[:]) 실습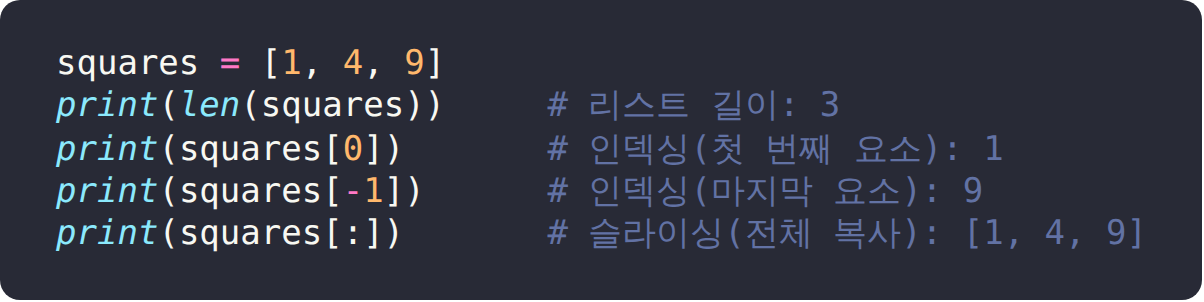
- 리스트끼리
+로 합치기,*로 반복하기 (단, 원본 리스트에 재할당하지 않으면 값은 그대로 유지된다는 것도 확인)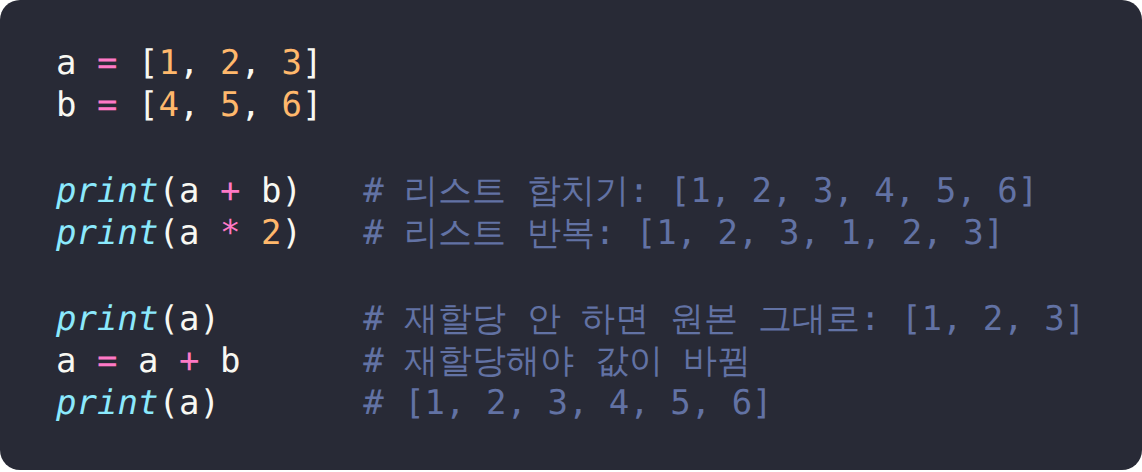
cubes리스트에서 세제곱 값 하나가 잘못 들어간 걸(65 → 64) 인덱싱으로 직접 수정,letters리스트는 슬라이싱으로 두 개 요소를 한 번에 교체(이때 교체할 요소 개수가 같아야 한다는 조건 확인)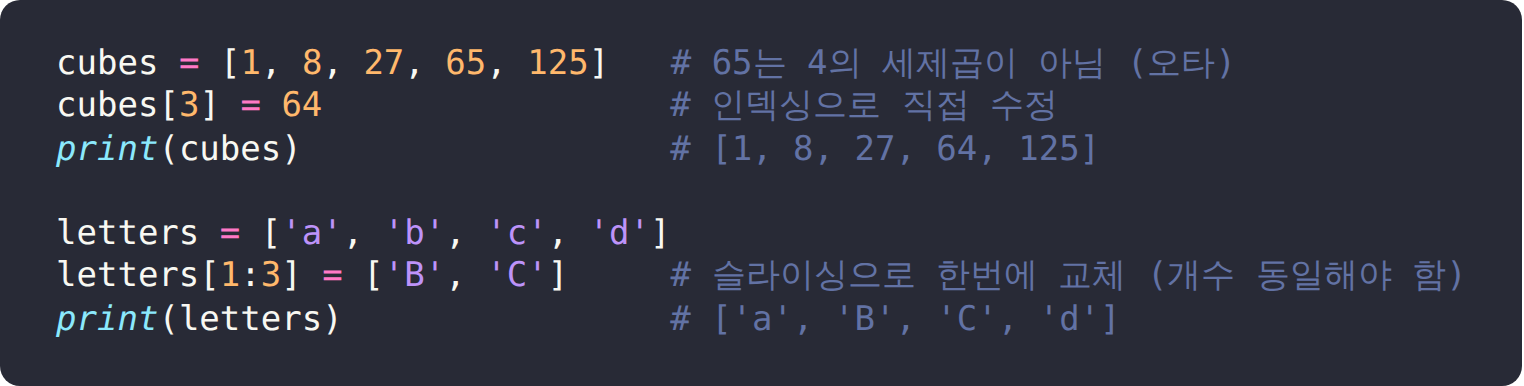
- 리스트 안에 리스트(중첩 리스트)를 만들고, 인덱싱을 두 번 해서 안쪽 요소까지 접근
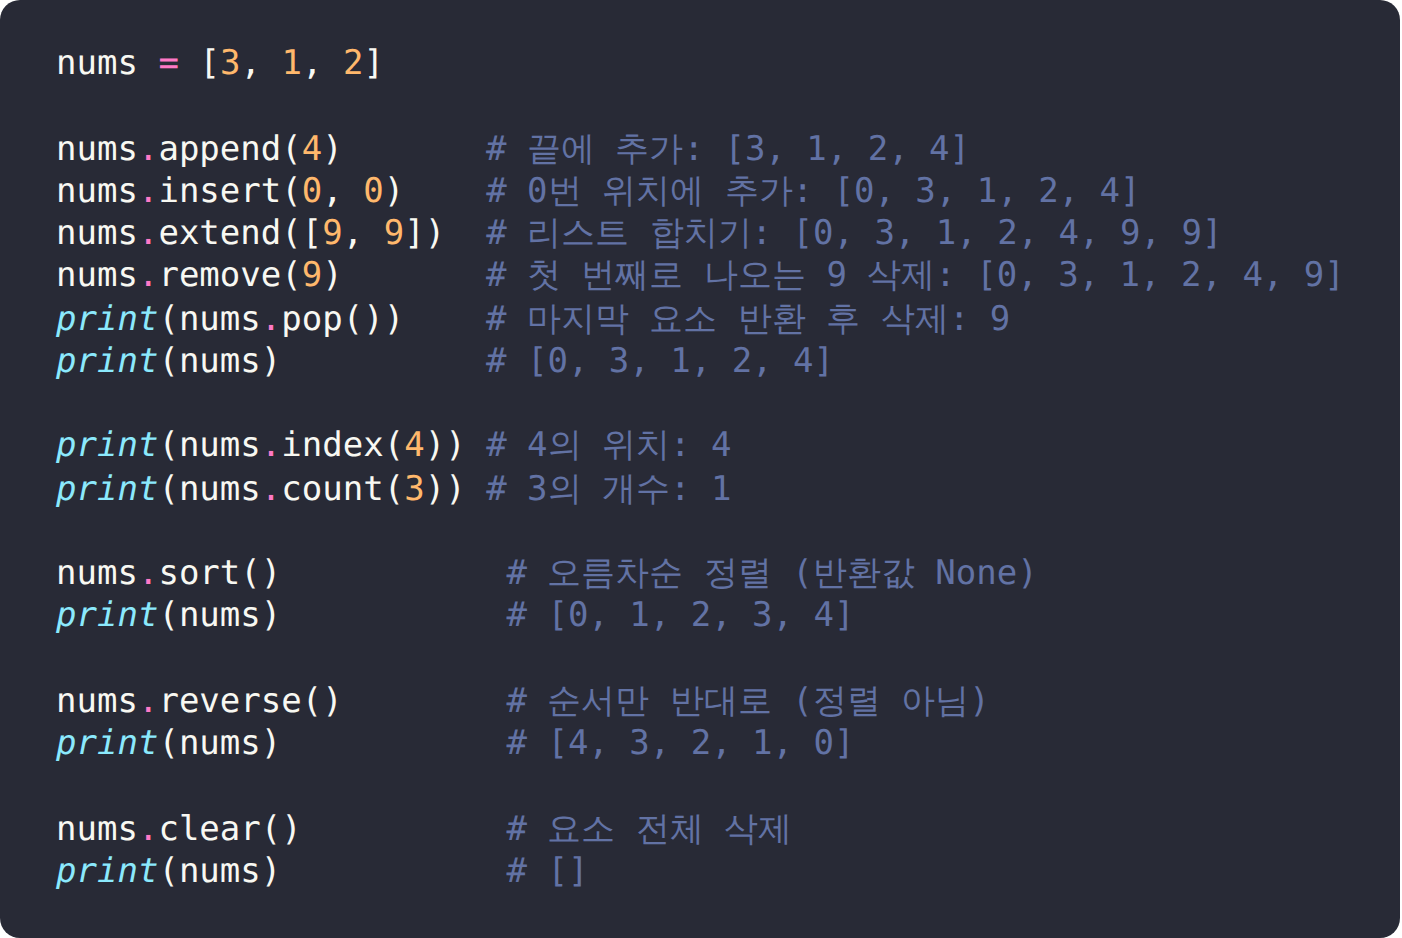
in으로 특정 값이 리스트에 있는지 True/False로 확인- append(끝에 추가), insert(위치 지정 추가), extend(리스트끼리 합치기), remove(값으로 첫 번째 요소 삭제), pop(마지막 요소 반환하면서 삭제), index(첫 위치 찾기), count(개수 세기), sort(정렬, 반환값 None), reverse(순서만 뒤집기, 정렬이 아니라 그대로 방향만 반대로 바꾸는 것), clear(요소 전체 삭제)를 하나씩 직접 실행
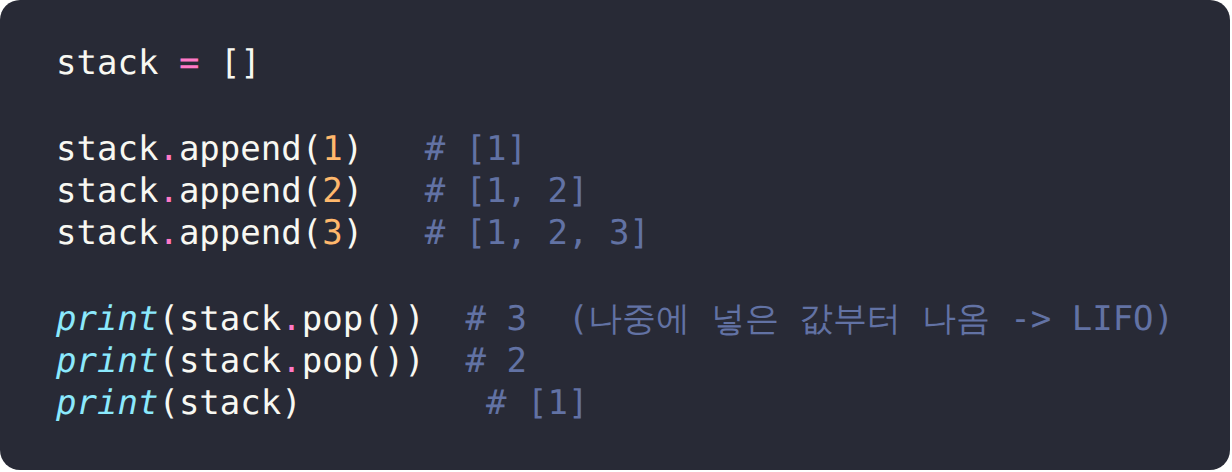
- 리스트를 스택(Stack)처럼 활용하는 실습: append로 값을 쌓고 pop을 반복 호출해서 나중에 넣은 값부터 꺼내지는 걸 직접 확인 - 값이 들어오고 나가는 곳이 한쪽으로 뚫려 있는 구조라 후입선출(LIFO)이 성립한다는 설명이 인상적이었다.
"Talk"
메서드 종류가 많아서 처음엔 다 외워야 하나 싶었는데, append와 pop만으로 스택 구조가 만들어지는 걸 직접 보니까 문법이 아니라 "왜 이 메서드를 쓰는가"가 먼저 이해돼야 한다는 걸 알았다.
2. 튜플(Tuple)
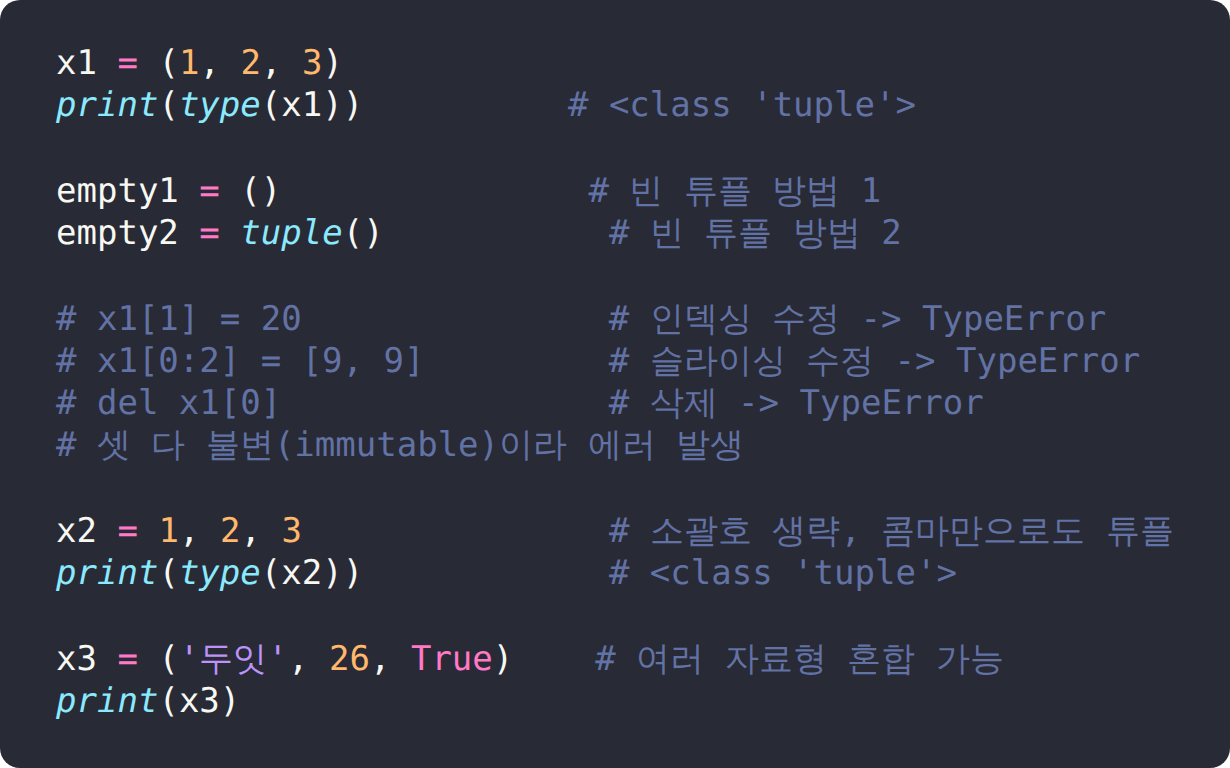
튜플은 리스트와 거의 같은데 소괄호를 쓰고, 불변(immutable)이라는 점만 다르다고 했다. 그래서 수정·삽입·삭제는 안 되고 조회(인덱싱, 슬라이싱, index(), count())만 가능하다.
<실습>
- 소괄호로 튜플 생성,
type()으로 확인 - 빈 튜플을 만드는 두 가지 방법: 소괄호만 쓰는
()와 인자 없는tuple()함수 x1[1] = ...처럼 인덱싱으로 값을 바꾸려 하면 에러, 슬라이싱으로 값을 넣으려 해도 에러,del로 요소를 지우려 해도 에러 — 세 가지를 직접 실행해서 "불변"을 눈으로 확인- 소괄호를 생략하고 콤마만으로 튜플을 만드는 것도 가능하다는 것 확인 (
type()으로 튜플임을 검증) - 여러 자료형을 섞어서 하나의 튜플에 담는 것도 가능하다는 것 확인
"Talk"
"다 되는 리스트를 두고 왜 굳이 제약 있는 튜플을 쓰나" 싶었는데, 리스트는 크기가 계속 변할 수 있어서 초과 할당까지 고려해 메모리 구조를 신경 써야 하는 반면, 튜플은 크기가 고정이라 더 빠르고 가볍게 동작한다는 설명을 듣고 납득했다. 변하지 않아야 하는 값에는 튜플을 쓰자. 기억.
3. 세트(Set)
세트는 수학의 집합과 같은 개념으로, 중복을 허용하지 않고 순서도 없는(인덱스가 없는) 자료형이다. 중괄호를 쓰지만 딕셔너리와 달리 키:값이 아니라 값 하나가 요소 역할을 한다.
<실습>
{}로 만들면 딕셔너리가 되어버려서, 빈 세트는 반드시set()함수로 만들어야 한다는 것 확인add()로 한 번에 하나씩 값을 추가하고, 같은 값을 여러 번 넣어도 하나만 남는 것을 직접 확인 (중복 저장 안 됨)remove()로 값 삭제, 없는 값을 remove하면KeyError발생 →discard()는 없는 값이어도 에러 없이 넘어간다는 차이 확인pop()은 리스트처럼 마지막 요소가 아니라 임의의 요소를 삭제(순서가 없기 때문), 더 이상 삭제할 요소가 없으면 마찬가지로KeyError발생clear()로 전체 삭제,len()으로 요소 개수 확인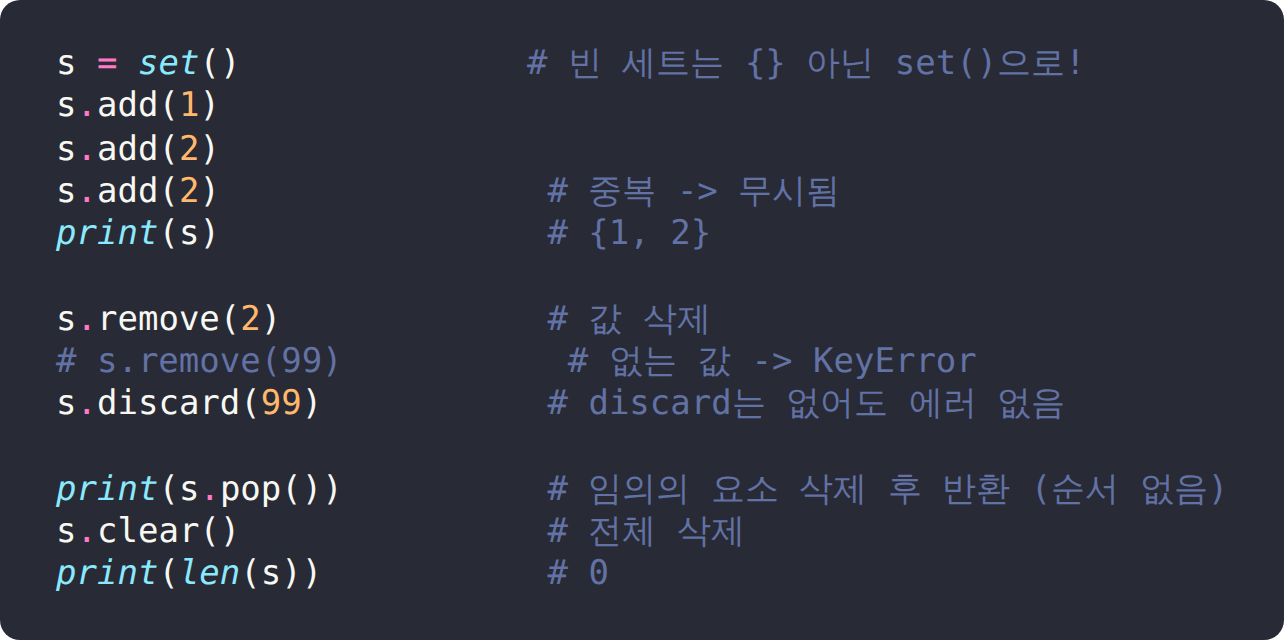
- 합집합(
union()/|), 교집합(intersection()/&), 차집합(difference()/-)을 직접 계산 - 차집합은A - B와B - A의 결과가 다르다는 점을 실습으로 확인 update()(|=),intersection_update()(&=),difference_update()(-=)로 A 자체에 연산 결과를 덮어쓰는 복합대입 실습 — 이 셋은 반환값이 없고, A를 직접 바꿔버린다는 공통점이 있었다- 부분집합(
issubset())·상위집합(issuperset()) — 두 세트가 완전히 같아도 True로 판정된다는 점(≤, ≥ 개념 포함)까지 확인,==로 두 세트가 완전히 같은지 비교, 겹치는 값이 없는지는isdisjoint()로 판별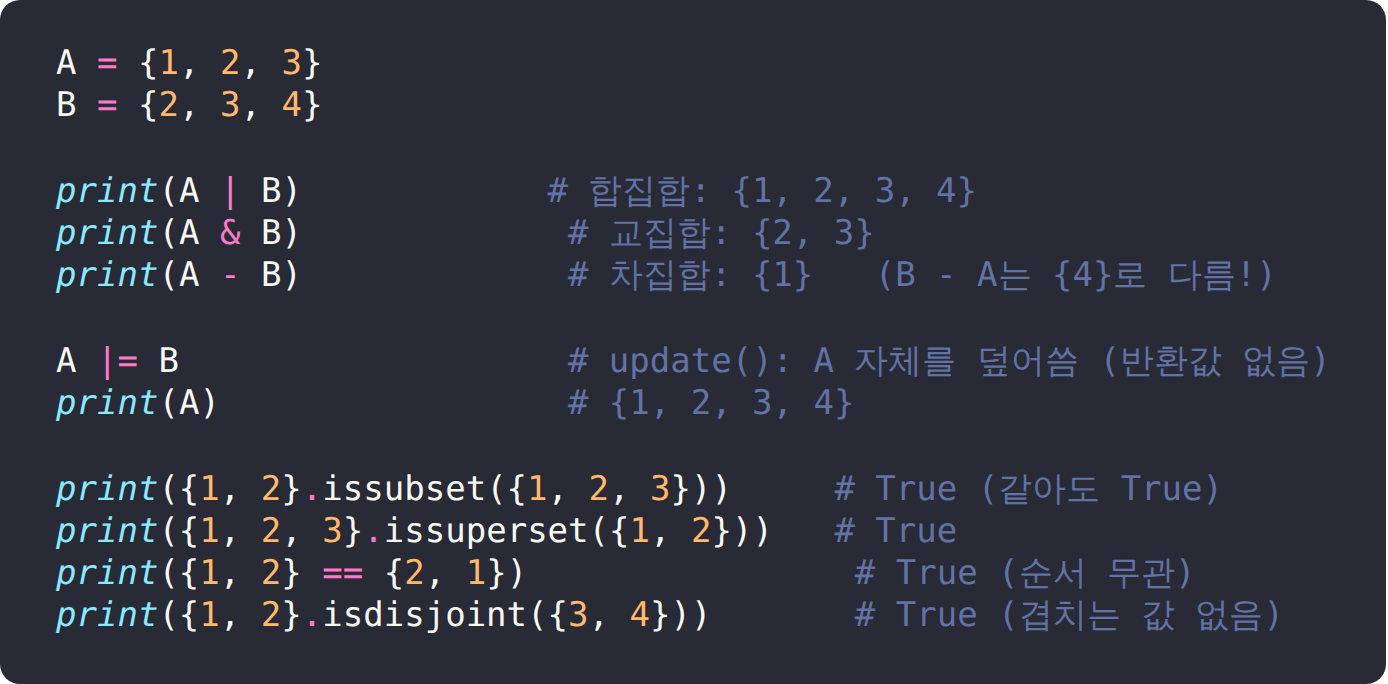
"Talk"
문법 자체는 리스트보다 단순했는데, 교집합·차집합 개념이 숫자 예제로만 다뤄지다 보니 "이걸 실제로 어디에 쓰나"는 아직 감이 잘 안 잡힌다. 다만,update()류 메서드가 반환값 없이 원본 자체를 바꾼다는 걸 직접 실행해보고 나서야, 반환값이 있는union()류와 구분해서 써야겠다는 감이 잡혔다. 중복 제거 용도로는 확실히 쓸 것 같은데 집합 연산 부분은 좀 더 예제를 봐야 할 것 같다.
4. 딕셔너리(Dictionary)
딕셔너리는 리스트·튜플·세트와 달리 비 시퀀스 자료형이라 인덱스를 갖지 않고, 대신 고유한 키(key)가 값(value)과 1대1로 짝을 이루는 key-value pair 구조다. 중괄호({}) 안에 key:value 쌍을 콤마로 구분해 작성하며, 같은 키를 중복해서 넣으면 가장 최근에 넣은 값만 남는다.
키(key)에는 문자열(str)·정수(int)·실수(float)·불리언(bool)·튜플(tuple)을 섞어 쓸 수 있지만, 리스트·딕셔너리·세트처럼 가변 자료형은 키로 쓸 수 없다는 제약이 있다(키는 반드시 고유해야 하기 때문). 반면 값(value) 자리에는 자료형 제약이 없어 어떤 자료형이든 올 수 있다.
빈 딕셔너리를 만드는 방법부터 실제로 채워 넣는 방법까지 여러 갈래로 실습했다.
- 빈 딕셔너리:
{}또는 인자 없는dict() dict(키=값, ...)처럼 키워드 인자로 만드는 방법 — 이때 키워드 부분은 변수명처럼 따옴표 없이 쓰기 때문에, 결과적으로 키가 무조건 문자열로 고정된다는 제약이 생긴다(숫자를 키 자리에 쓰면 에러)dict([(키, 값), (키, 값), ...])처럼 키-값 쌍(튜플/리스트)을 요소로 갖는 시퀀스 객체로 만드는 방법 — 이 방법을 쓰면 키를 문자열로 고정해야 하는 제약을 우회할 수 있다zip(keys, values)로 키 리스트와 값 리스트를 짝지어 튜플들을 만들고, 그걸dict(zip(...))로 감싸 변환하는 방법
<실습>
- 딕셔너리 생성,
type()확인, 같은 키로 두 번 값을 넣으면 마지막 값으로 덮어써지는 것을 직접 확인 - 키로 문자열/정수/실수/불리언/튜플을 섞어서 써봤는데, 이 과정에서
True와1이 같은 키로 취급되어 값이 덮어써지는 걸 확인 — 처음엔 왜 값 하나가 사라졌는지 못 알아챘다가, 파이썬에서 True==1이라는 걸 뒤늦게 깨달음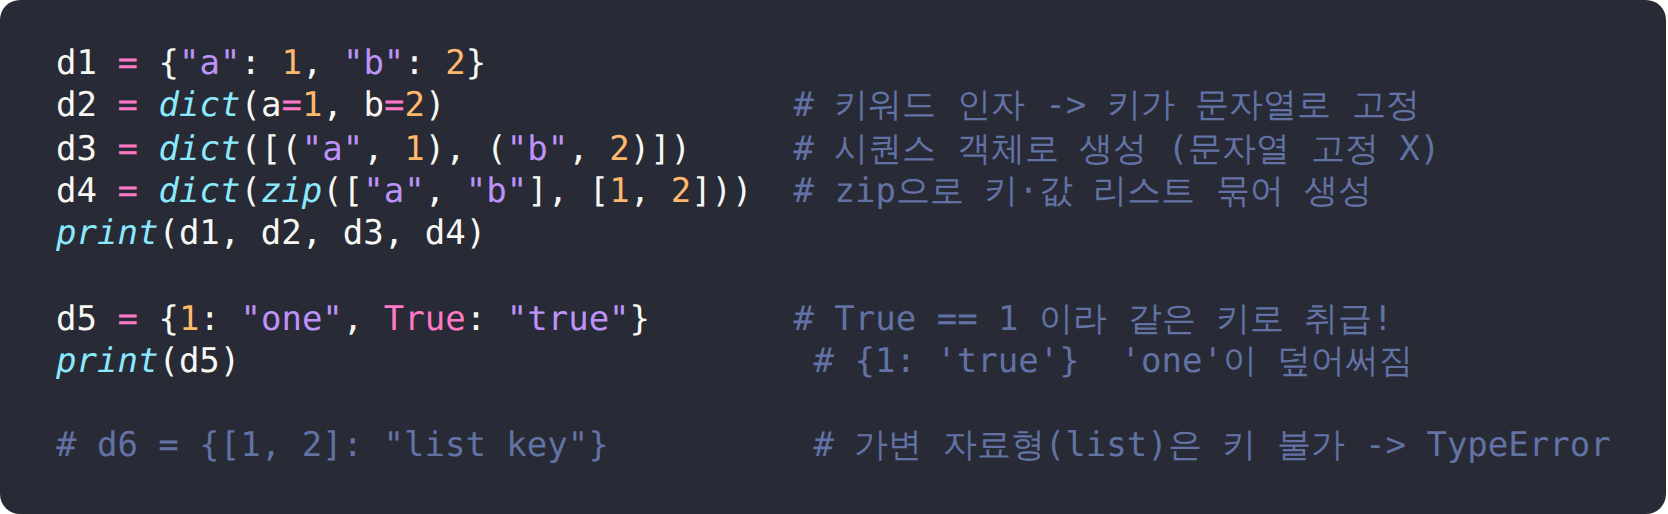
- 값(value)에는 리스트를 포함해 어떤 자료형이든 올 수 있다는 것을 문자열/정수/실수/불리언/튜플/리스트를 섞어 만들어보며 확인,
.values()와map(type, ...)으로 값들의 타입을 리스트로 뽑아 검증 - 키로 인덱싱해서 값 조회(
dict_b['key']), 키로 접근해 값 재할당(dict_b['key'] = "super value"), 없는 키에 값을 할당하면 새 요소가 추가된다는 것 확인(dict_b['new one'] = "new value"), 없는 키를 조회하면KeyError발생 in으로 키 존재 여부 확인 (.values()를 거치면 값 존재 여부도 확인 가능)del로 특정 키-값 쌍 삭제(del dict_b['new one']),len()으로 요소(=키의 개수=값의 개수) 확인 — 키와 값이 항상 1대1로 짝을 이루기 때문에 개수가 같다는 것도 짚었다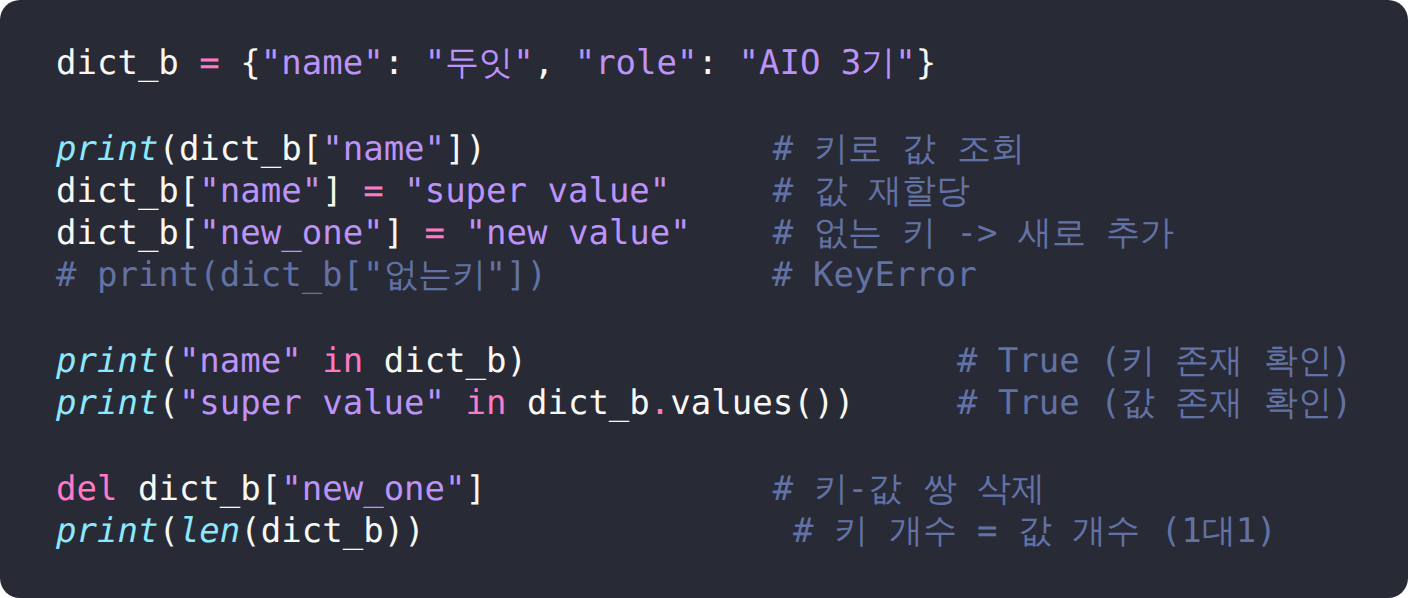
"Talk"
사실 딕셔너리는 예전에 네이버 블로그에서 한 번 정리했던 적이 있어서 "아는 내용이겠지" 하고 가볍게 들었는데, 착각이었다. 키에 어떤 자료형이 올 수 있고 어떤 자료형은 안되는지(가변 자료형은 키가 될 수 없다는 것),dict()함수를 쓰면 키가 문자열로 고정된다는 제약이나 그걸 시퀀스 객체·zip으로 우회하는 세 가지 생성 방법, True와 1이 충돌한다는 디테일 같은 건 전혀 몰랐던 내용이었다. 지금까지 개념을 너무 얕게 학습해왔다는 걸 이번 강의에서 확실히 체감했고, "들어본 개념"과 "설명할 수 있는 개념"은 다르다는 걸 다시금 느꼈다.
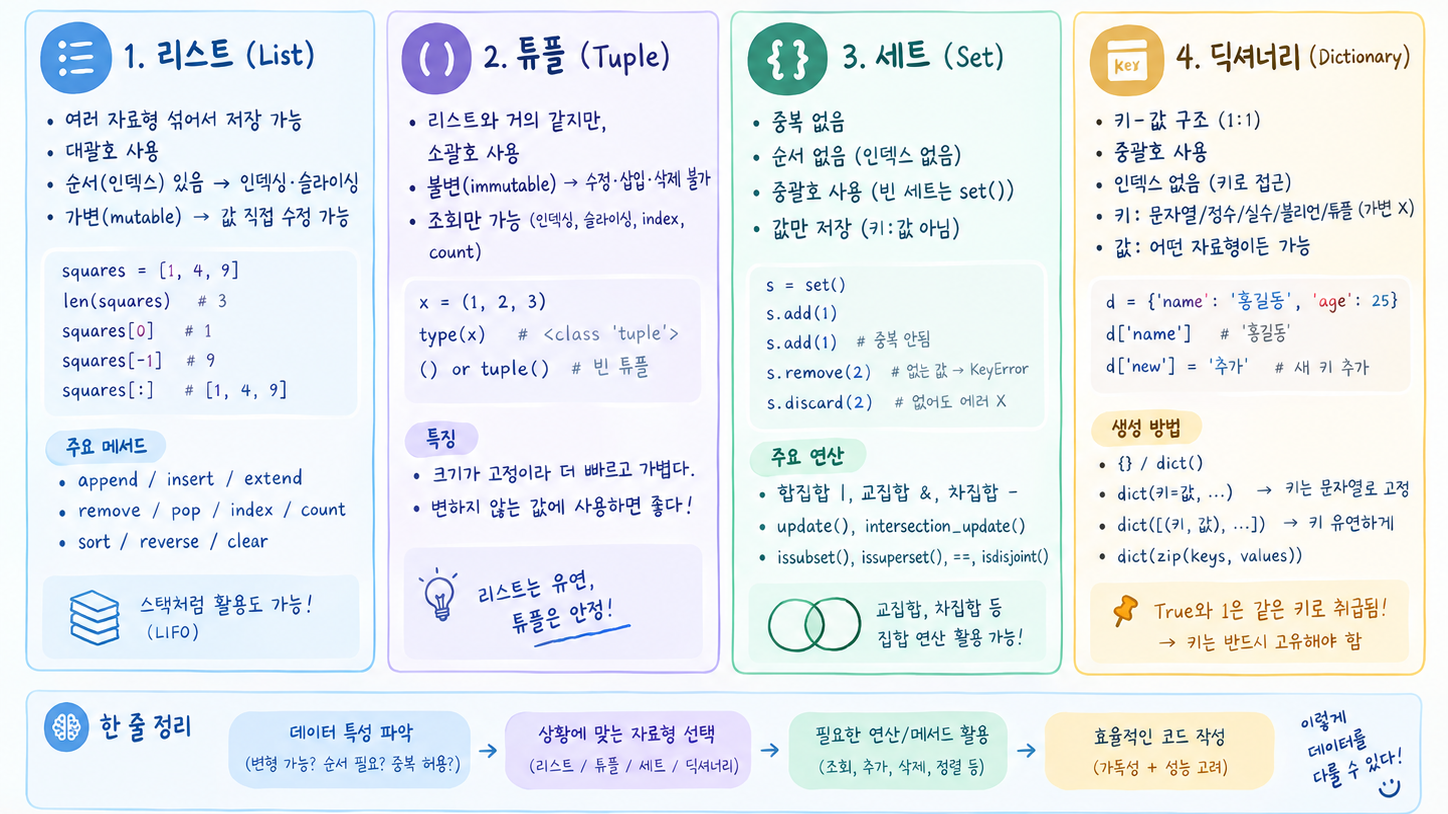
시퀀스 자료형 정리
제어문
5. for문
"Hello World"를 1000번 출력해야 하는데 문구가 바뀌면 1000줄을 일일이 고쳐야 하는 상황을 예시로 들면서 반복문의 필요성을 설명했다. for문은 반복 가능한(iterable) 대상에서 요소를 하나씩 꺼내 변수에 담고, 그때마다 들여쓰기로 구획된 코드 블록을 한 번씩 실행하는 구조다.
여기서 iterable 이라는 개념도 짚었다
- 여러 개의 요소로 구성돼 있으면서 요소를 한 번에 하나씩 돌려줄 수 있는 객체"를 뜻하고, 객체는 메모리에 할당되어 존재하는 데이터를 말한다(자세한 건 이후 클래스 학습 때 다시 다룰 예정이라 한다)
<실습>
range(1000)으로 "Hello World"를 반복 출력 (실습에서는 10번, 5번으로 줄여서 확인) —range(시작, 끝, 증감)은 시작 인덱스는 포함(이상), 끝 인덱스는 불포함(미만)이고, 시작은 생략 시 0, 증감은 생략 시 1이 기본값이라는 것도 확인range(2, 100, 20)처럼 규칙적인 숫자를 만들고,list()로 감싸서 실제 리스트로 변환(예: 100 미만의 2의 배수 리스트는list(range(2, 100, 2)))- range는 리스트처럼 보이지만, 메모리에 미리 모든 값을 만들어두는 리스트와 달리 필요할 때마다 다음 요소를 만들어 반환하는 방식이라 공간 효율적이라는 차이점 설명
- 문자열, 튜플도 for문으로 반복 가능하다는 것을 직접 실행 (문자열은 한 글자씩 순회)
reversed()로 문자열을 거꾸로 출력해서 "olleh" 만들기range(len(리스트))로 인덱스 번호를 만들어서 인덱싱하는 방식으로 시퀀스 객체를 순회하는 "인덱스 루프(loop)" 테크닉도 실습했다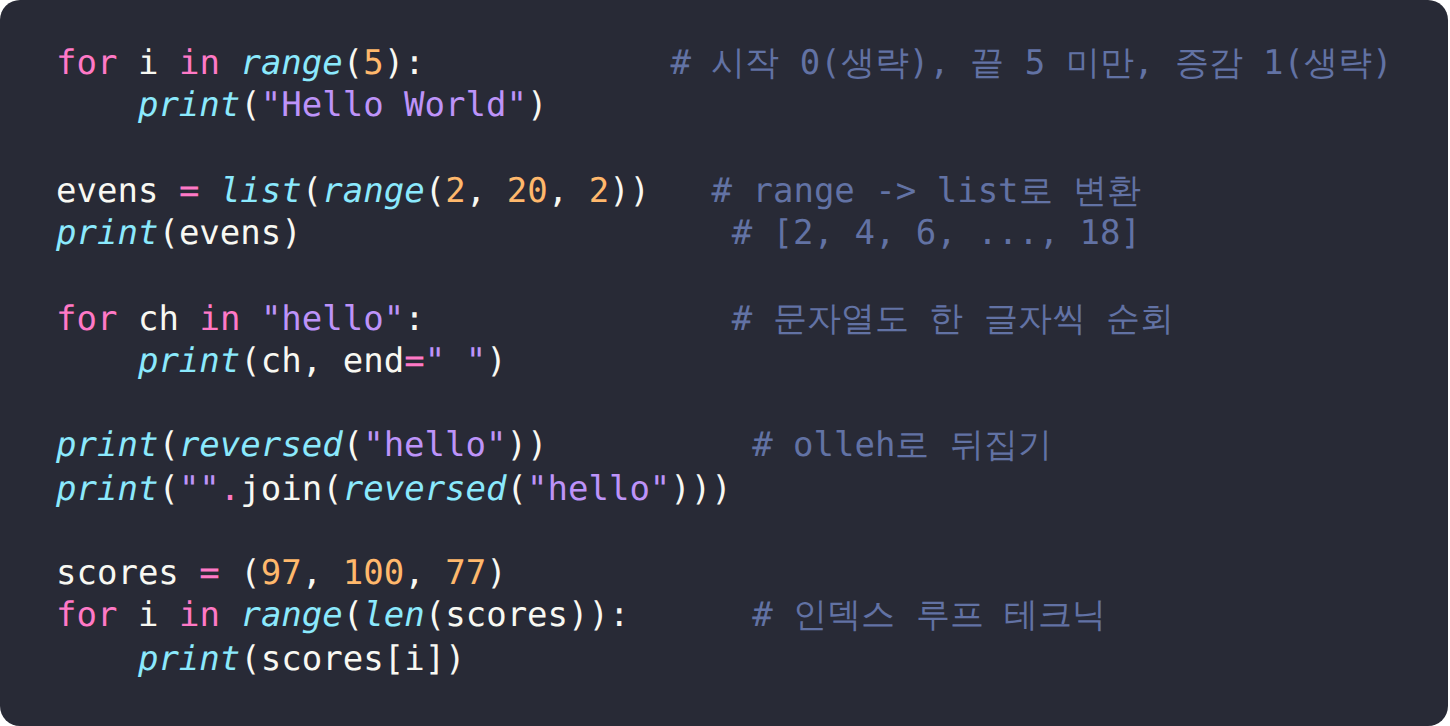
"Talk"
1000줄 예시가 와닿았다. 반복 작업을 손으로 하다가 실수하는 상황이 실무에서도 똑같이 생길 것 같아서, for문이 단순히 코드를 줄이는 문법이 아니라 실수를 막는 장치라는 설명이 기억에 남는다. iterable이라는 용어를 제대로 정의하고 넘어가니, 지금까지 "그냥 반복 가능한 것들"이라고 뭉뚱그려 알던 개념이 좀 더 또렷해진 느낌이다.
6. while / break / continue
while문은 for문처럼 요소 개수만큼이 아니라 "조건식이 True인 동안" 반복한다. 실행순서는 1)조건식을 판별하고 2)True인 동안 while문의 바디(반복할 코드 + 변화식)를 계속 실행하다가 3) False가 되면 빠져나가는 구조다. 보통 초기식 → 조건식 → (반복할 코드) → 변화식 순으로 구성되고, 변화식을 빠뜨리면 무한루프가 된다는 주의사항이 강조됐다.
i = 0                      # 초기식
while i < 100:              # while 조건식
    print("Hello world!")   # 반복할 코드
i += 1 # 변화식break는 반복문을 완전히 빠져나가는 것이고, 보통 특정 조건에 부합할 때 빠져나가기 위해 if문과 함께 쓰인다.
# 10000회 반복하다가 100을 만나면 중단
for i in range(10000):
    print(i)
    if i == 100:
break무한루프(while True:)와 input()을 조합하면, 사용자가 원하는 값을 입력할 때까지 계속 반복시키는 콘솔 프로그램도 만들 수 있다는 응용까지 배웠다.
while True:
    input_value = input("q를 입력하면 종료됩니다.")
    if input_value == "q":
        break
print("프로그램을 종료합니다.")continue는 제어 흐름은 그대로 유지한 채, continue가 실행된 그 회차의 나머지 코드만 건너뛴다. 마찬가지로 보통 if문과 함께 써서 특정 조건일 때만 그 회차를 건너뛰는 식으로 쓴다.
for i in range(100):     # 0부터 99까지 100번 반복
    if i % 2 == 0:        # 2로 나눈 나머지가 0이면 짝수
        continue           # 아래 코드를 실행하지 않고 건너뜀
    print(i, end="\t")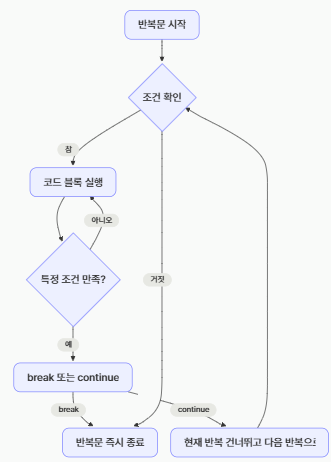
<실습>
i = 0,while i < 10:, 블록 안에서i += 1로 "Hello World" 10번 출력 (변화식을 빼먹으면 무한루프가 난다-> 이럴 땐 커널 재시작으로 복구할 것)- 사용자 입력값을 카운터로 받아 3, 2, 1까지 출력하고 0이 되면 반복이 끝나는 카운트다운 예제
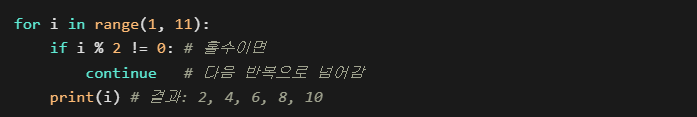
idx를 인덱스처럼 활용해서[98, 89, 28]리스트를 while문으로 순회하며 인덱싱range(100)반복 중 값이 100이 될 때 break로 빠져나가는 예제, 그리고 점수 리스트를 순회하다 특정 값(92)을 만나면 break로 멈추는 예제range(100)반복 중 2의 배수를 만나면 continue로 건너뛰어 홀수만 출력하는 예제, 같은 로직을 while문으로도 다시 작성
"Talk"
변화식을 빼먹으면 무한루프가 난다는 걸 명심할 것. for문이 "몇 번"을 기준으로 한다면 while문은 "어떤 조건까지"를 기준으로 한다는 차이가 명확해졌고, 예전에 네이버 블로그에 정리했던 AI 프로젝트 설계 때도 비슷한 로직(사용자가 원하는 값을 입력할 때까지 반복)을 감으로 짰던 게 생각났는데, 이번엔 초기식·조건식·변화식 구조로 정확하게 뜯어보면서 복기할 수 있어서 좋았다. break·continue가 늘 if문과 짝을 이뤄 쓰인다는 패턴도 눈에 들어왔다.
7. 리스트 컴프리헨션
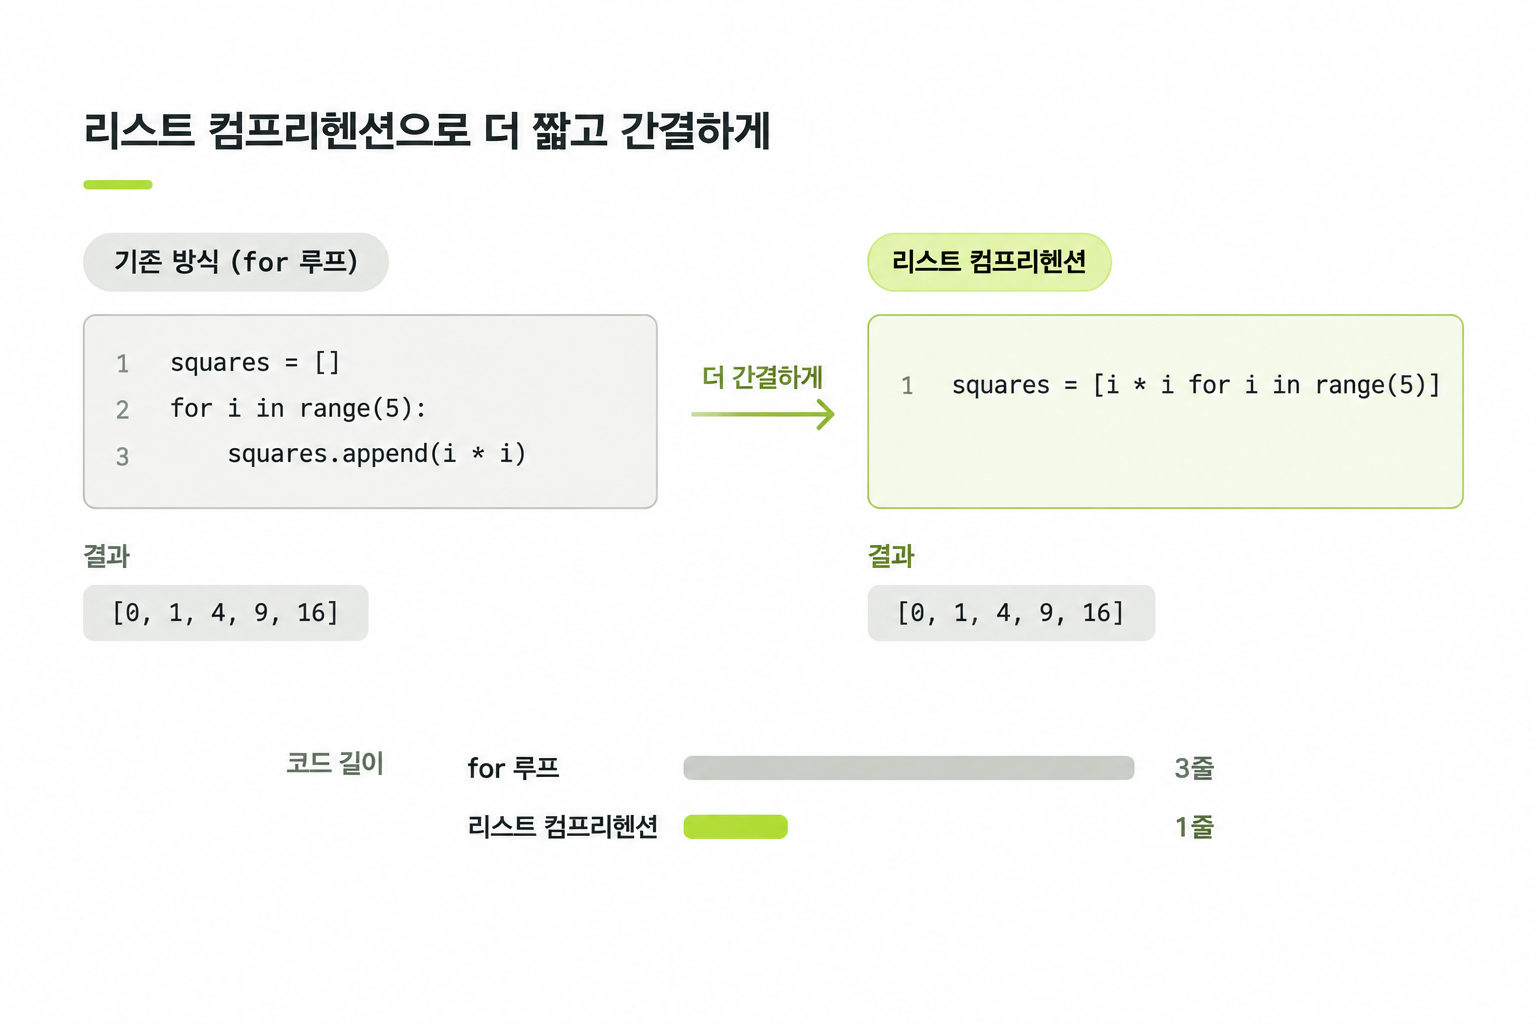
[표현식 for 변수 in iterable] 형태로, 대괄호 안에 표현식과 for문을 함께 작성해 반복하면서 요소를 가공한 새 리스트를 한 줄로 만드는 문법이다. 동작 순서로 보면 1) iterable에서 값을 하나 꺼내 변수에 담고 2) 그 변수로 표현식을 실행하고(변수를 쓸 수도, 안 쓸 수도 있음) 3) 결과값을 리스트 요소로 넣는 과정을 iterable에 값이 없을 때까지 반복하는 것이다.
list_c = [i for i in range(1, 10)]
print(list_c)조건문을 붙이면([표현식 for 변수 in iterable if 조건식]) iterable에서 꺼낸 값을 조건식에 먼저 넣고, True일 때만 표현식을 실행해 리스트에 담는다 — elif·else는 쓸 수 없다는 제약이 있다.
list_p = [i for i in range(10) if i % 3 == 0]
print(list_p)
<실습>

[i for i in range(1, 10)]로 1~9 리스트 만들기- 조건을 추가해서
range(10)중 3의 배수만 담는 리스트 만들기 - 2의 배수만 걸러서 제곱한 값으로 담는 리스트 만들기 (
[i**2 for i in range(10) if i % 2 == 0]형태) - 리스트 컴프리헨션 안에
print()처럼 반환값이 없는 걸 넣으면None만 쌓인 리스트가 된다는 주의사항, for문을 중첩해서 여러 개 쓸 수도 있다는 것까지 언급( 이 경우 왼쪽이 아니라 오른쪽에 있는 for문부터 순서대로 동작한다) list()함수로 만드는 다른 방식도 있지만, 되도록 대괄호 형태의 리스트 컴프리헨션을 쓰는 게 낫다는 강사님의 의견도 있었다
"Talk"
문법 자체는 생소했지만 for문의 동작 원리를 이미 이해하고 있어서 따라가는 데 어렵지 않았다. 다만 동작 순서를 같은 결과를 "iterable → 조건식 → 표현식 → 리스트에 담기"로 단계별로 뜯어보니, 왜 elif·else를 못 쓰는지도 자연스럽게 이해가 됐다. 같은 결과를 더 간결하게 만드는 방법이라는 게 신선했다.
Today's 회고
ch.4는 자료형(리스트/튜플/세트/딕셔너리)과 반복문(for/while/리스트 컴프리헨션)을 훑는 회차였다. 리스트·튜플·세트는 아직 실습을 따라치는 수준이라 완전히 소화됐다고 말하긴 어렵고, 딕셔너리는 예전에 이미 안다고 생각했던 부분이 사실 얕은 이해였다는 걸 확인한 게 오늘의 소득이었다. for/while/continue/break는 이전에 다뤄본 적 있는 로직을 훨씬 구조적으로 다시 짚을 수 있어서 유익했다. 특히 세트의 update() 계열 메서드나 딕셔너리를 만드는 세 가지 방법처럼, 겉핥기로 넘어갔을 법한 디테일을 하나씩 짚고 넘어가니 확실히 이해의 깊이가 달라지는 걸 느꼈다. 내용이 꽤 길어 생각보다 진도는 많이 못 나갔지만, 실습 하나하나 놓치지 않고 하는 것에 보다 큰 의미를 두어야겠다.
#AIO #엔코아 #프리코스 #파이썬 #TIL
