개요
이번 4주차부터 4주간은 Assembly 언어와 매우 가까운 C언어를 사용하여 좀 더 컴퓨터의 본질에 가까이 가면서 pint OS를 위한 기반을 다지는 주차이다.
c언어 기본 자료구조 미션을 해결하며 자료구조와 친해지고 CSAPP 책을 읽으며 CS지식을 다지는 기간이었다.
이번주 공부 내용
- 필수 자료구조 구현(4주차)
- CS:APP 1장, 3장 복습
정리
1. 레지스터(프로그램 카운터, 명령어 레지스터, 메모리 주소 레지스터), 스택 주소 지정방식, 변위 주소 지정 방식
프로그램 속 명령어와 데이터 실행 전후로 반드시 레지스터에 저장되는데 따라서 레지스터에 저장된 값만 잘 관찰해도 프로그램의 실행 흐름을 파악할 수 있음
- cpu내부를 잘 들여다 보면 어떤 일이 벌어지는지 알 수 있음
프로그램 카운터(PC. Program Counter)
- 기능 : 메모리에서 가져올 명령어의 주소, 즉
메모리에서 읽어 들일 명령어의 주소를 저장하고 다음에 실행될 명령어의 위치를 가리킴 - 활용
- 명령어의 순차적인 실행을 제어해서 프로그램 카운터를 명령어 포인터라고 부르는 CPU도 있음
- 명령어가 실행될때마다 증가하며 분기 또는 서브 루틴 호출/복귀 등의 특정 명렁어는 프로그램 카운터에 실행해야 위치가 바로 다음 코드가 아니라 새로운 기계어 코드의 위치 값이 들어감
명령어 레지스터
- 기능 : 현재 실행 중인 명령어를 저장하는 레지스터로 제어 장치가 명령어를 해석하는데 활용
- 활용 : 명령어 레지스터에 저장된 명령어의 연산 코드와 피연산자 등으 분석하여
CPU가 수행해야할 동작을 결정하고 제어 신호를 생성
메모리 주소 레지스터
- 기능 : 메모리의 주소를 저장하는 레지스터로 CPU가 메모리에 데이터를 읽거나 쓸때 사용
- 활용 : CPU가 메모리에 데이터를 요청할 때 메모리 주소 레지스터에 저장된 주소가 주소 버스를 통해 메모리로 전송되어 해당 주소의 데이터를 가져옴
메모리 버퍼 레지스터
- 기능 : 메모리와 주고 받을 데이터를 저장하는 레지스터 CPU와 메모리 간 데이터 전송에 사용됨
- 활용 : CPU가 메모리로부터 읽어온 데이터는 메모리 버터 레지스터에 저장되며 CPU가 메모리에 데이터를 쓸 때도 메모리 버퍼 레지스터에 저장된 값이 메모리에 전송
프로그램을 실행하는 과정에서 다양한 레지스터와 메모리 위치들의 상호작용 실행 과정

- 프로그램 로딩 : 프로그램이 메모리에 로드됨
- 프로그램 카운터(PC) : 프로그램이 시작되며 PC가 초기화되고 프로그램의 첫 번째 명령어의 주소로 설정됨
- 명령어 주소 레지스터 : 첫 번쨰 명령어의 주소를 읽어 들이기 위해 주소 버스로 해당 주소를 내보내야 함
- 이를 위해 메모리 주소 레지스터에 주소가 저장됨
- 메모리 읽기 제어 신호와 메모리 주소 레지스터 값이 제어 버스와 주소 버스를 통해 메모리로 보내진다
- 해당 주소에 저장된 값은 데이터 버스를 통해 메모리 버퍼 레지스터로 전달되고 프로그램 카운터는 증가되어 다음 명령어를 읽어 들일 준비를 함
- 메모리 버퍼 레지스터에 저장된 값은 명령어 레지스터로 이동함
- 제어장치는 명령어 레지스터의 명령어를 해석하고 제어 신호를 발생시킴
x86-64 아키텍처의 데이터 접근 및 이동 완전 가이드
x86-64 아키텍처에서 데이터에 어떻게 접근하고 이동시키는지
1. x86-64 레지스터 구조
x86-64 CPU에는 16개의 64비트 범용 레지스터가 있습니다. 이 레지스터들은 정수 데이터와 포인터를 저장하는 데 사용됩니다.

주요 특징:
- 레지스터 이름은 %r로 시작함
- 하위 32비트, 16비트, 8비트에 각각 다른 이름으로 접근할 수 있음
- 역사적인 이유로 다양한 명명 규칙이 존재
예를 들어, %rax 레지스터의 경우
- %rax: 전체 64비트
- %eax: 하위 32비트
- %ax: 하위 16비트
- %al: 최하위 8비트
이러한 구조 덕분에 다양한 크기의 데이터를 효율적으로 다룰 수 있게되었다.
2. 연산자 지정자
x86-64에서의 세 가지 주요 연산자 지정자가 존재
| 유형 | 형식 | 설명 | 예시 |
|---|---|---|---|
| 즉시값(Immediate) | $Imm | 상수 값 | $0x100 |
| 레지스터(Register) | ra | 레지스터 내용 | %rax |
| 메모리(Memory) | Imm(rb,ri,s) | 계산된 메모리 주소 | 8(%rbp,%rsi,4) |
메모리 참조의 일반적인 형식: Imm + R[rb] + R[ri] * s
- Imm: 즉시값 오프셋
- rb: 베이스 레지스터
- ri: 인덱스 레지스터
- s: 스케일 팩터 (1, 2, 4, 8 중 하나)
이 복잡해 보이는 형식 덕분에 배열이나 구조체의 요소에 효율적으로 접근할 수 있음
3. 데이터 이동 명령어
x86-64는 다양한 데이터 이동 명령어를 제공합니다. 크게 mov, movz, movs 계열로 나눌 수 있음
a) mov 계열
소스에서 목적지로 데이터를 그대로 복사하는 명령어
| 명령어 | 설명 | 예시 |
|---|---|---|
| movb | 1바이트 이동 | movb $0x12, (%rax) |
| movw | 2바이트 이동 | movw (%rax), %dx |
| movl | 4바이트 이동 | movl $0x12345678, %eax |
| movq | 8바이트 이동 | movq %rax, (%rsp) |
b) movz 계열 (제로 확장)
작은 크기의 데이터를 큰 크기로 확장할 때, 상위 비트를 0으로 채우는 명령어
| 명령어 | 설명 |
|---|---|
| movzbw | 바이트를 워드로 제로 확장 |
| movzbl | 바이트를 더블워드로 제로 확장 |
| movzwl | 워드를 더블워드로 제로 확장 |
| movzbq | 바이트를 쿼드워드로 제로 확장 |
| movzwq | 워드를 쿼드워드로 제로 확장 |
c) movs 계열 (부호 확장)
작은 크기의 데이터를 큰 크기로 확장할 때 사용하는 명령어, 부호를 유지함
| 명령어 | 설명 |
|---|---|
| movsbw | 바이트를 워드로 부호 확장 |
| movsbl | 바이트를 더블워드로 부호 확장 |
| movswl | 워드를 더블워드로 부호 확장 |
| movsbq | 바이트를 쿼드워드로 부호 확장 |
| movswq | 워드를 쿼드워드로 부호 확장 |
| movslq | 더블워드를 쿼드워드로 부호 확장 |
네, 이해했습니다. 요약 대신 스택 연산에 대한 전체적인 설명을 드리겠습니다.
x86-64 아키텍처의 스택 연산 이해하기
x86-64 아키텍처에서 스택은 프로그램 실행에 핵심적인 역할을 한다.
1. 스택의 기본 개념
스택은 후입선출(LIFO: Last In, First Out) 구조의 메모리 영역이다. x86-64에서 스택은 다음과 같은 특징을 가진다.
- 메모리의 높은 주소에서 낮은 주소 방향으로 성장한다.
- 스택 포인터(%rsp)가 항상 스택의 맨 위(top)를 가리킨다.
- 주로 함수 호출 시 지역 변수 저장, 함수 파라미터 전달, 반환 주소 저장 등에 사용도니다.
2. 주요 스택 연산
x86-64에서 스택을 조작하는 두 가지 주요 명령어가 있다.
| 명령어 | 설명 | 동작 |
|---|---|---|
| pushq S | 쿼드워드를 스택에 추가 | R[%rsp] ← R[%rsp] - 8; M[R[%rsp]] ← S |
| popq D | 스택에서 쿼드워드를 제거 | D ← M[R[%rsp]]; R[%rsp] ← R[%rsp] + 8 |
여기서 R[%rsp]는 스택 포인터의 값을, M[addr]은 메모리 주소 addr의 내용을 나타낸다.
3. pushq의 내부 동작
pushq 명령어는 다음 두 단계로 이루어진다.
pushq %rbp
; 동등한 동작:
subq $8, %rsp       ; 스택 포인터 8 감소
movq %rbp, (%rsp) ; 값을 새 스택 top에 저장- 스택 포인터를 8바이트(쿼드워드 크기) 감소시킴
- 지정된 값을 새로운 스택 top 위치에 저장
이 과정을 통해 스택에 새로운 데이터가 "쌓이게" 된다.
4. popq의 내부 동작
popq 명령어는 pushq의 역순으로 동작한다.
popq %rax
; 동등한 동작:
movq (%rsp), %rax   ; 스택 top 값을 레지스터로 복사
addq $8, %rsp ; 스택 포인터 8 증가- 스택 top의 값을 지정된 목적지(여기서는 %rax 레지스터)로 복사한다.
- 스택 포인터를 8바이트 증가시킨다.
pop 연산 후에도 이전 값이 메모리에 남아있지만, 스택의 일부로 간주되지 않는다.
5. 스택 연산 시각화
다음 다이어그램은 push와 pop 연산의 효과를 시각적으로 보여줍니다:
초기 상태         pushq %rax 실행 후   popq %rdx 실행 후

높은 주소
+---------------+ +---------------+ +---------------+
|               | |               | |               |
|               | |               | |               |
|               | |               | |               |
+---------------+ +---------------+ +---------------+
| %rsp -> 0x108 | | 0x108         | | %rsp -> 0x108 |
+---------------+ +---------------+ +---------------+
|               | | %rsp -> 0x100 | | 0x123         |
                  +---------------+ +---------------+
                  | 0x123         |

낮은 주소

레지스터 상태:
%rax: 0x123        %rax: 0x123        %rax: 0x123
%rdx: 0            %rdx: 0            %rdx: 0x123
%rsp: 0x108        %rsp: 0x100        %rsp: 0x108
이 다이어그램은 다음을 보여줍니다:
1. push 연산이 스택 포인터를 감소시키고 값을 저장하는 과정
2. pop 연산이 값을 읽고 스택 포인터를 증가시키는 과정
3. 스택이 높은 주소에서 낮은 주소로 성장하는 방식
6. 스택 연산의 중요성
- 함수 호출: 반환 주소와 호출자의 상태를 저장
- 지역 변수: 함수 내 임시 데이터를 저장
- 컨텍스트 전환: 프로세스나 스레드 전환 시 상태를 보존
- 인터럽트 처리: 인터럽트 발생 시 현재 실행 상태를 저장
마무리
x86-64 아키텍처에서 스택 연산을 이해하는 것은 저수준 프로그래밍과 시스템 최적화에 필수적이다. 이 지식을 바탕으로 더 효율적인 코드를 작성하고, 복잡한 프로그램의 동작을 더 잘 이해할 수 있다.
x86-64 아키텍처의 산술 및 논리 연산 과정
x86-64 아키텍처에서 산술 및 논리 연산이 이루어지는 과정
1. 산술 및 논리 연산 개요
x86-64는 다양한 산술 및 논리 연산을 지원한다. 이들은 크게 네 그룹으로 나눌 수 있다.
- 유효 주소 로드 (Load Effective Address)
- 단항 연산 (Unary Operations)
- 이항 연산 (Binary Operations)
- 시프트 연산 (Shift Operations)
주요 연산들의 목록
| 명령어 | 효과 | 설명 |
|---|---|---|
| leaq S, D | D ← &S | 유효 주소 로드 |
| inc D | D ← D + 1 | 증가 |
| dec D | D ← D - 1 | 감소 |
| neg D | D ← -D | 부정 |
| not D | D ← ~D | 보수 |
| add S, D | D ← D + S | 덧셈 |
| sub S, D | D ← D - S | 뺄셈 |
| imul S, D | D ← D * S | 곱셈 |
| xor S, D | D ← D ^ S | 배타적 논리합 |
| or S, D | D ← D | S |
| and S, D | D ← D & S | 논리곱 |
| sal k, D | D ← D << k | 왼쪽 산술 시프트 |
| shl k, D | D ← D << k | 왼쪽 논리 시프트 (sal과 동일) |
| sar k, D | D ← D >>A k | 오른쪽 산술 시프트 |
| shr k, D | D ← D >>L k | 오른쪽 논리 시프트 |
여기서 S는 소스 오퍼랜드, D는 목적지 오퍼랜드를 나타냄
2. 유효 주소 로드 (LEA) 연산
leaq (Load Effective Address) 명령어는 movq 명령어의 변형입니다. 메모리에서 읽는 것처럼 보이지만, 실제로는 메모리를 참조하지 않고 유효 주소만을 계산하여 목적지 레지스터에 저장한다.
예를 들어:
// `5*%rdx + 7`의 값을 `%rax`에 저장한다.
leaq 7(%rdx,%rdx,4), %raxleaq는 단순한 산술 연산을 수행하는 데도 자주 사용된다.
long scale(long x, long y, long z) {
    long t = x + 4 * y + 12 * z;
    return t;
}
이 함수는 다음과 같은 어셈블리 코드로 변환된다.
scale:
    leaq (%rdi,%rsi,4), %rax    # x + 4*y
    leaq (%rdx,%rdx,2), %rdx    # z + 2*z = 3*z
    leaq (%rax,%rdx,4), %rax    # (x+4*y) + 4*(3*z) = x + 4*y + 12*z
    ret
이처럼 leaq를 사용하면 복잡한 산술 연산을 효율적으로 수행할 수 있다.
3. 단항 및 이항 연산
단항 연산은 하나의 오퍼랜드에 대해 연산을 수행한다.
incq (%rsp)이 명령은 스택의 최상위 8바이트 값을 1 증가시킨다.
이항 연산은 두 개의 오퍼랜드를 사용합니다.
subq %rax, %rdx이 명령은 %rdx에서 %rax의 값을 뺀다.
4. 시프트 연산
시프트 연산은 비트를 왼쪽이나 오른쪽으로 이동시킨다. 시프트 양은 즉시 값이나 %cl 레지스터로 지정할 수 있다.
예를 들어:
salq $4, %rax    # %rax를 왼쪽으로 4비트 시프트
sarq %cl, %rbx # %rbx를 오른쪽으로 %cl에 저장된 값만큼 산술 시프트sar은 산술 시프트로, 부호 비트를 보존한다. shr은 논리 시프트로, 항상 0으로 채운다.
5. 특수 산술 연산
x86-64는 128비트 연산을 위한 특별한 명령어도 제공한다.
| 명령어 | 효과 | 설명 |
|---|---|---|
| imulq S | R[%rdx]:R[%rax] ← S × R[%rax] | 부호 있는 전체 곱셈 |
| mulq S | R[%rdx]:R[%rax] ← S × R[%rax] | 부호 없는 전체 곱셈 |
| cqto | R[%rdx]:R[%rax] ← SignExtend(R[%rax]) | 옥트 워드로 변환 |
| idivq S | R[%rdx] ← R[%rdx]:R[%rax] mod S; R[%rax] ← R[%rdx]:R[%rax] ÷ S | 부호 있는 나눗셈 |
| divq S | R[%rdx] ← R[%rdx]:R[%rax] mod S; R[%rax] ← R[%rdx]:R[%rax] ÷ S | 부호 없는 나눗셈 |
이 명령어들은 128비트 곱셈과 나눗셈을 수행할 수 있게 해준다.
마무리
x86-64 아키텍처는 다양하고 강력한 산술 및 논리 연산을 제공하는데 이러한 연산들을 이해하고 활용하면 효율적인 저수준 프로그래밍이 가능해진다.
leaq를 이용한 효율적인 주소 계산과 간단한 산술 연산- 다양한 단항 및 이항 연산으로 복잡한 계산 구현
- 비트 단위 연산을 위한 시프트 명령어
- 128비트 연산을 위한 특수 명령어
x86-64 아키텍처의 제어 흐름
안x86-64 아키텍처에서 제어 흐름이 어떻게 구현되는지 정리
1. 조건 코드
x86-64 CPU는 산술 및 논리 연산의 결과를 나타내는 단일 비트 조건 코드 레지스터를 유지한다.
- CF (Carry Flag): 최근 연산에서 최상위 비트에서 자리올림이 발생했는지 여부
- ZF (Zero Flag): 최근 연산의 결과가 0인지 여부
- SF (Sign Flag): 최근 연산의 결과가 음수인지 여부
- OF (Overflow Flag): 최근 연산에서 2의 보수 오버플로우가 발생했는지 여부
이러한 조건 코드는 조건부 분기를 수행하는 데 사용된다.
2. 조건 코드 접근하기
조건 코드를 사용하는 세 가지 일반적인 방법이 있다.
- 조건 코드의 조합에 따라 단일 바이트를 0 또는 1로 설정
- 조건부로 프로그램의 다른 부분으로 점프
- 조건부로 데이터 전송
조건부 설정 명령어
다음은 조건부 설정 명령어의 예입니다:
| 명령어 | 동작 | 설명 |
|---|---|---|
| sete D | D ← ZF | 같음 / 0 |
| setne D | D ← ~ZF | 다름 / 0이 아님 |
| sets D | D ← SF | 음수 |
| setns D | D ← ~SF | 음수가 아님 |
| setg D | D ← ~(SF^OF) & ~ZF | 더 큼 (부호 있는 >) |
| setge D | D ← ~(SF^OF) | 크거나 같음 (부호 있는 >=) |
| setl D | D ← SF^OF | 더 작음 (부호 있는 <) |
| setle D | D ← (SF^OF) | ZF |
조건부 점프 명령어
조건부 점프 명령어는 다음과 같다.
| 명령어 | 동작 | 설명 |
|---|---|---|
| je Label | if (ZF) goto Label | 같음 / 0 |
| jne Label | if (~ZF) goto Label | 다름 / 0이 아님 |
| js Label | if (SF) goto Label | 음수 |
| jns Label | if (~SF) goto Label | 음수가 아님 |
| jg Label | if (~(SF^OF) & ~ZF) goto Label | 더 큼 (부호 있는 >) |
| jge Label | if (~(SF^OF)) goto Label | 크거나 같음 (부호 있는 >=) |
| jl Label | if (SF^OF) goto Label | 더 작음 (부호 있는 <) |
| jle Label | if ((SF^OF) | ZF) goto Label |
3. 조건부 이동을 사용한 조건부 분기 구현
조건부 제어 전송 대신 조건부 데이터 전송을 사용하여 조건부 연산을 구현할 수 있다. 이 방법은 조건부 연산의 두 결과를 모두 계산한 다음 조건에 따라 하나를 선택한다.
조건부 이동 명령어의 예:
| 명령어 | 동작 | 설명 |
|---|---|---|
| cmove S, R | if (ZF) R ← S | 같음 / 0일 때 이동 |
| cmovne S, R | if (~ZF) R ← S | 다름 / 0이 아닐 때 이동 |
| cmovs S, R | if (SF) R ← S | 음수일 때 이동 |
| cmovns S, R | if (~SF) R ← S | 음수가 아닐 때 이동 |
이 방법은 분기 예측 실패로 인한 성능 저하를 줄일 수 있다.
4. 루프
C 언어의 do-while, while, for 루프는 조건부 테스트와 점프의 조합으로 구현된다.
do-while 루프
do-while 루프의 일반적인 형태:
do
    body-statement
while (test-expr);
이는 다음과 같은 goto 코드로 변환됩니다:
loop:
    body-statement
    t = test-expr;
    if (t)
        goto loop;
while 루프
while 루프의 일반적인 형태:
while (test-expr)
    body-statement
이는 두 가지 방법으로 변환될 수 있다.
- "jump to middle" 방식:
    goto test;
loop:
    body-statement
test:
    t = test-expr;
    if (t)
goto loop;- "guarded do" 방식:
    t = test-expr;
    if (!t)
        goto done;
loop:
    body-statement
    t = test-expr;
    if (t)
        goto loop;
done:
for 루프
for 루프의 일반적인 형태:
for (init-expr; test-expr; update-expr)
    body-statement
이는 while 루프로 변환된 후, 위의 두 가지 방법 중 하나로 구현된다.
5. switch 문
switch 문은 정수 인덱스 값에 따라 다중 분기를 제공하는데 효율적인 구현을 위해 점프 테이블이라는 데이터 구조를 사용한다.
점프 테이블은 각 항목이 해당 케이스를 처리하는 코드 세그먼트의 주소인 배열이다. 프로그램은 switch 인덱스를 사용하여 점프 테이블을 참조하고, 해당 주소로 점프한다.
예를 들어:
switch(n) {
    case 100: /* code for case 100 */
    case 102: /* code for case 102 */
    case 103: /* code for case 103 */
    case 104:
    case 106: /* code for cases 104 and 106 */
    default:  /* default case */
}
이러한 switch 문은 점프 테이블을 사용하여 효율적으로 구현될 수 있다.
마무리
x86-64 아키텍처는 조건 코드, 조건부 점프, 조건부 이동 등 다양한 제어 흐름 메커니즘을 제공하는데 이를 통해 C 언어의 if-else 문, 루프, switch 문 등을 효율적으로 구현할 수 있.
- 조건 코드를 통해 연산 결과의 특성을 추적
- 조건부 점프로 프로그램의 흐름을 제어
- 조건부 이동으로 분기 예측 실패의 영향을 최소화
- 점프 테이블을 통한 효율적인 switch 문 구현
이러한 메커니즘을 이해하면 저수준에서 프로그램의 동작을 더 잘 이해하고 최적화할 수 있다.
x86-64 아키텍처의 프로시저 호출
x86-64 아키텍처에서 프로시저(함수) 호출이 어떻게 구현되는지 정리를 정리한 단원이다.
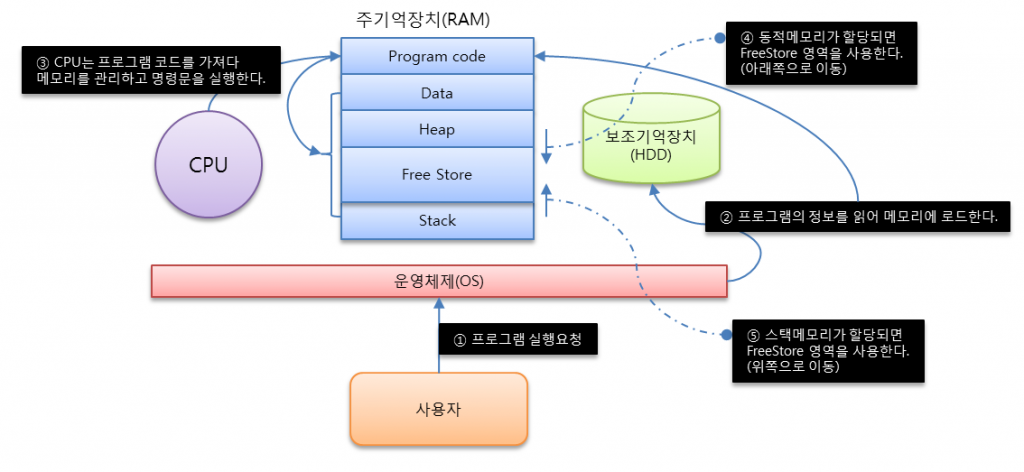
프로시저 호출: 프로시저 호출은 프로그램에서 특정 코드 블록(프로시저 또는 함수라고 함)을 실행하기 위해 사용되는 프로그래밍 기법1. 런타임 스택
프로시저 호출 메커니즘의 핵심은 스택 데이터 구조를 사용하는 것. 스택은 "후입선출(Last-In-First-Out, LIFO)" 원칙으로 작동하며, 다음과 같은 용도로 사용된다.
- 반환 주소 저장
- 함수 인자 전달 (7번째 이후의 인자)
- 지역 변수 저장
- 레지스터 값 보존
x86-64에서 스택은 메모리의 높은 주소에서 낮은 주소로 성장하는데 스택 포인터 %rsp는 스택의 최상단(가장 낮은 주소)을 가리킨다.
스택 프레임의 구조
높은 주소
+------------------+
|   이전 프레임     |
+------------------+
|   반환 주소       |
+------------------+
|   저장된 레지스터  |
+------------------+
|   지역 변수       |
+------------------+
|   인자 빌드 영역   |
+------------------+ <- 스택 포인터 (%rsp)
낮은 주소
2. 제어 전달
프로시저 호출과 반환은 두 명령어로 구현된다.
call <label>: 다음 명령어의 주소(반환 주소)를 스택에 푸시하고 로 점프한다.ret: 스택에서 주소를 팝하고 그 주소로 점프한다.
예를 들어:
call multstore   ; 함수 호출
...
ret              ; 함수에서 반환
call 명령어의 동작을 자세히 살펴보면:
- 현재 명령어 포인터(다음 명령어의 주소)를 스택에 푸시
- 목표 주소로 점프
ret 명령어의 동작:
- 스택에서 주소를 팝
- 그 주소로 점프
이 메커니즘은 함수 호출의 중첩을 자연스럽게 지원한다.
3. 데이터 전달
x86-64에서는 최대 6개의 정수 또는 포인터 인자를 레지스터를 통해 전달할 수 있다.
- %rdi: 첫 번째 인자
- %rsi: 두 번째 인자
- %rdx: 세 번째 인자
- %rcx: 네 번째 인자
- %r8: 다섯 번째 인자
- %r9: 여섯 번째 인자
7번째 이후의 인자는 스택을 통해 전달됩니다. 스택을 통해 전달되는 인자는 오른쪽에서 왼쪽으로(즉, 마지막 인자부터) 푸시됩니다.
반환 값은 %rax 레지스터를 통해 전달됩니다. 64비트보다 작은 정수 값을 반환할 때는 %eax, %ax, %al 레지스터의 해당 부분이 사용됩니다.
예를 들어, 다음과 같은 함수가 있다고 가정해 보면
long func(long a, long b, long c, long d, long e, long f, long g, long h) {
    return (a + b + c + d + e + f + g + h);
}
이 함수를 호출하는 어셈블리 코드는 다음과 같다.
    movq $8, %r9    ; f를 %r9에 저장
    movq $7, %r8    ; e를 %r8에 저장
    movq $6, %rcx   ; d를 %rcx에 저장
    movq $5, %rdx   ; c를 %rdx에 저장
    movq $4, %rsi   ; b를 %rsi에 저장
    movq $3, %rdi   ; a를 %rdi에 저장
    pushq $10       ; h를 스택에 푸시
    pushq $9        ; g를 스택에 푸시
    call func
    addq $16, %rsp  ; 스택 정리
4. 지역 저장소
함수 내에서 지역 변수를 위한 공간이 필요한 경우, 스택 프레임에 할당한다.
스택 프레임에 할당하는 경우
- 레지스터가 충분하지 않을 때
- 주소 연산자 &가 지역 변수에 사용될 때
- 배열이나 구조체 같은 큰 데이터 구조를 다룰 때
예를 들어:
long swap_add(long *xp, long *yp) {
    long x = *xp;
    long y = *yp;
    *xp = y;
    *yp = x;
    return x + y;
}
위 함수의 어셈블리 코드
swap_add:
    movq (%rdi), %rax   # x = *xp
    movq (%rsi), %rdx   # y = *yp
    movq %rdx, (%rdi)   # *xp = y
    movq %rax, (%rsi)   # *yp = x
    addq %rdx, %rax     # return x + y
    ret
이 예제에서는 지역 변수를 위한 추가적인 스택 공간이 필요하지 않지만 더 복잡한 함수에서는 스택에 지역 변수를 할당해야 할 수 있다.
complex_func:
    pushq %rbp
    movq %rsp, %rbp
    subq $16, %rsp      # 16바이트 스택 공간 할당
    ...
    movq %rbp, %rsp
    popq %rbp
    ret
5. 레지스터 사용 규약
x86-64는 레지스터 사용에 대한 규약을 가지고 있다.
-
호출자 저장 레지스터: %rax, %rdi, %rsi, %rdx, %rcx, %r8, %r9, %r10, %r11
- 함수 호출 시 이 레지스터들의 값이 변경될 수 있음
- 호출하는 함수가 이 값들을 보존해야 함
-
피호출자 저장 레지스터: %rbx, %rbp, %r12, %r13, %r14, %r15
- 함수는 이 레지스터들의 값을 보존해야 함
- 사용하기 전에 스택에 저장하고, 함수 종료 전에 복원해야 함
예시
P:
    pushq %rbp           # 피호출자 저장 레지스터 보존
    pushq %rbx
    ...                  # 함수 본문
    popq %rbx            # 원래 값 복원
    popq %rbp
    ret
이 규약을 통해 함수 호출 간의 상호 작용이 원활해지고, 재귀 호출도 가능해진다.
6. 재귀 프로시저
재귀 함수는 일반적인 함수 호출 메커니즘을 그대로 사용한다. 각 재귀 호출은 새로운 스택 프레임을 생성하므로, 지역 변수와 반환 주소가 독립적으로 유지된다.
예시 : 팩토리얼 함수
long rfact(long n) {
    if (n <= 1)
        return 1;
    else
        return n * rfact(n-1);
}
어셈블리 코드
rfact:
    pushq %rbx           # 피호출자 저장 레지스터 보존
    movq %rdi, %rbx      # n을 %rbx에 저장
    movl $1, %eax        # 반환 값을 1로 초기화
    cmpq $1, %rdi        # n과 1 비교
    jle .L2              # n <= 1이면 반환
    leaq -1(%rdi), %rdi  # n-1 계산
    call rfact           # rfact(n-1) 재귀 호출
    imulq %rbx, %rax     # n * rfact(n-1) 계산
.L2:
    popq %rbx            # 원래 %rbx 값 복원
    ret
이 코드에서 각 재귀 호출은 새로운 스택 프레임을 생성하고, 반환 주소와 %rbx의 값을 저장합니다. 이를 통해 각 호출의 상태가 독립적으로 유지됩니다.
7. 스택 프레임 정렬
x86-64 ABI(Application Binary Interface)는 함수 호출 시점에 스택 포인터가 16바이트 경계에 정렬되어야 한다고 규정합니다. 이는 특정 SSE(Streaming SIMD Extensions) 명령어의 성능을 최적화하기 위함입니다.
예를 들어:
func:
    pushq %rbp
    movq %rsp, %rbp
    subq $24, %rsp   # 24바이트 할당 (16의 배수로 정렬)
    ...
    movq %rbp, %rsp
    popq %rbp
    ret
마무리
x86-64 아키텍처는 스택을 사용하여 지역 변수와 반환 주소를 관리하고, 레지스터를 통해 빠른 인자 전달을 실현하고 또한 재귀 호출도 자연스럽게 지원한다.
이점
- 효율성: 레지스터를 통한 빠른 인자 전달
- 유연성: 다양한 수의 인자와 지역 변수 지원
- 재귀 지원: 각 호출에 대한 독립적인 상태 유지
- 최적화 가능성: 컴파일러가 레지스터 사용을 최적화할 수 있음
아마존 aws로 RAM을 1GB 받으면 원래는 할당받은 공간 초과시 ssh 튕기는데 swap메모리 설정해주면 vscode에서 ssh 접속해서 사용해도 다운이 안됨
시나리오(예시)
- EC2 인스턴스에 SSH로 접속합니다.
- VS Code의 Remote-SSH 확장을 사용해 이 인스턴스에 연결합니다.
- Flask 웹 서버를 실행하려고 합니다.
문제
- VS Code 서버가 약 400-500MB의 RAM을 사용
- Flask 애플리케이션이 추가로 200-300MB를 사용한다고 가정합니다.
- 이미 운영체제와 기타 프로세스가 일부 메모리를 사용 중입니다.
결과
총 메모리 사용량이 1GB를 초과하여 시스템이 불안정해지고, SSH 연결이 끊어질 수 있음
AWS EC2 인스턴스와 같은 클라우드 환경에서 RAM이 부족할 때 스왑 공간을 추가해 사용
장점
- 물리적 RAM이 부족할 때 추가 메모리 공간을 제공
- VS Code와 같은 메모리 집약적 애플리케이션을 실행할 때 시스템 안정성을 높임
- 비용 효율적인 방법으로 시스템 리소스를 확장할 수 있움
단점
- 스왑 공간은 HDD/SSD를 사용하므로 RAM보다 속도가 느림
- 과도한 스왑 사용은 시스템 성능을 저하시킬 수 있음
해결책
앞서 제시한 스왑 공간 생성 명령어를 사용
#2G의 swap 공간 할당
sudo fallocate -l 2G /swapfile
#system만 변경할수 있도록 권한설정
sudo chmod 600 /swapfile
#swap 연결
sudo mkswap /swapfile
#ram 스왑 시작
sudo swapon /swapfile
이렇게 하면
- 2GB의 스왑 공간이 추가되어 총 가용 메모리가 약 3GB로 증가
- VS Code, Flask, 그리고 기타 프로세스들이 안정적으로 실행될 수 있음
- RAM이 부족해지면 시스템은 자동으로 스왑 공간을 사용하기 시작
실제 사용 예
-
free -h명령어로 메모리 상태를 확인 가능$ free -h total used free shared buff/cache available Mem: 982Mi 823Mi 72Mi 1.0Mi 86Mi 158Mi Swap: 2.0Gi 0B 2.0Gi -
VS Code와 Flask를 실행한 후 다시 확인
$ free -h
              total        used        free      shared  buff/cache   available
Mem:          982Mi       957Mi        11Mi       1.0Mi        13Mi        24Mi
Swap:         2.0Gi       234Mi       1.8Gi
이 예시에서 볼 수 있듯이, 실제 RAM이 거의 다 사용되었지만 스왑 공간 덕분에 시스템이 계속 안정적으로 작동할 수 있음
주의할 점:
- 스왑 사용이 과도하면 시스템 성능이 현저히 저하될 수 있음
- 장기적으로는 t2.small이나 t3.small과 같이 RAM이 2GB인 인스턴스로 업그레이드하는 것이 더 나은 해결책일 수 있음
이런 방식으로 제한된 리소스의 AWS EC2 환경에서도 개발 작업을 수행할 수 있습니다. 하지만 프로젝트의 규모가 커지면 더 큰 인스턴스로의 이전을 고려해야 함
참조