[PyTorch] MNIST MLP 구현과 Learning Rate 비교 실험
이번에는 PyTorch로 간단한 MLP를 만들어 MNIST 숫자 분류를 해보고,
Learning Rate에 따라 학습 결과가 얼마나 달라지는지 직접 비교해봤다.
단순히 모델을 학습시키는 것보다,
Learning Rate를 작게 잡았을 때와 크게 잡았을 때 실제 Accuracy와 Loss가 어떻게 달라질까?
이 부분을 확인하는 것이 이번 실습의 핵심이었다.
비교한 Learning Rate는 다음 세 가지이다.
0.001, 0.01, 0.1
1. 실험 환경 설정
먼저 필요한 라이브러리를 불러왔다.
import random, os, math
import numpy as np
import torch

from torch import nn
from torch.utils.data import DataLoader
from torchvision import datasets, transforms

import torch.nn.functional as F
from torch.optim import SGD

import matplotlib.pyplot as plt
import pandas as pd
실험 결과가 실행할 때마다 너무 달라지는 것을 막기 위해 seed도 고정했다.
SEED = 42

random.seed(SEED)
np.random.seed(SEED)
torch.manual_seed(SEED)
torch.cuda.manual_seed_all(SEED)

torch.backends.cudnn.deterministic = True
torch.backends.cudnn.benchmark = False
GPU를 사용할 수 있으면 CUDA를 사용하고, 아니면 CPU를 사용하도록 설정했다.
device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)
여기서 cuDNN은 NVIDIA GPU에서 딥러닝 연산을 빠르게 처리할 수 있도록 도와주는 라이브러리이다.
이번 실습에서는 속도보다는 실험 결과의 재현성을 중요하게 생각해서
torch.backends.cudnn.deterministic = True
torch.backends.cudnn.benchmark = False
로 설정했다.
2. MNIST 데이터 불러오기
이번에 사용할 데이터는 MNIST이다.
MNIST 이미지는 28 × 28 크기의 흑백 숫자 이미지이고,
정답은 0~9 중 하나이다.
먼저 이미지를 Tensor로 바꾸고 정규화를 적용했다.
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.1307,), (0.3081,))
])
정규화는 대략적으로 데이터를 일정한 범위와 분포로 맞춰 학습을 안정적으로 만드는 과정이라고 이해했다.
MNIST에서 자주 사용하는 평균과 표준편차인
mean = 0.1307
std  = 0.3081
을 사용했다.
데이터셋은 다음과 같이 불러왔다.
train_ds = datasets.MNIST(
    root="./data",
    train=True,
    download=True,
    transform=transform
)

test_ds = datasets.MNIST(
    root="./data",
    train=False,
    download=True,
    transform=transform
)
MNIST는 학습 데이터 60,000개와 테스트 데이터 10,000개로 구성되어 있다.
3. DataLoader 만들기
학습 데이터를 한 번에 전부 넣는 대신 Batch 단위로 나누기 위해 DataLoader를 사용했다.
BATCH_SIZE = 128

train_loader = DataLoader(
    train_ds,
    batch_size=BATCH_SIZE,
    shuffle=True,
    num_workers=2,
    pin_memory=True
)

test_loader = DataLoader(
    test_ds,
    batch_size=512,
    shuffle=False,
    num_workers=2,
    pin_memory=True
)
학습 데이터에는
shuffle=True를 사용했다.
매 Epoch마다 데이터 순서를 섞어서 특정 데이터 순서에 학습이 영향을 받는 것을 줄이기 위해서이다.
반면 테스트 데이터는 학습에 사용하지 않기 때문에
shuffle=False로 두었다.
4. MLP 모델 구성
이번 실습에서는 CNN 대신 간단한 MLP를 사용했다.
MNIST 이미지 한 장의 크기는
1 × 28 × 28이다.
MLP의 Linear Layer에 입력하기 위해 이미지를 펼치면
28 × 28 = 784개의 값이 된다.
그래서 모델 구조를 다음과 같이 구성했다.
784
 ↓
512
 ↓
256
 ↓
10
코드는 다음과 같다.
class MLP(nn.Module):
    def __init__(self, dropout_p=0.0):
        super().__init__()

        self.flatten = nn.Flatten()

        self.fc1 = nn.Linear(28 * 28, 512)
        self.fc2 = nn.Linear(512, 256)
        self.fc3 = nn.Linear(256, 10)

        self.drop = nn.Dropout(p=dropout_p)
        self.p = dropout_p

    def forward(self, x):

        x = self.flatten(x)

        x = F.relu(self.fc1(x))

        if self.p > 0:
            x = self.drop(x)

        x = F.relu(self.fc2(x))

        if self.p > 0:
            x = self.drop(x)

        x = self.fc3(x)

        return x
흐름으로 보면 다음과 같다.
MNIST Image
[1, 28, 28]

     ↓ Flatten

784

     ↓ Linear + ReLU

512

     ↓ Linear + ReLU

256

     ↓ Linear

10
마지막 출력값 10개는 숫자 0~9에 대응한다.
여기서는 마지막에 Softmax를 따로 적용하지 않았다.
Loss 계산에서
F.cross_entropy(logits, y)를 사용하기 때문이다.
Cross Entropy에는 Softmax를 적용하기 전의 값인 logits를 그대로 넣으면 된다.
5. Accuracy 계산
모델이 출력한 10개의 값 중 가장 큰 값을 가진 위치를 예측 숫자로 사용했다.
def accuracy_from_logits(logits, y):

    return (
        (logits.argmax(dim=1) == y)
        .float()
        .mean()
        .item()
    )
예를 들어 모델 출력 중 숫자 7에 해당하는 값이 가장 크다면 모델은 숫자 7을 예측한 것으로 본다.
6. 평가 함수
학습 중간마다 모델의 성능을 확인하기 위한 평가 함수도 만들었다.
@torch.no_grad()
def evaluate(model, loader):

    model.eval()

    total_loss = 0.0
    total_acc = 0.0
    total_cnt = 0

    for x, y in loader:

        x = x.to(device)
        y = y.to(device)

        logits = model(x)

        loss = F.cross_entropy(logits, y)
        acc = accuracy_from_logits(logits, y)

        bs = x.size(0)

        total_cnt += bs
        total_loss += loss.item() * bs
        total_acc += acc * bs

    return (
        total_loss / total_cnt,
        total_acc / total_cnt
    )
평가에서는 학습이 필요하지 않기 때문에
@torch.no_grad()를 사용해서 Gradient 계산을 막았다.
그리고
model.eval()을 호출해서 모델을 평가 모드로 변경했다.
Dropout을 사용하는 모델에서는 특히 중요한 부분이다.
7. Training Loop
실제 학습은 다음 함수로 진행했다.
def train_one(model, optimizer, epochs=6, clip_maxnorm=None):

    hist = {
        "epoch": [],
        "train_loss": [],
        "train_acc": [],
        "val_loss": [],
        "val_acc": []
    }

    for ep in range(1, epochs + 1):

        model.train()

        t_loss = 0.0
        t_acc = 0.0
        t_cnt = 0

        for x, y in train_loader:

            x = x.to(device)
            y = y.to(device)

            logits = model(x)

            loss = F.cross_entropy(logits, y)

            optimizer.zero_grad(set_to_none=True)

            loss.backward()

            if clip_maxnorm is not None:
                torch.nn.utils.clip_grad_norm_(
                    model.parameters(),
                    clip_maxnorm
                )

            optimizer.step()

            bs = x.size(0)

            t_cnt += bs
            t_loss += loss.item() * bs
            t_acc += (
                accuracy_from_logits(logits, y) * bs
            )

        vl, va = evaluate(
            model,
            test_loader
        )

        hist["epoch"].append(ep)
        hist["train_loss"].append(t_loss / t_cnt)
        hist["train_acc"].append(t_acc / t_cnt)
        hist["val_loss"].append(vl)
        hist["val_acc"].append(va)

        print(
            f"Epoch {ep:02d} | "
            f"train_loss={t_loss/t_cnt:.4f} "
            f"acc={t_acc/t_cnt:.4f} | "
            f"val_loss={vl:.4f} "
            f"acc={va:.4f}"
        )

    return hist
처음에는 코드가 길어 보였는데, 실제 학습에서 핵심은 결국 이 부분이었다.
optimizer.zero_grad()
loss.backward()
optimizer.step()
정리하면
모델이 예측
   ↓
Loss 계산
   ↓
Gradient 계산
   ↓
Weight 수정
과정을 계속 반복하는 것이다.
8. 이번 실험에서 확인할 것
이번 실습에서는 다른 조건은 그대로 두고 Learning Rate만 변경했다.
독립 변수는 Learning Rate이다.
0.001
0.01
0.1
통제한 조건은 다음과 같다.
Dataset      : MNIST
Model        : 동일한 MLP
Optimizer    : SGD
Epoch        : 6
Batch Size   : 128
Loss         : Cross Entropy
Dropout      : 사용하지 않음
Scheduler    : 사용하지 않음
그리고 Learning Rate가 변했을 때
Accuracy
Loss
수렴 속도
가 어떻게 달라지는지를 확인했다.
9. Learning Rate Sweep
실험 코드는 다음과 같다.
EPOCHS = 6

LR_LIST = [
    1e-3,
    1e-2,
    1e-1
]

histories = {}
summary = []

for lr in LR_LIST:

    name = f"lr : {lr}"

    print(f"\n{name}")

    model = MLP(
        dropout_p=0.0
    ).to(device)

    optim = SGD(
        model.parameters(),
        lr=lr
    )

    hist = train_one(
        model,
        optim,
        epochs=EPOCHS
    )

    histories[name] = hist

    summary.append({
        "name": name,
        "final_val_acc":
            hist["val_acc"][-1],

        "final_val_loss":
            hist["val_loss"][-1]
    })
처음 예상했던 것은 Learning Rate가 너무 작으면 학습이 느릴 것이고,
어느 정도 큰 Learning Rate에서는 더 빠르게 학습될 것이라는 점이었다.
다만 너무 큰 Learning Rate에서는 오히려 Loss가 불안정해질 수도 있기 때문에 실제 결과를 확인해보기로 했다.
10. 결과
최종 결과는 다음과 같았다.
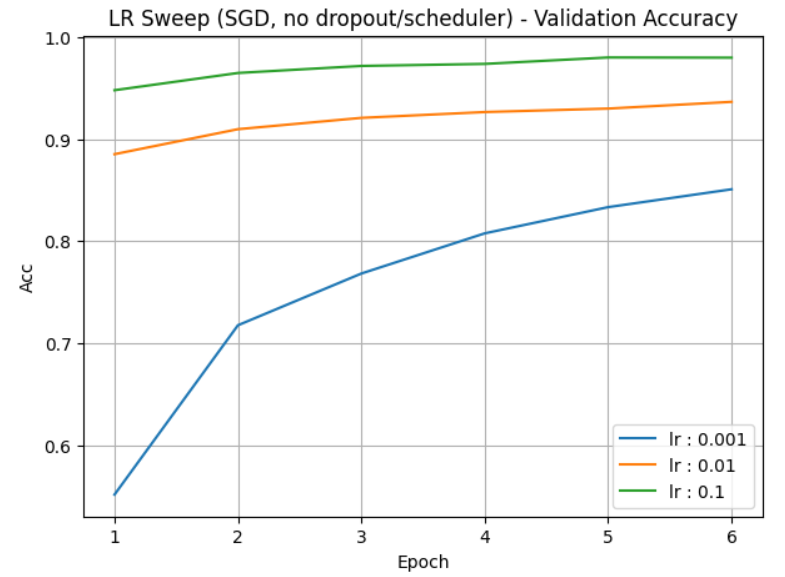
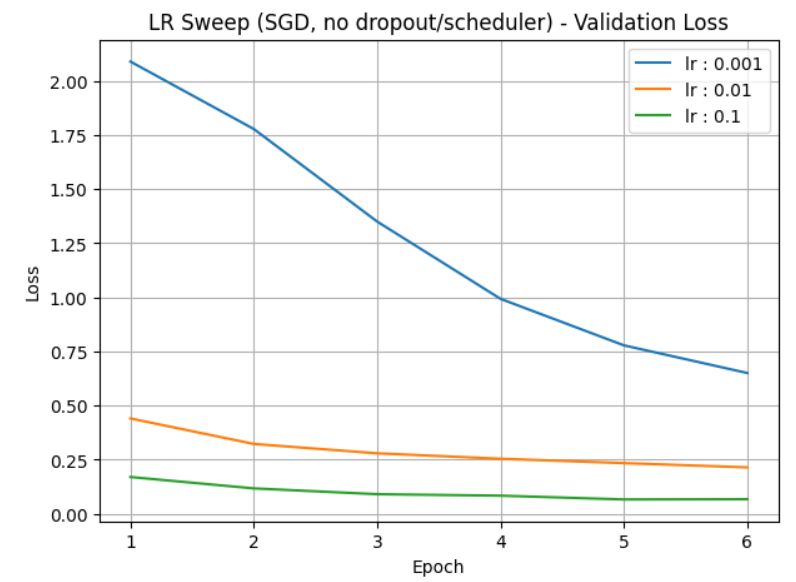
| Learning Rate | Accuracy | Loss |
|---|---|---|
| 0.1 | 97.98% | 0.0674 |
| 0.01 | 93.65% | 0.2146 |
| 0.001 | 85.08% | 0.6507 |
생각보다 Learning Rate에 따른 차이가 꽤 크게 나타났다.
11. LR = 0.001
결과는 다음과 같았다.
Epoch 01 | val_loss=2.0897 | acc=0.5515
Epoch 02 | val_loss=1.7781 | acc=0.7175
Epoch 03 | val_loss=1.3503 | acc=0.7682
Epoch 04 | val_loss=0.9932 | acc=0.8076
Epoch 05 | val_loss=0.7784 | acc=0.8333
Epoch 06 | val_loss=0.6507 | acc=0.8508
처음에는 Accuracy가 55% 정도였지만 계속 증가해서 최종적으로 약 85%까지 올라갔다.
Loss 역시 계속 감소했다.
그래프를 보면 학습이 멈춘 것이 아니라 아직도 개선되고 있는 상태였다.
즉 0.001이 잘못된 Learning Rate라기보다는
6 Epoch라는 제한된 학습 횟수에서는 너무 느린 Learning Rate
라고 보는 것이 적절해 보였다.
12. LR = 0.01
Epoch 01 | val_loss=0.4407 | acc=0.8852
Epoch 02 | val_loss=0.3228 | acc=0.9097
Epoch 03 | val_loss=0.2796 | acc=0.9208
Epoch 04 | val_loss=0.2544 | acc=0.9265
Epoch 05 | val_loss=0.2343 | acc=0.9299
Epoch 06 | val_loss=0.2146 | acc=0.93650.001과 비교하면 첫 Epoch부터 성능 차이가 상당히 컸다.
LR 0.001 → 55.15%
LR 0.01  → 88.52%
Learning Rate를 10배 올렸더니 훨씬 빠르게 좋은 영역으로 이동하는 것을 확인할 수 있었다.
Accuracy도 꾸준히 증가하고 Loss도 안정적으로 감소했다.
따라서 0.01은 꽤 안정적인 Learning Rate라고 볼 수 있었다.
13. LR = 0.1
가장 좋은 결과가 나온 조건이다.
Epoch 01 | val_loss=0.1701 | acc=0.9479
Epoch 02 | val_loss=0.1175 | acc=0.9648
Epoch 03 | val_loss=0.0907 | acc=0.9717
Epoch 04 | val_loss=0.0839 | acc=0.9737
Epoch 05 | val_loss=0.0664 | acc=0.9800
Epoch 06 | val_loss=0.0674 | acc=0.9798
첫 Epoch부터 Accuracy가 약 94.8%까지 올라갔다.
그리고 Epoch 5에서는
Accuracy = 98.00%
Loss     = 0.0664
를 기록했다.
이번에 비교한 세 Learning Rate 중 가장 빠른 수렴 속도와 가장 좋은 성능을 보여줬다.
14. 재미있었던 부분: Epoch 5가 Epoch 6보다 좋았다
LR=0.1에서는 한 가지 재미있는 부분이 있었다.
Epoch 5 결과는
train_acc = 98.57%
val_acc   = 98.00%
val_loss  = 0.0664
였는데,
Epoch 6에서는
train_acc = 98.91%
val_acc   = 97.98%
val_loss  = 0.0674
가 나왔다.
Training Accuracy는 계속 좋아졌지만 Validation Accuracy는 아주 조금 감소했고 Loss도 조금 증가했다.
즉
Training 성능 ↑

하지만

Validation 성능 → 거의 그대로 또는 소폭 하락
하는 모습을 확인할 수 있었다.
차이가 매우 작아서 심한 Overfitting이라고 하기는 어렵지만,
조금 더 오래 학습하면 과적합이 나타날 가능성은 있어 보였다.
또 하나 알게 된 것은
마지막 Epoch의 모델이 항상 가장 좋은 모델은 아니다.
라는 점이다.
이번 실험에서는 마지막 Epoch인 6보다 Epoch 5에서 더 좋은 Validation 성능이 나왔다.
15. 그래프로 확인
Accuracy 그래프를 보면 차이가 더 확실하게 보였다.
여기에 Validation Accuracy 그래프 삽입
LR=0.001은 천천히 올라가는 반면,
LR=0.1은 처음부터 빠르게 높은 Accuracy에 도달했다.
Loss 그래프에서도 같은 경향이 나타났다.
여기에 Validation Loss 그래프 삽입
LR=0.1에서 Loss가 가장 빠르게 감소했다.
16. Learning Rate가 왜 이렇게 큰 차이를 만들까?
SGD의 기본적인 Weight Update는 다음과 같다.
여기서 (\eta)가 Learning Rate이다.
Gradient가 같다고 가정하면 Learning Rate가 클수록 Weight가 한 번에 더 크게 이동한다.
예를 들어 Gradient가 2라고 하면,
LR = 0.001
→ 0.002만큼 이동

LR = 0.01
→ 0.02만큼 이동

LR = 0.1
→ 0.2만큼 이동
하게 된다.
이번 실험에서는 0.001이나 0.01보다 0.1이 좋은 Parameter 영역에 훨씬 빠르게 도달한 것으로 볼 수 있다.
그렇다고 Learning Rate가 무조건 클수록 좋은 것은 아니다.
너무 크게 설정하면 최적점을 지나쳐 계속 왔다 갔다 하거나 Loss가 아예 발산할 수도 있다.
이번 실험에서 확인한 것은 정확히
0.001,0.01,0.1중에서는0.1이 가장 좋았다.
는 것이다.
17. 최종 정리
이번 실험에서 가장 눈에 띈 부분은 Learning Rate 하나만 바꿨는데도 학습 속도와 최종 성능에 큰 차이가 발생했다는 점이었다.
결과는 다음과 같다.
LR = 0.001
Accuracy = 85.08%
Loss     = 0.6507

LR = 0.01
Accuracy = 93.65%
Loss     = 0.2146

LR = 0.1
Accuracy = 97.98%
Loss     = 0.0674
따라서 이번 실험 조건에서는
Learning Rate = 0.1
이 가장 좋은 결과를 보였다.
특히 LR=0.1은 첫 Epoch부터 높은 Accuracy를 기록했고, Epoch 5에서는 98% Accuracy까지 도달했다.
반면 LR=0.001은 학습 자체는 정상적으로 진행되었지만 6 Epoch 안에서는 충분히 수렴하지 못했다.
이번 실습을 통해 단순히 모델 구조만 중요한 것이 아니라
Learning Rate 같은 Hyperparameter 설정도 모델의 학습 결과를 크게 바꿀 수 있다는 점을 직접 확인할 수 있었다.
18. 실습하면서 추가로 알게 된 점
이번 코드는 변수 이름으로 val_acc, val_loss를 사용했지만 실제로는
evaluate(model, test_loader)를 실행하고 있다.
즉 엄밀하게 말하면 Validation Set이 아니라 Test Set을 매 Epoch 사용하고 있는 구조이다.
연습 목적에서는 결과를 비교할 수 있지만, 제대로 된 실험에서는
Train
↓
모델 학습

Validation
↓
Hyperparameter 선택

Test
↓
최종 성능 평가
처럼 데이터를 따로 나누는 것이 더 적절하다.
특히 이번처럼 Learning Rate를 비교하여 가장 좋은 값을 선택한다면 Validation Set으로 Learning Rate를 선택하고, 최종적으로 선택한 모델을 Test Set에서 한 번 평가하는 방식이 더 정확하다.
마무리
이번에는 가장 기본적인 MLP와 SGD를 이용해서 Learning Rate의 영향을 확인해봤다.
다음에는 여기서 한 단계 더 나아가
Dropout, Momentum, Gradient Clipping, Learning Rate Scheduler
같은 요소를 하나씩 적용하면서 결과가 어떻게 달라지는지 비교해보면 좋을 것 같다.