SentencePiece와 RNN을 이용한 영화 리뷰 감정 분류
이번 실습에서는 NLTK의 영화 리뷰 데이터를 SentencePiece로 토큰화하고, Embedding → RNN → 출력층 구조로 긍정·부정을 예측했다.
리뷰의 앞부분과 뒷부분을 사용했을 때 정확도가 어떻게 달라지는지도 비교했다.
1. 데이터 준비
처음에는 리뷰 내용으로 영화 점수를 예측하려고 했지만, movie_reviews에는 숫자 평점이 없었다. 대신 긍정과 부정 라벨이 있어서 이진 분류 문제로 진행했다.
| 분류 | 리뷰 수 | 라벨 |
|---|---|---|
| 부정 | 1,000 | 0 |
| 긍정 | 1,000 | 1 |
| 전체 | 2,000 |
import nltk
from nltk.corpus import movie_reviews

nltk.download("movie_reviews")

file_ids = movie_reviews.fileids()

x = [movie_reviews.raw(fid) for fid in file_ids]
y = [
    1 if movie_reviews.categories(fid)[0] == "pos" else 0
    for fid in file_ids
]x: 리뷰 문자열 목록y: 각 리뷰에 대응하는 긍정·부정 라벨
len(x)와 len(y)가 모두 2,000인 이유는 리뷰마다 정답 라벨이 하나씩 있기 때문이다.
2. 학습·검증·테스트 데이터 분리
전체 데이터의 10%를 테스트용으로 분리했다. 나머지 90%는 다시 학습과 검증용으로 8:2로 나눴다.
from sklearn.model_selection import train_test_split

x_temp, x_test, y_temp, y_test = train_test_split(
    x, y,
    test_size=0.1,
    random_state=42,
    stratify=y
)

x_train, x_val, y_train, y_val = train_test_split(
    x_temp, y_temp,
    test_size=0.2,
    random_state=42,
    stratify=y_temp
)| 구분 | 데이터 수 | 전체 비율 |
|---|---|---|
| 학습 | 1,440 | 72% |
| 검증 | 360 | 18% |
| 테스트 | 200 | 10% |
stratify는 각 데이터셋에서도 긍정·부정 비율을 유지하는 설정이다.
- 학습 데이터: 가중치 업데이트
- 검증 데이터: 모델과 설정 선택
- 테스트 데이터: 최종 성능 평가
3. SentencePiece 사전 생성
SentencePiece는 단어 전체뿐 아니라 단어의 일부인 서브워드를 사용한다.
예를 들어 학습된 사전에 따라 하나의 단어가 여러 조각으로 나뉠 수 있다.
리뷰 문자열 → 서브워드 토큰 → 정수 ID이번 실습에서는 BPE 방식과 사전 크기 8,000을 사용했다.
사전 학습에는 최종 학습 데이터인 x_train만 사용해야 한다. 검증·테스트 데이터의 정보가 사전 생성에 포함되지 않도록 하기 위해서다.
import sentencepiece as spm

with open("train_reviews.txt", "w", encoding="utf-8") as f:
    for review in x_train:
        f.write(" ".join(review.split()) + "\n")

spm.SentencePieceTrainer.train(
    input="train_reviews.txt",
    model_prefix="movie_bpe",
    vocab_size=8000,
    model_type="bpe",
    character_coverage=1.0,
    pad_id=0,
    unk_id=1,
    bos_id=-1,
    eos_id=-1,
    hard_vocab_limit=False
)

sp = spm.SentencePieceProcessor(model_file="movie_bpe.model")

print("실제 사전 크기:", sp.get_piece_size())
확인한 실제 사전 크기는 8,000개였다.
이 값은 리뷰 수나 리뷰당 단어 수가 아니라, 특수 토큰을 포함한 토큰 종류의 수다.
만약
x_temp전체로 사전을 만들었다면 검증 데이터도 사전 학습에 포함된다. 엄밀하게 비교하려면x_train만으로 사전을 다시 만들고 모델도 다시 학습해야 한다.
4. 토큰화
같은 SentencePiece 사전으로 학습·검증·테스트 리뷰를 토큰 ID 목록으로 변환했다.
def tokenize(reviews):
    return [
        sp.encode(" ".join(review.split()), out_type=int)
        for review in reviews
    ]

x_train_ids = tokenize(x_train)
x_val_ids = tokenize(x_val)
x_test_ids = tokenize(x_test)out_type=int는 토큰을 숫자 ID로 반환한다.
각 리뷰는 다음과 같은 형태가 된다.
[
    [15, 28, 93, ...],
    [42, 17, 65, 81, ...],
    ...
]
리뷰마다 토큰 수가 다르기 때문에 아직 고정된 크기의 텐서는 아니다.
5. 리뷰 길이 확인
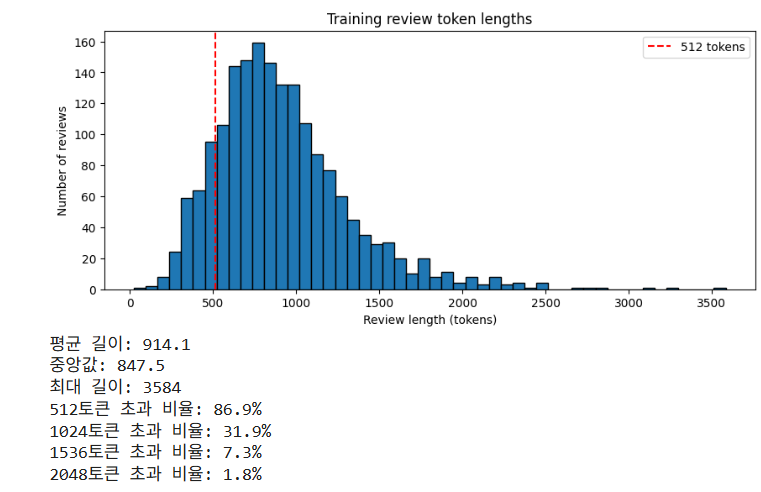
패딩 전 학습 리뷰의 토큰 길이를 확인했다.
import numpy as np
import matplotlib.pyplot as plt

lengths = np.array([len(ids) for ids in x_train_ids])

plt.figure(figsize=(10, 4))
plt.hist(lengths, bins=50, edgecolor="black")
plt.axvline(512, color="red", linestyle="--", label="512 tokens")
plt.xlabel("Review length (tokens)")
plt.ylabel("Number of reviews")
plt.title("Training review token lengths")
plt.legend()
plt.show()

print(f"평균 길이: {lengths.mean():.1f}")
print(f"중앙값: {np.median(lengths):.1f}")
print(f"최대 길이: {lengths.max()}")

# 글자수 별로 잘리는 비율
for limit in [512, 1024, 1536, 2048]:
    print(f"{limit}토큰 초과 비율: {(lengths > limit).mean():.1%}")
확인 결과
| 항목 | 값 |
|---|---|
| 평균 길이 | 914.1토큰 |
| 중앙값 | 847.5토큰 |
| 최대 길이 | 3,584토큰 |
| 512토큰 초과 비율 | 86.9% |
512토큰으로 제한하면 대부분의 리뷰에서 일부 내용이 잘린다.
중앙값인 847.5토큰짜리 리뷰는 512개만 남기면 약 39%의 토큰을 버리게 된다. 따라서 리뷰의 어느 부분을 남기는지도 중요한 실험 조건이 된다.
6. 패딩과 자르기
최대 길이를 512로 정하고, 짧은 리뷰는 오른쪽에 패딩을 추가했다.
비교한 조건은 두 가지다.
ids[:512]   # 앞 512토큰 유지
ids[-512:]  # 뒤 512토큰 유지
뒤의 512토큰을 사용하는 패딩 함수는 다음과 같다.
import torch

MAX_LEN = 512
PAD_ID = sp.pad_id()

def pad_reviews(token_lists):
    padded = [
        ids[-MAX_LEN:] + [PAD_ID] * max(0, MAX_LEN - len(ids))
        for ids in token_lists
    ]
return torch.tensor(padded, dtype=torch.long)- 긴 리뷰: 마지막 512토큰만 유지
- 짧은 리뷰: 전체 토큰을 유지하고 오른쪽에 패딩 추가
- 정확히 512토큰인 리뷰: 그대로 사용
뒤쪽을 남기는 것은 역순으로 읽는다는 뜻이 아니다. 남겨진 토큰은 원래 순서대로 RNN에 들어간다.
7. Dataset과 DataLoader
from torch.utils.data import TensorDataset, DataLoader

X_train_tensor = pad_reviews(x_train_ids)
X_val_tensor = pad_reviews(x_val_ids)
X_test_tensor = pad_reviews(x_test_ids)

y_train_tensor = torch.tensor(y_train, dtype=torch.long)
y_val_tensor = torch.tensor(y_val, dtype=torch.long)
y_test_tensor = torch.tensor(y_test, dtype=torch.long)

train_dataset = TensorDataset(X_train_tensor, y_train_tensor)
val_dataset = TensorDataset(X_val_tensor, y_val_tensor)
test_dataset = TensorDataset(X_test_tensor, y_test_tensor)

train_loader = DataLoader(
    train_dataset, batch_size=32, shuffle=True
)
val_loader = DataLoader(
    val_dataset, batch_size=32, shuffle=False
)
test_loader = DataLoader(
    test_dataset, batch_size=32, shuffle=False
)
학습 입력 텐서의 크기는 (1440, 512)다.
배치 하나를 꺼내면 다음과 같다.
X_batch: (32, 512)
y_batch: (32,)
8. 모델 구조
모델은 Embedding → 단방향 RNN 1층 → Linear 출력층으로 구성했다.
입력 토큰 ID
(32, 512)
    ↓
Embedding
(32, 512, 128)
    ↓
RNN
각 토큰을 순서대로 처리
    ↓
마지막 실제 토큰의 은닉 상태
(32, 128)
    ↓
Linear
(32, 2)
    ↓
[부정 점수, 긍정 점수]
RNN의 input_size=128은 토큰 하나를 나타내는 벡터의 길이다.
리뷰 하나에는 최대 512개의 토큰 벡터가 들어가며, RNN은 각 단계에서 현재 토큰 벡터와 이전 은닉 상태를 이용해 새로운 상태를 계산한다.
import torch.nn as nn
from torch.nn.utils.rnn import pack_padded_sequence

class ReviewRNN(nn.Module):
    def __init__(
        self,
        vocab_size,
        embedding_dim=128,
        hidden_dim=128,
        pad_id=0
    ):
        super().__init__()

        self.pad_id = pad_id

        self.embedding = nn.Embedding(
            num_embeddings=vocab_size,
            embedding_dim=embedding_dim,
            padding_idx=pad_id
        )

        self.rnn = nn.RNN(
            input_size=embedding_dim,
            hidden_size=hidden_dim,
            batch_first=True
        )

        self.output = nn.Linear(hidden_dim, 2)

    def forward(self, x):
        lengths = (x != self.pad_id).sum(dim=1)
        embedded = self.embedding(x)

        packed = pack_padded_sequence(
            embedded,
            lengths.cpu(),
            batch_first=True,
            enforce_sorted=False
        )

        _, hidden = self.rnn(packed)
        logits = self.output(hidden[-1])

return logitspack_padded_sequence는 별도의 학습 층이 아니다. RNN이 패딩을 제외하고 실제 리뷰 부분만 처리하도록 입력을 준비한다.
패딩 벡터가 0이어도 RNN이 계속 계산하면 은닉 상태는 바뀔 수 있으므로, 실제 길이를 알려주는 처리가 필요하다.
9. 학습 설정
| 설정 | 값 |
|---|---|
| 사전 크기 | 8,000 |
| 최대 토큰 길이 | 512 |
| 임베딩 차원 | 128 |
| 은닉 차원 | 128 |
| 배치 크기 | 32 |
| Epoch | 10 |
| Optimizer | Adam |
| 학습률 | 0.001 |
| 손실 함수 | CrossEntropyLoss |
학습은 다음 순서로 진행했다.
optimizer.zero_grad()
logits = model(X_batch)
loss = criterion(logits, y_batch)

loss.backward()
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
optimizer.step()CrossEntropyLoss에는 softmax를 적용하지 않은 logits를 전달한다.
예측 라벨은 점수가 더 높은 클래스로 정한다.
predictions = logits.argmax(dim=1)10. 조건별 정확도 비교
리뷰의 앞 512토큰과 뒤 512토큰을 사용한 결과를 비교했다.
아래 테스트 결과는 각각 10번째 epoch 모델을 평가한 값이다.
| 지표 | 앞 512토큰 | 뒤 512토큰 |
|---|---|---|
| 마지막 학습 정확도 | 100.00% | 98.19% |
| 최고 검증 정확도 | 53.33% | 53.89% |
| 마지막 검증 정확도 | 52.22% | 51.39% |
| 마지막 검증 손실 | 2.5712 | 2.0023 |
| 테스트 정확도 | 54.50% | 58.00% |
| 테스트 손실 | 2.2025 | 1.5880 |
| 테스트 정답 수 | 109 / 200 | 116 / 200 |
이번 실행에서는 뒤쪽을 사용한 경우 테스트 정확도가 3.5%p 높았고, 리뷰 7개를 더 맞혔다.
하지만 최고 검증 정확도 차이는 약 0.56%p로, 검증 리뷰 360개 중 2개 차이였다. 따라서 한 번의 실행만으로 뒤쪽이 항상 더 좋다고 판단하기는 어렵다.
11. 결과 해석: 과적합
두 조건 모두 학습 정확도는 높아졌지만, 검증 정확도는 약 50%대에 머물렀다. 검증 손실도 학습이 진행될수록 증가했다.
이는 학습 데이터에는 잘 맞지만 새로운 데이터에는 잘 적용되지 않는 과적합 양상이다.
가능한 원인은 다음과 같다.
- 학습 데이터 규모에 비해 많은 파라미터
- 긴 시퀀스의 정보를 유지하기 어려운 기본 RNN
- 마지막 은닉 상태 하나로 리뷰 전체를 표현하는 방식
- 512토큰 제한으로 인한 정보 손실
로그만으로 원인을 하나로 확정할 수는 없다. 다만 리뷰를 자르는 위치만 바꾸는 것으로는 문제가 해결되지 않았다.
12. 사전 크기와 은닉 차원을 바꿀 때
사전 크기
| 변경 | 장점 | 단점 |
|---|---|---|
| 늘리기 | 단어가 덜 쪼개져 리뷰당 토큰 수가 줄어드는 경향 | 임베딩 파라미터 증가, 드문 토큰의 학습 사례 부족 |
| 줄이기 | 공통 조각을 공유하고 파라미터가 줄어 적은 데이터에서 유리할 수 있음 | 리뷰당 토큰 수가 늘어 더 많은 내용이 잘릴 수 있음 |
작은 사전에서는 여러 단어가 공통 조각을 공유한다. 개별 단어가 드물게 등장하더라도 공통 조각의 벡터는 여러 사례에서 학습할 수 있다.
임베딩 파라미터 수는 다음과 같다.
사전 크기 × 임베딩 차원

8,000 × 128 = 1,024,000
4,000 × 128 =   512,000
은닉 벡터 길이
| 변경 | 장점 | 단점 |
|---|---|---|
| 늘리기 | 복잡한 특징을 표현할 용량 증가 | 계산량과 파라미터 증가, 과적합 가능성 |
| 줄이기 | 계산량 감소, 과적합 완화 가능성 | 너무 작으면 필요한 정보 표현이 어려움 |
hidden_dim=128은 128개 토큰을 기억한다는 뜻이 아니라, 정보를 담는 상태 벡터의 길이가 128이라는 뜻이다.
은닉 차원을 늘려도 긴 리뷰의 정보를 유지하는 문제가 자동으로 해결되지는 않는다.
13. 다음 실험 계획
아직 실행하지 않은 개선 실험은 다음과 같다.
- 은닉 차원을 128에서 64로 줄이기
- Dropout과 weight decay 적용하기
- 검증 손실 기준으로 조기 종료하고 최적 가중치 복원하기
- 마지막 상태 대신 패딩을 제외한 RNN 출력의 평균 사용하기
- 과제 조건이 허용하면 GRU 또는 LSTM 사용하기
- 모델을 고정한 상태에서 최대 길이를 512에서 1,024로 늘리기
토큰 길이를 늘리면 더 많은 내용을 보존할 수 있지만, 기본 RNN이 그 정보를 충분히 활용할 수 있는지는 별도의 문제다.
따라서 한 조건씩 바꾸고 검증 성능으로 비교할 예정이다. 최종 모델을 선택한 뒤 테스트 데이터로 평가한다.
배운 점
- 데이터에 숫자 평점이 없으면 실제 별점 예측을 학습할 수 없다.
- SentencePiece 사전은 학습 데이터만으로 만든다.
- 최대 토큰 길이를 정하기 전에 실제 길이 분포를 확인해야 한다.
- 학습 정확도 100%가 새로운 데이터에서의 높은 성능을 의미하지는 않는다.
- 입력 길이, 사전 크기, 은닉 차원은 서로 영향을 주므로 함께 고려해야 한다.
- 이번에는 뒤 512토큰의 테스트 정확도가 높았지만, 검증 성능 차이가 작아 우월성을 확정할 수 없었다.