제가 이해한 내용을 바탕으로 중요하다 생각하는 부분만 작성한 CS APP 3장입니다.
일부의 부분만 서술한 것이라 책을 보기 전 읽어보고 책을 읽으며 다시 이해해보는 것을 추천 드립니다!
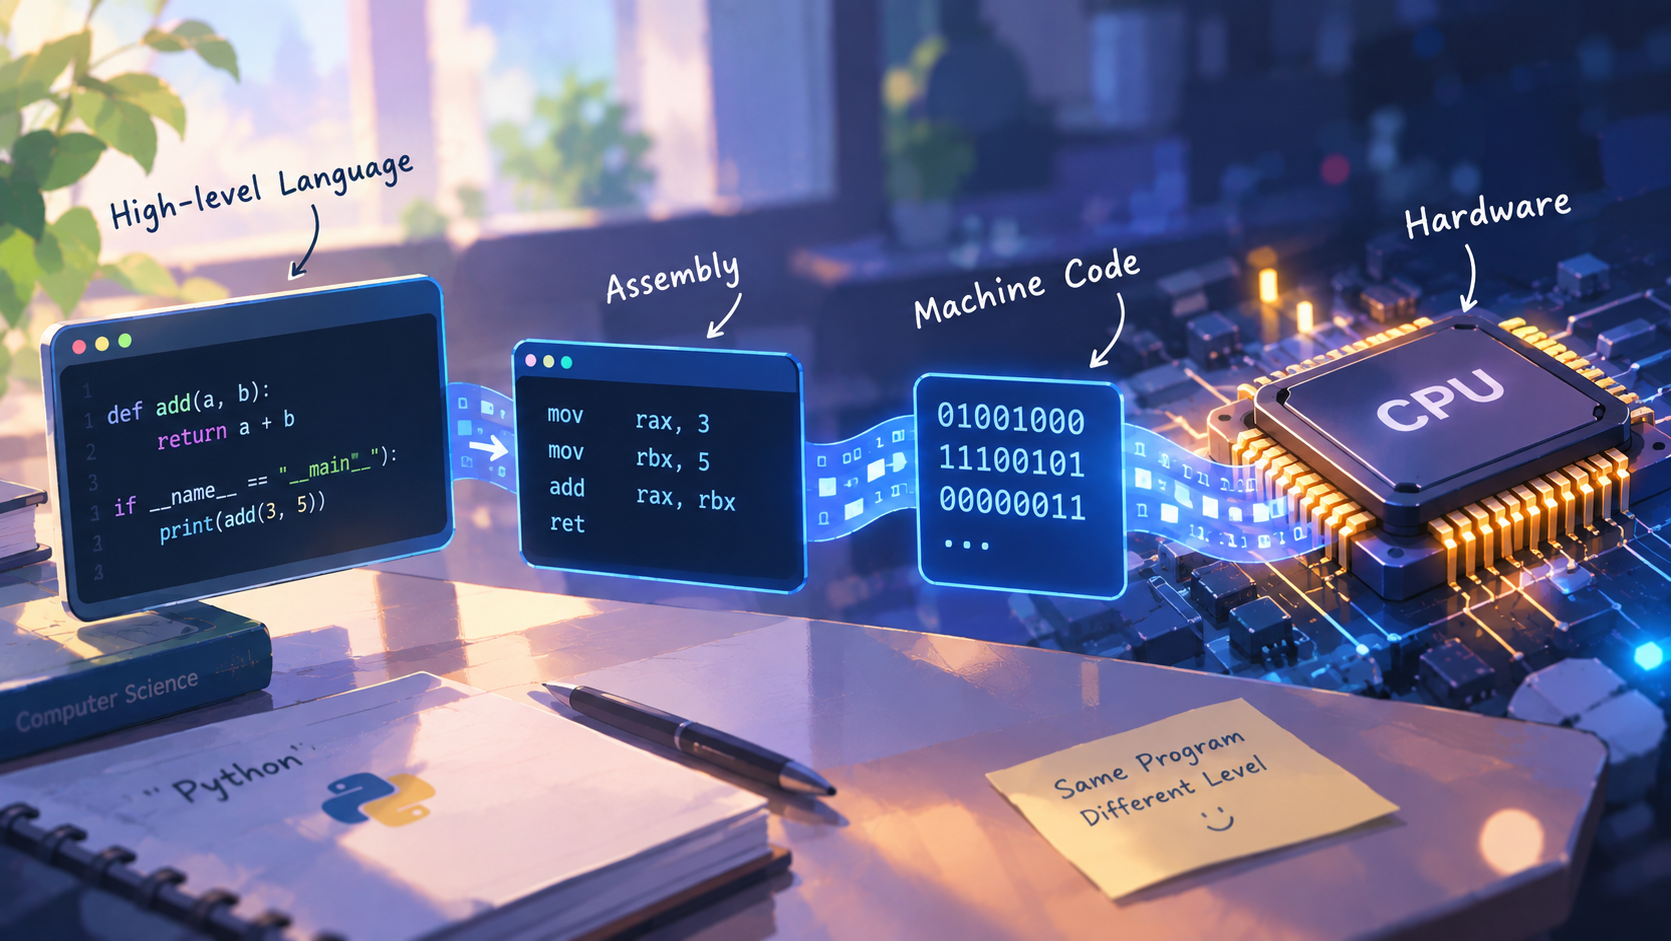
이 장은 우리가 작성한 C 코드가 GCC 컴파일러를 거쳐 어셈블리어로 어떻게 바뀌는지 보여주는 장이다.
컴파일러는 최적화 수준에 따라 C 코드를 다르게 변환한다.
최적화가 높을수록 빠르지만 사람이 읽을 수 없는 코드가 된다.
이 장에서 나오는 어셈블리어는 -Og 단계로, 디버깅이 가능한 수준의 최적화다.
실제 개발에서도 디버깅할 땐 이 단계를 쓴다.
전부 이해하려고 하면 너무 어려운 장이라 선택과 집중이 필요했다.
어셈블리어를 직접 짜거나 주소를 손으로 계산할 일은 없겠지만,
어떻게 계산되는지, 뭐가 뭐를 의미하는지 알고 가면 분명 도움이 된다.
오퍼랜드 — 값이 어디에 있는지 말하는 법
어셈블리 명령어는 "무엇을" "어디서" 가져올지를 오퍼랜드로 표현한다.
오퍼랜드는 세 종류다.
| 종류 | 표기 예시 | 의미 |
|---|---|---|
| 즉시값 (Immediate) | $42 | 값 자체. 상수. |
| 레지스터 (Register) | %rax | CPU 안의 저장소에서 가져옴 |
| 메모리 (Memory) | (%rax) | 레지스터가 가리키는 메모리 주소에서 가져옴 |
%rax는 레지스터 안의 값이고, (%rax)는 괄호가 붙으면서 "그 값을 주소로 써서 메모리를 읽어라"가 된다.
C로 치면 변수 a와 포인터 *a의 차이와 같다.
메모리 오퍼랜드는 단순히 (%rax)만 있는 게 아니다.
배열이나 구조체에 접근하려면 주소를 계산해야 하기 때문에 여러 형태가 있다.
가장 일반적인 형태는 이렇다.
D(Rb, Ri, S) → 유효 주소 = Rb + Ri × S + D여기서 각 자리를 생략하면 다른 형태가 된다.
메모리 형태는 전부 위 점화식의 부분집합이고, 즉시값과 레지스터는 별도 종류다.
| 형태 | 계산 | 쓰임 |
|---|---|---|
$Imm | Imm | 즉시값 (상수) |
%rax | R[rax] | 레지스터 |
Imm | M[Imm] | 절대 주소 |
(%Rb) | M[R[Rb]] | 간접 참조 — C의 *p |
D(%Rb) | M[D + R[Rb]] | 구조체 필드 접근 |
(%Rb, %Ri) | M[R[Rb] + R[Ri]] | 두 레지스터 합산 |
D(%Rb, %Ri) | M[D + R[Rb] + R[Ri]] | 위에 오프셋 추가 |
(, %Ri, S) | M[R[Ri] × S] | 스케일만 |
(%Rb, %Ri, S) | M[R[Rb] + R[Ri] × S] | 배열 접근 — a[i] |
D(%Rb, %Ri, S) | M[D + R[Rb] + R[Ri] × S] | 구조체 배열 — a[i].field |
S(스케일)는 1, 2, 4, 8만 가능하다. 타입 크기와 딱 맞는다.
예를 들어 int 배열 a[i]에 접근한다면:
movl (%rdi, %rsi, 4), %eax
     ──────────────
     유효 주소 = rdi + rsi × 4
     배열 시작 + 인덱스 × int 크기(4바이트)
C에서 a[i]라고 쓰면 컴파일러가 이렇게 바꾼다.
배열 접근이 결국 곱셈과 덧셈이라는 걸 여기서 볼 수 있다.
lea — 주소 계산을 산술 연산으로 쓰기
lea는 Load Effective Address의 약자다.
이름은 "주소를 가져와라"인데, 실제로는 메모리에 접근하지 않고 주소 계산만 한다.
leaq (%rdi, %rdi, 2), %rax → rax = rdi + rdi × 2 = rdi × 3메모리를 읽는 게 아니라 rdi × 3이라는 산술 연산 결과를 rax에 넣은 것이다.
컴파일러는 x * 3 같은 곱셈을 이렇게 lea로 바꿔버린다.
곱셈 명령어보다 빠르기 때문이다.
처음 봤을 때 "주소 명령어를 왜 계산에 쓰지?" 싶었는데,
하드웨어 입장에선 주소 계산이나 정수 계산이나 같은 덧셈·곱셈이라 가능한 거다.
데이터를 옮기는 법 — mov
메모리는 1바이트짜리 칸이 쭉 늘어선 구조다.
값을 옮길 때는 위치만 말하면 안 되고, 몇 바이트를 옮길지도 같이 말해야 한다.
그래서 mov 뒤에 크기를 뜻하는 글자를 붙인다.
| 글자 | 바이트 | 예시 타입 |
|---|---|---|
b | 1 | char |
w | 2 | short |
l | 4 | int |
q | 8 | long |
movl이면 4바이트를 옮기고, movq면 8바이트를 옮긴다.
도착 타입의 크기를 보고 어떤 mov를 쓸지 정한다.
크기가 다른 타입 사이에서 옮길 땐 확장이 필요하다.
movs는 부호 확장 (Sign extend), movz는 제로 확장 (Zero extend)이다.
movsbl (%rdi), %eax    ← char(1바이트) → int(4바이트), 부호 유지
movzbl (%rdi), %eax    ← unsigned char → int, 빈 자리를 0으로 채움
여기서 재밌었던 건 unsigned다.
unsigned는 크기를 적는 단어가 없는데 4바이트였다.
이유는 unsigned = unsigned int이기 때문이다.
C에서 크기를 안 적으면 int가 채워진다.
조건과 분기 — cmp, jmp
C에서 if문을 쓰면 어셈블리에서는 비교 → 점프 두 단계로 바뀐다.
if (x > 0) { ... }cmpl $0, %edi ← x와 0을 비교 (뺄셈을 하되 결과는 버림)
jle .L2 ← 작거나 같으면 .L2로 점프 (else 블록)
... ← if 블록 코드
.L2:cmp는 실제로 뺄셈을 한다. 결과값은 버리고 플래그만 세팅한다.
그 플래그를 보고 jle(less or equal이면 점프), jg(greater면 점프) 같은 조건 점프가 동작한다.
반복문도 마찬가지다.
for나 while은 조건 비교 + 조건 점프 + 무조건 점프(되돌아가기)로 구현된다.
결국 기계 수준에서 제어 흐름은 전부 비교하고 점프하는 것뿐이다.
함수 호출과 인자 전달
C에서 함수를 호출하면 인자는 어디로 갈까?
x86-64에서는 처음 6개 인자를 레지스터로 전달한다.
| 순서 | 레지스터 |
|---|---|
| 1번째 | %rdi |
| 2번째 | %rsi |
| 3번째 | %rdx |
| 4번째 | %rcx |
| 5번째 | %r8 |
| 6번째 | %r9 |
7번째부터는 스택에 쌓인다.
long add(long a, long b) { return a + b; }addq %rsi, %rdi ← a는 %rdi, b는 %rsi에 이미 들어와 있음
movq %rdi, %rax ← 결과를 %rax에 넣어서 반환
ret반환값은 항상 %rax에 넣는다. 이건 호출하는 쪽과 받는 쪽이 미리 정한 약속(calling convention)이다.
또 하나 알아야 할 건 callee-saved / caller-saved 구분이다.
함수를 호출하면 레지스터 값이 덮어씌워질 수 있는데,
누가 원래 값을 보존할 책임이 있는지를 정해둔 것이다.
- caller-saved (
%rax,%rdi,%rsi등) — 호출하는 쪽이 필요하면 미리 저장. 호출된 함수는 마음대로 써도 됨. - callee-saved (
%rbx,%rbp,%r12~%r15) — 호출된 함수가 쓰려면 먼저 저장하고, 돌아가기 전에 복원해야 함.
이 규칙 덕분에 함수끼리 레지스터를 공유하면서도 값이 꼬이지 않는다.
구조체와 메모리 정렬 (Alignment)
구조체의 크기가 멤버 크기의 단순 합보다 큰 경우가 있다.
이유는 패딩 때문이다.
struct S1 {
    char  c;   // 1바이트
    int   i;   // 4바이트
    char  d;   // 1바이트
};
// sizeof = ?
단순 합이면 1 + 4 + 1 = 6바이트일 것 같지만, 실제로는 12바이트다.
주소:  0    1  2  3   4  5  6  7      8    9 10 11
     [ c ] [ 패딩 ] [ i  i  i  i ] [ d ] [ 패딩 ]
CPU는 데이터를 읽을 때 자기 크기의 배수 주소에서 읽는 게 가장 빠르다.
int(4바이트)는 4의 배수 주소에 놓여야 하고, long(8바이트)은 8의 배수에 놓여야 한다.
이걸 정렬 제약 (alignment requirement)이라고 한다.
그래서 컴파일러가 멤버 사이에 빈 바이트(패딩)를 끼워넣어서 정렬을 맞춘다.
구조체 전체 크기도 가장 큰 멤버의 정렬값의 배수로 맞춰진다.
멤버 순서를 바꾸면 패딩이 줄어든다.
struct S2 {
    int   i;   // 4바이트
    char  c;   // 1바이트
    char  d;   // 1바이트
};
// sizeof = 8바이트
주소: 0 1 2 3 4 5 6 7
[ i i i i ] [ c ] [ d ][ 패딩 ]같은 멤버인데 순서만 바꿨더니 12바이트 → 8바이트가 됐다.
큰 타입부터 선언하면 패딩 낭비를 줄일 수 있다.
메모리에 쌓이는 과정 — 스택
책을 보면 더 쉽게 이해할 수 있습니다.
그림은 책을 참고해보세요
함수가 호출되면 스택 프레임이라는 공간이 스택에 쌓인다.
그 안에 지역 변수, 리턴 주소 같은 것들이 들어간다.
스택은 높은 주소에서 낮은 주소로 자란다.
함수를 호출하면 스택 포인터(%rsp)가 아래로 내려가면서 공간을 확보하고,
함수가 끝나면 다시 올라오면서 공간을 반납한다.
높은 주소  ┌─────────────┐
            main 프레임
          ├─────────────┤
            foo 프레임     ← 함수 호출하면 아래로 쌓임
          ├─────────────┤
            bar 프레임     ← %rsp가 여기를 가리킴
낮은 주소  └─────────────┘
이 구조를 알면 "왜 지역 변수는 함수가 끝나면 사라지는지"가 바로 이해된다.
스택 포인터가 올라가면서 그 공간을 버리기 때문이다.
스택 오버플로우
스택은 무한히 자랄 수 없다. 크기가 정해져 있다.
재귀를 너무 깊게 돌리거나, 지역 변수로 엄청 큰 배열을 잡으면
스택이 허용된 범위를 넘어서 스택 오버플로우가 발생한다.
void infinite() {
    infinite();  // 리턴 없이 계속 호출 → 프레임이 끝없이 쌓임
}
재귀할 때 종료 조건을 빠뜨리면 이렇게 터진다.
"Segmentation fault"라는 에러를 봤다면 이게 원인일 수 있다.
버퍼 오버플로우 — 스택을 아는 게 왜 중요한가
책의 연습문제를 풀어보세요
풀지 못하더라도 풀이를 보면 바로 이해할 수 있습니다.
스택 구조를 아는 게 단순히 "교양"이 아닌 이유가 있다.
버퍼 오버플로우라는 보안 취약점이 바로 스택 구조에서 나오기 때문이다.
스택 프레임에는 지역 변수와 함께 리턴 주소가 저장된다.
함수가 끝나면 이 주소로 돌아간다.
높은 주소  ┌──────────────┐
            리턴 주소       ← 함수 끝나면 여기로 돌아감
          ├──────────────┤
            ...
          ├──────────────┤
            buf[0~15]       ← 지역 배열
낮은 주소  └──────────────┘
그런데 배열에 크기를 넘겨서 쓰면? 스택은 아래서 위로 채워지니까
배열을 넘친 데이터가 리턴 주소를 덮어쓴다.
void vulnerable() {
    char buf[16];
    gets(buf);   // 입력 길이를 체크하지 않음 → 16바이트 넘으면 리턴 주소까지 덮음
}
공격자가 리턴 주소를 원하는 코드의 주소로 바꿔넣으면,
함수가 끝날 때 공격자의 코드가 실행된다.
이게 가장 고전적인 해킹 기법 중 하나다.
그래서 현대 시스템은 방어 기법을 쓴다.
- 스택 카나리 (Stack Canary) — 리턴 주소 앞에 랜덤 값을 넣어두고, 함수 리턴 전에 값이 바뀌었는지 검사
- ASLR — 스택 주소를 실행할 때마다 랜덤하게 배치해서 주소를 예측 불가능하게 만듦
- NX 비트 — 스택 영역의 코드 실행을 하드웨어가 차단
감사합니다 :)
잘 보고 갑니다