CS APP의 1장 내용을 간단하게 정리해봤다.
전체적으로 자세한 설명보단 흐름을 알려주는 내용들이라
쉽게 접할 수 있었다.
1. 컴파일 시스템 (4단계)
-
전처리기(Preprocessor)
#include,#define등 지시문을 텍스트 수준에서 확장
.c→.i -
컴파일러(Compiler)
C 소스를 어셈블리어로 번역
.i→.s -
어셈블러(Assembler)
어셈블리어를 기계어 바이너리(재배치 가능 오브젝트)로 변환
.s→.o -
링커(Linker)
여러.o파일과 라이브러리를 합치고, 외부 함수 주소를 채워서 실행 파일 생성
.o→ 실행파일 -
실행 가능 목적파일(Executable Object File)
링커의 최종 산출물. 메모리에 적재하면 바로 실행 가능한 바이너리
링커가 중요한 이유:
분할 컴파일 가능(파일별로 따로 컴파일 후 합침), 라이브러리 재사용, 빌드 시간 단축
2. 시스템 하드웨어 구성
-
버스(Bus)
컴포넌트 간 바이트 정보를 전송하는 전기적 통로
워드(word) 단위로 전송. 현대 64비트 시스템에서 1워드 = 8바이트 -
I/O 장치
키보드, 마우스, 디스플레이, 디스크 등. I/O 버스를 통해 시스템에 연결- 컨트롤러: 디바이스 자체 또는 마더보드에 내장된 칩셋 (디스크 컨트롤러, USB 컨트롤러)
- 어댑터: 마더보드 슬롯에 꽂는 카드 형태 (그래픽카드 등)
- 기능은 같고 패키징 방식의 차이
-
I/O 브리지
CPU · 메모리 · I/O 장치 세 갈래를 연결하는 중앙 허브 칩 -
메인 메모리
DRAM으로 구성
프로그램 실행 중 코드와 데이터를 저장하는 임시 저장 장치
전원 꺼지면 사라짐 -
프로세서(CPU)
메인메모리에 저장된 명령어를 실행하는 엔진- PC(프로그램 카운터): 다음에 실행할 명령어의 메모리 주소를 가리키는 레지스터
- 레지스터 파일: CPU 내부의 초고속 저장 공간. 각각 1워드 크기
- ALU(산술논리연산장치): 실제 산술 · 논리 연산을 수행하는 회로
3. CPU 명령어 4가지 타입
-
적재(Load)
메인메모리 → 레지스터로 데이터 복사 -
저장(Store)
레지스터 → 메인메모리로 데이터 복사 -
작업(Operate)
레지스터 두 개의 값을 ALU로 복사 → 연산 → 결과를 레지스터에 덮어쓰기 -
점프(Jump)
명령어에서 워드를 추출해 PC에 복사 → 다음 실행 위치 변경
(if, while, goto)
fetch-decode-execute 사이클
PC가 가리키는 주소에서 명령어를 읽고(fetch)
→ 해석하고(decode)
→ 실행한 뒤(execute)
→ PC를 다음 명령어로 업데이트
CPU는 이것을 무한 반복
4. hello 프로그램 실행 흐름
-
키보드 입력
키보드 → I/O 버스 → I/O 브리지 → 시스템 버스 → CPU 레지스터
→ 시스템 버스 → I/O 브리지 → 메모리 버스 → 메인메모리에 저장
(한 글자씩 CPU가 중계) -
프로그램 로딩 (DMA)
셸이 hello 실행
→ 디스크 → I/O 버스 → I/O 브리지 → 메모리 버스 → 메인메모리
(CPU를 거치지 않고 직통 = DMA) -
실행
CPU가 메인메모리에서 명령어를 fetch → decode → execute 반복 -
출력
결과 문자열이 메모리 → I/O 브리지 → I/O 버스 → 디스플레이로 전송
DMA(Direct Memory Access)
디스크 컨트롤러가 CPU 개입 없이 데이터를 디스크에서 메인메모리로 직접 전송하는 기술
CPU는 그동안 다른 작업 가능
5. 캐시 메모리
- 존재 이유: CPU 레지스터와 메인메모리의 속도 차이를 줄이기 위한 중간 저장 장치
- SRAM: 캐시에 사용. 플립플롭 회로 기반. 빠르지만 비싸고 작음
- DRAM: 메인메모리에 사용. 커패시터 기반. 느리지만 싸고 큼
- 캐시라인: 한 번에 가져오는 단위 = 64바이트
지역성 (Locality)
-
시간적 지역성(Temporal)
최근 접근한 데이터를 곧 다시 접근할 확률이 높음
(for문의 i) -
공간적 지역성(Spatial)
접근한 주소의 인접 데이터를 곧 접근할 확률이 높음
(배열 순회) → 캐시라인 64바이트 통째 적재의 근거
저장 장치 계층 구조 (위로 갈수록 빠르고, 작고, 비쌈)
레지스터          ← CPU 내부, 가장 빠름
L1 캐시 (SRAM)    ← 코어당 전용, ~1ns
L2 캐시 (SRAM)    ← 코어당 전용, ~4ns
L3 캐시 (SRAM)    ← 코어 간 공유, ~10ns
메인메모리 (DRAM) ← ~100ns
디스크 (SSD/HDD)  ← ~ms 단위
원격 서버         ← 네트워크 지연
핵심 원리: 각 층은 바로 아래 층의 캐시 역할
Redis가 DB의 캐시, CDN이 오리진 서버의 캐시인 것도 같은 원리
6. 운영체제(OS)
존재 이유
- 보호: 응용 프로그램이 하드웨어를 잘못 사용하는 것을 방지
- 추상화: 복잡한 하드웨어를 단순하고 동일한 인터페이스로 제공
OS의 3대 추상화
- 프로세스: 프로세서 + 메인메모리 + I/O 장치를 추상화
- 가상 메모리: 메인메모리 + 디스크를 추상화
- 파일: I/O 장치를 추상화
7. 프로세스
-
정의
실행 중인 프로그램의 인스턴스
코드 + 데이터 + 실행 상태를 포함 -
PCB(Process Control Block)
OS 커널이 프로세스마다 관리하는 정보 블록
(PID, 레지스터 상태, 메모리 매핑 등) -
프로세스 상태
실행(Running) / 대기(Ready) / 블록(Blocked) -
컨텍스트 스위칭
현재 프로세스의 상태(PC, 레지스터 등)를 PCB에 저장
→ 다음 프로세스의 상태를 PCB에서 복원
비용이 있으므로 무한정 전환 불가 -
user mode / kernel mode
일반 코드는 user mode에서 실행
→ 시스템 콜(read, write 등) 호출 시 kernel mode로 전환
→ OS가 하드웨어 접근 수행
→ 다시 user mode 복귀
8. 스레드
-
정의: 프로세스 내부의 실행 흐름 단위
-
프로세스와 차이
같은 프로세스의 스레드끼리 코드 · 힙 · 전역변수 공유
스택만 각자 소유 -
멀티스레드: 하나의 프로세스에서 여러 스레드를 실행
-
위험성: 공유 메모리에 동시 접근 → race condition 발생 가능
race condition 예시: count++
count++은 CPU에서 3단계로 실행됨:
① Load:    메모리에서 count → 레지스터  (값: 0)
② Operate: 레지스터 +1                 (값: 1)
③ Store:   레지스터 → 메모리에 쓰기     (값: 1)
두 스레드가 동시에 count++ 하면 (기대값: 2):
A: Load(0) → Operate(1) →              → Store(1)
B:           → Load(0)   → Operate(1)  → Store(1)

결과: 1 (증가분 1 소실)해결: synchronized (블록 잠금), AtomicInteger (하드웨어 원자적 연산)
9. 동시성 vs 병렬성
-
동시성(Concurrency)
여러 작업이 논리적으로 겹치는 시간에 진행
코어 1개에서 빠른 전환(컨텍스트 스위칭)으로 가능
"동시에 하는 것처럼 보임" -
병렬성(Parallelism)
여러 작업이 물리적으로 같은 순간에 실행
코어 2개 이상 필요
"진짜 동시"
동시성은 구조, 병렬성은 실행 방식
동시성이 있어야 병렬성 활용 가능
10. 병렬성의 3가지 수준
스레드 수준 병렬성
-
멀티코어에서 여러 스레드를 실제로 동시에 실행
-
하이퍼스레딩
물리 코어 1개에 PC · 레지스터 2세트 탑재. ALU 공유
한 스레드가 메모리 대기할 때 다른 스레드가 ALU 사용
"4코어 8스레드" = 물리 4개 + 하이퍼스레딩
명령어 수준 병렬성 (ILP)
-
CPU 하드웨어가 자동으로 수행하는 최적화
-
파이프라이닝
명령어1 Execute 하는 동안 명령어2 Decode, 명령어3 Fetch를 동시에
(세탁기 비유: 1번 건조 중 2번 세탁) -
슈퍼스칼라
파이프라인 여러 개를 깔아서 한 사이클에 2~6개 명령어 동시 처리
SIMD (Single Instruction, Multiple Data)
-
하나의 명령어로 여러 데이터를 동시에 연산
-
128/256비트 넓은 레지스터에 int 4~8개를 묶어서 한 번에 처리
-
사용처: 이미지/영상 처리, 과학 계산, ML 행렬 연산
11. 가상 주소 공간
-
정의
프로세스마다 각각 하나씩 독립적으로 존재하는 메모리 주소 체계 -
이유
프로세스 간 메모리 격리
각 프로세스가 0번지부터 사용 가능
가상 주소 → 물리 주소로 OS가 매핑
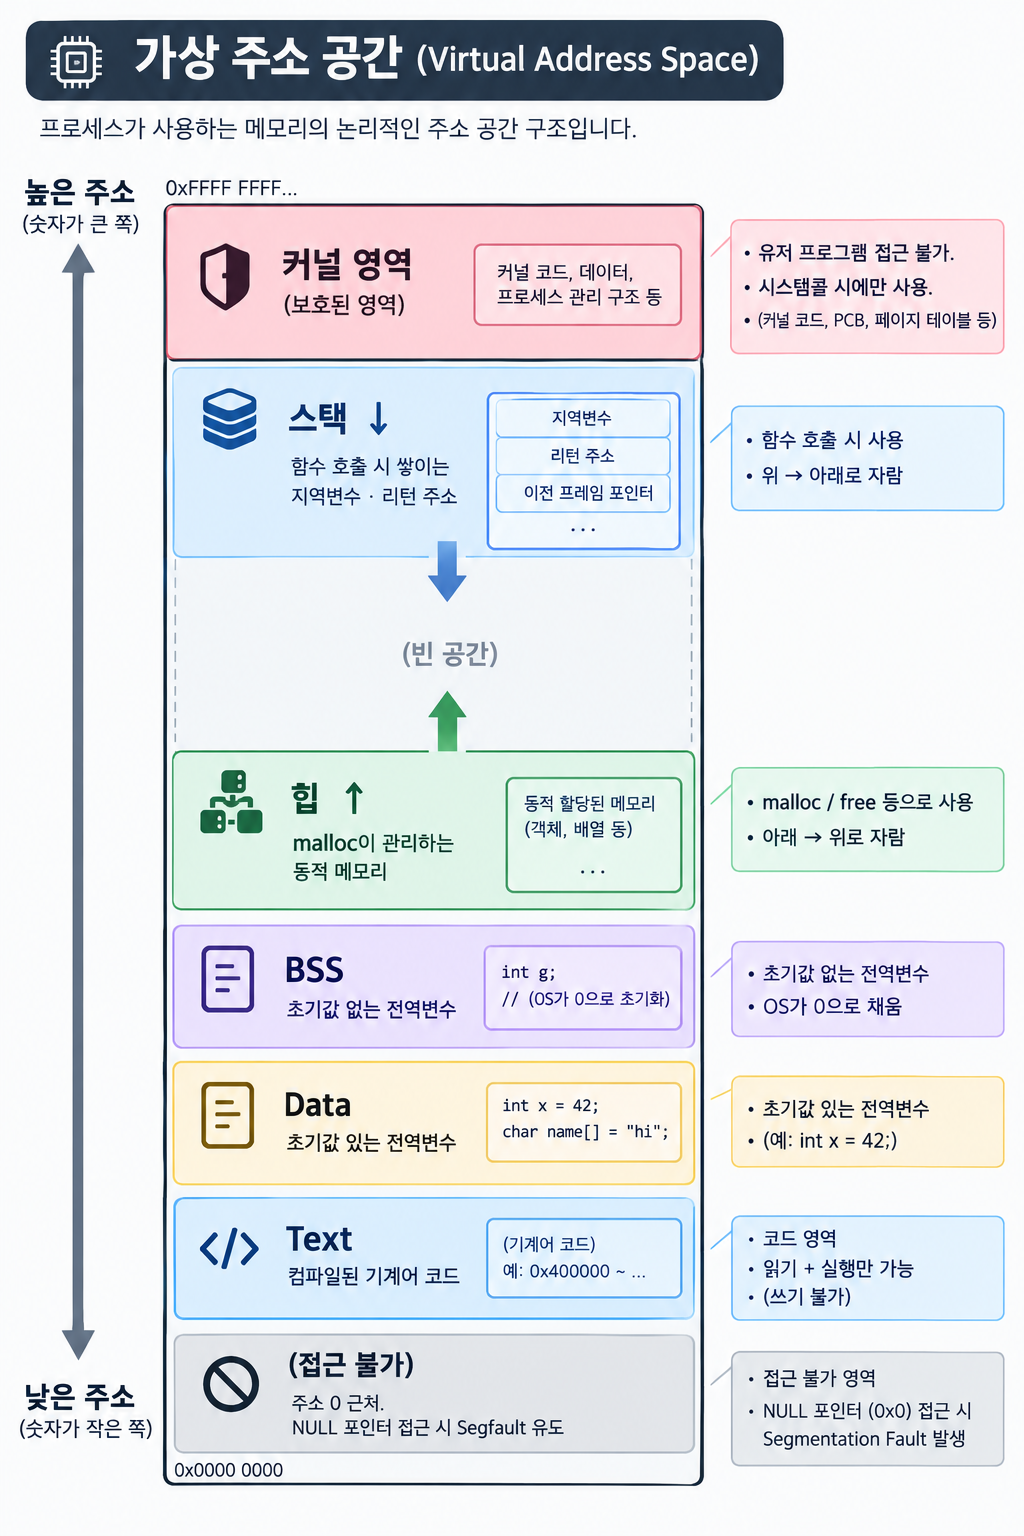
구조 (아래 → 위, 주소 증가 방향)
페이징
-
페이지
가상 주소와 물리 주소를 4KB 단위로 나눈 블록 -
디맨드 페이징(Demand Paging)
필요할 때만 페이지를 물리 메모리에 적재 -
페이지 폴트(Page Fault)
접근하려는 페이지가 RAM에 없을 때 발생
OS가 디스크에서 해당 페이지를 RAM으로 가져옴 -
페이지 교체(Page Replacement)
RAM이 꽉 찼을 때 기존 페이지를 디스크로 내보내고 새 페이지를 올림
LRU 등의 교체 알고리즘 사용
12. 파일
-
정의: 연속된 바이트의 나열
-
디스크, 키보드, 디스플레이, 네트워크 등 모든 I/O 장치를 파일로 모델링 (유닉스 철학)
-
동일한 read/write 인터페이스로 모든 I/O 처리 가능
13. Amdahl의 법칙
-
시스템 일부분만 개선하면 전체 성능 향상에 한계가 있음
-
전체 작업 중 해당 부분이 차지하는 비율이 클수록 개선 효과가 큼
-
극단적 성능 향상을 위해서는 시스템 전체를 개선해야 함
-
공식:
전체 속도 향상 = 1 / ((1 - 비율) + 비율/개선배수)
예: 전체의 60%를 차지하는 부분을 3배 빠르게
→ 전체 속도 향상 = 1/(0.4 + 0.6/3) = 1/0.6 = 1.67배 (3배가 아님)
14. 추상화의 계층
I/O 장치                  →  파일       (추상화)
파일 + 메인메모리          →  가상 메모리  (추상화)
가상 메모리 + 프로세서      →  프로세스    (추상화)
프로세스 + OS             →  가상 머신   (추상화)
각 층이 아래의 복잡한 하드웨어를 감추고, 위에 단순한 인터페이스를 제공