우리는 바로 코딩하면 어떻게 되는지 알고 있다
이커머스 과제를 받았다. Brand, Product, Stock, Like, Order — 5개 도메인, 21개 API.
요구사항 문서를 읽으면서 떠오른 첫 번째 생각은 "일단 엔티티부터 만들어야 하지 않나?"였다.
하지만 회사에서 경험상, 바로 코딩부터 시작하게된 프로젝트는 결국 어떻게 흔들리게 되는지 안다.
중간에 테이블 구조가 바뀌고, API 스펙이 흔들리고, "이거 왜 이렇게 했지?" 하면서 이미 짠 코드를 뜯어고치게 된다.
그래서 이번에는 제대로 설계를 해보고 싶었다. 따라서. 코드를 한 줄도 치지 않고, 모든 애매한 부분을 먼저 드러내기로 했다.
Notion에 Q&A 브레인스토밍 페이지를 열고, 요구사항을 읽으면서 "이거 어떻게 하지?"라는 생각이 드는 순간마다 질문으로 적었다. 하나씩, 하나씩...
33개가 나왔다.
Q&A 브레인스토밍 — 애매한 것을 질문으로 만드는 방법
내가 사용한 방식은 단순하다.
애매한 부분을 질문으로 만들고, 선택지를 나열하고, 장단점을 비교한 뒤 결정한다.
여기서 "애매함을 아는 것"은 도메인에 대한 지식이 전제되어야 한다. 이 과정이 참 힘들었는데, 나와 가치관이 비슷한 Devin 멘토님의 조언이 큰 울림을 주었다.
"저는 단어 변태예요. 생각이 잘 안 날 때는 개념을 최대한 추상적으로 파고들어 정의해 보세요."
이 한 문장이 나에게는 유레카였다. 기능을 구현하기 전에, 우리가 다루는 데이터의 '본질'이 무엇인지 단어부터 정의해 보았다.
1. 판매(Sale)란 무엇인가?
- 개발적 정의: 특정 Price를 대가로 Product의 소유권을 이전하는 트랜잭션.
- 비유를 통한 직관적 설명: 단순히 돈을 받는 게 끝이 아니다. 고객이 만족해야 하고, 만족하지 못하면 환불이라는 역프로세스가 발생한다. 즉, 판매는 '거래(Transaction)'다. 양측이 가치를 교환하고 합의하는 과정인 셈이다.
2. 주문(Order)이란 무엇인가?
- 개발적 정의: 고객의 구매 의사를 시스템에 기록하고, 재고 확보 및 결제 프로세스를 트리거하는 상태 기반의 데이터 집합.
- 비유를 통한 직관적 설명: 주문은 소비자가 하는 것이고 생산자는 이를 받아야 한다. 결국 거래가 이루어지기 위한 서로의 약속 사항이다. 즉, 주문은 '계약(Contract)'이다.
이 관점을 장착하니 33개의 질문이 무지성(?)으로 쏟아져 나왔다. 질문 하나가 만들어지는 과정을 살펴보자.
예시: Q4 — 재고를 상품에 둘까, 분리할까?
요구사항에는 "상품을 등록할 때 초기 재고를 함께 입력한다"고만 적혀 있었다. 재고를 Product 테이블의 컬럼 하나로 둘 수도 있고, 별도 Stock 테이블로 분리할 수도 있다. 어떻게 해야 할까?
이걸 질문으로 만들고, 선택지를 나열하고, 각각의 장단점을 적고, 결정하고, 감수하는 비용까지 기록했다. 이 과정은 뒤에서 자세히 다룬다.
이 방식의 장점은 세 가지다.
- 결정의 이유가 기록으로 남는다. 나중에 "왜 이렇게 했지?" 할 때 Q&A 페이지만 보면 된다.
- 코드 리뷰나 누군가의 "왜요?"라는 질문에 대한 답이 이미 준비되어 있다. "Q4 참고해주세요"라고 하면 끝이다.
- 설계가 감이 아니라 논리가 된다. 장단점을 적다 보면 "그냥 느낌"이 아니라 근거 있는 결정이 된다.
33개 Q&A의 도메인별 분포는 이랬다.
| 도메인 | 질문 수 | 예시 |
|---|---|---|
| Brand | 4 | Q1: Soft Delete 연쇄, Q17: 브랜드명 중복 처리 |
| Product + Stock | 7 | Q4: Stock 분리, Q6: 재고 표시 방식, Q8: likeCount 비정규화 |
| Like | 4 | Q7: 멱등성, Q28: 음수 방지 |
| Order | 7 | Q9: 스냅샷, Q19: All or Nothing, Q20: 삭제 상품 처리 |
| 공통 | 5 | Q13: 인증 방식, Q15: 페이지네이션, Q32: 에러 처리 |
| 합계 | 33 |
이 33개를 다 정리하고 나니, 설계 문서의 뼈대가 거의 완성되어 있었다.
트레이드오프 — 고민 세 가지
33개 중 특히 고민이 깊었던 3가지를 적어보려고 한다
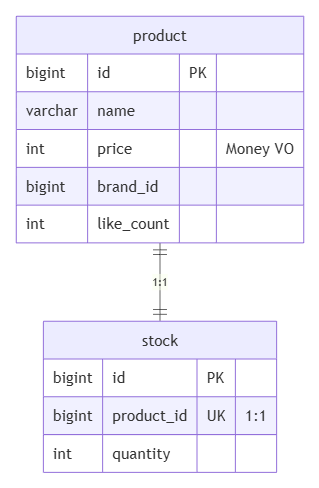
사례 1: 재고를 상품에 둘 것인가, 분리할 것인가
문제:
재고는 상품의 속성인가, 별도 도메인인가?
Product 테이블에 stock 컬럼 하나 추가하면 간단하다.
그런데 가만히 생각해보니 질문이 하나 떠올랐다 — "누가, 왜 이 데이터를 바꾸는가?"
상품 정보(이름, 설명, 가격)는 어드민이 수정한다.
재고는 주문 시스템이 차감한다.
변경 주체와 변경 이유가 다르다.
| 기준 | A: Product에 stock 필드 | B: 별도 Stock 엔티티 |
|---|---|---|
| 구현 난이도 | 낮음 — 컬럼 하나 추가 | 보통 — 테이블, 엔티티, 서비스 추가 |
| 변경 이유 분리 | 상품 수정과 재고 차감이 한 테이블 | 각자의 테이블에서 각자의 이유로 변경 |
| 동시성 대비 | 어려움 — 상품 수정과 재고 차감이 같은 row를 잠금 | 유리 — 재고 차감이 Stock row만 잠금 |
| 확장성 | 낮음 — 옵션별 재고 등 확장 어려움 | 높음 — Stock 엔티티 독립 확장 가능 |
결정: B. 분리한다.
SRP 관점에서 변경 이유가 다르면 분리하는 게 맞다. 건물에 비유하면, 상품 정보는 건물의 간판이고 재고는 건물의 창고다. 간판을 바꾸는 사람과 창고를 관리하는 사람이 다르면, 같은 방에 두지 않는 게 자연스럽지 않을까 라는 생각이 들었다.
이전 포스팅에서도 말했다시피 은탄환은 없다. 그럼 감수해야 하는 사항은 무엇일까?
감수하는 비용:
테이블이 하나 늘고, 상품 등록 시 Stock도 함께 생성해야 한다. 조회 시 조인이 필요하다. 하지만 이 비용은 구조적 이점에 비하면 감당할 수 있는 수준이라고 판단했다.
사례 2: 좋아요 수 집계 — 정확성 vs 성능
문제:
상품 목록을 sort=likes_desc로 정렬하려면 좋아요 수를 알아야 한다. 어떻게?
가장 정직한 방법은 매번 COUNT 쿼리를 날리는 것이다. 하지만 상품 목록 조회 시마다 모든 상품의 좋아요를 세는 건 부담이 크다.
| 기준 | A: 매번 COUNT 쿼리 | B: Product에 likeCount 비정규화 |
|---|---|---|
| 정확성 | 항상 정확 | 동기화가 깨질 가능성 있음 |
| 조회 성능 | 느림 — 상품마다 서브쿼리 | 빠름 — 이미 저장된 값 |
| 정렬 편의성 | 복잡 — 서브쿼리 기반 ORDER BY | 단순 — ORDER BY like_count DESC |
| 쓰기 복잡도 | 없음 | 있음 — 좋아요 추가/취소 시 같이 업데이트 |
결정: B. 비정규화한다.
좋아요 수는 "대략 맞으면 되는" 데이터다. 은행 잔고처럼 1원까지 정확해야 하는 게 아니다. 상품 목록에서 "이 상품이 인기 있구나" 정도의 정보를 전달하면 충분하다.
그런데 연쇄 질문이 생겼다.
비정규화를 하면 likeCount가 음수가 될 수 있다. 좋아요 추가 없이 취소 요청이 들어오면? 동시 요청으로 타이밍이 꼬이면?
이건 Claude Code와 씨름을 벌인 결과 두 겹으로 막기로 했다.
- 애플리케이션 레벨:
decrementLikeCount()메서드에서 현재 값이 0이면 감소하지 않는 가드 - DB 레벨:
like_count컬럼에CHECK (like_count >= 0)제약조건
비정규화를 선택하면 이런 추가 책임이 따라온다. 역시 은탄환은 없다... 하지만 조회 성능이라는 대가로 충분히 합리적인 트레이드오프라고 판단했다.
사례 3: 주문 시 삭제된 상품 — 백엔드의 역할 경계란?
문제:
만약, 고객이 장바구니에 3개 상품을 담고 주문했는데, 그 사이에 1개가 삭제됐다.
이러면 어떻게 해야 할까?
처음에 내가 떠올린 시나리오는 이랬다.
"삭제된 상품을 빼고 나머지 2개만 주문하시겠습니까?"라는 확인을 보여주면 되지 않을까?
보통 제가 회사에서는 풀스택을 하다보니 이렇게 유도하는 식으로 해왔습니다 ㅋㅋ...
그런데 곰곰이 생각해보니 이건 백엔드 API가 할 수 있는 일이 아니었다.
HTTP API는 요청-응답 모델이다. 요청을 받으면 처리하고 결과를 돌려줄 뿐, 중간에 "이거 어떻게 할까요?"라고 사용자에게 물어볼 수 없다. 그건 프론트엔드의 역할이다.
| 기준 | A: 삭제된 상품 빼고 부분 성공 | B: 전체 실패 + 상세 에러 |
|---|---|---|
| 사용자 경험 | 편리해 보이지만 의도치 않은 주문 위험 | 한 번 더 확인 필요하지만 안전 |
| 구현 복잡도 | 높음 — 부분 처리 로직, 금액 재계산 | 낮음 — 검증 실패 시 롤백 |
| 역할 경계 | 모호 — 백엔드가 UX 판단 | 명확 — 백엔드는 검증, 프론트는 UX |
| 데이터 정합성 | 위험 — 고객이 의도하지 않은 조합 가능 | 안전 — 고객이 명시적으로 재주문 |
결정: B. All or Nothing.
삭제된 상품이 포함되어 있으면 주문 전체를 실패시키고, 어떤 상품이 문제인지 에러 메시지로 알려준다. 프론트엔드는 이 에러를 받아서 "이 상품이 삭제되었습니다. 빼고 다시 주문하시겠습니까?"라는 UI를 보여주면 된다고 생각했다.
이 결정을 함에 있어 대부분의 대형 이커머스 업계에서는 All or Nothing 전략을 취한다고 한다. 이 질문을 통해 얻은 교훈은 이거다 — API의 역할 경계를 명확히 하는 것 자체가 설계다. 백엔드는 "이 요청이 유효한가?"를 판단하고, 유효하지 않으면 왜 유효하지 않은지를 충분히 설명한다. 그 이상의 UX 판단은 프론트엔드에 맡긴다.
깎고 또 깎았자
Q&A 브레인스토밍과 병행해서 설계 문서도 만들어나갔다. 그런데 이 문서들도 처음부터 완성된 게 아니었다. 피드백을 받으며 계속 다듬었다.
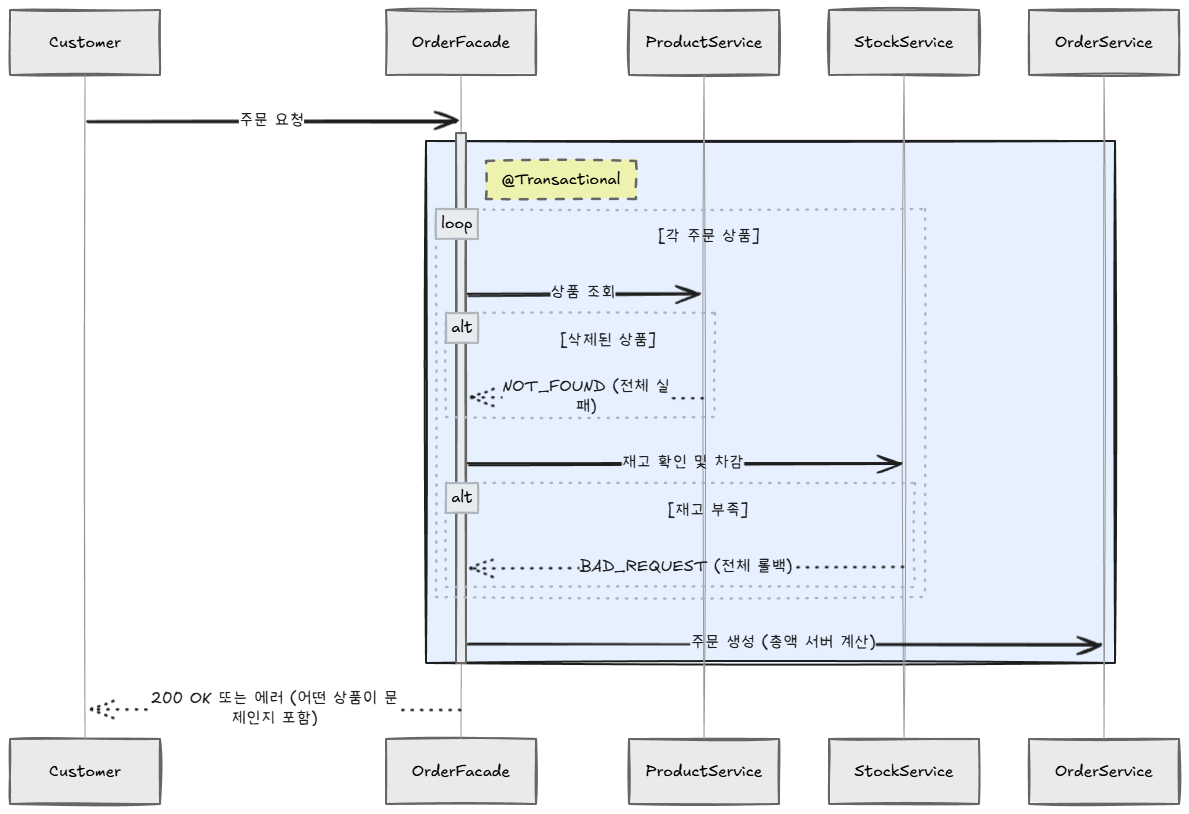
시퀀스 다이어그램: 처음에는 Repository 레벨까지 그렸다. Controller → Facade → Service → Repository, 모든 호출을 빠짐없이.
Claude Code의 피드백은 명확했다.
"설계 다이어그램은 who asks whom to do what이지, 구현 명세서가 아니다."
Facade-Service 레벨로 축소했다. Repository는 구현할 때 알아서 정하면 된다.
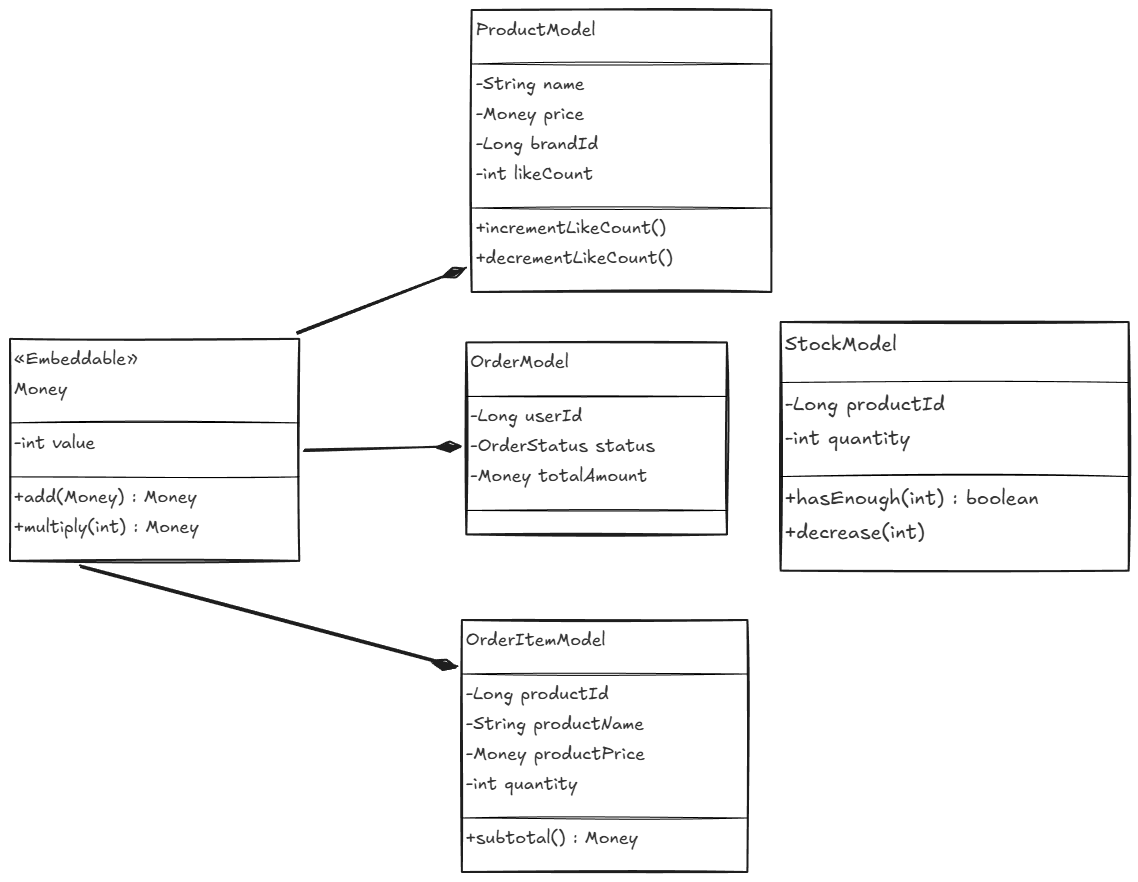
클래스 다이어그램: 어디까지 얼마나 작성해야하지? 에러처리는 어디까지나 상세하게 작성해야 해?
시퀀스 다이어그램은 구체적일 필요가 없다. 행위 관점에서 놓치면 안되는 것들을 기술하는 것이다.
위 피드백을 받고 클래스 다이어그램이 굉장히 단순해질 수 있었다. 결국 최종으로 남긴 것은 도메인 모델의 핵심 필드와 행위 메서드(hasEnough(), decrease(), subtotal())뿐이다.
ERD: DDL과 제약조건까지 상세하게 그렸다가, 멘토링 후 FK 제약조건을 제거하는 쪽으로 축소했다. 애플리케이션 레벨에서 참조 무결성을 관리하고, DB에서는 ID 참조만 유지하는 방식이다.
이 과정에서 깨달은 건 이거다 — 개발 전 설계 문서의 디테일 수준은 "의사결정을 전달할 수 있는 최소한"이면 충분하다. 그 이상은 구현 시점에 코드로 표현하면 된다.
회고 — 33개의 질문이 남긴 것
33개 Q&A를 끝내고 코딩을 시작했을 때, 신기하게도 코딩이 무섭지 않았다.
- 테이블 구조가 확정되어 있으니 엔티티 설계가 명확했다.
Product와Stock이 왜 분리되어 있는지 고민할 필요가 없었다. - API 스펙이 정해져 있으니 컨트롤러 구현이 기계적이었다. 21개 엔드포인트의 요청/응답 구조가 이미 결정되어 있었다.
- 비즈니스 규칙이 문서화되어 있으니 테스트 케이스가 자동으로 나왔다. "좋아요는 멱등성을 보장한다" → 같은 상품에 두 번 좋아요 해도 한 번만 반영되는 테스트.
물론 과했던 부분도 있다. 하지만 과하게 만들어봤기 때문에 "어디까지가 적정선인지"를 체감할 수 있었으니, 완전한 낭비는 아니었다고 생각한다.
이번에 가장 많이 한 일은 코딩이 아니라 질문하기였다. "재고를 어디에 둘까?", "좋아요 수를 어떻게 셀까?", "삭제된 상품을 어떻게 처리할까?" — 이런 질문에 답을 만들어두니, 코드는 답을 옮겨 적는 일에 가까웠다.
코드를 치기 전에 질문을 던져라. 답은 코드보다 먼저 나와야 한다.
설계를 해보니 마지막으로 드는 생각은 "좋은 설계란" 어디까지 확장가능하게 둘지에 대한 판단이 어려운 거 같다. 변하지 않는 부분과 변하는 부분을 잘 판단하는게 결국 개발자의 역할이 아닐까 싶다.
또 찾아보니 이러한 생각 회로가 익숙해지다 보면 코드를 짬과 동시에 설계를 해나가는 경지에까지 도달하는 거 같다.