java Hello 한 줄을 치면 그 안에서 무슨 일이 일어나는지 궁금해서, 바이트코드와 클래스 로더, 런타임 데이터 영역, 인터프리터와 JIT 컴파일러까지 javap로 직접 뜯어 보며 정리했습니다.
들어가며
"자바는 어떻게 윈도우에서도, 리눅스에서도, 맥에서도 같은 파일로 돌아갈까?"
자바를 처음 배울 때 "한 번 작성하면 어디서나 실행된다"는 말을 들었는데, 그게 정확히 어떻게 가능한지는 그냥 넘어갔습니다. 컴파일을 하는데 왜 운영체제마다 다시 빌드하지 않아도 되는지, java 명령은 정확히 무엇을 실행하는지 막상 설명하려니 막혔습니다.
그래서 아주 작은 Hello.java 하나를 두고, 컴파일된 파일을 열어 보고 실행 로그를 켜 가며 한 단계씩 따라가 봤습니다. 이 글은 그 기록입니다.
한눈에 보기
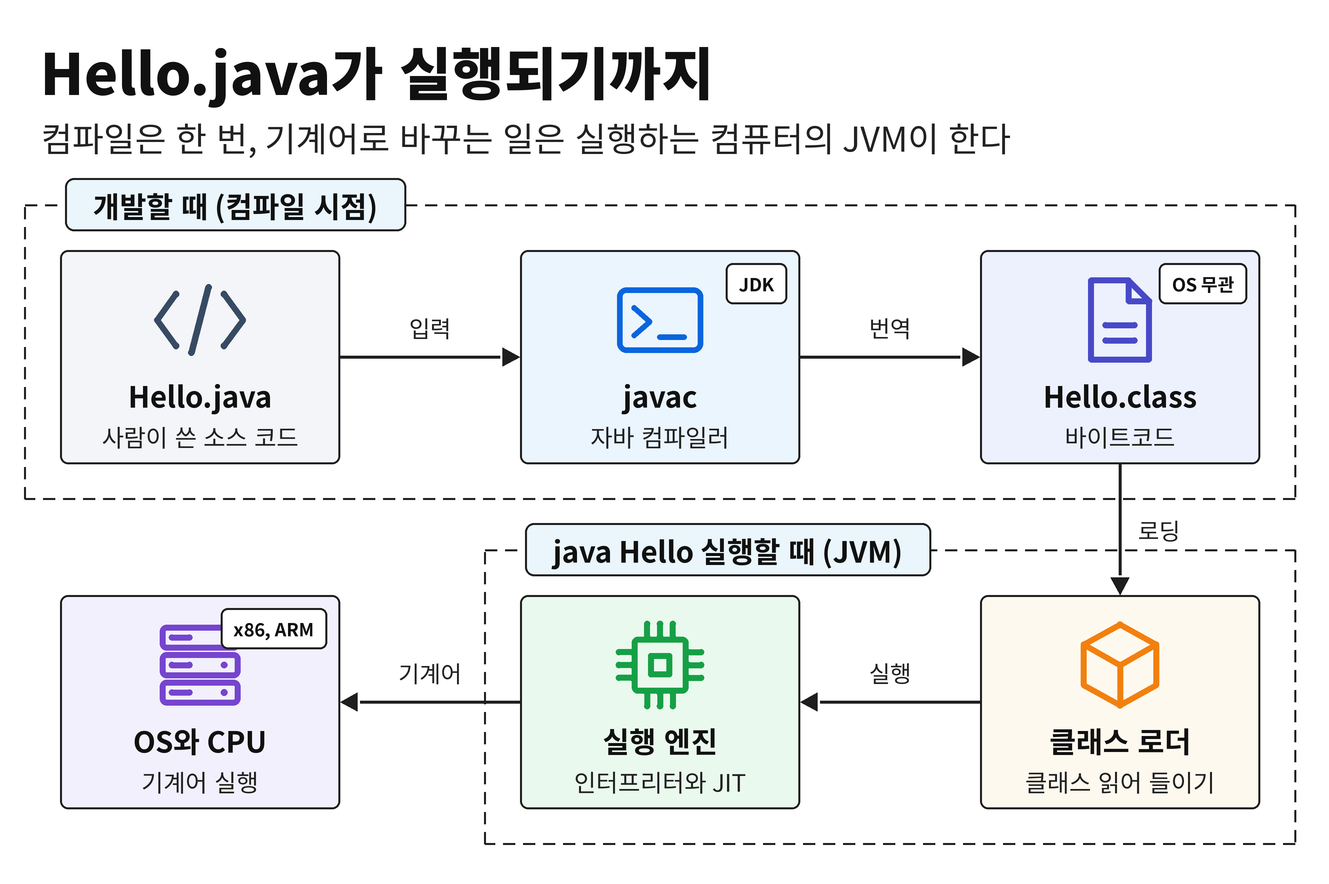
자바 코드는 두 번에 걸쳐 번역됩니다. 개발할 때 javac가 소스 코드를 바이트코드(Bytecode)로 한 번 바꾸고, 실행할 때 JVM(Java Virtual Machine, 자바 가상 머신)이 그 바이트코드를 지금 컴퓨터의 기계어로 다시 바꿉니다.
| 단계 | 누가 | 무엇을 | 결과 |
|---|---|---|---|
| 컴파일 | javac | 소스 코드를 바이트코드로 번역 | Hello.class |
| 로딩 | 클래스 로더 | .class를 찾아 JVM 메모리에 올림 | 클래스 정보 |
| 실행 | 실행 엔진 | 바이트코드를 해석하거나 기계어로 컴파일 | 실제 동작 |
| 정리 | 가비지 컬렉터 | 안 쓰는 객체를 힙에서 치움 | 메모리 회수 |
핵심은 .class 파일이 특정 OS(Operating System)나 CPU(Central Processing Unit)를 위한 기계어가 아니라는 점입니다. 기계어로 바꾸는 마지막 일은 각 컴퓨터에 설치된 JVM이 맡습니다. 그래서 같은 .class가 어디서든 돌아가고, 대신 JVM은 운영체제마다 따로 만들어져 있습니다. 알고 나니 "어디서나 실행된다"는 말의 주어가 자바 코드가 아니라 JVM이었다는 게 납득이 됐습니다.
1단계: javac가 만드는 바이트코드
예제로 쓴 코드는 이것입니다.
public class Hello {
    public static void main(String[] args) {
        int a = 3;
        int b = 4;
        int sum = add(a, b);
        System.out.println(sum);
    }

    static int add(int x, int y) {
        return x + y;
    }
}
javac Hello.java로 컴파일한 뒤 javap -c Hello로 .class 안을 열어 보면 바이트코드가 사람이 읽을 수 있는 형태로 나옵니다(JDK(Java Development Kit) 21에서 확인했습니다).
static int add(int, int);
  Code:
     0: iload_0
     1: iload_1
     2: iadd
     3: ireturn
add 메서드의 네 줄을 하나씩 보면 이렇습니다.
0: iload_0: 0번 지역 변수(x)의 int 값을 꺼내 피연산자 스택에 올립니다. 앞의 숫자0은 명령이 놓인 바이트 위치입니다.1: iload_1: 1번 지역 변수(y)를 스택에 올립니다.2: iadd: 스택 맨 위 두 값을 꺼내 더하고, 결과를 다시 스택에 올립니다.3: ireturn: 스택 맨 위 int 값을 돌려주며 메서드를 끝냅니다.
main 쪽은 iconst_3, istore_1(3을 1번 칸에 저장), invokestatic #7(add 호출), getstatic(System.out 가져오기), invokevirtual(println 호출) 같은 명령으로 이어집니다.
잠깐, 바이트코드가 뭐예요?
바이트코드는 JVM이라는 가상의 컴퓨터를 위한 기계어입니다. 명령 하나가 1바이트 코드(opcode)로 표현돼서 이런 이름이 붙었습니다. 실제 CPU는 이 명령을 모르기 때문에, 중간에 JVM이 통역을 해 줘야 합니다.
위에서 본 것처럼 바이트코드는 "값을 스택에 올리고, 꺼내서 계산하고, 다시 올리는" 방식으로 동작합니다. 그래서 JVM을 스택 기반 가상 머신이라고 부릅니다. 처음엔 여기서 말하는 스택이 메모리 영역의 스택과 같은 건 줄 알았는데, 이건 메서드 실행 하나하나가 갖는 작은 계산용 스택(피연산자 스택)이었습니다. 이 스택은 3단계의 스택 프레임 안에 들어 있습니다.
비유하자면 자바 소스는 한국어 원고, 바이트코드는 세계 공용으로 정해 둔 중간 언어, JVM은 나라마다 상주하는 통역사입니다. 원고를 중간 언어로 한 번만 옮겨 두면, 어느 나라에 가든 그곳 통역사가 현지 말로 읽어 줍니다.
JVM을 이루는 다섯 부분
java Hello를 실행하면 JVM 프로세스가 하나 뜨고, 그 안에서 아래 부분들이 함께 일합니다.
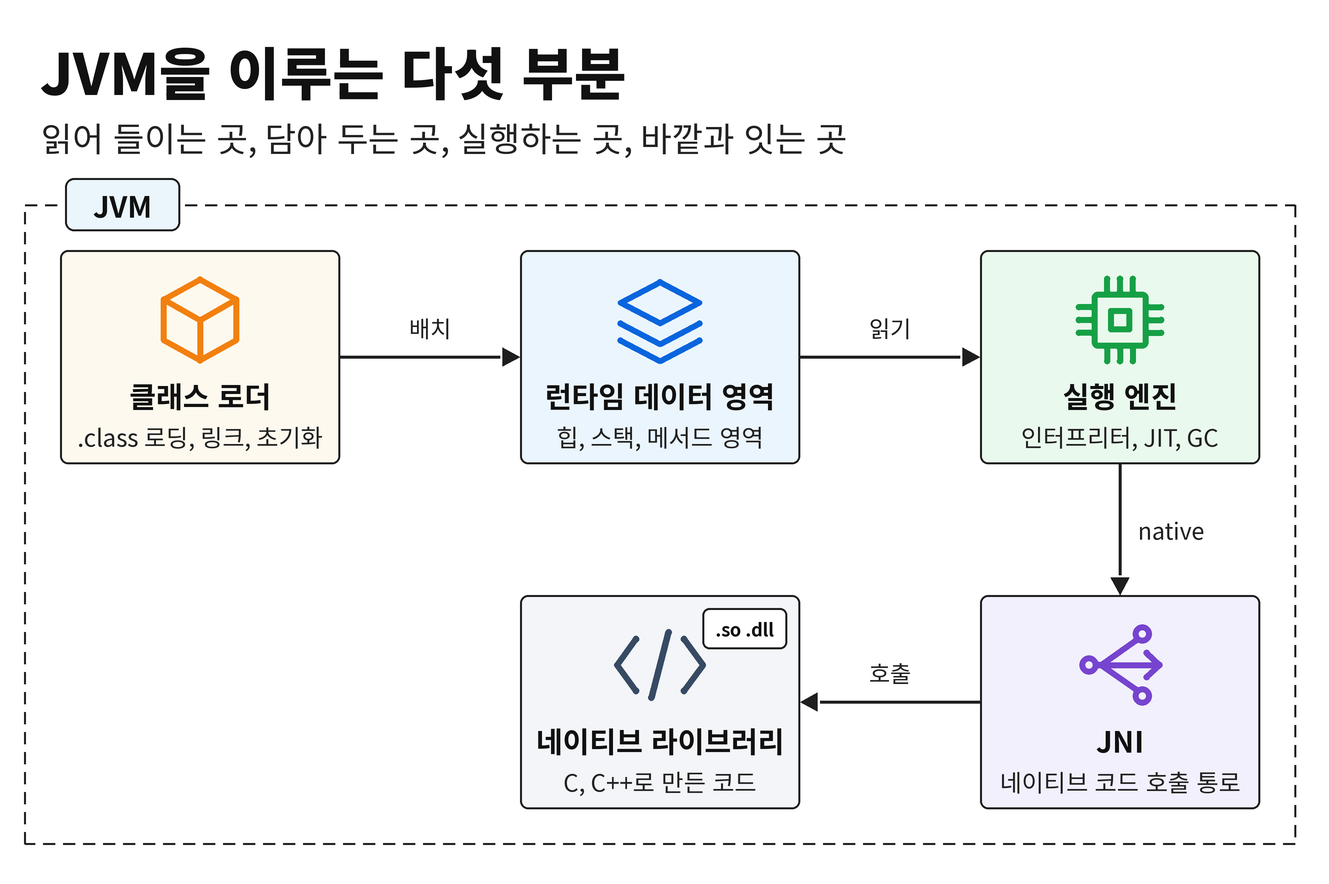
- 클래스 로더(Class Loader):
.class파일을 찾아 읽고, 검사하고, 쓸 수 있게 준비합니다. - 런타임 데이터 영역(Runtime Data Area): 프로그램이 도는 동안 쓰는 메모리입니다. 힙, 스택, 메서드 영역 등으로 나뉩니다.
- 실행 엔진(Execution Engine): 바이트코드를 실제로 실행합니다. 인터프리터, JIT(Just-In-Time) 컴파일러, 가비지 컬렉터가 여기 속합니다.
- JNI(Java Native Interface): 자바 코드가 C, C++로 만든 함수를 부를 수 있게 이어 주는 통로입니다.
- 네이티브 메서드 라이브러리: JNI로 불리는 C, C++ 라이브러리(
.so,.dll파일)입니다.
이제 실행 순서대로 클래스 로더, 런타임 데이터 영역, 실행 엔진을 하나씩 보겠습니다.
2단계: 클래스 로더가 클래스를 찾는 방법
세 개의 기본 클래스 로더
자바 9 이후 기준으로 JVM에는 기본 클래스 로더가 셋 있습니다.
| 클래스 로더 | 맡는 클래스 | 예 |
|---|---|---|
| 부트스트랩(Bootstrap) | 자바의 가장 핵심 클래스 | java.lang.String, java.lang.Object |
| 플랫폼(Platform) | 나머지 자바 표준 모듈 일부 | java.sql.Connection |
| 애플리케이션(Application, System) | 클래스패스에 있는 내 코드와 라이브러리 | Hello, 스프링 jar |
자바 8까지는 플랫폼 로더 자리에 확장(Extension) 클래스 로더가 있었고, 모듈 시스템이 들어온 자바 9에서 지금 구조로 바뀌었습니다.
직접 찍어 보면 이렇게 나옵니다.
System.out.println(Hello.class.getClassLoader());
System.out.println(java.sql.Connection.class.getClassLoader());
System.out.println(String.class.getClassLoader());
jdk.internal.loader.ClassLoaders$AppClassLoader@...
jdk.internal.loader.ClassLoaders$PlatformClassLoader@...
nullString의 클래스 로더가 null로 나와서 처음엔 오류인 줄 알았습니다 😅 부트스트랩 로더는 자바 객체가 아니라 JVM 안에 C++ 코드로 들어 있어서, 자바 쪽에서는 null로 보이는 것이었습니다.
부모에게 먼저 묻기: 위임 모델
클래스 로더는 클래스를 찾아 달라는 요청을 받으면 자기가 찾기 전에 부모에게 먼저 넘깁니다. 이것을 부모 위임 모델(Parent Delegation Model)이라고 합니다.
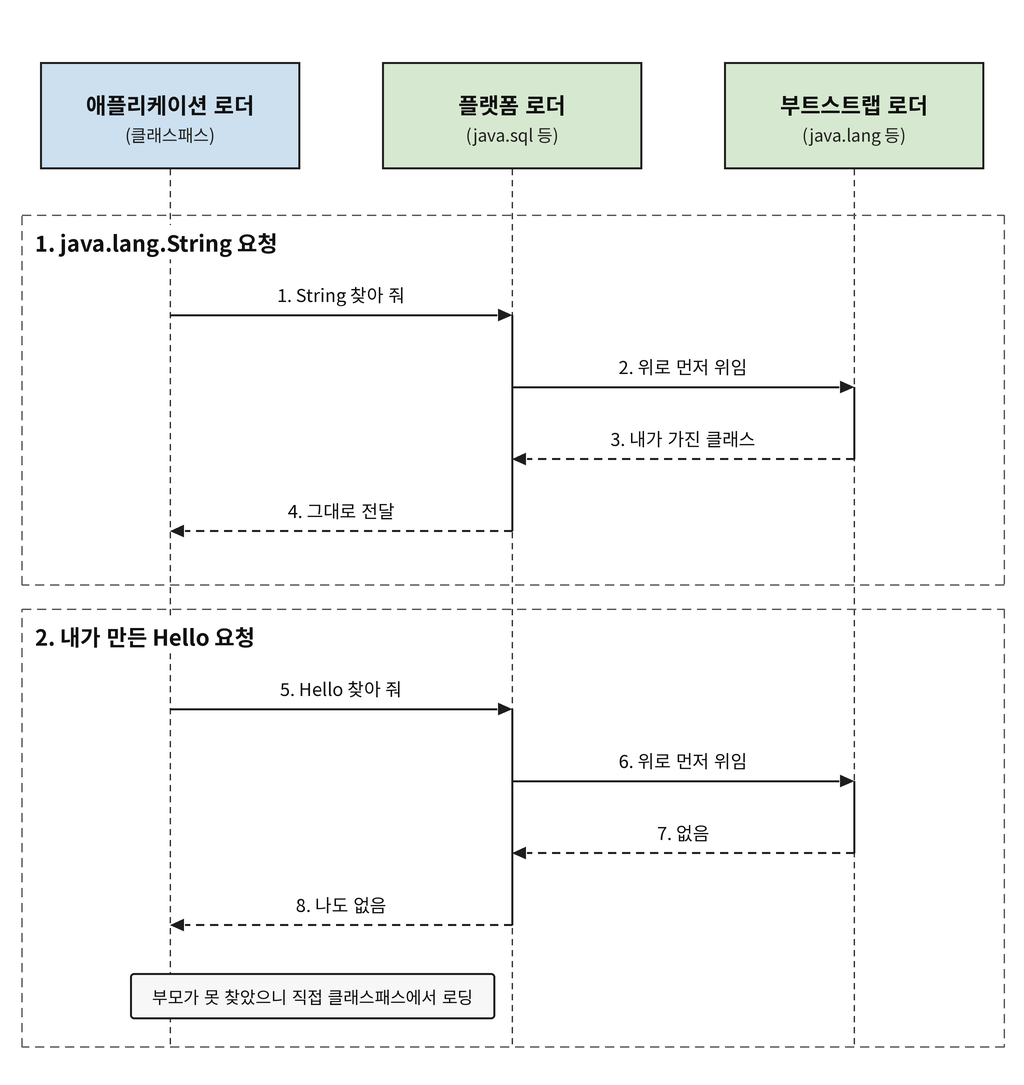
String을 요청하면 애플리케이션 로더는 플랫폼 로더에게, 플랫폼 로더는 부트스트랩 로더에게 먼저 묻습니다. 부트스트랩이 가지고 있으니 그 클래스가 그대로 내려옵니다.Hello를 요청하면 위로 올라가도 아무도 없다고 답합니다. 그제야 애플리케이션 로더가 클래스패스에서 직접 찾습니다.
이렇게 하는 이유는 핵심 클래스가 바꿔치기되지 않게 하기 위해서입니다. 누군가 클래스패스에 java.lang.String이라는 가짜 클래스를 넣어도, 요청은 항상 부트스트랩 로더에게 먼저 가기 때문에 진짜 String이 쓰입니다. 같은 클래스를 여러 로더가 중복으로 올리는 일도 막아 줍니다.
로딩, 링크, 초기화
클래스 로더가 .class를 찾았다고 바로 쓸 수 있는 건 아닙니다. 클래스 하나는 아래 순서를 거칩니다.
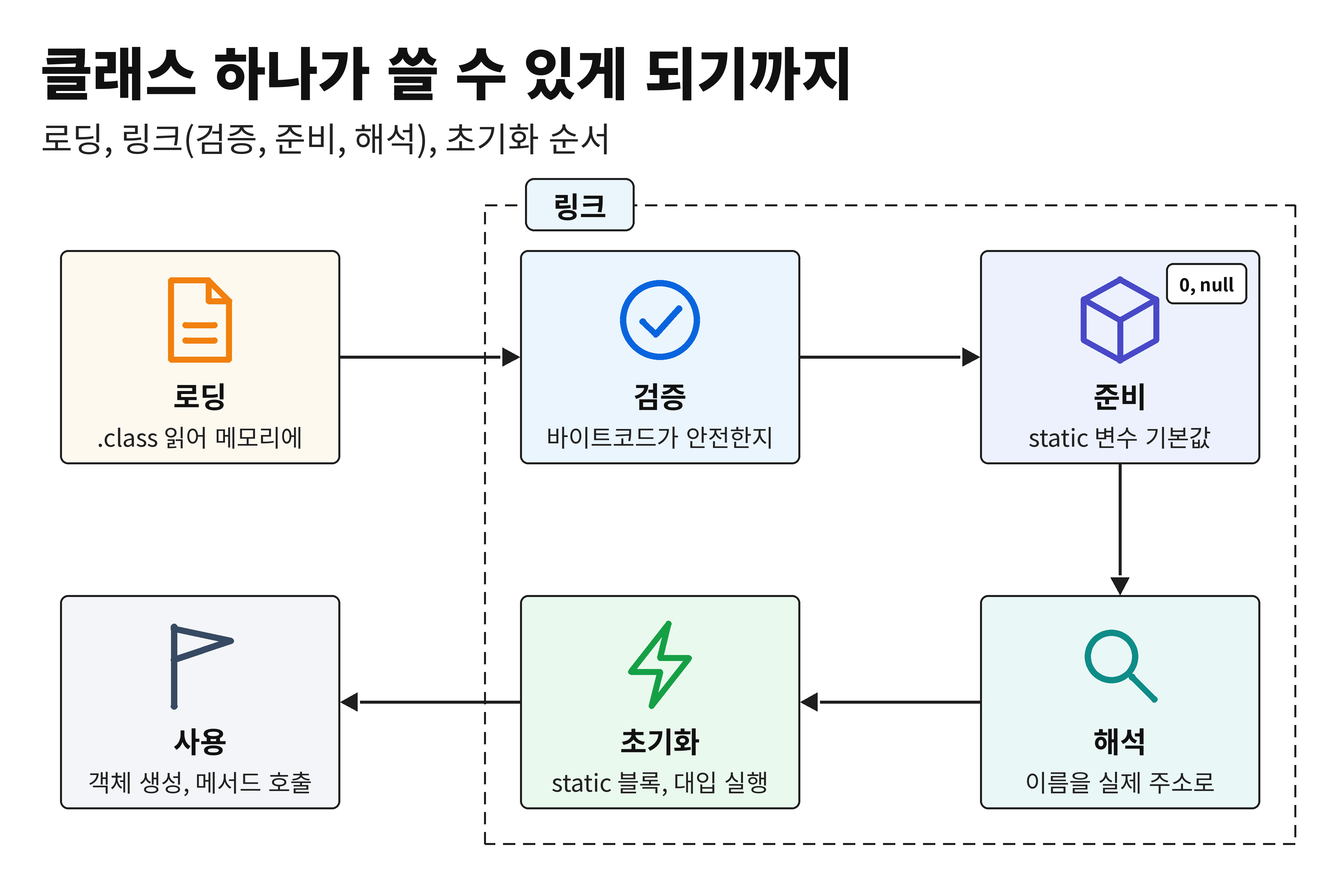
- 로딩(Loading):
.class파일의 바이트를 읽어 메서드 영역에 클래스 정보를 만들고, 힙에 그 클래스를 나타내는Class객체를 만듭니다. - 검증(Verification): 바이트코드가 규칙을 지키는지 확인합니다. 예를 들어 int 자리에 객체 참조를 넣는 명령이나, 스택에 값이 없는데 꺼내는 명령이 없는지 봅니다. 누가
.class를 직접 고쳐서 넣어도 JVM이 깨지지 않게 하는 안전장치입니다. - 준비(Preparation): static 변수에 메모리를 잡고 기본값(0, false, null)을 넣습니다.
- 해석(Resolution): 바이트코드 안의
#7같은 이름표(심볼 참조)를 실제 메서드나 필드의 위치로 바꿉니다. 구현에 따라 처음 쓰는 순간까지 미뤄서 하기도 합니다. - 초기화(Initialization): static 변수에 코드에 적은 값을 대입하고,
static { }블록을 실행합니다.
잠깐, static 변수는 언제 값이 들어가나요?
static int count = 10;이라고 쓰면 처음부터 10일 것 같지만, 실제로는 두 번에 걸쳐 들어갑니다. 준비 단계에서 먼저 0이 들어가고, 초기화 단계에서 10이 대입됩니다.
그리고 초기화는 그 클래스가 처음 실제로 쓰일 때 일어납니다. new로 객체를 만들거나, static 메서드를 부르거나, static 필드를 읽는 순간입니다. 프로그램이 시작할 때 모든 클래스를 미리 올리는 게 아니라 필요할 때 하나씩 올리는 셈입니다.
이게 정말인지 -Xlog:class+load 옵션으로 로딩 로그를 켜 봤습니다.
[0.017s][info][class,load] java.lang.Object source: shared objects file
[0.017s][info][class,load] java.lang.String source: shared objects file
...
[0.044s][info][class,load] Hello source: file:/.../
Hello 하나 실행하는 데 로그가 450줄 넘게 찍혀서 놀랐습니다. 내 클래스보다 먼저 Object, String, System 같은 핵심 클래스 수백 개가 올라가고, 맨 마지막 즈음에야 Hello가 등장합니다. source: shared objects file은 자주 쓰는 핵심 클래스를 미리 정리해 둔 파일(CDS, Class Data Sharing)에서 빠르게 읽어 왔다는 뜻입니다.
3단계: 런타임 데이터 영역
클래스가 올라가면 프로그램이 도는 동안 쓰는 메모리가 필요합니다. JVM 명세는 이 메모리를 여섯 영역으로 나눕니다. 이 부분이 제일 헷갈렸는데, 스레드마다 따로 있는지, 모두가 함께 쓰는지를 기준으로 나누니 정리가 됐습니다.
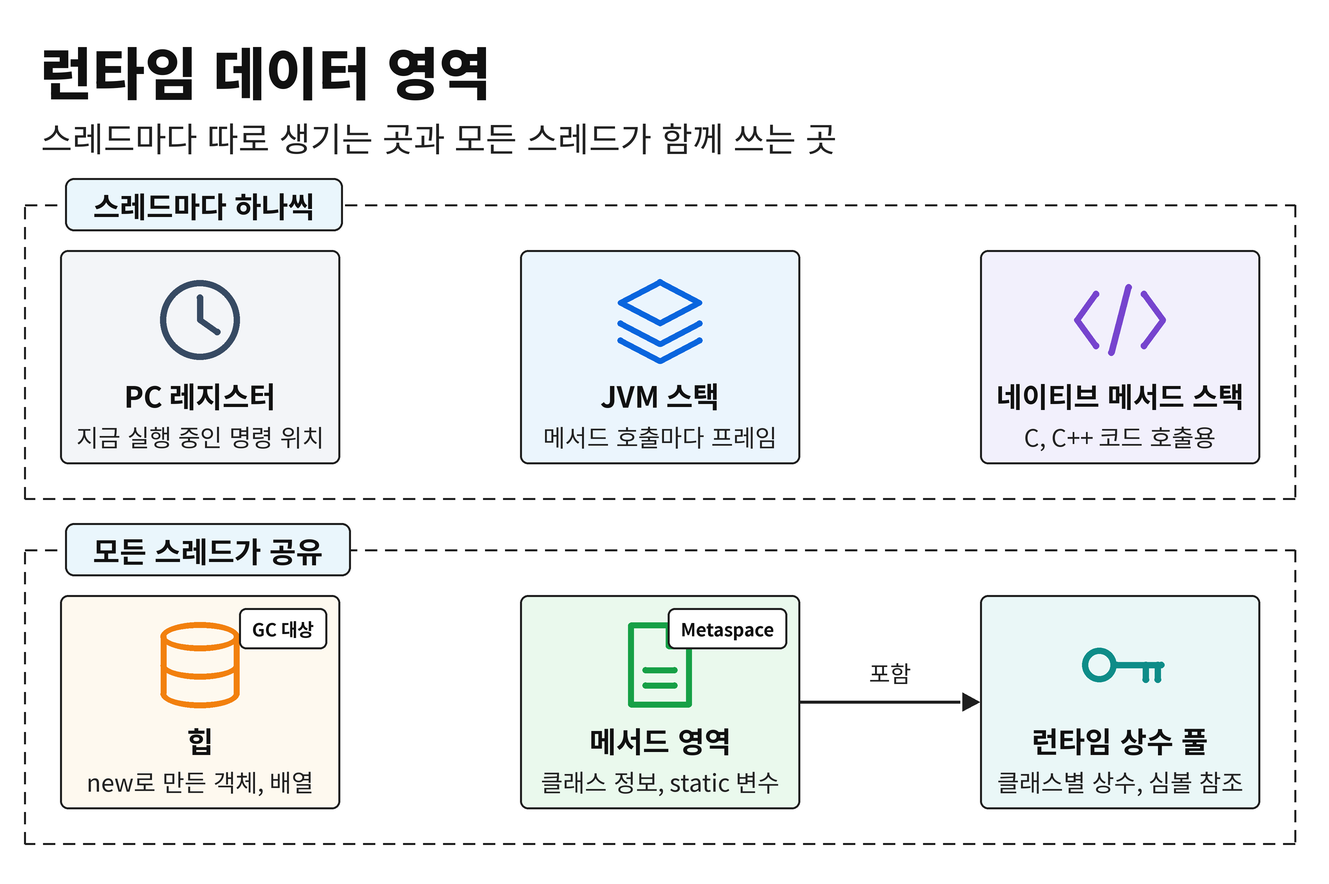
| 영역 | 범위 | 담는 것 | 가득 차면 |
|---|---|---|---|
| PC 레지스터 | 스레드마다 | 지금 실행 중인 바이트코드 위치 | 해당 없음 |
| JVM 스택 | 스레드마다 | 메서드 호출마다 쌓이는 프레임 | StackOverflowError |
| 네이티브 메서드 스택 | 스레드마다 | C, C++ 코드 호출 상태 | StackOverflowError |
| 힙 | 공유 | new로 만든 객체와 배열 | OutOfMemoryError |
| 메서드 영역 | 공유 | 클래스 구조, 메서드 바이트코드 | OutOfMemoryError |
| 런타임 상수 풀 | 공유(클래스별) | 상수, 메서드와 필드의 이름표 | OutOfMemoryError |
- PC(Program Counter) 레지스터: 스레드가 "지금 몇 번째 명령을 하고 있는지" 적어 두는 칸입니다. 앞의
javap출력에서0:,1:,2:같은 위치가 여기 들어갑니다. 스레드끼리 번갈아 실행되다 돌아와도 이 값 덕분에 이어서 실행할 수 있습니다. 네이티브 메서드를 실행할 때는 값이 정해져 있지 않습니다. - JVM 스택: 메서드를 부를 때마다 프레임이 하나 쌓이고, 끝나면 빠집니다. 재귀가 끝없이 돌면 프레임이 계속 쌓이다
StackOverflowError가 납니다. - 힙: 객체가 사는 곳이자 가비지 컬렉터가 청소하는 곳입니다. 스레드가 모두 공유하니 여러 스레드가 같은 객체를 동시에 건드리면 동시성 문제가 생깁니다.
- 메서드 영역: 클래스 이름, 부모 클래스, 필드와 메서드 목록, 메서드 바이트코드 같은 "클래스 설계도"가 들어갑니다. 런타임 상수 풀도 클래스마다 하나씩 여기 붙어 있습니다.
명세가 정한 건 "이런 영역이 있어야 한다"까지이고, 실제로 어디에 어떻게 둘지는 구현마다 다릅니다. 가장 많이 쓰는 HotSpot JVM은 자바 8부터 메서드 영역을 Metaspace라는 네이티브 메모리 공간에 둡니다(그전에는 힙 옆의 PermGen이라는 고정 크기 공간이었습니다). static 변수의 실제 값은 HotSpot에서는 힙의 Class 객체 쪽에 붙어 있다는 점도 이번에 알게 됐습니다.
잠깐, 스택 프레임이 뭐예요?
메서드 하나를 부를 때마다 JVM 스택에 쌓이는 상자 하나가 스택 프레임(Stack Frame)입니다. 상자 안에는 세 가지가 들어 있습니다.
- 지역 변수 배열: 매개변수와 지역 변수 칸입니다. 앞의
iload_0,iload_1이 꺼내던 0번, 1번 칸이 여기입니다. - 피연산자 스택:
iadd같은 계산에 쓰는 작은 스택입니다. - 이 메서드가 속한 클래스의 런타임 상수 풀을 가리키는 정보:
#7같은 이름표를 풀 때 씁니다.
main이 add를 부르면 main 프레임 위에 add 프레임이 쌓이고, add가 ireturn하면 add 프레임이 빠지면서 결과가 main의 피연산자 스택으로 넘어갑니다.
그러면 객체를 만들면 어디에 무엇이 놓일까요? User u = new User("kim"); 한 줄로 그려 보면 이렇습니다.
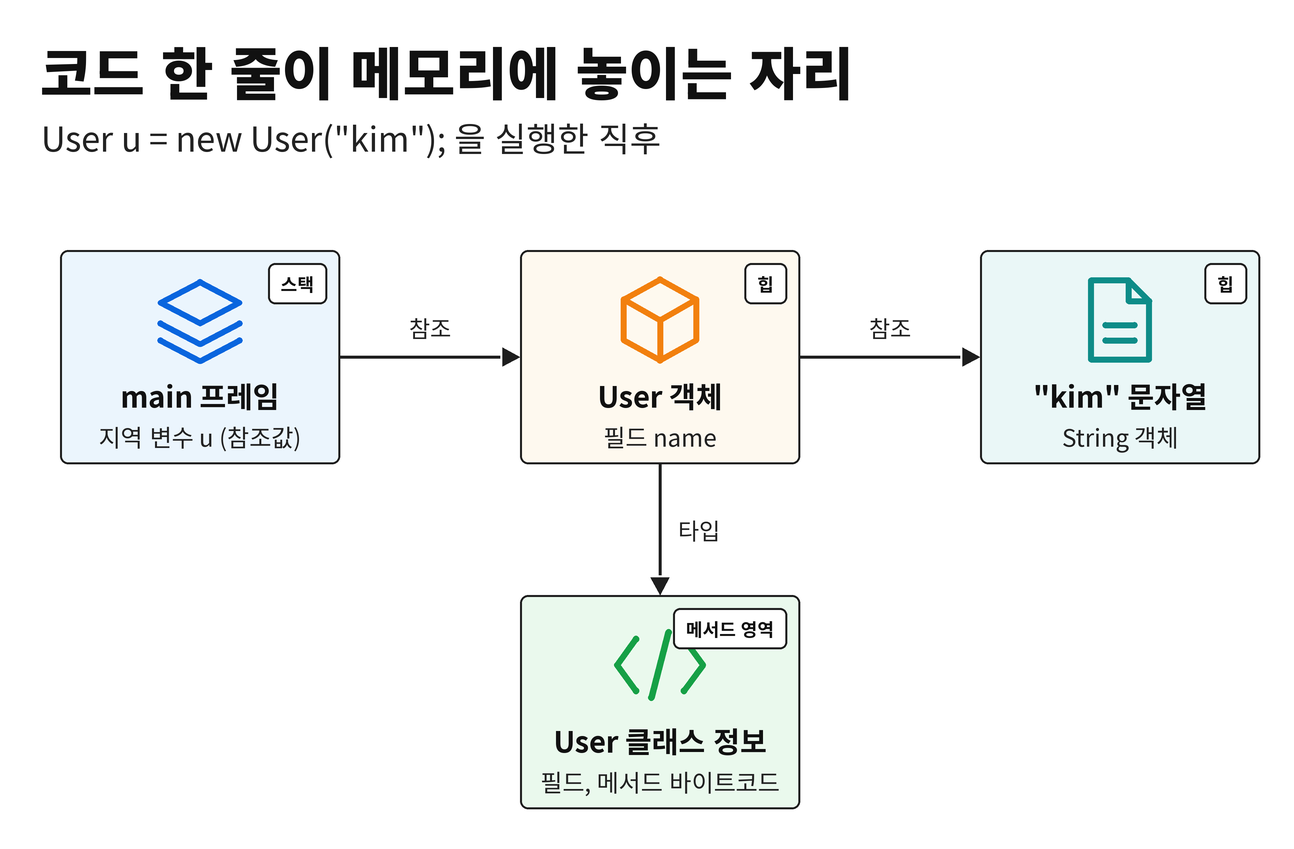
- 스택의
main프레임에는 변수u의 칸이 있고, 거기에는 객체 자체가 아니라 객체를 가리키는 참조값만 들어 있습니다. User객체와"kim"문자열은 힙에 있습니다.User객체는 자기가 어떤 클래스인지 알아야 메서드를 찾을 수 있으니, 메서드 영역의 클래스 정보를 가리킵니다.
비유하면 스택 프레임은 메서드마다 받는 개인 메모지이고, 힙은 모두가 같이 쓰는 큰 창고입니다. 메모지에는 물건 대신 "창고 3번 선반" 같은 위치만 적어 둡니다. 메서드가 끝나 메모지를 버려도 창고 물건은 남아 있고, 아무 메모지에도 위치가 적혀 있지 않은 물건을 가비지 컬렉터가 치웁니다.
4단계: 실행 엔진, 인터프리터와 JIT 컴파일러
처음에는 한 줄씩 해석한다
실행 엔진은 처음에 인터프리터(Interpreter)로 바이트코드를 한 명령씩 읽어 실행합니다. 바로 시작할 수 있다는 장점이 있지만, 같은 코드를 백만 번 돌리면 백만 번 해석해야 해서 느립니다.
자주 쓰는 코드는 기계어로 바꿔 둔다
그래서 JVM은 실행하면서 메서드 호출 횟수와 반복문이 도는 횟수를 셉니다. 많이 불리는 "뜨거운" 코드를 찾으면 JIT 컴파일러가 그 메서드를 통째로 기계어로 컴파일해 두고, 다음부터는 해석 없이 기계어를 바로 실행합니다. 실행 도중(Just-In-Time)에 컴파일한다고 해서 이런 이름이 붙었습니다.
HotSpot에는 성격이 다른 컴파일러가 둘 있고, 단계적으로 씁니다. 이것을 계층형 컴파일(Tiered Compilation)이라고 하며 지금 HotSpot에서는 기본으로 켜져 있습니다.
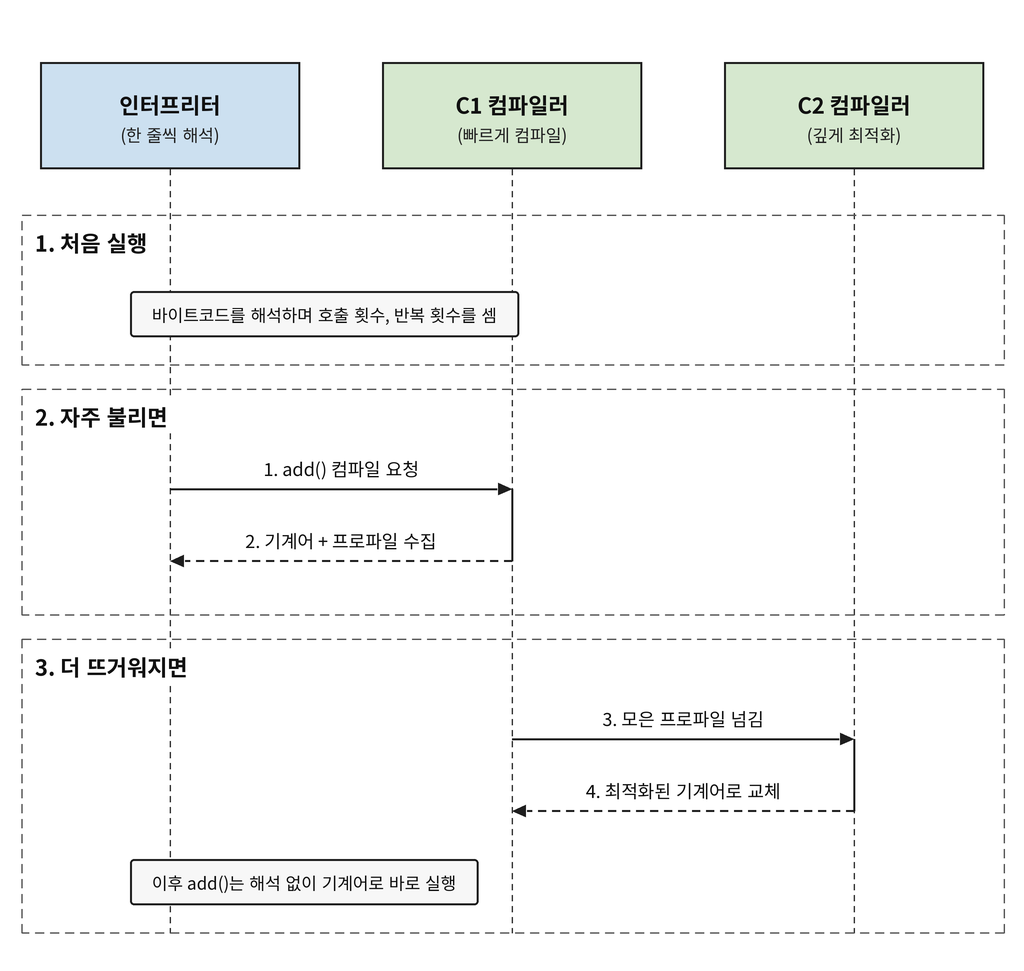
| 단계 | 누가 | 특징 |
|---|---|---|
| 0 | 인터프리터 | 바로 실행, 느림, 호출 횟수를 셈 |
| 1~3 | C1 컴파일러 | 빨리 컴파일, 가벼운 최적화, 3단계는 실행 정보(프로파일)도 모음 |
| 4 | C2 컴파일러 | 컴파일은 오래 걸리지만 모은 프로파일로 깊게 최적화 |
C2는 "이 if는 거의 항상 참이었다", "이 인터페이스 호출은 늘 같은 구현 클래스였다" 같은 실제 실행 정보를 바탕으로 과감하게 최적화합니다. 정적으로 한 번에 컴파일하는 언어는 이런 실행 중 정보를 쓰기 어렵다는 점에서, 오래 도는 서버에서 자바가 생각보다 빠른 이유가 이해됐습니다.
java -version을 치면 끝에 나오는 mixed mode라는 말도 이제야 뜻을 알았습니다. 인터프리터와 JIT 컴파일을 섞어서 실행한다는 뜻이었습니다.
직접 JIT 컴파일을 지켜보기
add를 백만 번 부르는 코드를 -XX:+PrintCompilation 옵션으로 실행해 봤습니다.
long total = 0;
for (int i = 0; i < 1_000_000; i++) {
    total += add(i, 1);
}
38 7 3 Hot::add (4 bytes)
38 8 4 Hot::add (4 bytes)
38 7 3 Hot::add (4 bytes) made not entrant
40 9 % 3 Hot::main @ 4 (33 bytes)
40 11 % 4 Hot::main @ 4 (33 bytes)- 첫 번째 열(
38): 프로그램 시작 후 몇 ms 시점인지입니다. - 두 번째 열(
7,8): 컴파일 작업 번호입니다. %: 메서드가 아직 실행 중인데 반복문 도중에 기계어 버전으로 갈아탄다는 표시입니다(OSR, On-Stack Replacement).main은 한 번만 불리지만 안의 반복문이 오래 돌아서 이렇게 컴파일됐습니다.- 그다음 숫자(
3,4): 위 표의 컴파일 단계입니다.add가 3단계(C1)로 컴파일되자마자 4단계(C2)로 다시 컴파일됐습니다. (4 bytes): 바이트코드 크기입니다. 앞에서 본add의 명령 네 개가 딱 4바이트였습니다.made not entrant: 더 좋은 버전이 생겨서, 옛 버전(3단계)으로는 새 호출이 들어가지 않게 막았다는 뜻입니다.
참고로 실행 엔진에는 가비지 컬렉터도 있지만, 동작 방식이 꽤 길어서 다음 글에서 따로 다루려고 합니다.
직접 확인해 보기
이번에 쓴 명령을 모아 두면 이렇습니다.
| 명령 | 알 수 있는 것 |
|---|---|
javac Hello.java | 바이트코드 파일 Hello.class 생성 |
javap -c Hello | .class 안의 바이트코드 명령 |
java -Xlog:class+load Hello | 어떤 클래스가 어떤 순서로 로딩되는지 |
java -XX:+PrintCompilation Hello | 어떤 메서드가 언제 몇 단계로 JIT 컴파일되는지 |
java Hello.java | 자바 11부터 컴파일 없이 소스 파일 하나를 바로 실행 |
마지막 java Hello.java는 javac 과정이 사라진 것처럼 보이지만, 실제로는 메모리 안에서 컴파일한 뒤 실행하는 방식이었습니다. 클래스 로더를 찍어 보니 MemoryClassLoader라는 별도 로더가 나와서 확인할 수 있었습니다.
백엔드 개발자 입장에서 보면
- 배포 직후에 응답이 느린 이유가 됩니다. 서버가 막 떴을 때는 아직 인터프리터로 돌고 JIT 컴파일 전이라, 첫 요청들이 눈에 띄게 느릴 수 있습니다. 트래픽을 받기 전에 주요 경로를 미리 호출해 두는 웜업(Warm-up)을 하는 이유입니다.
- 에러 이름으로 어느 영역이 문제인지 짐작할 수 있습니다.
StackOverflowError는 깊은 재귀나 서로를 끝없이 부르는 코드,OutOfMemoryError: Java heap space는 힙에 객체가 너무 많이 쌓인 경우,OutOfMemoryError: Metaspace는 클래스가 계속 새로 로딩되는 경우를 먼저 의심합니다. - 클래스 로딩 에러는 두 가지를 구분합니다.
ClassNotFoundException은 이름으로 클래스를 직접 찾으려 했는데(Class.forName등) 없을 때,NoClassDefFoundError는 컴파일할 때는 있었는데 실행할 때 클래스를 쓸 수 없을 때 납니다. 보통 의존성 jar 버전이 맞지 않거나 빠졌을 때 만납니다. - JVM 메모리는 힙만이 아닙니다.
-Xmx로 정하는 건 힙 크기뿐이고, Metaspace, 스레드마다의 스택, JIT이 만든 기계어 저장 공간도 따로 씁니다. 컨테이너 메모리 제한을 정할 때 힙 크기만 보고 맞추면 생각보다 빨리 한도에 걸릴 수 있습니다.
스스로 점검해 보기
- Q. 자바 프로그램은 어떤 과정을 거쳐 실행되나요?
javac가 소스 코드를 바이트코드(.class)로 컴파일합니다. 실행하면 JVM의 클래스 로더가 필요한 클래스를 로딩, 링크, 초기화하고, 실행 엔진이 바이트코드를 인터프리터로 해석하거나 JIT 컴파일러로 기계어로 바꿔 실행합니다. 그동안 객체는 힙에, 메서드 호출 정보는 스택에 놓입니다.
- Q. 자바가 운영체제에 상관없이 실행될 수 있는 이유는 무엇인가요?
- 컴파일 결과가 특정 CPU의 기계어가 아니라 JVM용 바이트코드이기 때문입니다. 바이트코드를 실제 기계어로 바꾸는 일은 각 OS에 맞게 만들어진 JVM이 맡으므로, 같은
.class파일을 어느 환경에서든 실행할 수 있습니다.
- 컴파일 결과가 특정 CPU의 기계어가 아니라 JVM용 바이트코드이기 때문입니다. 바이트코드를 실제 기계어로 바꾸는 일은 각 OS에 맞게 만들어진 JVM이 맡으므로, 같은
- Q. 클래스 로더의 부모 위임 모델은 무엇이고 왜 쓰나요?
- 클래스 로딩 요청을 받으면 자기가 찾기 전에 부모 로더에게 먼저 넘기고, 부모가 못 찾을 때만 직접 찾는 방식입니다. 핵심 클래스를 항상 부트스트랩 로더가 올리게 해서 가짜 클래스로 바꿔치기되는 것을 막고, 같은 클래스가 중복으로 로딩되는 것도 막습니다.
- Q. 런타임 데이터 영역 중 스레드끼리 공유하는 곳과 아닌 곳은 어디인가요?
- PC 레지스터, JVM 스택, 네이티브 메서드 스택은 스레드마다 따로 생깁니다. 힙과 메서드 영역(런타임 상수 풀 포함)은 모든 스레드가 공유하기 때문에, 여러 스레드가 같은 객체를 다룰 때 동기화를 신경 써야 합니다.
- Q. 인터프리터가 있는데 JIT 컴파일러가 왜 필요한가요?
- 인터프리터는 바로 실행할 수 있지만 같은 코드를 실행할 때마다 다시 해석해서 느립니다. JIT 컴파일러는 자주 실행되는 코드를 찾아 기계어로 컴파일해 두고, 실행 중에 모은 정보로 최적화까지 하기 때문에 오래 도는 프로그램의 성능을 크게 높입니다.
정리
- 자바는
javac가 바이트코드로 한 번, JVM이 기계어로 한 번 번역하기 때문에 같은.class가 어느 환경에서든 실행됩니다. - JVM은 클래스 로더(부모 위임, 로딩과 링크와 초기화), 런타임 데이터 영역(스레드별 스택과 공유 힙, 메서드 영역), 실행 엔진(인터프리터, JIT, 가비지 컬렉터)으로 나눠 이해할 수 있습니다.
- 자주 실행되는 코드는 JIT 컴파일러가 실행 정보로 최적화하므로, 배포 직후 웜업과 영역별 메모리 에러를 이 구조와 연결해 보면 원인을 찾기 쉽습니다.
이 글을 읽고 2가지 궁금한 점이 떠올랐습니다.
1. JIT 컴파일을 하면 무조건 성능이 좋아지나요? 오히려 안좋아지는 경우는 어떤 때이고 왜 그런가요?
2. GC가 자동으로 메모리를 정리해준다고 하셨는데, Java에서도 메모리 누수가 발생할 수 있나요?