텍스트 표현
컴퓨터는 항상 비트를 다루고 이를 이용해 수, 문자, 키보드에 있는 기호를 표현한다.
아스키 코드
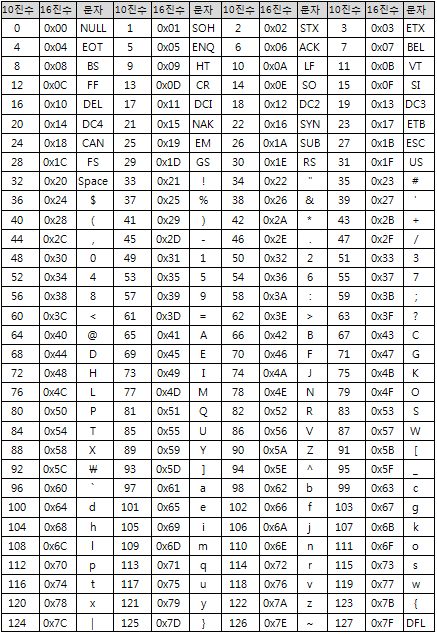
과거 수와 마찬가지로 텍스트를 표현하는 방법의 경우에도 여러 아이디어가 있었지만 승자는 정보 교환을 위한 미국 표준 코드(ASCII, American Standard Code for Information Interchange)이다. 아스키는 키보드에 있는 모든 기호에 대해 7비트 수 가밧을 할당했다. 예를 들어 65는 대문자 A를 표현한다.
https://velog.io/@astar5327/C%EC%96%B8%EC%96%B4-%EC%95%84%EC%8A%A4%ED%82%A4%EC%BD%94%EB%93%9C
아스키 코드 표에는 글자를 출력하는 데 쓰이지 않고 장치를 제어하기 위해 쓰이는 제어 문자(control character)가 존재한다. 이 중 상당 수는 통신 제어를 위한 문자이다. 예를 들어 ACK(수신확인)은 '메시지를 받았음'이라는 뜻이고 NAK(반수신확인)는 '메시지를 받지 못했음'이라는 뜻이다.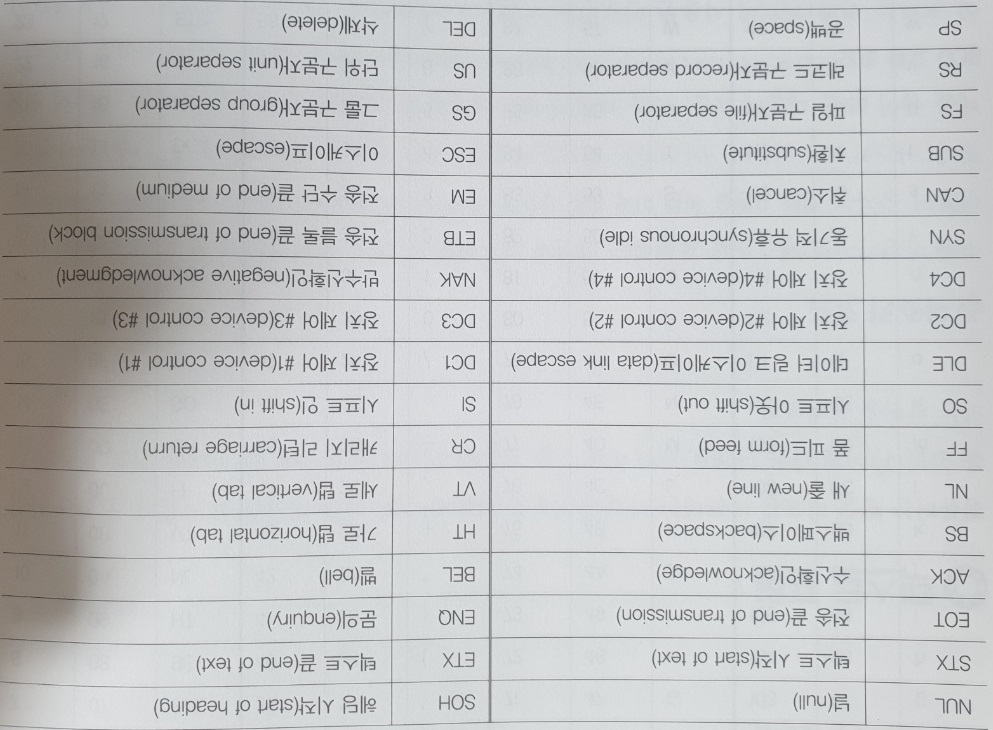
다른 표준의 진화
아스키는 영어를 표현하는 데 필요한 모든 문자를 포함하고 있어서 상당 기간 표준 역할을 했다. 초기 컴퓨터는 미국산 아니면 영국산이었기에 문제는 없었다. 하지만 컴퓨터가 널리 쓰이게 됨에 따라 그 밖의 언어를 지원해야 할 필요가 점차 늘어났다.
국제 표준화 기구(ISO, International Standards Organization)는 ISO-646, ISO-8859를 도입했다. 기본적으로 아스키를 확장해 유럽 언어에 필요한 액센트 기호나 그 밖의 발음 구별 기호를 추가 했다. 일본 산업 표준(JIS, Japanese Industrial Standards)위원회는 일본 문자 표현을 위해 JISX-0201을 만들었다. 그리고 중국어, 아랍어, 한국어 등의 표준도 생겼다.
이렇게 각기 다른 표준이 존재한 이유는 그때는 비트가 지금보다 더 비싼 시절이었기 때문이다. 그래서 문자를 7비트, 8비트에 욱여넣었다. 하지만 비트 가격이 떨어짐에 따라 유니코드(Unicode)라는 새로운 표준이 만들어졌고, 문자에 16비트 코드를 부여했다. 그 후 유니코드는 21비트까지 확장되었다.
유니코드 변환 형식 8비트
인코딩
컴퓨터의 경우 8비트=1바이트 씩 사용한다. 이에 따라 7비트를 사용하는 아스키의 코드의 경우 MSB에 0을 넣는다. 하지만 유니코드는 7비트를 사용하지 않고 8비트 내로 표현하는것이 문제가 된다. 따라사 유니코드는 문자 코드에 따라 각기 다른 인코딩을 사용해 이런 문제를 해결한다. 여기서 인코딩이란 다른 비트 패턴을 표현하기 위해 사용하는 비트 패턴을 의미한다. 또 다른 말로는 사람이 인지할 수 있는 형태의 데이터를 약속된 규칙에 의해 컴퓨터가 사용하는 0과 1로 변환하는 과정을 말한다. 우리는 비트를 이용해 숫자를 표현하고 그 숫자로 문자를 표현한다. 다시 다른 숫자를 이용해 그 문자(숫자, 비트)를 표현한다. 이때 보통 유니코드 변환 형식 8비트(UTF-8, Unicode Transformation Format-8 bit)라는 인코딩 방법을 이용한다.
UTF-8은 하위 호환성(아스키 코드)과 효율성 때문에 널리 쓰이고 있다. UTF-8은 모든 아스키 문자를 8비트로 표현하기에 아스키 데이터를 인코딩할 때는 추가 공간이 필요하지 않다. 그리고 아스키가 아닌 문자의 경우 아스키를 받아서 처리하는 프로그램이 깨지지 않는 방법으로 문자를 인코딩한다.
UTF-8은 문자를 8비트 덩어리(옥텟, octet)의 시퀀스로 인코딩한다. UTF-8의 첫 번째의 옥텟의 MSB쪽에 있는 비트들이 옥텟의 시퀀스의 길이를 표현한다. 이에 옥텟들의 맨 앞을 식별하기 쉬운 특징이 있다. 이는 프로그램이 문제 경계를 찾을 때 빛을 발한다. 모든 아스키 코드의 경우 7비트에 들어가기에 하나의 옥텟으로 표현이 가능하다.
| 코드 값의 자릿수 | 범위 | 첫 바이트 | 둘째 바이트 | 셋째 바이트 | 넷째 바이트 | 다섯째 바이트 | 여섯째 바이트 |
|---|---|---|---|---|---|---|---|
| 7비트 | 0 ~ 0x7F(127) | 0xxxxxxx | |||||
| 11비트 | 0x80(128) ~ 0x7FF(2,047) | 110xxxxx | 10xxxxxx | ||||
| 16비트 | 0x800(2,048) ~ 0xFFFF(65,535) | 1110xxxx | 10xxxxxx | 10xxxxxx | |||
| 21비트 | 0x10000(65,536) ~ 0x1FFFFF(2,097,151) | 11110xxx | 10xxxxxx | 10xxxxxx | 10xxxxxx | ||
| 26비트 | (미사용) | 111110xx | 10xxxxxx | 10xxxxxx | 10xxxxxx | 10xxxxxx | |
| 31비트 | (미사용) | 1111110x | 10xxxxxx | 10xxxxxx | 10xxxxxx | 10xxxxxx | 10xxxxxx |
첫 번째의 옥텟의 MSM가 0일 경우 문자가 0~7비트 내로 표현이 가능하는 걸 말한다.
1일 경우는 여러개의 옥텟이 있다는 말이고 그 뒤에 따르는 1의 개수가 나머지 옥텟의 수를 나타낸다. 예를 들어 1110xxxx은 나머지 옥텟이 2개 더있다는걸 의미한다. 첫 옥텟을 제외한 나머지 옥텟은 10으로 시작한다.
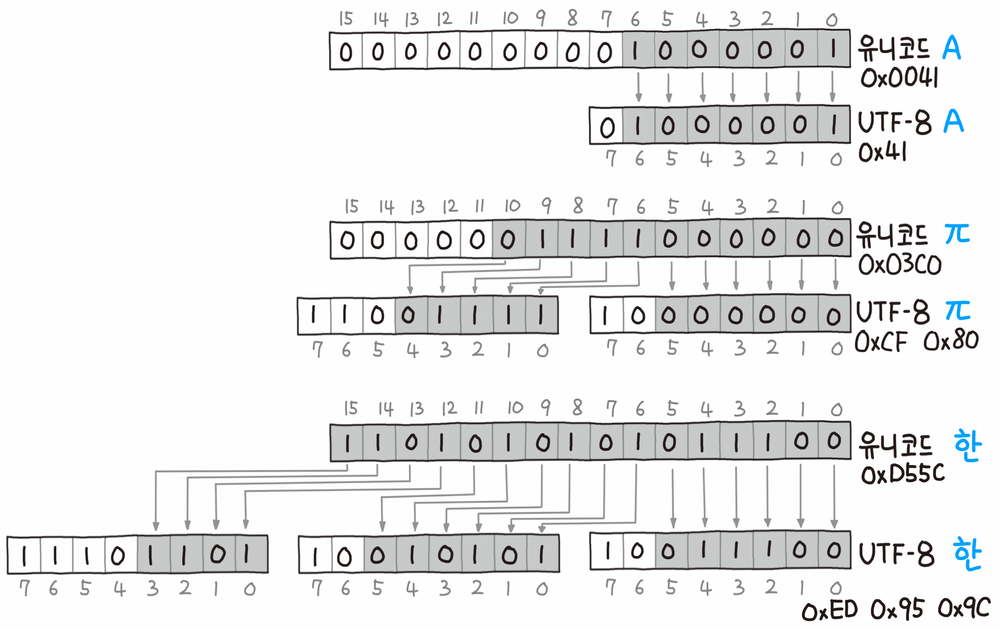
유니코드이자 아스키코드인 A는 하나의 옥텟으로 표현이 가능하다. 즉 0x0041을 UTF-8로 인코딩하면 0x41이 나온다.
유니코드 π의 경우 첫 옥텟에 110 그리고 두번째 옥텟에 10을 넣고 나머지 비트들에 π의 비트를 나눠서 넣고있다.
유니코드 한의 경우 세 개의 옥텟을 사용해 인코딩한다.
문자를 사용한 수 표현
UTF-8은 문자(예: A)를 표현하는 비트들(2진수 0000000001000000)로부터 나온 숫자들(0x0041)을 표현하는 숫자들(UTF-8로 인코딩한 값)을 표현하기 위해 숫자(실제 UTF-8로 인코딩한 0x41)들을 사용한다.
과거 사람들은 컴퓨터 사이에 많은 정보를 송수신하고 싶어했다. 사람들은 2진 데이터를 보내고 싶어했으나 쉽지 않았다. 왜냐하면 아스키 코드 중 상당수가 제어 문자로 예약되어 있었고 이런 제어 문자는 시스템에 따라 처리하는 방식이 달랐고 몇몇 시스템은 7비트만 송수신이 가능했기 때문이다.
QP 인코딩
출력 가능하게 변경한 인코딩(Quoted-Printable encoding)은 쿼티드 프린터블 인코딩, QP 인코딩이라 불리는데 8비트 데이터를 7비트만 지원하는 통신 경로를 통해 송수신하기 위한 인코딩이다.
QP인코딩은 전자우편 첨부를 처리하기 위해 만들어 졌다.
베이스64 인코딩
앞의 QP인코딩을 좀 더 효율적으로 쓰기 위해 나온 것이 베이스64(base64)인코딩이다. 베이스 64 인코딩은 3바이트 데이터를 4문자로 표현한다. 3바이트 데이터의 24비트를 6비트 덩어리로 나누고 각 덩어리의 6비트 값에 출력 가능한 문자를 할당해 표현한다.
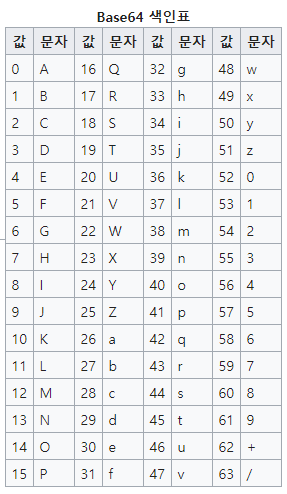
예를 들어 012를 베이스64 인코딩을 하면 다음과 같은 방식으로 AAEC라는 결과가 나온다.
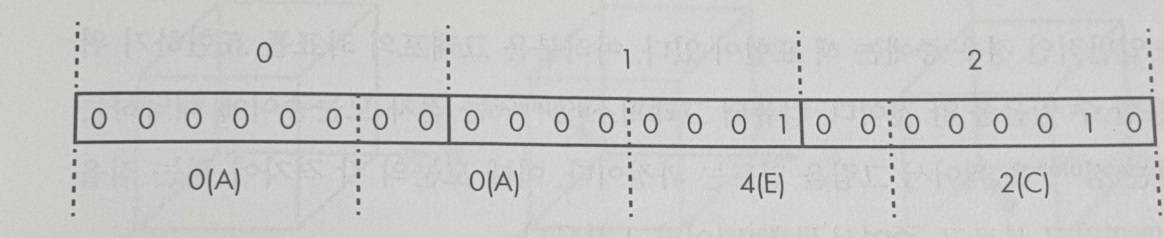
이 인코딩은 모든 3바이트 조합을 4바이트 조합으로 변환할 수 있다. 하지만 원본 데이터의 길이가 3바이트의 배수가 아닐 수 있다. 이때 패딩(padding)문자를 도입해 이런 문제를 해결한다. 2바이트가 남으면 '=', 1바이트가 남으면 '==' 끝이 붙인다.
베이스 64은 아직까지도 전자우편 첨부파일 전송에 많이 사용 중 이다.
URL 인코딩
URL 인코딩(혹은 퍼센트 인코딩percent-encoding)이란 URL에서 URL로 사용할 수 없는 문자 혹은 URL로 사용할 수 있지만 의미가 왜곡될 수 있는 문자들을 '%XX'의 형태로 변환하는 것을 말한다. 여기서 XX는 16진수 값이다. 그리고 URL 디코딩이란 변환된 URL을 다시 원래의 형태로 되돌리는 것을 말한다.
'안녕%바 보' 를 인코딩하면 '%ec%95%88%eb%85%95%25%eb%b0%94+%eb%b3%b4'
이를 반대를 디코딩이라 한다.
URL 인코딩을 왜 사용하는 건가?
- 인터넷을 통해 전송할 수 있는 문자는 오로지 ASCII 문자이기 때문이다. 따라서 ASCII 문자가 아닌 문자는 인터넷을 통해 전송할 수 있는 형태로 변환해줘야 한다. 한글은 ASCII 문자가 아니므로 변환이 필요하다. 그리고 이때 변환하는 규칙은 UTF-8을 따른다. UTF-8에 따르면 한글 문자 1개는 3바이트로 인코딩 된다. 따라서 '안녕'의 글자는 '%ec%95%88%eb%85%95' 6바이트가 된다. 공백은 %20혹은 +이다. '바 보'는 %eb%b0%94+%eb%b3%b4 에서 보면 중간에 +가 있다.
-
ASCII 문자라 하더라도 예약된 의미를 가지고 있는 문자의 경우, 그 문자 자체의 의미를 전달하고 싶은 경우에는 이스케이프 처리가 필요하기 때문이다.
이러한 문자의 대표적인 예시로는 '/', '&', '=' 등이 있다.
- '/'은 URL의 각 레벨을 구분해주는 역할을 맡는다.
- '&'는 쿼리 파라미터들을 구분해주는 역할을 맡는다.
- '='은 쿼리 파리미터의 값을 지정해주는 역할을 맡는다.
이처럼 이러한 문자들은 ASCII 문자이지만 URL 내에서 특별한(예약된) 의미를 가지고 있다. 따라서 이러한 문자들을 문자 그 자체의 의미로서 전달하고 싶다면 이스케이프 처리가 필요하다. 위의 예시에서 알수 있드시 %의 의미를 그대로 인코딩한다면 %25가 된다.(ASCII에서 %은 16진수 25)색을 표현하는 방법
컴퓨터 그래픽스(graphics)는 전자 모눈종이에 해당하는 것에 색을 표현하는 점(blob)을 찍어서 그림을 만드는 과정이다. 이때 모눈의 각 격자에 찍는 점을 그림 원소(picture element)라고 부르고, 줄여서 픽셀(pixel)이라 부른다.
컴퓨터 모니터는 빨간색, 녹색, 파란색 광선을 섞어서 색을 만들어내며 이런 색 표현법을 RGB색 모델(RGB color moder)이라 부른다. 색은 컬러 큐브(color cobe)라는 것에 표현 할 수 있다. 컬러 큐브에서 각 축은 주(primary) 색을 표현하며 값이 0이면 그에 해당하는 주 색의 빛을 끈다는 뜻이며, 값이 1이면 해당하는 주 색의 빛을 가능한 최대 밝기로 켠다는 뜻이다. 만일 빛이 없으면 검은색이 되고 모든 빛을 최대로 한다면 흰색이 된다. 빨간색과 녹색 파란색의 밝기가 전부 같다면 회색이 된다. 이런 식으로 빛을 혼합해 색을 표현하는 방식을 가산(additive)색 시스템이라고 부른다. 이에 반대되는 것이 감산(subtractive) 색 시스템이다. 감산 색 시스템에서는 주 색이 청록색, 자홍색, 노란색이다. 가산의 경우 빛의 광선(파장)을 서로 추가해서 색을 만들고 감산의 경우 빛을 제거하면서 색을 만들어 낸다.
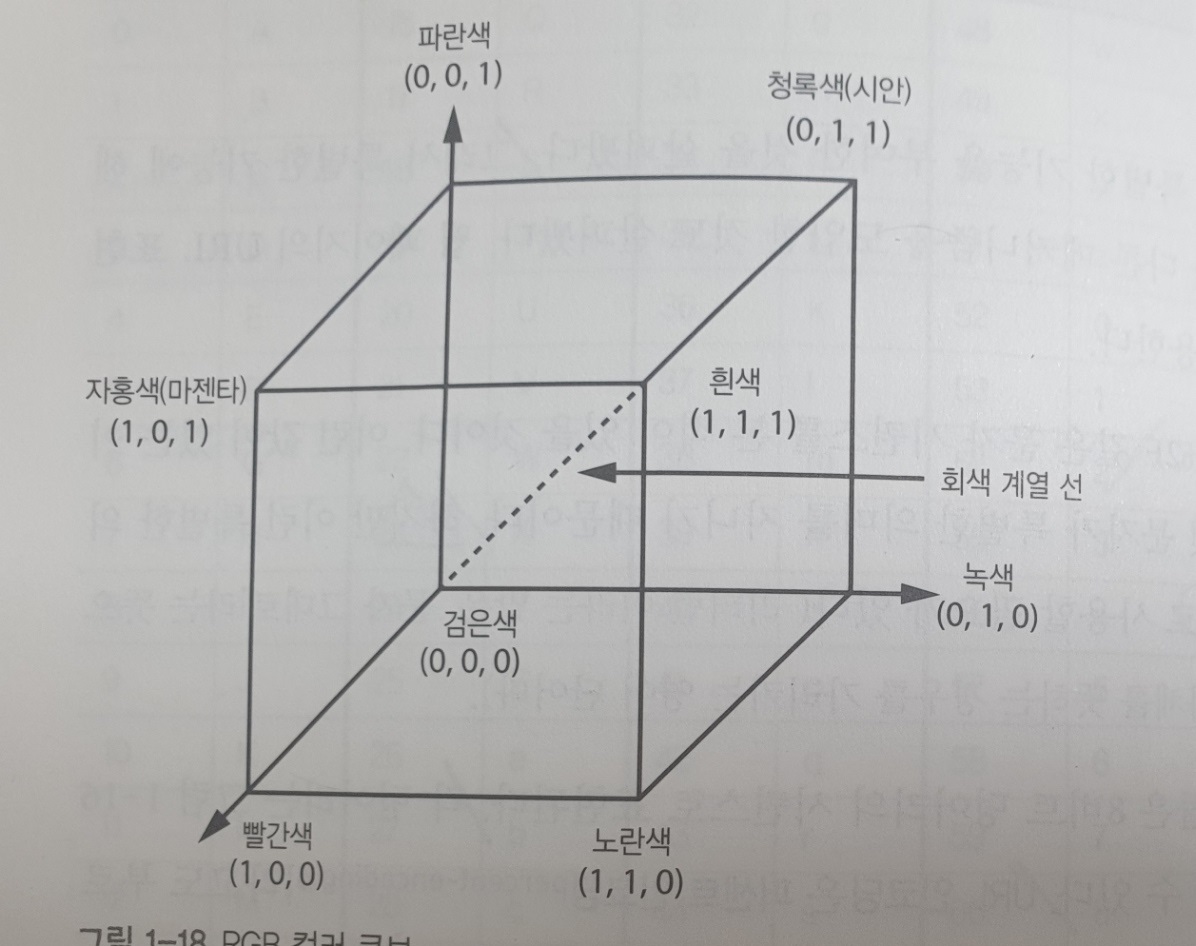
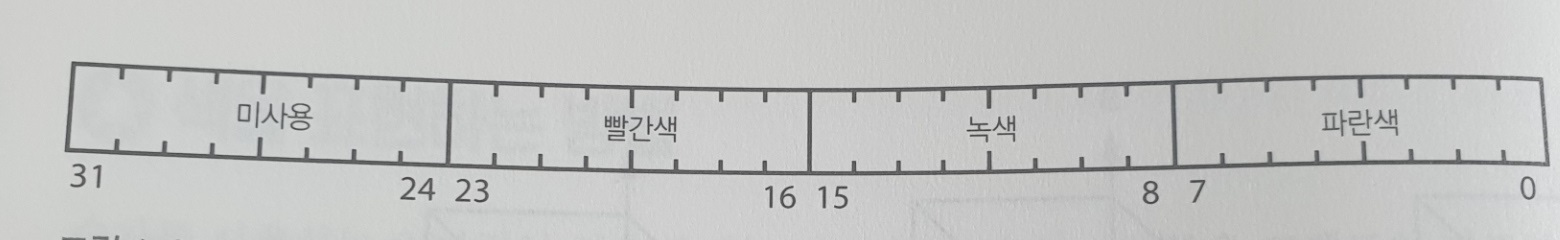
현재의 컴퓨터들은 색을 표현하는 데 24비트를 사용해 1천만에 가장 가까운 2의 제곱수에 해당하는 색을 표현할 수 있다. 24비트는 다시 8비트 세 그룹으로 나뉘며 각 필드는 세 가지 주요 색을 표현한다. 하지만 현대 컴퓨터들은 24비트 단위로 계산을 수행하지 않기에 가장 가까운 32비트(워드)로 계산을 수행한다. 이에 따라 자연스레 8비트가 남게되었다. 이 비트를 낭비하지 않기 위해 새로운 요소 투명도(transparency)를 도입했다.
투명도
샐 애니메이션(cell animation)에서는 움직이는 캐릭터를 투명한 셀룰로이드 필름 위에 그려서 정적인 배경 이미지 위에서 움직이게 할 수 있다. 마찬가지로 컴퓨터 애니메이션에서도 투명도가 있으면 여러 이미지를 하나로 합성(compose)하는 것이 가능하다.
1984년 투명도와 합성을 구현하는 새로운 방법을 발명했고, 그 이후 이 방법이 표준이됬다. 각 픽셀에 알파(α)라는 투명도 값을 추가했다. α는 수학적으로 0이상 1이하의 값인데 0은 완전히 투명하다는 뜻이고 1는 완전히 불투명하다는 뜻이다. 여러 다른 알파값의 색을 합성해 새로운 색을 만들어내는 방법을 정의하는 일련의 합성 계산법(compositing algebra)식이 있다.
앞서 말한대로 사용되지 않는 미사용 8비트에 α를 도입했다.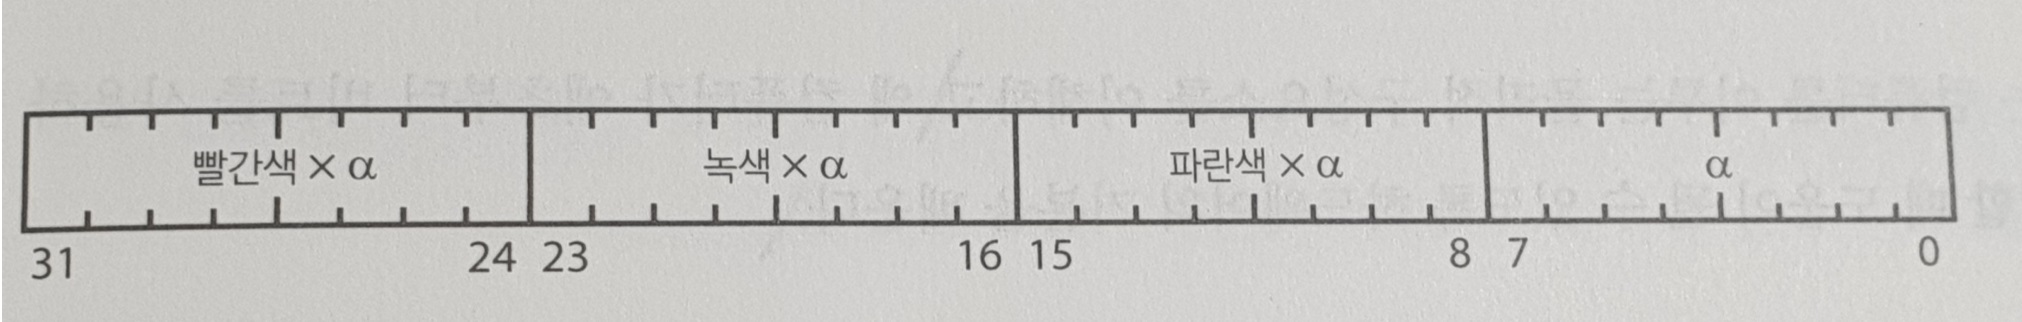
빨간색, 녹색, 파란색 값 그대로 저장하는 대신, 각각의 색값에 α를 곱한 값을 저장했다.
예를 들어 색이 중간 정도 밝기의 빨간색이라면 RGB로는 빨간색이 200, 나머지는 0이다. 이 색이 완전히 불투명하다면 α는 1(=255)이고 빨간색 값은 200이다. 만일 빨간색의 α가 절반 정도 투명도의 0.5라면 α는 127(255/2) 빨간색은 100(200/2)이다.
색 인코딩
앞의 URL 인코딩과 비슷한 방법으로 색을 인코딩한다. 웹에서는 색을 16진 트리플렛(hex triplet)으로 표현한다. 16진 트리플렛은 #뒤에 여섯 자리 16진 수를 추가해 #rrggbb처럼 표현하는 방식이다. 여기서 rr은 빨간색 값, gg는 녹색, bb는 파란색 값이다. 예를 들어 #000000은 검은색, #ffffff은 흰색, #ffff00은 노란색이다.
