0. 들어가며...
Lazy Propagation. 굉장히 낯선 용어다.
저번 포스트에서 세그먼트 트리를 설명했지만, 이 친구는 구간 쿼리와 점 업데이트에 강한 자료구조다.
여기서 구간 쿼리는 예를 들면 sum(4, 8) 같은 연산이다.
세그먼트 트리는 4부터 8까지의 모든 리프 노드를 직접 훑지 않고도, 중간에 적절히 끊어서 O(log N)에 처리할 수 있다.
하지만 기본 세그트리는 점 업데이트에 더 잘 맞는다.
예를 들어 A[5] = 10처럼 하나의 점만 바꾸는 경우에는 O(log N)으로 충분히 빠르다.
문제는 이런 식의 구간 업데이트가 들어올 때다.
A[4..8]에 모두+1A[2..7]에 모두+5
이런 연산을 기본 세그트리로 처리하려고 하면, 결국 리프까지 내려가서 영향을 받는 값들을 하나하나 갱신해야 하는 경우가 많아진다.
즉 업데이트 하나가 최악의 경우 O(N)까지 커질 수 있다.
그래서 나오는 생각이 바로 이거다.
지금 당장 자식들까지 다 갱신하지 말고,
이 구간 전체에+1해야 한다는 사실만 기록해두자.
이게 바로 Lazy Propagation이다.
1. 그래서 lazy가 뭔데?
사전적인 의미 그대로, '게으르게' 갱신하는 방식이다.
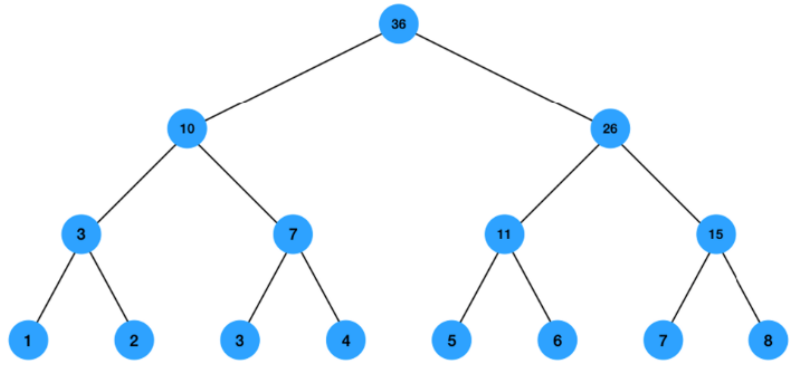
아래와 같은 구간합 세그먼트 트리를 예시로 들어보자.
여기에서 4부터 8까지 1씩 더해줘야 하는 경우를 생각해보자.
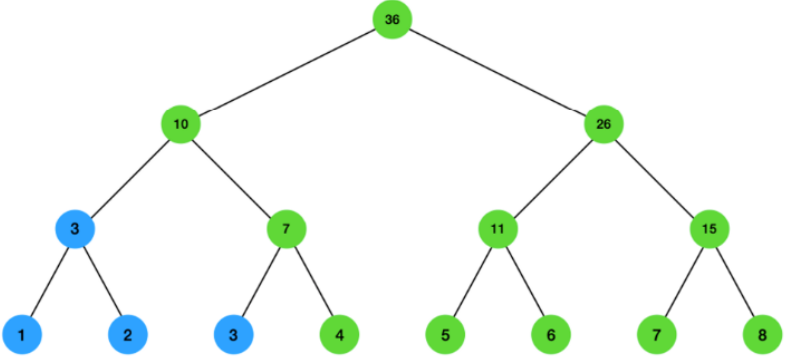
일반적인 세그트리에서는 4부터 8까지 업데이트하기 위해 거쳐야 하는 노드를 전부 탐색해야 한다.
지금은 노드 수가 적어서 괜찮아 보일 수 있지만, 노드가 100만 개이고 변경이 10만 번 일어난다면?
업데이트마다 최악의 경우 O(N)이 걸릴 수 있기 때문에 시간초과 가능성이 커진다.
여기서 우리는 Lazy Propagation을 사용한다.
아까
이 구간 전체에 +1 해야 한다는 사실만 기록해두자
라고 말했는데, 그걸 어디에 기록한다는 말일까?
정답은 현재 노드의 자식들에게 나중에 전파할 정보로 기록해두는 것이다.
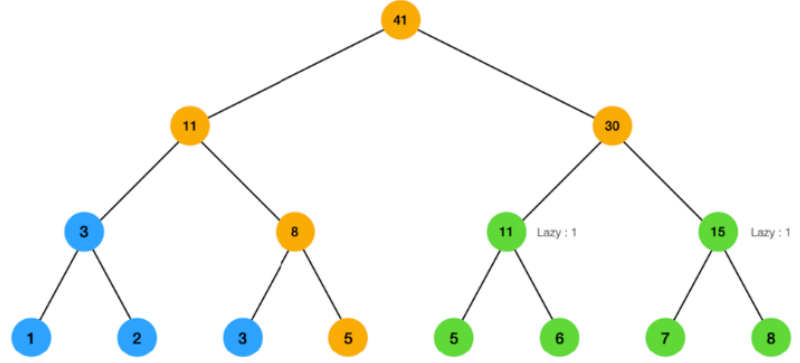
예를 들어 지금 위 그림에서 노드(30)가 5~8 구간 전체를 정확히 포괄하고 있으니, 굳이 그 아래 리프 노드까지 내려갈 필요가 없다.
그 노드의 합만 먼저 갱신해두고,
“이 아래 자식들도 나중에
+1해야 함”
이라는 사실만 lazy 배열에 남겨두면 된다.
즉 느낌상 이렇게 생각하면 된다.
어차피 지금 당장 자식 노드 값을 쓸 일이 없잖아?
그러니까 귀찮게 일일이 내려가지 말고, 나중에 query나 update로 진짜 그 자식을 방문할 때 반영해줄게.
이게 바로 Lazy Propagation의 핵심 원리다.
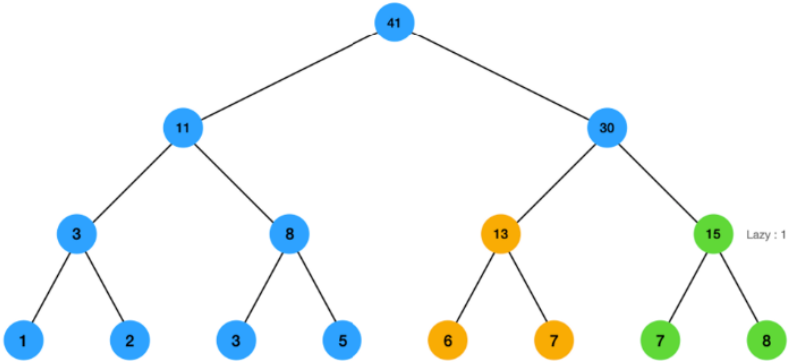
이제 3번 노드부터 5번 노드까지의 합을 구해야 한다고 해보자.
이 경우 중간에 lazy 값이 남아 있는 노드를 만나면, 그때 비로소 lazy를 실제로 반영해서 아래로 내려가면 된다.
2. 그래서 코드에서는 뭐가 추가되는데?
기본 세그트리에서는 보통
seg[node]: 이 구간의 합
만 관리했다.
Lazy Propagation에서는 여기에 더해
lazy[node]: 이 노드에 쌓여 있지만 아직 자식들에게 내려보내지 않은 업데이트 정보
를 관리해야 한다.
말 그대로, “밀린 숙제”를 적어두는 배열이라고 생각하면 된다.
3. update_lazy 함수
백문이 불여일견이라고 했으니, 코드부터 보자.
static void update_lazy(int node, int start, int end) {
    if (lazy[node] != 0) {
        seg[node] += (end - start + 1L) * lazy[node];

        if (start != end) {
            lazy[node * 2] += lazy[node];
            lazy[node * 2 + 1] += lazy[node];
        }

        lazy[node] = 0;
    }
}
이 함수가 바로 Lazy Propagation의 핵심이다.
이 함수가 하는 일
- 현재 노드에 lazy 값이 남아 있으면
- 그 구간 길이만큼 곱해서
seg[node]에 먼저 반영하고 - 리프 노드가 아니라면 왼쪽 / 오른쪽 자식에게 lazy 값을 넘겨주고
- 현재 노드의 lazy는 처리 완료했으니
0으로 초기화한다.
즉 이 함수는
“밀린 업데이트를 현재 노드에 반영하고,
자식에게는 나중에 처리하라고 넘겨주는 함수”
라고 보면 된다.
4. update는 어떻게 될까?
static void update(int node, int start, int end, int left, int right, long value) {
    update_lazy(node, start, end);

    if (right < start || left > end) return;

    if (left <= start && end <= right) {
        seg[node] += (end - start + 1L) * value;

        if (start != end) {
            lazy[node * 2] += value;
            lazy[node * 2 + 1] += value;
        }
        return;
    }

    int mid = (start + end) / 2;
    update(node * 2, start, mid, left, right, value);
    update(node * 2 + 1, mid + 1, end, left, right, value);
    seg[node] = seg[node * 2] + seg[node * 2 + 1];
}
기본 세그트리의 점 업데이트와 비교하면, 확실히 달라졌다.
먼저, 맨 앞에서 update_lazy
update_lazy(node, start, end);현재 노드에 미뤄둔 lazy가 있을 수도 있으니까,
무조건 먼저 정리하고 시작한다.
그다음은 세그트리의 익숙한 3가지 경우
- 완전 밖 → return
- 완전 포함 → 현재 노드에서 처리
- 부분 겹침 → 왼쪽 / 오른쪽 재귀
이 흐름 자체는 기존 세그트리와 같다.
여기서 핵심은 “완전 포함”일 때
if (left <= start && end <= right) {
    seg[node] += (end - start + 1L) * value;

    if (start != end) {
        lazy[node * 2] += value;
        lazy[node * 2 + 1] += value;
    }
    return;
}
여기가 lazy propagation의 진짜 핵심이다.
현재 노드가 구간 [left..right]에 완전히 포함된다면, 더 이상 자식으로 내려갈 필요가 없다.
- 현재 노드의
seg값은 즉시 갱신하고 - 자식에게는
나중에 이 값만큼 더해라라고 lazy만 넘긴 뒤 - 바로
return
하면 된다.
즉 여기서 자식에게 넘기는 것은 과거의 lazy가 아니라,
이번 update로 새롭게 생긴 lazy 정보다.
5. query는?
사실 query는 크게 달라지지 않는다.
핵심은 딱 하나다.
시작할 때
update_lazy(node, start, end)를 먼저 호출한다.
즉 query는 기존 세그트리의 흐름과 거의 같고,
현재 노드에 밀린 lazy가 있으면 먼저 반영한 뒤 구간 쿼리를 진행한다고 생각하면 된다.
6. 마무리
세그트리를 처음 배울 때도 생소했는데, lazy propagation은 그보다 한 단계 더 추상적이라 처음엔 더 어렵게 느껴졌다.
그래도 결국은
- 지금 갱신할 것
- 나중에 미뤄둘 것
을 나눠서 생각하는 구조라는 점에서, 원리를 이해하고 나면 꽤 납득이 되는 방식이었다.
여기까지 왔으면 아마 백준 구간 합 구하기 2 정도는 충분히 도전해볼 수 있을 것이다.
아직 풀어본 건 아니지만, lazy 세그 익히기에 괜찮아 보이는 문제들을 같이 적어두고 마무리하려 한다.