카프카의 특징을 보기 전 간단하게 발행/구독 메시지 전달 개념과 데이터 주도 애플리케이션에 대해서 알아본다.
발행/구독 메시지 전달 패턴의 특징은 전송자가 데이터를 보낼때 직접 수신자로 보내지 않는다는 것이다. 전송자는 메시지를 분류해서 보내고 수신자는 이 메시지를 구독한다. 이 발행/구독 시스템에는 메시지를 중계하는 브로커가 있다.
초기에 발행 구독 시스템에는 간단한 큐를 놓아 직접 연결하는 것이 일반적이었다. 예를 들어 지표값을 얻기 위해 지표를 생산한 지점과 처리하는 지점을 직접 연결했다. 초기에는 무리없이 동작할 수 있으나 서비스 요구사항이 복잡해지고 증가하면 기술 부채가 될 수 있다.
카프카
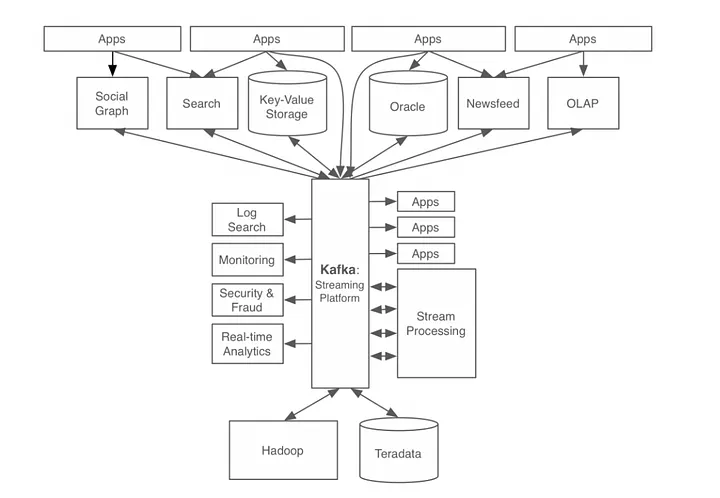
링크드인 내부 시스템 구조 (https://www.confluent.io/blog/event-streaming-platform-1/ 참고)
간략하게
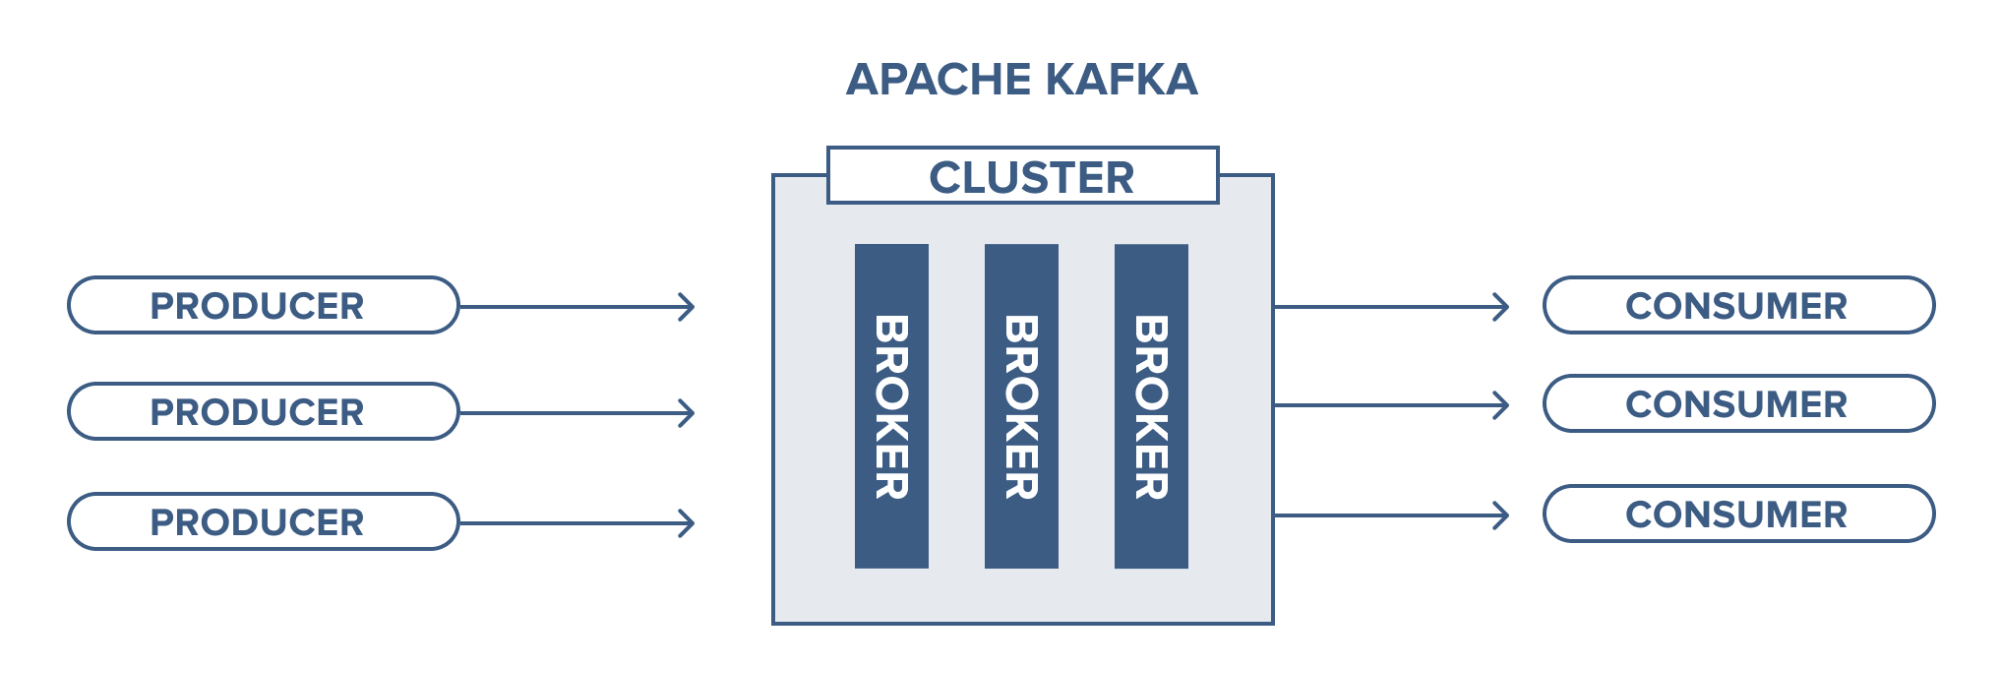
cloudkarafka 참고(https://www.cloudkarafka.com/blog/part1-kafka-for-beginners-what-is-apache-kafka.html)
카프카는 이 문제를 해결하기 위해 고안된 메시지 발행/구독 시스템이다.
카프카에 저장된 데이터는 순서를 유지한 채로 지속성있게 디스크에 보관되고 실패가 발생하여도 데이터 사용에는 문제가 없다.
메시지와 배치
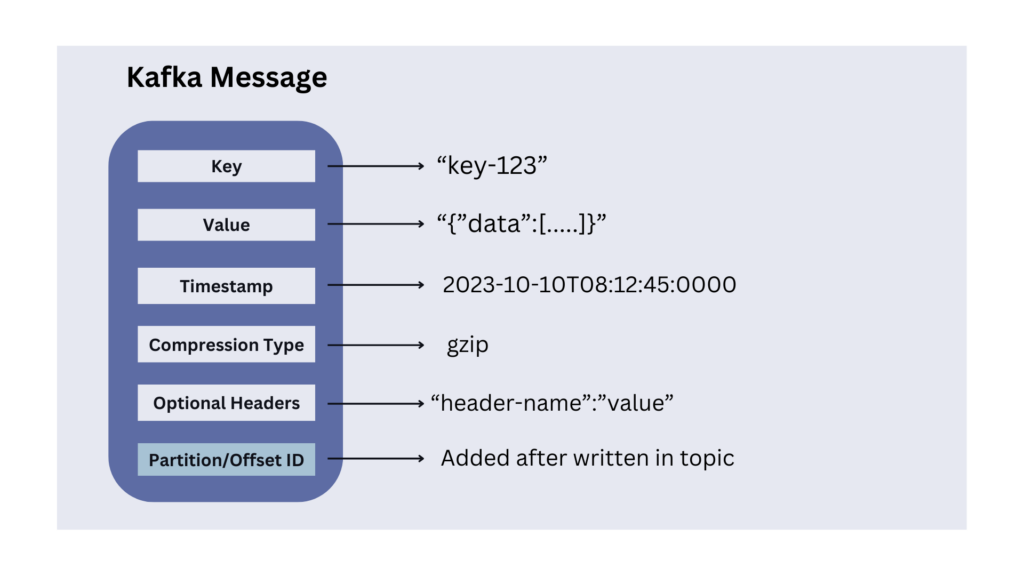
카프카에서 데이터의 기본 단위는 메시지이다. 이 메시지는 단순한 바이트 배열일 뿐이며 특정한 형식이나 의미는 없다. 메세지는 키(Key) 라 부리는 메타데이터를 포함할 수 있다. 이 키는 메세지를 저장할 파티션을 결정하기 위해 사용되기도 한다. 간단하게는 키 값에서 일정한 해시를 생성하여 토픽의 파티션수로 나눈 나머지 값에 해당하는 파티션에 메시지를 저장하는 것이다. 카프카는 효율성을 위해 메시지를 배치(batch) 단위로 저장한다.
스키마
카프카 입장에서 메시지는 단순한 바이트 배열이지만 내용이해를 쉽게 하기위해 일정한 구조를 부여하는것이 권장된다. 카프카에서는 일관적인 데이터 형식이 중요하다. 메시지 쓰기와 읽기 작업을 분리해주기 때문이다. 간단한 방법으로는 JSON이나 XML등이 있으며 아파치 에이브로(Avro)도 있다.
토픽과 파티션
[토픽 파티션 그림]
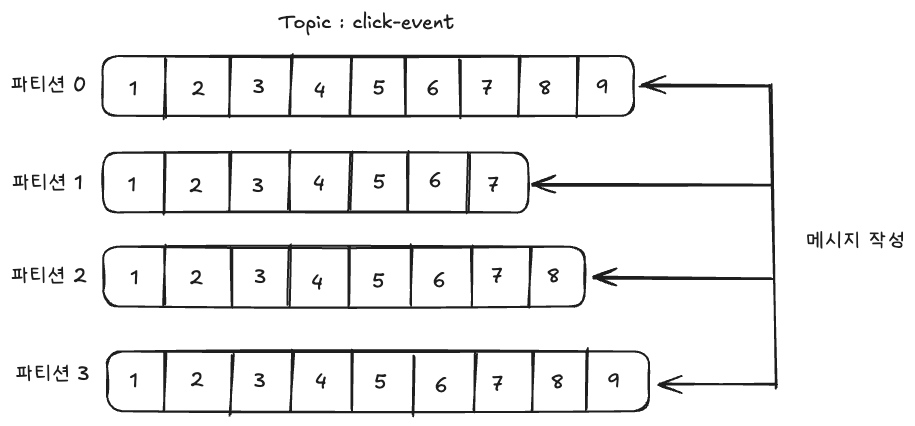
카프카에 저장되는 메시지는 토픽단위로 분류된다. 토픽은 여러개의 파티션으로 나뉘어진다. 파티션에 메시지가 쓰일때는 추가만 가능(append-only) 한 형태이며 읽을때는 맨 앞부터 끝까지 순서대로 읽힌다. 토픽은 하나의 토픽내에 여러개의 파티션이 있고 토픽내에 전체에 대한 순서는 보장되지 않으며 단일 파티션에 대해서만 순서가 보장된다.
그래서 토픽에 메시지를 쓰면 각 파티션의 끝에 추가가 된다. 각 파티션은 서로 다른 서버에 저장될 수 있다. 만약 순서 보장이 필요하면 파티션 키를 동일하게 설정하면 순서가 보장된다.
프로듀서
[프로듀서 그림]
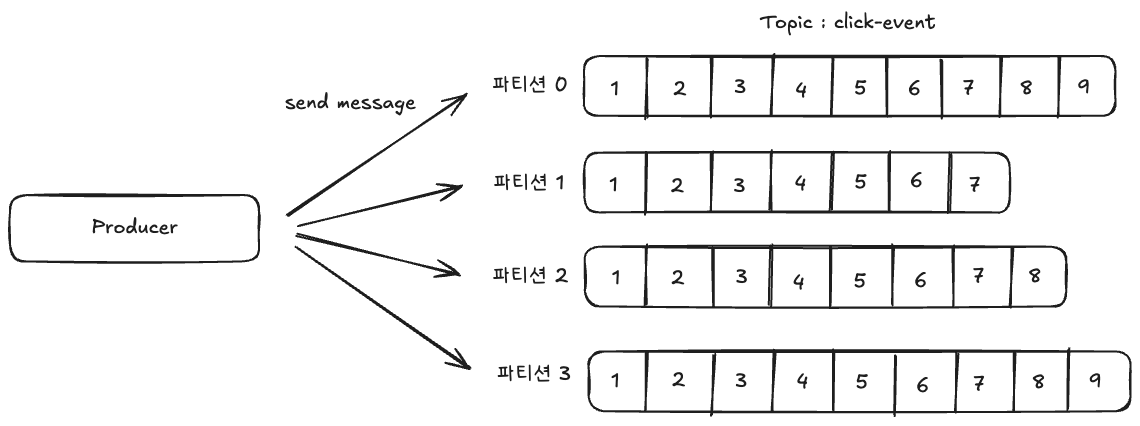
카프카 클라이언트는 카프카 사용자로 프로듀서와 컨슈머 2종류가 있다. 고급 클라이언트 API로는 카프카 Connect API와 카프카 Streams가 있다.
프로듀서는 새로운 메시지를 생성한다. 기본적으로 메시지를 쓸때 토픽 내의 파티션들 사이에 고르게 나눠쓰도록 되어있다. 파티션 키를 지정할 수 도 있으며 보통 키와 키의 해시를 특정 파티션으로 대응시키는 파티셔너를 사용해서 구현된다. 이렇게 하면 동일 키값을 가진 모든 메시지는 같은 파티션에 저장된다.
컨슈머
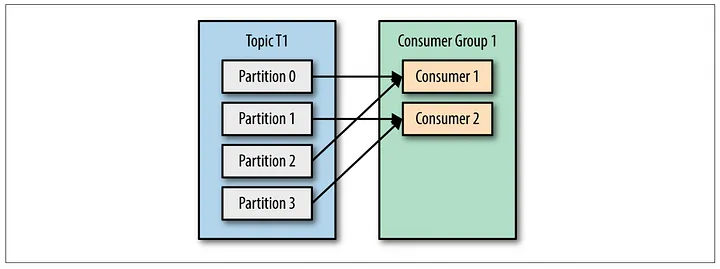
4개의 파티션에 2개의 컨슈머 (Kafka : The Definitive Guide 87p 참고)
컨슈머는 메시지를 읽는다. 컨슈머는 1개 이상의 토픽을 구독해서 파티션에 쓰여진 순서대로 읽어온다. 컨슈머는 메시지의 오프셋을 브로커에 기록하여 어디까지 컨슈머가 읽었는지를 유지한다. 오프셋은 지속적으로 증가하는 정수로 메타데이터이다. 파티션의 각 메시지는 고유한 오프셋을 가진다. 파티션별로 다음번에 사용 가능한 오프셋 값을 저장하여 갑자기 중단되더라도 정상적으로 다시 시작할 수 있다.
컨슈머 그룹
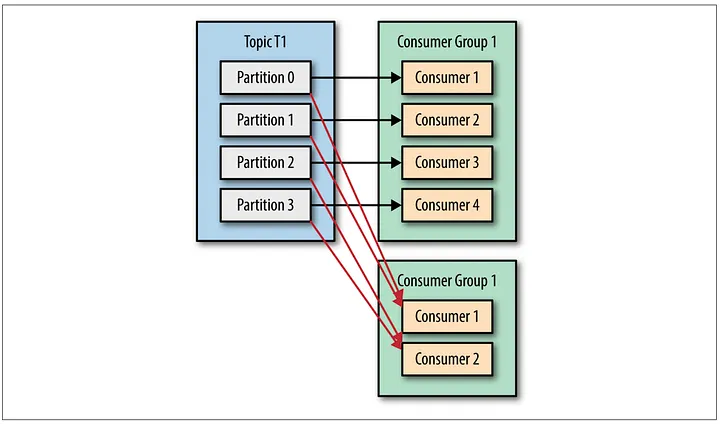
4개의 파티션에 2개의 컨슈머 그룹 (Kafka : The Definitive Guide 87p 참고)
컨슈머는 컨슈머 그룹의 일원으로 동작한다. 컨슈머 그룹은 각 파티션이 하나의 컨슈머에 의해서만 읽히도록 한다. 컨슈머에서 파티션의 대응관계는 파티션 소유권이라고도 부른다. 이 방법을 통해 대량의 메시지를 갖는 토픽들을 읽기 위해 컨슈머들이 수평확장할 수 있다. 그리고 장애가 발생해도 그룹안의 다른 컨슈머들이 파티션을 재할당받아 데이터를 이어서 읽을 수 있다.
브로커와 클러스터
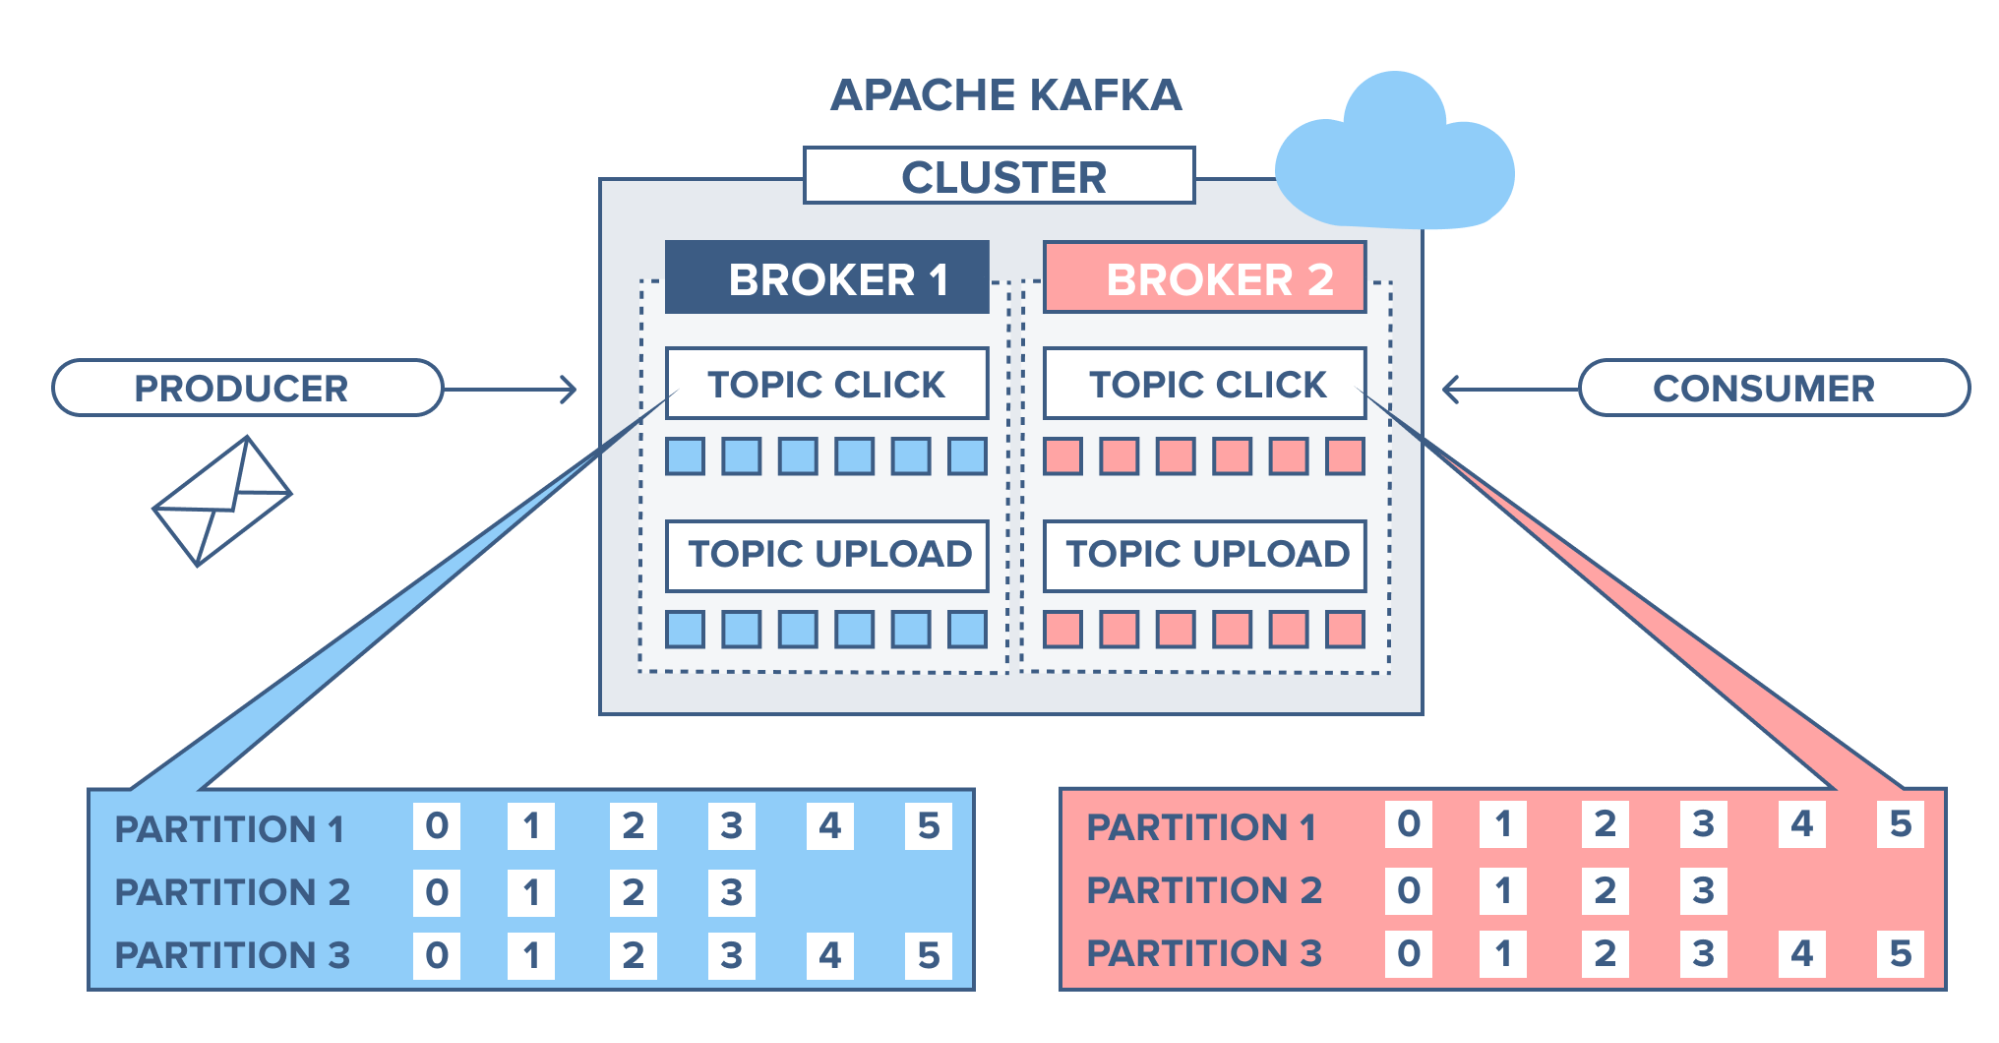
cloudkarafka 참고(https://www.cloudkarafka.com/blog/part1-kafka-for-beginners-what-is-apache-kafka.html)
하나의 카프카 서버를 브로커라고 부른다. 브로커는 프로듀서로부터 메시지를 전달받아서 오프셋을 할당한 뒤 디스크저장소에 쓴다. 또한 컨슈머의 파티션 읽기 요청 역시 처리하고 발행된 메시지를 보낸다. 카프카 브로커는 클러스터의 일부로 작동하며 하나의 클러스터 안에 여러개의 브로커가 있다.
그리고 이중 하나의 브로커가 컨트롤러 역할을 하게 된다. 컨트롤러는 파티션을 브로커에 할당하거나 모니터링 한다. 파티션에는 리더와 팔로워가 있는데 만약 리더 파티션이 장애가 발생하면 컨트롤러는 팔로워중 하나를 리더 역할을 이어받을 수 있도록 한다.
다중 프로듀서
데이터를 쉽게 수집하고 유지할 수 있다. 예를 들어 페이지 뷰용 데이터를 쉽게 수집할 수 있다. 하나의 토픽 생성을 생성하고 여러개의 프로듀서가 해당 토픽에 데이터를 전송하고 하나의 컨슈머가 소비하면 된다. 즉, 각 서비스별 producer는 단일 토픽으로 데이터를 전송하고 kafka 브로커는 데이터를 각 파티션에 나눠서 저장한다. 이때 컨슈머는 하나의 토픽만 읽어도 쉽게 데이터 수집이 가능하다.
다중 컨슈머
메시지는 키 값의 해시를 통해 특정 파티션에 저장된다. 컨슈머는 하나의 파티션의 데이터 스트림을 읽어오도록 되어있다. 하나의 파티션만 놓고보면 일반 queue 시스템과 유사하지만 broker 개념을 사용하여 다중적으로 처리할 수 있도록 설계되었다.
디스크 기반 보존
데이터들을 지속성있게 저장이 가능하다. 컨슈머가 중단되어도 메시지는 카프카안에 담겨있다. 중단된 지점부터 유실없이 이어서 처리가 가능하다.