0과 1밖에 이해하지 못하는 컴퓨터가 어떻게 문자를 표현하는지에 대해 알아보겠습니다.
문자 집합과 인코딩
문자 집합 (character set)
- 컴퓨터가 이해할 수 있는 문자의 모음
인코딩 (encoding)
- 코드화하는 과정
- 문자를 0과 1로 이루어진 문자코드로 변환하는 과정
어떤 값을 코드로 표현하는 것을 인코딩이라고 합니다.
디코딩 (decoding)
- 코드를 해석하는 과정
- 0과 1로 표현된 문자 코드를 문자로 변환하는 과정

아스키 코드
- 초창기 문자 집합 중 하나
- 알파벳, 아라비아 숫자, 일부 특수 문자 및 제어 문자
- 7비트로 하나의 문자 표현
-- 8비트 중 1비트는 오류 검출을 위해 사용되는 페리티 비트(parity bit)
가장 대표적이고 대중적인 문자 집합, 그리고 인코딩 방법입니다.
장점 : 간단한 인코딩
단점 : 한글을 포함한 다른 언어 문자, 다양한 특수 문자 표현 불가
아스키 코드는 7비트로 하나의 문자를 표현하기 때문에 128개보다 많은 문자를 표현할 수 없습니다. 즉, 아스키 코드를 쓴다한들 한글을 이해시킬 수 없습니다.
한글 인코딩: 완성형 vs 조합협 인코딩
영어와 다르게 한글은 초성, 중성, 종성으로 나뉘어 있기 때문에 인코딩 방식에도 차이가 있습니다.
완성형
완성형 인코딩 방식은 바 + 구 + 니 처럼 글자가 완성된 상태, 즉 완성된 글자에 고유한 코드를 부여하는 방식입니다.
조합형
조합형 인코딩 방식은 ㅂ + ㅏ + ㄱ + ㅜ + ㄴ + ㅣ 처럼 자음과 모음에 각각 코드를 부여하는 방식 입니다.
EUC-KR
- KS X 1001 KS X 1003 문자집합 기반의 한글 인코딩 방식
- 완성형 인코딩
- 글자 하나 하나에 2바이트 크기의 코드 부여
-- 2바이트 == 16비트 == 4자리 십육진수로 표현
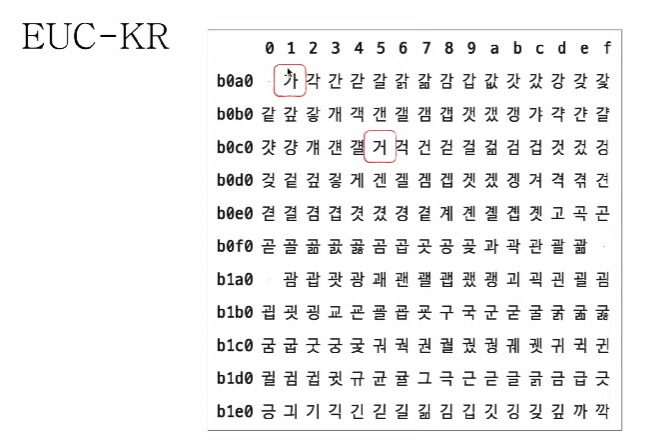
- 2300여개의 한글 표현 가능
- 여전히 모든 한글을 표현하기에는 부족한 수
따라서 모든 언어, 특수 문자까지 통일된 문자 집합을 사용, 통일된 문자 집합 & 인코딩 방식을 지원하기 위해 나온것이 유니 코드 입니다.
유니코드 문자 집합과 utf-8
유니코드
- 통일된 문자 집합
- 한글, 영어, 화살표와 같은 특수 문자, 심지어 이모티콘까지
- 현대 문자 표현에 있어 매우 중요한 위치
유니코드의 인코딩 방식
- utf-8, utf-16, utf-32 ...
UTF-8 인코딩
- UTF(Unicode Transformation Format) == 유니코드 인코딩 방법
- 가변 길이 인코딩: 인코딩 결과가 1바이트~4바이트
- 인코딩 결과가 몇 바이트가 될지는 유니코드에 부여된 값에 따라 다름

Cloud & DevOps