[Java] HashSet 동작 원리 - hashCode()와 equals()로 중복을 걸러내는 방법
HashSet을 쓰다 보면 "어떻게 중복을 이렇게 빨리 걸러내지?" 하는 궁금증이 생긴다. 이 글에서는 HashSet을 이해하기 위해 Hash 알고리즘과 Set 자료구조를 먼저 짚어보고, 두 개념이 만나 HashSet이 어떻게 동작하는지 정리해 본다.
1. Hash 알고리즘과 Hash Table
Hash 알고리즘은 임의의 데이터를 일정한 형태의 값(hash 값)으로 변환해 주는 알고리즘이다. 대표적으로 SHA-256 같은 알고리즘이 있다.
💡 다만
SHA-256은 보안(무결성 검증, 비밀번호 저장 등)을 위한 암호학적 해시 함수이고, 자료구조에서 쓰는 해시 함수는 훨씬 가볍고 빠른 함수를 사용한다. Java의 경우 객체의hashCode()가 그 역할을 한다. 이 글에서는hashCode()기준으로 설명한다.
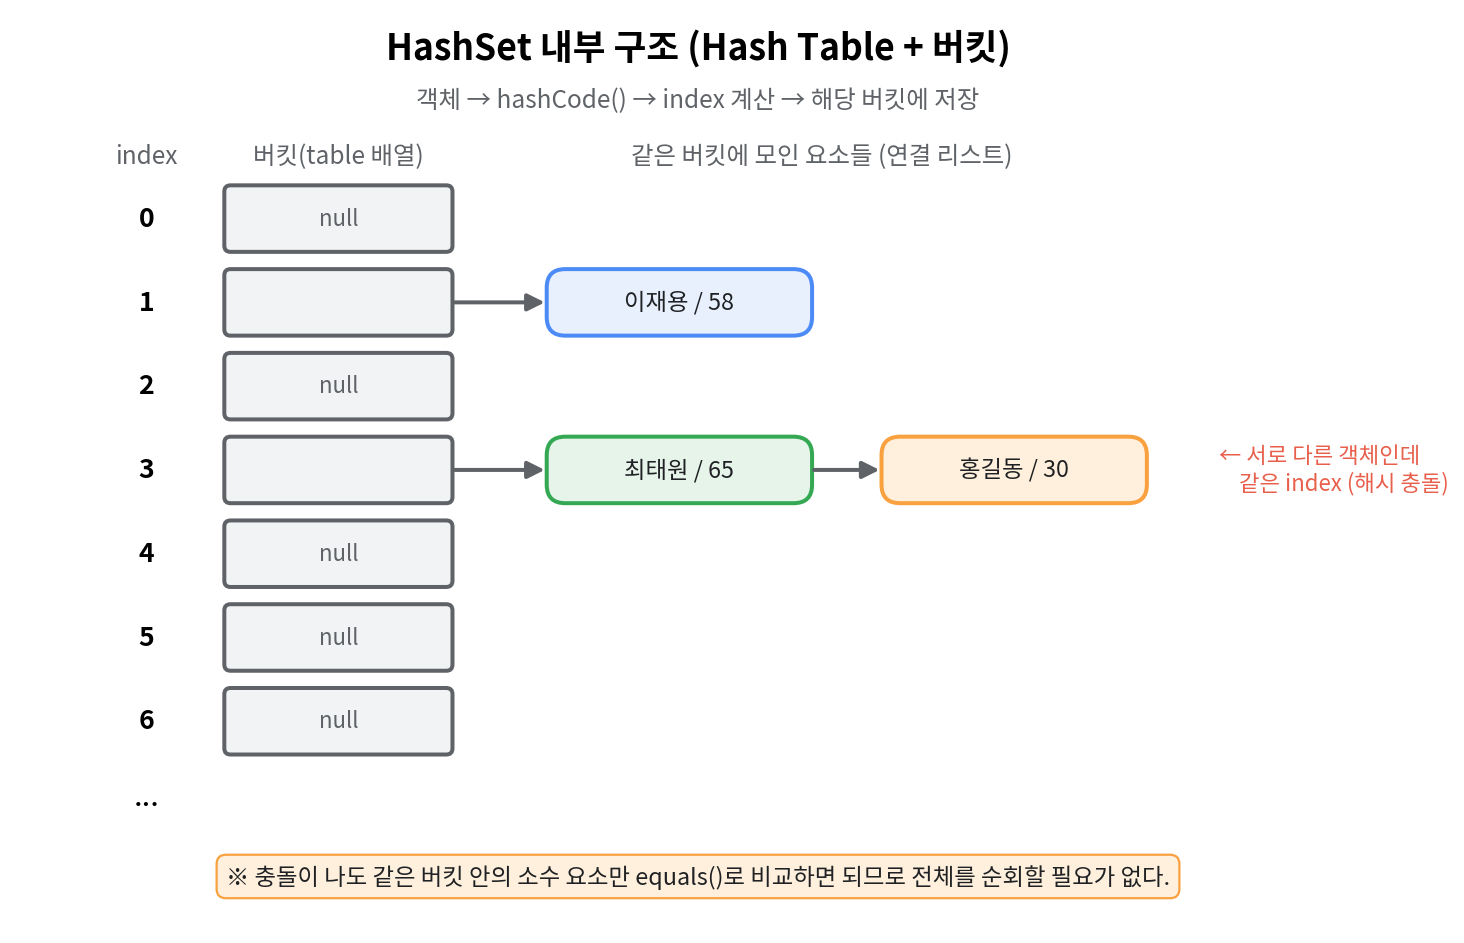
이렇게 얻은 hash 값으로 배열의 index(버킷 위치)를 계산하고, 그 index에 해당하는 자리에 데이터를 저장하는 자료구조를 Hash Table이라고 한다.
데이터 → hash 함수 → hash 값 → index 계산 → 배열의 해당 index(버킷)에 저장핵심은 "데이터만 알면 저장 위치를 바로 계산할 수 있다" 는 점이다. 그래서 탐색, 삽입, 삭제가 평균적으로 O(1)에 가능하다.
해시 충돌 (Hash Collision)
서로 다른 데이터가 같은 index로 계산되는 경우를 해시 충돌이라고 한다. hash 값의 범위(약 42억 개의 int)보다 배열의 크기가 훨씬 작기 때문에 충돌은 언제든 발생할 수 있다.
Java의 HashMap(= HashSet)은 체이닝(Chaining) 방식으로 충돌을 해결한다. 같은 index를 가지는 데이터들을 하나의 버킷 안에 연결 리스트로 이어서 저장한다.
2. Set 자료구조
Set은 번역하면 집합이다. 수학에서의 집합처럼 다음 두 가지 특징을 가진다.
- 순서가 없다. → List와 달리 index 개념이 없다. (
get(0)같은 접근이 불가능하다) - 중복을 허용하지 않는다. → 이미 있는 요소를 또 넣으려고 하면 무시된다.
⚠️ 여기서 주의할 점! "중복을 허용하지 않는다"는 것은 Set이 알아서 중복을 걸러준다는 뜻이다. List에서는 중복을 막으려면 직접
contains()로 검사하는 코드를 작성해야 하지만, Set은add()만 하면 중복 검사를 내부에서 해준다. 이 "내부에서 해주는 중복 검사"가 어떻게 가능한지를HashSet에서 살펴볼 것이다.
3. Hash Table + Set = HashSet
Set이 중복을 막으려면 "이미 같은 요소가 있는지" 확인해야 한다. 만약 저장된 모든 요소를 처음부터 끝까지 순회하며 비교한다면 데이터가 많아질수록 느려진다(O(n)).
Hash Table을 사용하면 새로 들어온 요소의 hash 값으로 저장될 버킷을 바로 찾아가서, 그 버킷 안의 요소들하고만 비교하면 된다. 이것이 HashSet이 중복 체크를 빠르게 하는 원리다.
HashSet은 내부적으로 HashMap이다
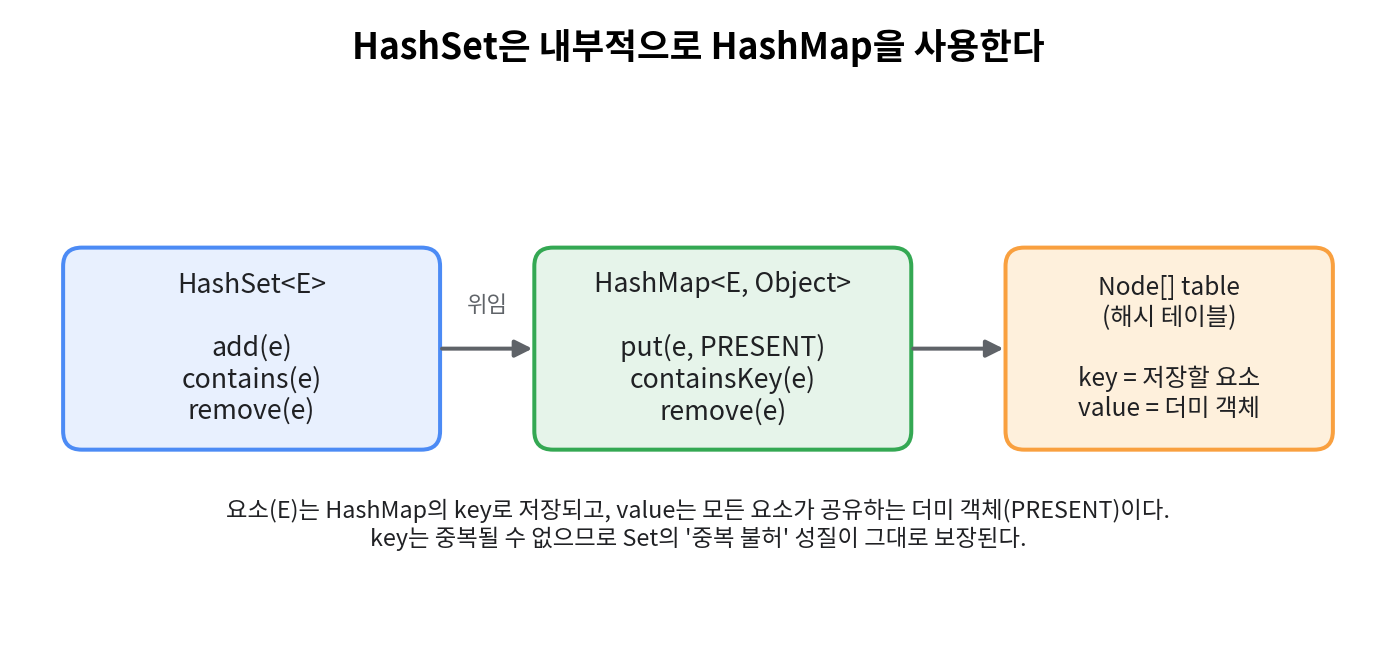
실제로 HashSet은 내부에 HashMap을 하나 가지고 있고, 모든 동작을 HashMap에 위임한다. 저장하려는 요소는 HashMap의 key로 들어가고, value에는 의미 없는 더미 객체를 넣는다.
// java.util.HashSet 소스코드 (일부)
private transient HashMap<E,Object> map;
private static final Object PRESENT = new Object(); // 모든 요소가 공유하는 더미 value

public HashSet() {
    map = new HashMap<>();
}

public boolean add(E e) {
    return map.put(e, PRESENT) == null; // 새로 추가되면 true, 이미 있었으면 false
}Map의 key는 중복될 수 없으므로, Set의 "중복 불허" 성질이 자연스럽게 보장된다.
4. hashCode()와 equals()
HashSet에 저장되는 객체는 hashCode()와 equals()를 함께 오버라이딩해야 한다.
| 메서드 | 역할 |
|---|---|
hashCode() | 객체를 hash 값(int)으로 변환한다. 어느 버킷에 넣을지 결정하는 데 쓰인다. |
equals() | 두 객체가 동등한지 판단한다. 같은 버킷 안에서 진짜 같은 객체인지 최종 확인하는 데 쓰인다. |
String, Integer, LocalDate 등 Java가 제공하는 대부분의 클래스는 이미 오버라이딩되어 있다. (모든 클래스는 아니다. 예를 들어 배열이나 StringBuilder는 값이 아닌 참조(주소) 기준으로 비교한다.)
하지만 직접 정의한 클래스는 오버라이딩하지 않으면 Object의 기본 구현을 쓰게 되는데, 이 기본 구현은 객체의 주소(참조) 를 기준으로 동작한다. 즉, 필드 값이 같아도 new로 만든 객체는 서로 다른 객체로 취급된다.
hashCode()와 equals()의 규약
equals()가true인 두 객체는 반드시 같은hashCode()를 가져야 한다.hashCode()가 같다고 해서equals()가true인 것은 아니다. (= 해시 충돌)- 같은 객체에 대해
hashCode()는 (필드가 바뀌지 않는 한) 항상 같은 값을 반환해야 한다.
그래서 둘 중 하나만 오버라이딩하면 안 된다. equals()만 재정의하면 같은 값의 객체인데도 hash 값이 달라 서로 다른 버킷에 들어가 중복 검사를 통과해 버린다.
5. 예제로 보는 HashSet의 동작 과정
이름(name)과 나이(age)가 모두 같으면 같은 사람이라고 정의한 Person 클래스를 만들어보자.
import java.util.Objects;

public class Person {
    private final String name;
    private final int age;

    public Person(String name, int age) {
        this.name = name;
        this.age = age;
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;
        Person person = (Person) o;
        return age == person.age && Objects.equals(name, person.name);
    }

    @Override
    public int hashCode() {
        return Objects.hash(name, age); // equals()에서 쓴 필드와 동일한 필드로 계산
    }

    @Override
    public String toString() {
        return name + "(" + age + ")";
    }
}
다음과 같이 HashSet에 객체를 저장해 보자.
Set<Person> set = new HashSet<>();

Person p1 = new Person("이재용", 58);
Person p2 = new Person("최태원", 65);
Person p3 = new Person("이재용", 58); // p1과 이름, 나이가 같다

System.out.println(set.add(p1)); // true
System.out.println(set.add(p2)); // true
System.out.println(set.add(p3)); // false  ← 중복이라 저장되지 않는다

System.out.println(set.size()); // 2p1, p2는 서로 다른 객체이므로 정상적으로 저장된다. 그렇다면 p1과 동등한 p3를 add() 하면 내부에서 어떤 일이 일어날까?
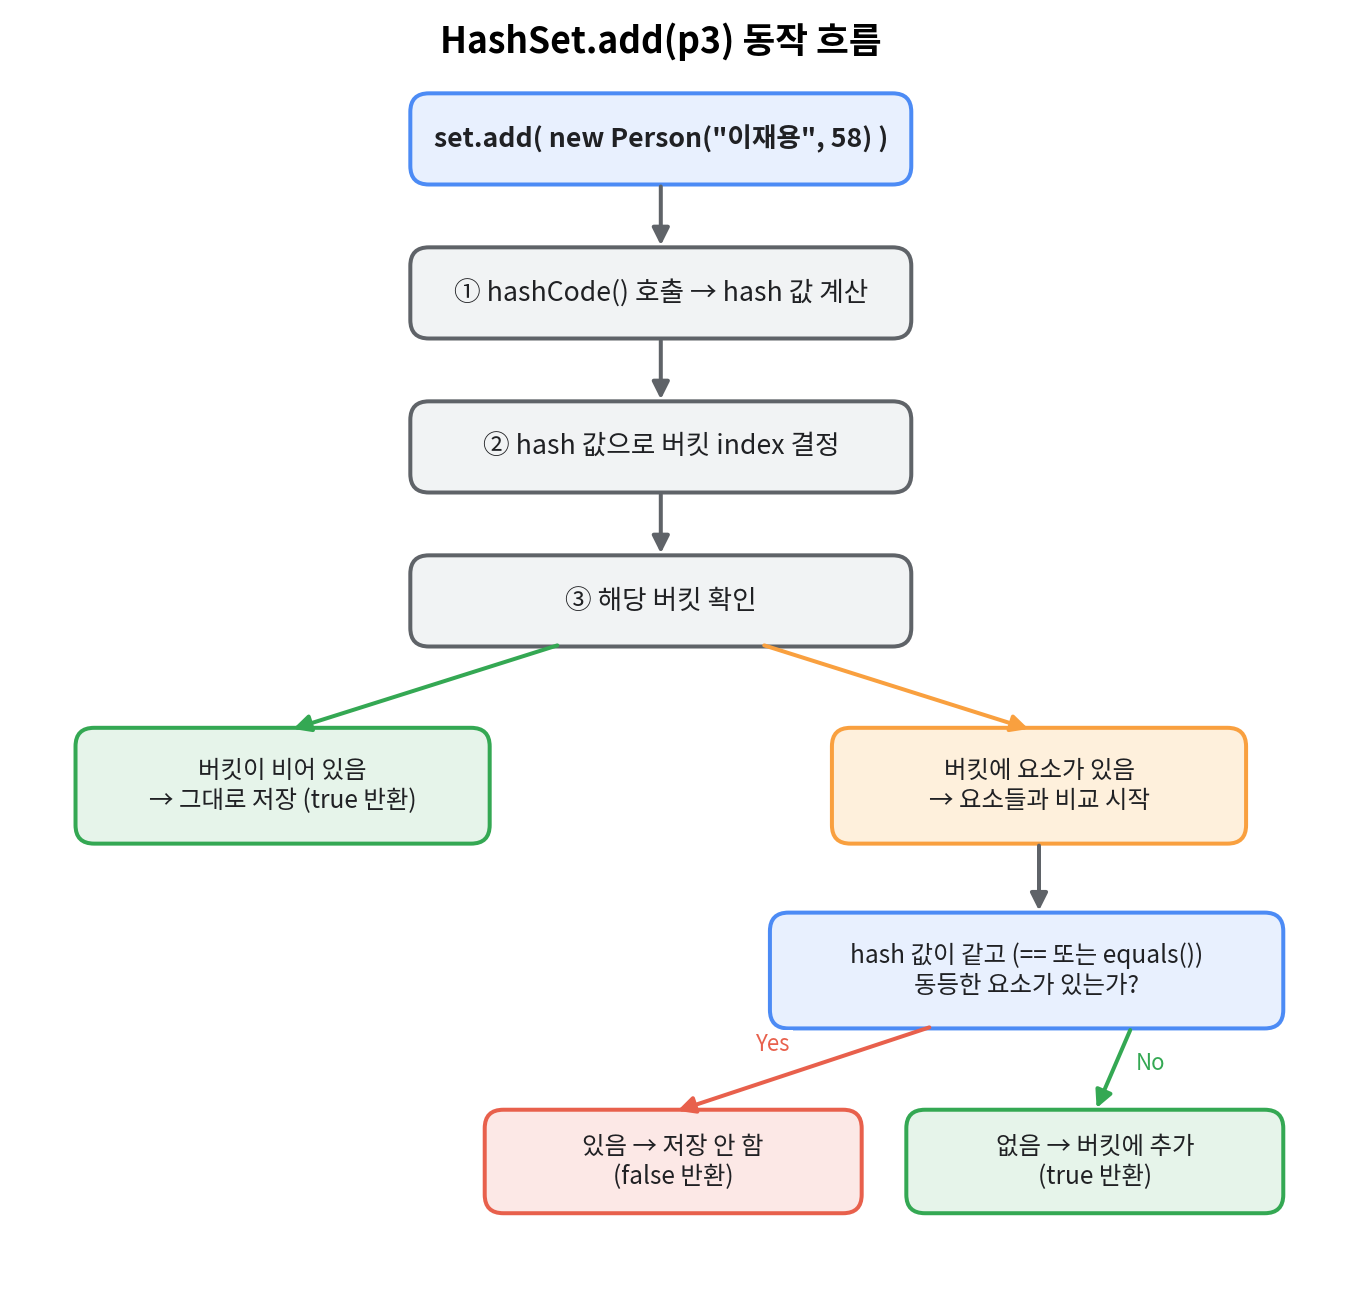
hashCode()호출 -p3.hashCode()가 호출되어 hash 값이 계산된다.hashCode()는name과age로 계산하도록 오버라이딩했으므로, 같은 값을 가진p1의 hash 값과 동일한 값이 나온다.- 버킷 index 결정 - hash 값으로 버킷 index를 계산한다. hash 값이 같으니
p1이 들어 있는 버킷과 같은 index가 나온다. - 버킷 확인 - 해당 버킷이 비어 있으면 그대로 저장하면 끝이다. 하지만
p1이 이미 들어 있으므로 비교가 필요하다. - 동등성 비교 - 버킷 안의 요소들과 비교한다. hash 값이 같고, 참조가 같거나(
==)equals()가true이면 동일한 요소로 판단한다.p1.equals(p3)가true이므로p3는 중복 객체이다. - 저장 거부 - 중복이므로 저장하지 않고
false를 반환한다.
이 과정에서 전체 요소를 순회하지 않고, 계산된 버킷 안의 요소들(보통 0~몇 개)하고만 비교한다는 점이 핵심이다.
📌 "같은 hash code"와 "해시 충돌"은 다르다
p1과p3는 동등한 객체(equals true) 라서 hash code가 같은 것이다. 이건 충돌이 아니라 중복이다.- 해시 충돌은
p1과p2처럼 서로 다른(equals false) 객체가 우연히 같은 버킷 index를 갖게 되는 경우다. 이때는equals()가false이므로 둘 다 저장되고, 같은 버킷 안에 연결 리스트로 이어진다.
String의 "Aa"와 "BB"는 hashCode()가 둘 다 2112로 같지만 서로 다른 문자열이다. 이 둘을 HashSet에 넣으면 충돌이 일어나지만 equals()가 false이므로 둘 다 저장된다.
Set<String> set = new HashSet<>();
set.add("Aa");
set.add("BB");

System.out.println("Aa".hashCode()); // 2112
System.out.println("BB".hashCode()); // 2112
System.out.println(set.size());      // 2 (hash가 같아도 equals가 false면 둘 다 저장)
6. 조금 더 깊이 들어가 보기 (Java 8 기준)
6-1. 배열 크기와 리사이징
- 기본 초기 용량은 16, load factor(부하율)는 0.75 이다.
- 저장된 요소 수가
용량 × 0.75(기본 12개)를 넘으면 배열 크기를 2배로 늘리고 요소들을 다시 배치(rehashing)한다. - 버킷이 지나치게 길어지는 것을 막기 위한 장치다.
6-2. 충돌이 많아지면? (연결 리스트 → 레드-블랙 트리)
Java 8부터는 한 버킷에 요소가 8개 이상 쌓이고 배열 크기가 64 이상이면, 그 버킷의 연결 리스트를 레드-블랙 트리로 바꾼다. (요소가 6개 이하로 줄면 다시 리스트로 되돌린다.) 덕분에 최악의 경우에도 탐색이 O(n)이 아닌 O(log n) 이 된다. (레드-블랙 트리는 다음에 더 자세하게 알아보도록 하자)
6-3. 시간 복잡도
| 연산 | 평균 | 최악 (Java 8+) |
|---|---|---|
add / contains / remove | O(1) | O(log n) |
List.contains()는 항상 O(n)이므로, 데이터가 많고 "있는지 확인"이 잦다면 HashSet이 훨씬 유리하다. 아래는 10만 개 데이터에서 1만 번 contains()를 수행해 본 예시다. (환경마다 다르므로 대략적인 감만 잡자)
ArrayList.contains : 2,099 ms
HashSet.contains   : 7 ms
[알고리즘] O(n)과 O(log n)의 차이 - 국어사전으로 이해하기
시간 복잡도를 공부하다 보면 O(n), O(log n) 같은 표기를 자주 만난다. 이 글에서는 두 복잡도의 차이를 국어사전에서 단어 찾기라는 실생활 예시로 이해하고, 데이터가 100만 개일 때 실제로 몇 번의 연산이 필요한지 비교해 본다.
1. 시간 복잡도(Big-O)란?
시간 복잡도는 입력 데이터의 크기(n)가 커질 때 연산 횟수가 어떻게 늘어나는지를 나타내는 표기법이다.
💡 Big-O는 "정확히 몇 초 걸린다"가 아니라 "데이터가 늘어나면 얼마나 가파르게 느려지는가" 를 보여준다.
2. 실생활 예시: 국어사전에서 단어 찾기
O(n) - 첫 페이지부터 한 장씩 넘기며 찾기
사전이 1,000쪽이라고 해보자. 첫 쪽부터 한 장씩 넘기며 찾으면 운이 나쁠 때 1,000번을 확인해야 한다.
- 쪽수가 2배가 되면 → 확인 횟수도 2배
- 데이터 크기에 정비례해서 늘어난다.
Java의 ArrayList.contains()처럼 처음부터 끝까지 순회하는 탐색이 대표적인 O(n)이다.
O(log n) - 사전을 반으로 펼쳐서 찾기
- 사전의 가운데를 펼친다.
- 찾는 단어가 앞쪽인지 뒤쪽인지 확인한다.
- 해당하는 절반만 남기고 나머지는 버린다.
- 이 과정을 반복한다.
1,000쪽이면 2¹⁰ ≈ 1,000이므로 약 10번이면 찾을 수 있다.
- 쪽수가 2배가 되어도 → 확인 횟수는 딱 1번만 늘어난다.
- 한 번 확인할 때마다 탐색 범위가 절반으로 줄어든다.
이진 탐색(Binary Search), 레드-블랙 트리(TreeSet, TreeMap)의 탐색이 대표적인 O(log n)이다.
⚠️ 단, 사전이 가나다순으로 정렬되어 있기 때문에 반으로 나눌 수 있는 것이다. 정렬되지 않은 책이라면 이 방법은 쓸 수 없다. 이진 탐색은 정렬된 데이터가 전제다.
3. 데이터가 1,000,000개일 때
| 방식 | 필요한 연산 횟수 | 계산 |
|---|---|---|
| O(n) | 최악 약 1,000,000번 (평균 약 500,000번) | n |
| O(log n) | 최악 약 20번 | log₂(1,000,000) ≈ 19.93 |
O(n)이 O(log n)보다 약 50,000배 많은 연산을 한다.
왜 약 20번일까?
100만을 계속 반으로 나눠보면 된다.
1,000,000 → 500,000 → 250,000 → 125,000 → 62,500 → 31,250
→ 15,625 → 7,812 → 3,906 → 1,953 → 976 → 488 → 244 → 122
→ 61 → 30 → 15 → 7 → 3 → 1
약 20번 나누면 1개만 남는다. 2²⁰ = 1,048,576이므로 100만 개 정도는 20번이면 충분하다.
4. 데이터가 늘어날수록 벌어지는 차이
| 데이터 수 (n) | O(n) | O(log n) |
|---|---|---|
| 1,000 | 1,000 | 약 10 |
| 1,000,000 | 1,000,000 | 약 20 |
| 1,000,000,000 | 1,000,000,000 | 약 30 |
데이터가 1,000배 늘어날 때마다 O(log n)은 약 10번씩만 늘어난다. 데이터가 10억 개가 되어도 30번 정도면 된다. 그래서 O(log n)은 데이터가 아무리 많아도 거의 느려지지 않는다고 봐도 된다.
5. HashSet과의 관계
이전 글에서 다룬 HashSet은 이 복잡도와 어떻게 연결될까?
| 상황 | 시간 복잡도 |
|---|---|
| 평균 (해시가 고르게 분산) | O(1) - 데이터가 몇 개든 위치를 바로 계산 |
| 최악 (Java 8 이후, 한 버킷에 요소가 몰림) | O(log n) - 연결 리스트가 레드-블랙 트리로 바뀜 |
| 최악 (Java 7 이하) | O(n) - 한 버킷이 연결 리스트라서 순회 |
한 버킷에 100만 개가 몰리는 극단적인 상황이라면, Java 8 이후에는 100만 번이 약 20번으로 줄어드는 셈이다. 이것이 Java 8에서 연결 리스트를 트리로 바꾸는 최적화가 들어간 이유다.
6. 정리
| O(n) | O(log n) | |
|---|---|---|
| 비유 | 사전을 첫 쪽부터 한 장씩 넘기기 | 사전을 반으로 펼쳐가며 찾기 |
| 증가 양상 | 데이터에 정비례 | 데이터가 2배일 때 1번만 증가 |
| 1,000,000개 | 약 1,000,000번 | 약 20번 |
| 전제 조건 | 없음 | 보통 정렬(또는 트리 구조) 필요 |
| 대표 예 | ArrayList.contains() | 이진 탐색, TreeSet, TreeMap |
📌 Big-O는 정확한 연산 횟수가 아니라 데이터가 늘어날 때의 증가 경향을 나타낸다. 실제 걸리는 시간은 상수 배, 하드웨어, 캐시 등에 따라 달라질 수 있다. 하지만 데이터가 커질수록 O(n)과 O(log n)의 차이는 상수 배로는 만회할 수 없을 만큼 벌어진다.
7. HashSet 사용 시 주의사항
7-1. hash 계산에 쓰이는 필드를 변경하지 말자
HashSet에 저장한 뒤 hashCode() 계산에 쓰이는 필드 값이 바뀌면, 객체는 원래 버킷에 그대로 있는데 새 hash 값으로는 다른 버킷을 찾아가게 된다. 그 결과 분명히 들어있는 객체를 contains()로 찾지 못하는 문제가 생긴다.
MutablePerson p = new MutablePerson("이재용", 58);
set.add(p);

p.age = 59; // hashCode가 달라짐!

System.out.println(set.contains(p)); // false (분명 들어 있는데...)
System.out.println(set.size());      // 1
→ HashSet의 요소나 HashMap의 key로 쓰는 클래스는 가능하면 불변(immutable) 객체로 만드는 것이 안전하다. (Java 16+ 의 record는 equals()/hashCode()를 자동으로 만들어주고 필드도 불변이라 좋은 선택이다.)
record Person(String name, int age) {} // equals, hashCode, toString 자동 생성7-2. 순서가 필요하다면 다른 Set을 쓰자
HashSet은 순서를 보장하지 않는다. 용도에 따라 아래 구현체를 선택하자.
| 구현체 | 순서 | 내부 구조 | 특징 |
|---|---|---|---|
HashSet | 보장 X | HashMap | 가장 빠름 (평균 O(1)) |
LinkedHashSet | 삽입 순서 유지 | LinkedHashMap | HashSet + 연결 리스트 |
TreeSet | 정렬 순서 | TreeMap (레드-블랙 트리) | O(log n), Comparable/Comparator 필요 |
List<String> data = List.of("banana", "apple", "cherry", "date", "elderberry");

System.out.println(new HashSet<>(data));       // [banana, date, apple, cherry, elderberry]  (순서 보장 X)
System.out.println(new LinkedHashSet<>(data)); // [banana, apple, cherry, date, elderberry]  (삽입 순서)
System.out.println(new TreeSet<>(data));       // [apple, banana, cherry, date, elderberry]  (정렬)
HashSet의 출력 순서는 JVM 버전/내부 구현에 따라 달라질 수 있으니 순서에 의존하는 코드를 작성하면 안 된다.
7-3. 기타
null도 한 개 저장할 수 있다.HashSet은 thread-safe하지 않다. 멀티스레드 환경에서는Collections.synchronizedSet()이나ConcurrentHashMap.newKeySet()등을 고려하자.
8. 정리
- Hash Table: hash 값으로 index를 계산해 해당 버킷에 데이터를 저장하는 자료구조. 충돌이 나면 같은 버킷 안에 연결 리스트(또는 트리)로 저장한다.
- Set: 순서가 없고 중복을 허용하지 않는 자료구조. 중복 체크는 Set이 내부적으로 해준다.
- HashSet: 내부적으로
HashMap을 사용하며, 요소를 key로 저장한다. - 중복 검사 과정:
hashCode()로 버킷을 찾고 → 그 버킷 안에서equals()로 동등성 비교. - 그래서 직접 만든 클래스를
HashSet에 넣으려면equals()와hashCode()를 함께 오버라이딩해야 하고, hash 계산에 쓰이는 필드는 저장 후 변경하지 않는 것이 안전하다.
📎 전체 예제 코드
Person.java- equals/hashCode를 오버라이딩한 클래스NoOverridePerson.java- 오버라이딩하지 않은 클래스 (비교용)HashSetExample.java- 기본 동작, 오버라이딩 유무 비교, 해시 충돌, 가변 객체 주의, Set 구현체별 순서 비교ListVsSetBenchmark.java-List.contains()vsHashSet.contains()성능 비교
📚 참고
- Java SE API 문서 -
java.util.HashSet,java.util.HashMap,Object#hashCode(),Object#equals() - Effective Java - Item 10 (equals 규약), Item 11 (equals를 재정의하려거든 hashCode도 재정의하라)
