[데이터마이닝] 재난문자 유형별 분류 프로젝트
2024년 1학기 서울과학기술대학교 산업정보시스템전공 데이터마이닝 팀 프로젝트
사용 언어
python
목차
목차
1. 배경 및 필요성
과도한 양의 재난문자로 인해 시민들의 피로도가 증가하고, 재난문자에 대한 신뢰도가 하락했다. 일부 시민들은 아예 재난문자 수신 기능을 해제해 놓기도 한다.
2. 분석 목적
수신자가 원하는 유형의 재난문자만 받아볼 수 있게 하기 위해, 재난문자를 각 유형별로 분류하는 것을 목적으로 한다.
3. 사용 데이터 및 획득 방법
행정안전부에서 제공하는 서울시 구청 재난문자 발송 현황 데이터를 활용했다. 공공데이터포털에서 획득했으며, 2020년 1월 ~ 2021년 1월 데이터, 2021년 2월 ~ 2021년 12월 데이터, 2022년 1월 ~ 2023년 8월 데이터 3개의 파일을 합쳐서 하나의 데이터프레임으로 만들었다.
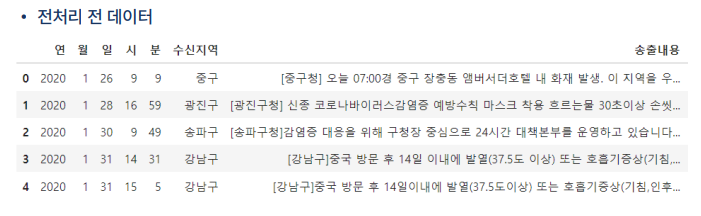
4. 분석 과정
4.1 데이터 전처리
4.1.1 토큰화 및 불용어 제거
- Okt 형태소 분석기를 사용하여 문장을 토큰화하고 각 토큰에 품사를 붙여 추출.
- 한글 불용어 사전을 이용하여 불용어를 제거.
# 한글 불용어 사전 파일 경로
stopwords_path = '/content/drive/MyDrive/데이터마이닝/stopwords-ko.txt'

# 파일 읽기
with open(stopwords_path, "r", encoding="utf-8") as file:
    stopwords = file.readlines()

# 각 불용어의 좌우 공백과 개행문자 제거
stopwords = [word.strip() for word in stopwords]
# 추가 불용어
stopwords.extend(['[', ']'])
print(stopwords)

```python
# Okt 형태소 분석기 생성
okt = Okt()

# 특수 단어 리스트 정의
special_words = ['확진자', '서울의료원']

# 텍스트 전처리 함수 정의
def preprocess_text_korean(text):
    # 특수 문자 제거
    text = re.sub(r'[^ㄱ-ㅎㅏ-ㅣ가-힣\s]', '', text)

    # 형태소 분석 및 불용어 제거
    tokens = okt.pos(text, stem=True)

    # 명사와 동사/형용사만 남기기 및 불용어 제거
    tokens = [word for word, pos in tokens if pos in ['Noun', 'Verb', 'Adjective'] and word not in stopwords]

    # 특정 단어들을 하나의 토큰으로 결합
    for special_word in special_words:
        while special_word in tokens:
            index = tokens.index(special_word)
            tokens[index:index + len(special_word)] = [special_word]

    # 토큰을 다시 문자열로 합침
    preprocessed_text = ' '.join(tokens)
    return preprocessed_text

# '송출내용' 열에 전처리 적용
df['preprocessed_송출내용'] = df['송출내용'].apply(preprocess_text_korean)

# 변경된 내용을 확인하기 위해 데이터프레임의 처음 몇 행 출력
df[['송출내용', 'preprocessed_송출내용']].head(10)

# 전처리된 송출내용만 남긴 데이터프레임: new_df
new_df = df.drop(columns=['송출내용'])
new_df.head()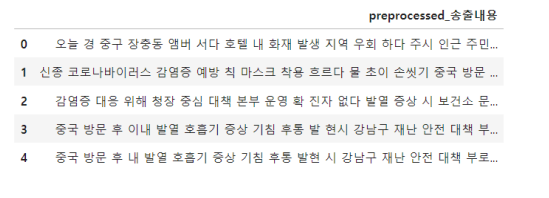
4.1.2 TF-IDF 벡터화
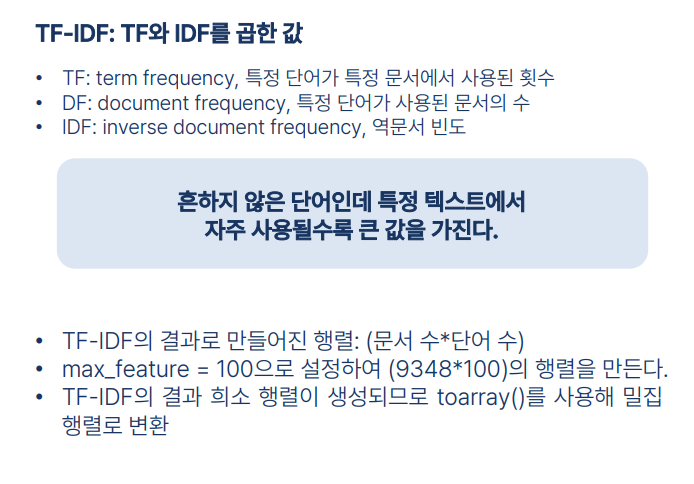
- TF-IDF (Term Frequency-Inverse Document Frequency) 기법을 사용하여 텍스트 데이터를 벡터화.
- 특정 단어가 문서에서 자주 사용될수록 높은 값을 가지며, 자주 등장하지 않는 단어는 낮은 값을 가짐.
- 최대 특징 수를 100으로 설정하여 (9348 * 100) 행렬을 생성하고, 희소 행렬을 밀집 행렬로 변환.
# TF-IDF 벡터라이저 생성

from sklearn.feature_extraction.text import TfidfVectorizer

vectorizer = TfidfVectorizer(max_features=100)  # max_features는 필요에 따라 조정 가능

# 텍스트 데이터를 학습 및 변환
tfidf_matrix = vectorizer.fit_transform(new_df['preprocessed_송출내용'])

# 결과 매트릭스의 형태 출력
print(tfidf_matrix.shape)
tfidf_matrix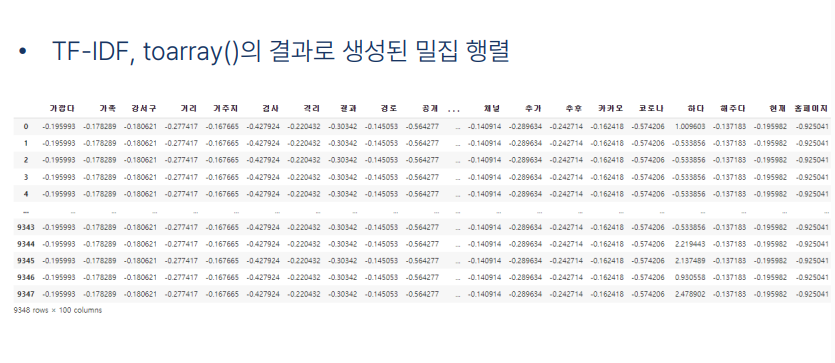
4.1.3 데이터 라벨링
- 클러스터링 알고리즘을 사용하여 데이터를 라벨링.
4.2 Clustering
4.2.1 DBSCAN을 통한 클러스터링 진행
- hyperparameter: eps는 0.01 ~ 10, min_samples는 5 ~ 60까지 바꾸면서 클러스터링을 진행했다.
import pandas as pd
from sklearn.cluster import DBSCAN
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.decomposition import PCA

# 2. DBSCAN 클러스터링 수행
# DBSCAN 파라미터 설정 (eps와 min_samples는 데이터에 따라 조정 필요)
dbscan = DBSCAN(eps=0.1, min_samples=55)
cluster_labels = dbscan.fit_predict(scaled_tfidf)

# 클러스터링 결과를 데이터프레임에 추가
df['cluster'] = cluster_labels

# 클러스터 수 및 각 클러스터에 속하는 포인트 수 확인
num_clusters = len(set(cluster_labels)) - (1 if -1 in cluster_labels else 0)
print(f'Number of clusters: {num_clusters}')
cluster_counts = pd.Series(cluster_labels).value_counts()
print(cluster_counts)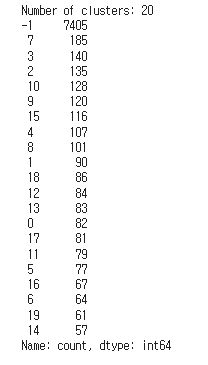
클러스터별 주요 키워드 추출 및 출력
def get_top_keywords(data, clusters, vectorizer, top_n=10):
    cluster_keywords = {}
    for cluster in np.unique(clusters):
        if cluster == -1:  # 노이즈 클러스터는 무시
            continue
        # 클러스터에 속한 문서들 추출
        cluster_data = data[clusters == cluster]
        # 클러스터 중심 벡터 계산 (평균)
        centroid = cluster_data.mean(axis=0)
        # 상위 top_n 키워드 추출
        keywords = [vectorizer.get_feature_names_out()[i] for i in centroid.argsort()[-top_n:]]
        cluster_keywords[cluster] = keywords
    return cluster_keywords

# 주요 키워드 추출
top_keywords = get_top_keywords(scaled_tfidf, cluster_labels, vectorizer, top_n=10)

# 주요 키워드 출력
for cluster, keywords in top_keywords.items():
    print(f"Cluster {cluster}: {', '.join(keywords)}")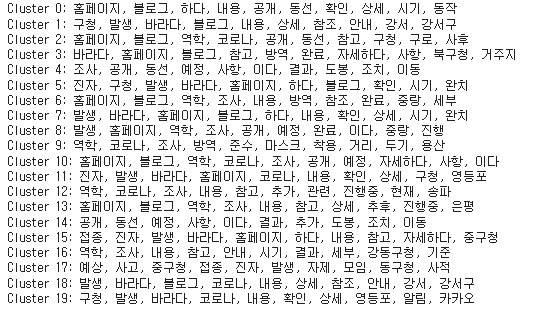
T-SNE로 시각화
from sklearn.manifold import TSNE

# TSNE를 사용하여 2차원으로 축소
tsne = TSNE(n_components=2, random_state=42)
tsne_results = tsne.fit_transform(scaled_tfidf)

# TSNE 결과를 시각화
plt.figure(figsize=(10, 6))
plt.scatter(tsne_results[:, 0], tsne_results[:, 1], c=cluster_labels, cmap='viridis', marker='o')
plt.title('Hierarchical Clustering on TSNE-reduced TF-IDF')
plt.xlabel('TSNE Component 1')
plt.ylabel('TSNE Component 2')
plt.grid(True)
plt.show()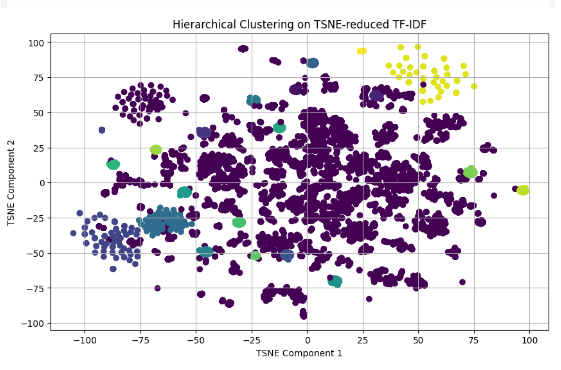
비슷한 클러스터끼리 병합
Cluster 0, 1, 2, 3:
공통적으로 '홈페이지', '블로그', '발생', '내용', '확인', '구청', '상세' 등으로 일반적인 정보를 나타냄.
라벨: 0 할당.
Cluster 5, 6, 7, 11, 12, 13:
공통적으로 '홈페이지', '블로그', '역학', '조사', '방역', '참조', '완료', '세부' 등으로 역학 조사 클러스터.
라벨: 1 할당.
Cluster 18, 19:
공통적으로 '발생', '바라다', '블로그', '코로나', '내용', '상세', '참조', '안내', '강서', '강서구' 등으로 코로나 관련 공지 클러스터.
라벨: 2 할당.
Cluster 4, 8, 10, 14, 15:
공통적으로 '공개', '동선', '예정', '사항' 등의 키워드로 공개된 이동 경로와 일정.
이동 경로 및 일정 공지 클러스터.
라벨: 3 할당.
Cluster 9, 16:
공통적으로 '역학', '코로나', '조사', '방역', '준수', '마스크' 등의 키워드로 역학 조사 및 방역 조치.
방역 조치 및 마스크 클러스터.
라벨: 4 할당.
Cluster 17:
'사고', '중구청', '접종', '모임', '사적' 등의 키워드로 사고 및 예방 조치.
사적 모임 자제 클러스터.
라벨: 5 할당.
병합
# 클러스터 재할당을 위한 매핑 딕셔너리

cluster_mapping = {
    0: 0, 1: 0, 2: 0, 3: 0,  # 일반적인 정보 클러스터
    5: 1, 6: 1, 7: 1, 11: 1, 12: 1, 13: 1,  # 역학 조사 클러스터
    18: 2, 19: 2,  # 코로나 관련 공지 클러스터
    4: 3, 8: 3, 10: 3, 14: 3, 15: 3,  # 이동 경로 및 일정 공지 클러스터
    9: 4, 16: 4,  # 방역 조치 및 마스크 클러스터
    17: 5,  # 사고 및 예방 조치 클러스터
    -1: -1  # 노이즈 클러스터 (제외)
}

# 클러스터 재할당
df['merged_cluster'] = df['cluster'].map(cluster_mapping)

# -1(noise) 제외한 새로운 데이터프레임 생성
new_df = df[df['merged_cluster'] != -1][['preprocessed_송출내용', 'cluster', 'merged_cluster']]

# 결과 확인
new_df
# 클러스터 수 및 각 클러스터에 속하는 포인트 수 확인
num_clusters = len(set(df['merged_cluster'])) - (1 if -1 in df['merged_cluster'].values else 0)
print(f'Number of clusters: {num_clusters}')
cluster_counts = df['merged_cluster'].value_counts()
print(cluster_counts)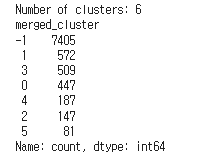
최종
| 클러스터명 | 내용 | 데이터 수 |
|---|---|---|
| 0 | 일반적인 정보 나타냄 ('홈페이지', '블로그', '발생', '내용', '확인', '구청', '상세') | 447 |
| 1 | 역학 조사 클러스터 ('홈페이지', '블로그', '역학', '조사', '방역', '참조', '완료', '세부') | 572 |
| 2 | 코로나 관련 공지 클러스터 ('발생', '바라다', '블로그', '코로나', '내용', '상세', '참조', '안내', '강서', '강서구') | 147 |
| 3 | 이동 경로 및 일정 공지 클러스터 ('공개', '동선', '예정', '사항') | 509 |
| 4 | 방역 조치 및 마스크 클러스터 ('역학', '코로나', '조사', '방역', '준수', '마스크') | 187 |
| 5 | 사적 모임 자제 클러스터 ('사고', '중구청', '접종', '모임', '사적') | 81 |
DBSCAN은 많은 데이터들을 -1, 즉 noise로 처리함을 확인했으며, 적절치 않은 clustering 결과를 확인했다.
4.2.2 k-means를 통한 클러스터링 진행
hyperparameter는 cluster 개수 -> [5,10,15,30], 중심 클러스터 선정방법(init_methods) -> ['k-means++', 'random']를 조정하여 탐색하였고, silhouette score를 참고하여 최적의 하이퍼파라미터를 선정하였다.
그 결과 20개의 cluster를 만들고 k-means++방법으로 중심 클러스터를 찾아 보았다.
# KMeans 모델 생성 및 학습
kmeans = KMeans(n_clusters=20, random_state=42)  # 클러스터 개수를 적절히 설정
kmeans.fit(scaled_tfidf)

#레이블 추출
kmeans_labels = kmeans.labels_

from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score

# 하이퍼파라미터 범위 설정
n_clusters_range = [5,10,15,20]
init_methods = ['k-means++', 'random']

# 최적의 파라미터를 저장할 변수 초기화
best_score = -1
best_params = {}

# 모든 하이퍼파라미터 조합을 탐색
for n_clusters in n_clusters_range:
    for init in init_methods:
                kmeans = KMeans(n_clusters=n_clusters, init=init, random_state=42)
                cluster_labels = kmeans.fit(scaled_tfidf)
                labels = kmeans.labels_
                centroids = kmeans.cluster_centers_
                score = silhouette_score(scaled_tfidf, labels)

                if score > best_score:
                    best_score = score
                    best_params = {
                        'n_clusters': n_clusters,
                        'init': init,
                    }

print("Best parameters found: ", best_params)
print("Best silhouette score: ", best_score)
Best parameters found: {'n_clusters': 20,'init': 'k-means++'}
Best silhouette score: 0.16555712518201277
T-SNE로 2차원 시각화
from sklearn.manifold import TSNE

# TSNE를 사용하여 2차원으로 축소
tsne = TSNE(n_components=2, perplexity=2, random_state=42)
tsne_results = tsne.fit_transform(scaled_tfidf)

# TSNE 결과를 시각화
plt.figure(figsize=(10, 6))
plt.scatter(tsne_results[:, 0], tsne_results[:, 1], c=kmeans_labels, cmap='Spectral', marker='o')
plt.title('K-Means Clustering on t-SNE-reduced Data')
plt.xlabel('t-SNE Component 1')
plt.ylabel('t-SNE Component 2')
plt.grid(True)
plt.show()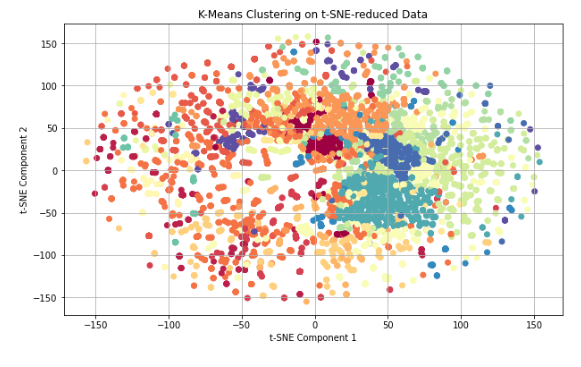
from sklearn.feature_extraction.text import TfidfVectorizer

texts = new_df['preprocessed_송출내용'].fillna('')
vectorizer = TfidfVectorizer(max_features=100)
vectored_df = vectorizer.fit_transform(texts)
dense_df = vectored_df.todense() #vectored_df는 희소행렬이기 때문에 dense 형태로 전환.
feature_names = vectorizer.get_feature_names_out()

keyword_df = pd.DataFrame(dense_df, columns=feature_names)

kmeans = KMeans(n_clusters=20, init='k-means++', random_state=42)
kmeans.fit(tfidf_dense)

centroids = kmeans.cluster_centers_

# 클러스터 중심을 데이터프레임으로 변환
centroids_df = pd.DataFrame(centroids, columns=keyword_df.columns)

# 각 클러스터의 주요 피처 확인
top_features = {}
for i, centroid in centroids_df.iterrows():
    top_features[i] = centroid.sort_values(ascending=False).head(10).index.tolist()

# 각 클러스터의 주요 피처가 문자열인지 확인하고, 그렇지 않은 경우 문자열로 변환
top_features_str = {cluster: [str(feature) for feature in features] for cluster, features in top_features.items()}

# 결과 출력
for cluster, features in top_features_str.items():
print(f"Cluster {cluster}: {', '.join(features)}")| 클러스터 | 내용 |
|---|---|
| Cluster 0 | 진자, 코로나, 발생, 신청, 검사, 하다, 관련, 격리, 입국, 자가 |
| Cluster 1 | 공개, 조사, 역학, 사항, 예정, 이다, 결과, 조치, 홈페이지, 진자 |
| Cluster 2 | 마스크, 착용, 거리, 준수, 두기, 방역, 진자, 바라다, 발생, 공개 |
| Cluster 3 | 시기, 확인, 완치, 하다, 블로그, 상세, 홈페이지, 내용, 바라다, 진자 |
| Cluster 4 | 이용자, 알림, 검사, 시간대, 동선, 확인, 관내, 진자, 바람, 보건소 |
| Cluster 5 | 참고, 내용, 진자, 자세하다, 홈페이지, 바라다, 발생, 조사, 역학, 결과 |
| Cluster 6 | 하다, 안전, 유의, 되다, 바라다, 예상, 사고, 지역, 자제, 이용 |
| Cluster 7 | 운영, 시선, 검사, 진료, 보건소, 되다, 하다, 주말, 구청, 드리다 |
| Cluster 8 | 격리, 이송, 방역, 소독, 완료, 진자, 발생, 동선, 은평, 채널 |
| Cluster 9 | 사후, 구청, 공개, 동선, 참고, 역학, 홈페이지, 블로그, 발생, 진자 |
| Cluster 10 | 모임, 사적, 자제, 금지, 준수, 발생, 진자, 방역, 내용, 바라다 |
| Cluster 11 | 거주지, 완료, 사항, 방역, 참고, 자세하다, 블로그, 홈페이지, 바라다, 발생 |
| Cluster 12 | 안내, 참조, 블로그, 강서구, 상세, 진자, 발생, 내용, 양천구, 바라다 |
| Cluster 13 | 참조, 완료, 세부, 조사, 역학, 진자, 홈페이지, 내용, 바라다, 블로그 |
| Cluster 14 | 받다, 검사, 진료, 가깝다, 방문자, 바라다, 방문, 증상, 코로나, 보건소 |
| Cluster 15 | 진행중, 현재, 참고, 추가, 조사, 역학, 내용, 홈페이지, 관련, 코로나 |
| Cluster 16 | 확인, 상세, 구청, 코로나, 내용, 진자, 발생, 홈페이지, 바라다, 알림 |
| Cluster 17 | 접종, 예약, 코로나, 센터, 신청, 주민, 오늘, 방문, 되다, 하다 |
| Cluster 18 | 진행, 이다, 예정, 조사, 역학, 공개, 추후, 홈페이지, 완료, 발생 |
| Cluster 19 | 방문자, 검사, 보건소, 바라다, 받다, 코로나, 소독, 주말, 증상, 완료 |
silhouette score = 0.16으로 높지 않았고, 직접 확인 하였을 때도 모든 cluster가 코로나 관련 내용으로 뭉쳐있으므로 주제에 적합한 cluster 모델은 아니라고 판단했다.
4.2.3 계층적 클러스터링을 활용한 데이터 라벨링
앞의 두 클러스터링 알고리즘이 적절한 결과를 내지 못해서, Agglomerative Clustering 알고리즘을 사용했다.
덴드로그램을 그린 후 높이 150에서 군집화하여 총 19개의 클러스터로 만들었다. 그 후 유사한 클러스터끼리 병합하여 총 8개의 클러스터로 만들었다.
- 계층적 클러스터링을 통해 데이터를 다음 8종류의 라벨로 라벨링했다.
import matplotlib.pyplot as plt
from scipy.cluster.hierarchy import dendrogram, linkage, fcluster

# 덴드로그램 시각화 (계층적 클러스터링)
linked = linkage(scaled_tfidf, method='ward')

plt.figure(figsize=(15, 10))
dendrogram(linked, orientation='top', distance_sort='ascending', show_leaf_counts=True, color_threshold=150)
plt.title('Dendrogram')
plt.xlabel('Samples')
plt.ylabel('Distance')
plt.grid(True)
plt.show()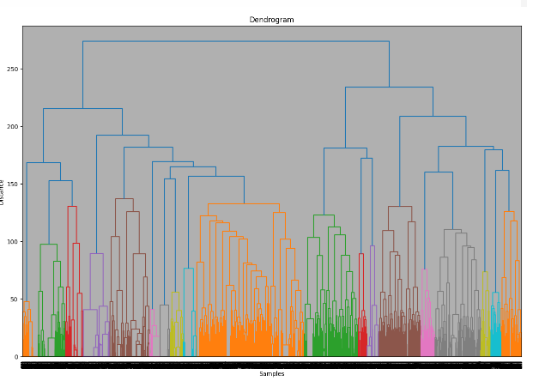
from sklearn.cluster import AgglomerativeClustering
# 덴드로그램에서 클러스터를 잘라내기 위해 특정 높이 설정
color_threshold = 150  # 이 값을 적절히 설정하여 클러스터 수를 조절
clusters = fcluster(linked, color_threshold, criterion='distance')

# 결정한 클러스터 수 출력
num_clusters = len(set(clusters))
print(f'Number of clusters determined from dendrogram: {num_clusters}')

# Agglomerative Clustering 수행
hierarchical = AgglomerativeClustering(n_clusters=num_clusters, affinity='euclidean', linkage='ward')
cluster_labels = hierarchical.fit_predict(scaled_tfidf)
new_df['cluster'] = cluster_labels

# 클러스터링 결과 확인
print(new_df[['preprocessed_송출내용', 'cluster']].head(10))

# 클러스터 수 및 각 클러스터에 속하는 포인트 수 확인
print(f'Number of clusters: {num_clusters}')
cluster_counts = pd.Series(cluster_labels).value_counts()
print(cluster_counts)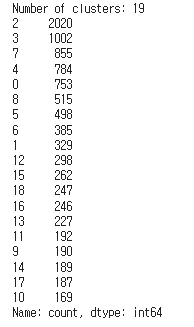
TSNE 시각화
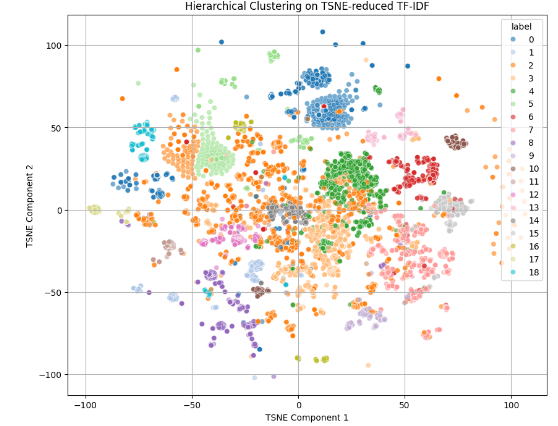
비슷한 클러스터끼리 병합
2, 3번 병합(추후 다시 클러스터링 필요) -> 23번으로 병합
1, 8, 12, 17번 병합 -> 117번으로 병합
5, 16번 병합 -> 516번으로 병합
7, 9번 병합 -> 79번으로 병합
2, 3번 병합: 확진자 발생 안내+일반 기상상황 혼합
new_df['merged_cluster'] = new_df['cluster']
클러스터 2와 3을 병합하여 새로운 클러스터 20으로 지정
new_df.loc[new_df['cluster'].isin([2, 3]), 'merged_cluster'] = 20
1, 5, 8, 12, 16, 17, 18번 병합: 역학조사
클러스터 1, 8, 12, 17번을 병합하여 새로운 클러스터 21번으로 지정
new_df.loc[new_df['cluster'].isin([1, 5, 8, 12, 16, 17, 18]), 'merged_cluster'] = 21
7, 9번 병합: 코로나검사 권장
클러스터 7, 9번을 병합하여 새로운 클러스터 23번으로 지정
new_df.loc[new_df['cluster'].isin([7, 9]), 'merged_cluster'] = 23
10, 11, 13, 14번 병합: 방역
클러스터 10, 13번을 병합하여 새로운 클러스터 24번으로 지정
new_df.loc[new_df['cluster'].isin([10, 11, 13, 14]), 'merged_cluster'] = 24
결과 확인
new_df
1차 병합된 데이터프레임: new_df에서 병합 전 클러스터 컬럼 제거, 클러스터명 순으로 정렬 -> new_df2 클러스터명 순으로 정렬 후 클러스터명 0부터 다시 지정
new_df2 = new_df.drop(columns=['cluster']).sort_values(by='merged_cluster')
print(new_df2['merged_cluster'].value_counts())
클러스터명 재할당
new_df2['merged_cluster'] = pd.factorize(new_df2['merged_cluster'])[0]
print(new_df2['merged_cluster'].value_counts())
new_df2
merged_cluster
20 3022
21 2320
23 1045
4 784
24 777
0 753
6 385
15 262
Name: count, dtype: int64
merged_cluster
4 3022
5 2320
6 1045
1 784
7 777
0 753
2 385
3 262
Name: count, dtype: int64
유사한 것끼리 병합 후
클러스터명 | 데이터 수 | 내용
0 753 확진자 발생안내
1 784 기상
2 385 백신, 교통, 확진자발생
3 262 임시선별소
4 3022 확진자 발생, 기상
5 2320 역학조사
6 1045 검사 권장
7 777 방역
new_df2 = new_df2.sort_index().rename(columns={'merged_cluster': 'label'})
new_df2 # 라벨링한 데이터프레임
최종
| 클러스터명 | 내용 |
|---|---|
| 0 | 확진자 발생안내 |
| 1 | 기상 관련 |
| 2 | 백신, 교통, 확진자발생 |
| 3 | 전염병 임시선별소 관련 |
| 4 | 확진자 발생, 기상 관련 |
| 5 | 역학조사 |
| 6 | 전염병 검사 권장 |
| 7 | 방역 관련 |
2번, 4번 클러스터의 경우 유형이 완벽하게 나누어지지 않는 문제가 있었다.
4.3 재난문자 유형별 분류
4.3.1 사용 모델
- 분류 모델은 SVM, XGBoost, Random Forest, Catboost를 사용했다.
4.3.2 SVM
- 최적 hyperparameter
| C | gamma |
|---|---|
| 50 | 0.1 |
| SVM 모델 성능 | |
|---|---|
| train accuracy | 0.927 |
| valid accuracy | 0.839 |
4.3.3 Random Forest
- 최적 hyperparameter
| max_depth | max_features | min_samples_leaf | min_samples_split | n_estimators |
|---|---|---|---|---|
| 20 | auto | 1 | 5 | 300 |
| Random Forest 모델 성능 | |
|---|---|
| train accuracy | 0.923 |
| valid accuracy | 0.834 |
4.3.4 XGBoost
- 최적 hyperparameter
| max_depth | learning_rate | colsample_bytree | subsample | n_estimators |
|---|---|---|---|---|
| 7 | 0.05 | 1 | 0.6 | 300 |
| XGBoost 모델 성능 | |
|---|---|
| train accuracy | 0.923 |
| valid accuracy | 0.828 |
4.3.5 Catboost
- 최적 hyperparameter
| depth | learning_rate | l2_leaf_reg | iterations |
|---|---|---|---|
| 10 | 0.05 | 1 | 500 |
| CatBoost 모델 성능 | |
|---|---|
| train accuracy | 0.919 |
| valid accuracy | 0.833 |
4.3.6 최적 모델 선정
-
선정된 최적 모델의 학습을 위해 train 데이터와 valid 데이터를 병합: X_train_final, y_train_final
-
X_train_final, y_train_final으로 교차검증 진행
| model | cross-validation score(cv=5) |
|---|---|
| SVM | 0.848 |
| Random Forest | 0.843 |
| XGBoost | 0.840 |
| CatBoost | 0.846 |
각각의 최적 하이퍼파라미터 모델에서의 정확도와 X_train_final, y_train_final로 진행한 교차검증 모두 SVM이 가장 좋은 성능을 보였다. → SVM을 최적 모델로 선정
4.4 재난문자 유형별 분류 - 분석 결과
- 최적 모델을 test data로 평가했다. 결과는 다음과 같다.
| cluster | precision | recall | f1-score | support |
|---|---|---|---|---|
| 0(확진자 발생) | 0.91 | 0.95 | 0.93 | 143 |
| 1(기상 관련) | 0.68 | 0.79 | 0.73 | 157 |
| 2(백신, 교통, 확진자발생) | 0.6 | 0.65 | 0.62 | 77 |
| 3(임시선별소) | 0.68 | 0.67 | 0.67 | 57 |
| 4(확진자 발생, 기상 관련) | 0.82 | 0.81 | 0.82 | 596 |
| 5(역학조사) | 0.97 | 0.95 | 0.96 | 470 |
| 6(전염병 검사 권장) | 0.91 | 0.85 | 0.88 | 198 |
| 7(방역) | 0.86 | 0.8 | 0.83 | 172 |
| accuracy | 0.849 | 1870 |
- 2번, 4번 클러스터는 라벨링 과정에서 깔끔하게 분리되지 않은 혼합된 클러스터이다.
- 2번과 3번 클러스터는 precision과 recall이 모두 낮아 성능 개선이 필요하다.
- 전체 클래스 중 성능이 좋지 않은 2, 3번 클래스의 데이터는 각각 384개, 262개로 다른 클래스에 비해 적은 수이다. 따라서 불균형 데이터셋이 모델의 분류 성능에 부정적인 영향을 주었을 가능성이 높다.
- 전체적인 정확도의 경우, 최적 모델로 선정된 SVM 외의 다른 모델에서도 약 0.84의 비슷한 성능을 보였다.
5. 한계점 및 개선 방안
한계점
- 라벨링을 위한 클러스터링 과정에서 데이터가 완벽하게 분류되지 못함.
- 전염병 관련 문자의 양이 매우 많아 일반 기상 경보 관련 문자들을 잘 분류하지 못함(TF-IDF로 벡터화 시킬 때 전염병 문자 관련 단어들만 feature로 선정되는 문제 존재)
개선 방안
- 서로 다른 유형의 문자에 자주 등장하는 단어가 한 문자에 동시에 존재할 수 있으므로, 문장의 맥락 파악이 필요 → 딥러닝 기반 모델의 사용
- 데이터의 특성 상(2020년~2023년 데이터, 펜데믹) 전염병 유형 문자의 수가 다른 유형의 문자보다 매우 많음 → 데이터 수집 확대 및 텍스트 데이터 증강(SR, RI, RS, RD, Back Translation)