[Paper Review] - Unlocking the Power of Patch: Patch-Based MLP for Long-Term Time Series Forecasting(AAAI, 2025)
[Paper Review]
목록 보기
4/4
[Main contribution]
- 장기 시계열 예측 문제에서 MLP에 Patching을 적용한 PatchMLP라는 새로운 모델을 제안
- Transformer가 장기 시계열 예측(Long-Term Time Series Forecasting, LTSF) 과제의 해법이 될 수 있는지 회의적.
- 패치 메커니즘을 적용한 간단한 선형 계층(linear layer)이 복잡한 Transformer 기반 LTSF 모델을 능가할 수도 있음을 시사.
- 다중 스케일 패치 임베딩(Multi-Scale Patch Embedding, MPE) 방식 제안: 단일 스케일이 아닌 다양한 크기의 패치를 활용
- 짧은 길이의 패치를 통해 국소적 패턴 포착
- 긴 길이의 패치는 계절성, 추세 같은 장기 패턴을 포착
- 서로 다른 스케일의 패치를 함께 사용하면, 다양한 기간 길이에 걸친 대표 특징을 유연하게 학습할 수 있어 예측 정확도와 일반화 능력이 향상
- 저자는 원본 시계열에 내재된 지나치게 복잡한 시간적 관계가 단순한 분해 기술로는 효과적인 결과를 얻을 수 없으며, Latent Vector Decomposition으로 이러한 문제를 우회할 수 있다고 주장
[Patch]
- 패치는 데이터를 압축하고 입력 차원을 줄이며 중복 특징을 감소시킴.
- 또한 패치는 일종의 스무딩 효과를 제공하여 이상치(outlier)의 영향을 어느 정도 줄이고, 시계열의 불규칙한 변동과 랜덤 노이즈를 걸러내면서 더 안정적이고 대표적인 정보를 유지할 수 있음.
cf) 채널 믹싱(같은 시점에 측정된 각 변수의 값을 하나의 벡터) x , 채널 독립(각 변수별로 처리)이 더 효과적.
[PatchMLP]
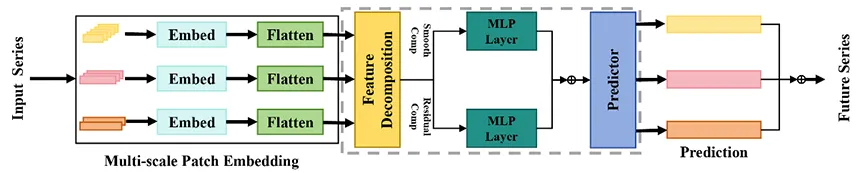
[Multi-Scale Patch Embedding]
- Patching
- 각 변수별로 원시 시계열을 서로 다른 길이의(스케일)의 패치를 만듬
- embedding
- 각 패치를 embedding 레이어를 통과시켜 고정 차원 D의 벡터로 변환
- 이 과정에서 패치 내 시간축 정보가 압축되어, 패치 하나당 하나의 임베딩 벡터가 생성
- flatten & concat
- 임베딩된 D차원의 벡터를 1차원으로 flatten시켜 Token으로 만듬
- 한 변수 내 각 스케일의 토큰을 concat하여 하나의 긴 토큰 시퀀스를 만듬.
- Concat (변수 간)
- 변수 A의 긴 토큰 시퀀스, 변수 B의 긴 토큰 시퀀스, … 를 차례대로 concat하여
- 전체 변수에 걸친 하나의 긴 토큰 시퀀스 구성
[Feature Decomposition]
-
생성된 토큰 시퀀스에 대해 Average Pooling 연산을 수행하여 “스무딩된 추세(Smooth Component)”를 추출
- → 데이터의 변동과 노이즈를 줄임
- 스무딩 과정에서 시계열의 길이가 변하지 않도록 패딩(padding) 연산을 적용
-
잔차 성분 계산 (Residual Component)
- 원본 토큰 시퀀스에서 스무딩된 추세를 빼서 잔차 성분 계산
이렇게 하면
- Xs에는 “장기적 추세나 완만한 변화” 정보가 담기게 됨.
- Xr에는 “단기적 변동·노이즈” 정보가 담기게 됨.
-
두 경로 분기
- 이렇게 분해된 두 종류의 토큰(추세, 잔차)이 병렬로 준비되어,
- 스무딩된 추세 Xs는 “위쪽” MLP Layer 블록으로만 가고,
- 잔차 성분 Xr는 “아래쪽” MLP Layer 블록으로만 감.
[MLP Layer]
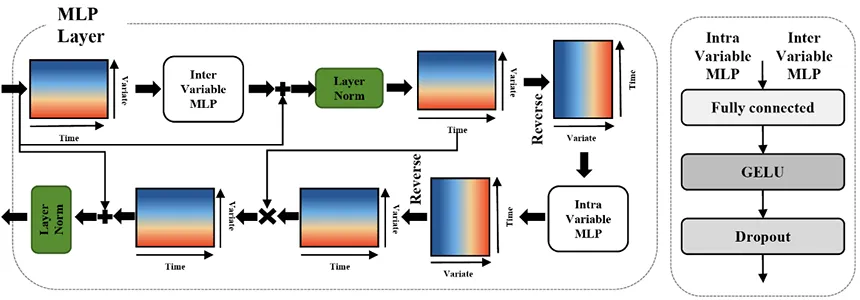
[Inter-Variable MLP]:
- fully connected layer - GELU - dropout 구조
- “한 시점에 걸친” 다변량 시계열(MTS) 변수들 간의 상호 영향을 모델링하는 것을 목표
- 한 시점에 걸친 모든 변수 값을 하나의 입력 벡터로 보고, 변수들 간의 상호작용을 학습하는 MLP 블록
[Intra-Variable MLP]:
-
fully connected layer - GELU - dropout 구조
-
단일 변수의 시간축 상관 패턴(추세·주기·의존성 등) 학습
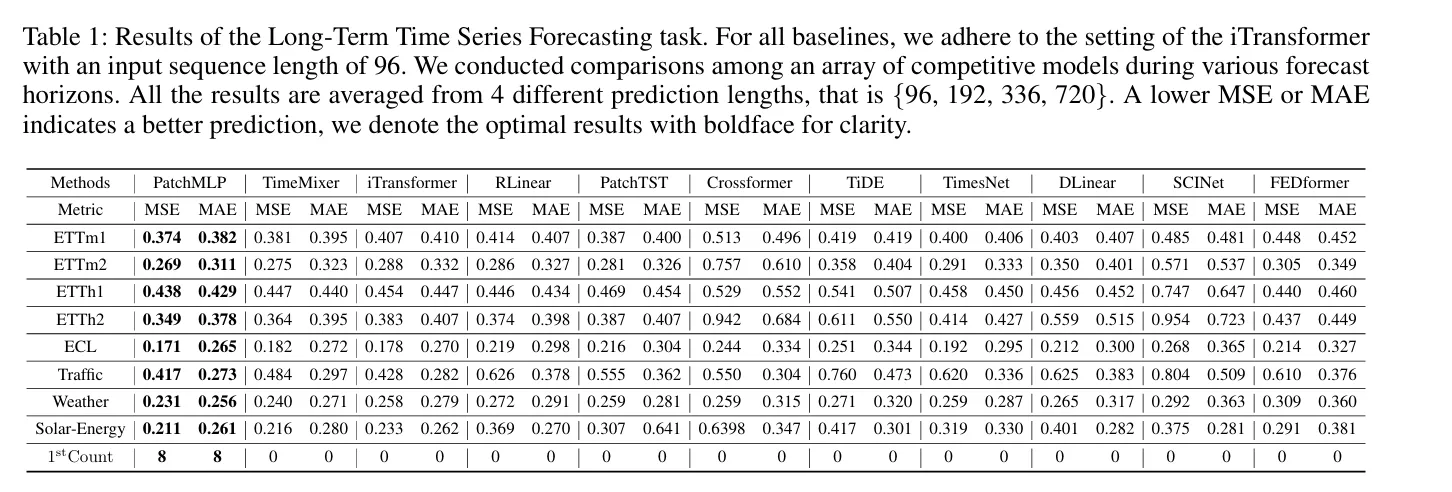
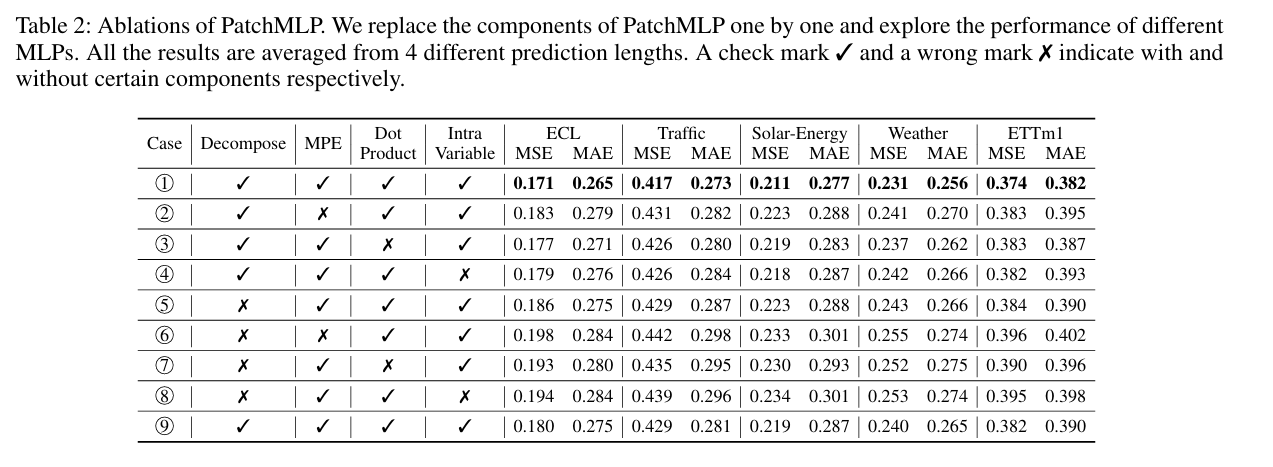
실험
Self supervised Learning, Time Series, Multimodal Learning