코스트코 A포맷 가격표의 OCR 결과를 구조화 데이터로 바꾸는 휴리스틱 파서를 Dart·Python·TypeScript로 구현하고, 세 언어 구현의 동작을 자동으로 일치시키는 방법을 정리한다. 코드는 전부 공개돼 있다(GitHub, MIT).
1. 문제 정의 — OCR을 올바른 포맷으로 해석하는 방법
가격표를 사진으로 찍어 OCR에 넣으면 나오는 건 "위치가 붙은 텍스트 조각들"이다. 어느 숫자가 최종가인지, 어느 게 단가인지, 이 태그가 할인 중인지, 6자리 품목번호가 어디 박혀 있는지는 OCR이 알려주지 않는다. 그 해석이 파서가 하는 일이다.
가격표 인식 파이프라인은 두 층으로 나뉜다.
[이미지] ──(OCR)──▶ OcrLine[] ──(파서)──▶ PriceTagData
          플랫폼 종속            순수 로직·이식 가능
          ML Kit / Tesseract / Vision   ← 이 글의 대상
OCR(인식) 층은 ML Kit, Tesseract, Apple Vision처럼 플랫폼·언어마다 다른 부품이라 이식되지 않는다. 파서(해석) 층은 이미지를 건드리지 않고 OCR 결과만 받아 구조화 데이터를 뱉는 순수 로직이라 어떤 언어로든 옮길 수 있다. 이 글은 파서만 다룬다.
두 층을 잇는 계약은 JSON 한 쌍이다. 입력 OcrLine(정규화된 바운딩 박스 + 텍스트), 출력 PriceTagData.
// 입력: OCR이 뱉는 한 줄 (좌표는 0~1 정규화, 원점 좌상단)
class OcrLine {
  final String text;
  final double x, yTop, w, h, conf;  // h = 글자 높이 (최종가 판정에 씀)
}

// 출력: 구조화된 가격표
class PriceTagData {
  final String schemaVersion;  // '0.1'
  final String? itemNumber;    // 6자리 품목번호
  final bool plusMark;         // 품목번호 옆 '+'
  final String? nameKo;        // 한글 제품명 (best-effort)
  final String? model;         // 모델명 (best-effort)
  final String? nameEn;        // 영문 제품명 (best-effort)
  final int? finalPrice;       // 최종가 (원)
  final TagType tagType;       // regular | discount | unknown
  final DiscountInfo? discount;   // { originalPrice, discountAmount, periodStart, periodEnd }
  final UnitPrice? unitPrice;     // { value, unit } — 단가 + 단위(개/100G…)
  final String rawText;        // 원본 OCR 전문 (재파싱·검수용)
}
좌표를 0~1로 정규화해 두는 게 핵심이다. OCR 엔진마다 픽셀 좌표계가 다르지만, 정규화하면 파서는 해상도·엔진과 무관해진다.
2. 파서 휴리스틱 — 표준 포맷(A포맷)의 시각 문법을 규칙으로
코스트코 표준 포맷 매대카드에는 일관된 시각 규칙이 있다. 파서는 이 규칙을 그대로 인코딩한다.
이 포맷을 "A포맷" 이라고 부르자!
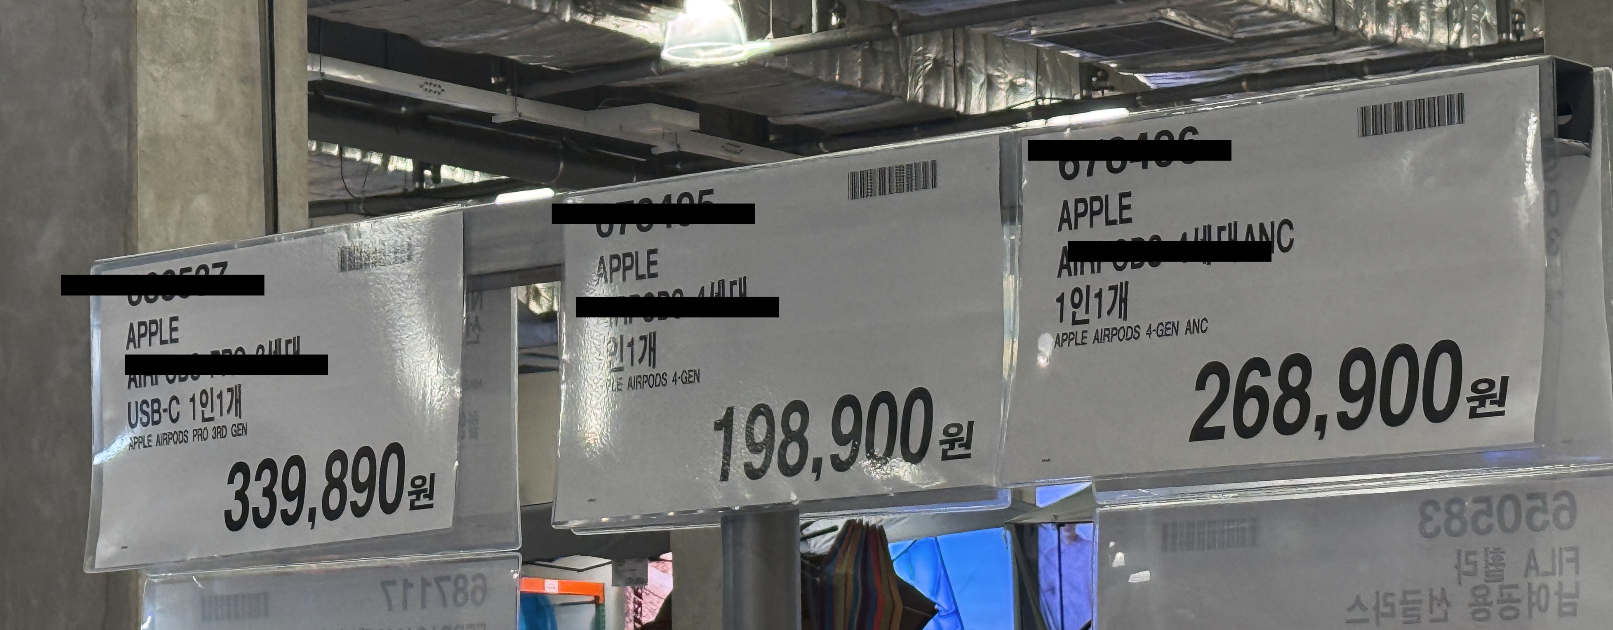
*사진은 혹시몰라서 다 가려둠
품목번호 — 6자리 단독 줄 우선. 매칭 전에 줄 안의 공백을 지운 뒤(그래서 123 456도 6자리 후보가 된다), 6자리 숫자"만" 있는 줄을 최우선으로, 없으면 경계를 둔 6자리를 쓴다. 경계 (?<!\d)…(?!\d)가 바코드나 ITEM: 3663092 같은 긴 숫자열 속 6자리를 오식하지 않게 막는다.
final _pureItemRe = RegExp(r'^(\d{6})(\+?)$');            // 6자리만 있는 줄
final _itemRe     = RegExp(r'(?<!\d)(\d{6})(?!\d)(\+?)'); // 경계를 둔 6자리
후보가 여럿이면 읽기 순서(위→아래, 같으면 왼→오)로 첫 번째를 택한다. 이 정렬의 보조키 x가 뒤에서 중요해진다(4장).
최종가 — 글자가 가장 큰 가격. A포맷에서 최종가는 물리적으로 가장 크게 인쇄된다(정가·단가는 항상 작다). 그래서 "가격 토큰 중 바운딩 박스 높이 h가 최대인 것"을 최종가로 잡는다.
final _priceRe = RegExp(r'(\d[\d,]{2,})\s*원');
// … 가격 토큰들 중 글자 높이(h)가 가장 큰 것 = 최종가
_PT? finalTok;
for (final p in pts) {
  if (finalTok == null || p.h > finalTok.h) finalTok = p;
}원이 붙은 토큰이 1순위 가격 후보지만, OCR이 원을 떼어내 콤마 숫자만 남은 경우도 후보로 삼는다. 이때 함정이 하나 있다 — 1,584g(무게)나 2,142kcal(열량)이 가격보다 크게 인쇄되기도 해서, 그냥 두면 최종가로 뽑힌다. 그래서 콤마 숫자 뒤에 g/kg/mg/ml/l/kcal이 오면 후보에서 뺀다.
final _weightUnitRe = RegExp(r'^\s*(?:kcal|kg|mg|ml|g|l)', caseSensitive: false);할인 · 단가 · 날짜. 할인행사 라벨이 있으면 discount 타입으로 보고, 최종가보다 큰 가격을 정가로, 그 차액을 할인액으로 계산한다. 단가는 단가 / <단위> 라벨에 세로로 가장 가까운 가격이다(최종가 토큰은 제외). 날짜는 범위를 벗어난 값(월 > 12, 일 > 31 등)을 버린다 — 다만 월별 일수까지는 보지 않아 2026.02.31은 통과한다.
final _unitRe = RegExp(r'단가\s*/\s*([^\s]+)');
// 날짜: 달력 범위 밖이면 null 처리 (OCR이 날짜를 자주 뭉갠다)
String? _isoDate(int y, int mo, int d) {
  if (y < 2000 || y > 2099 || mo < 1 || mo > 12 || d < 1 || d > 31) return null;
  return '$y-${_pad(mo)}-${_pad(d)}';
}
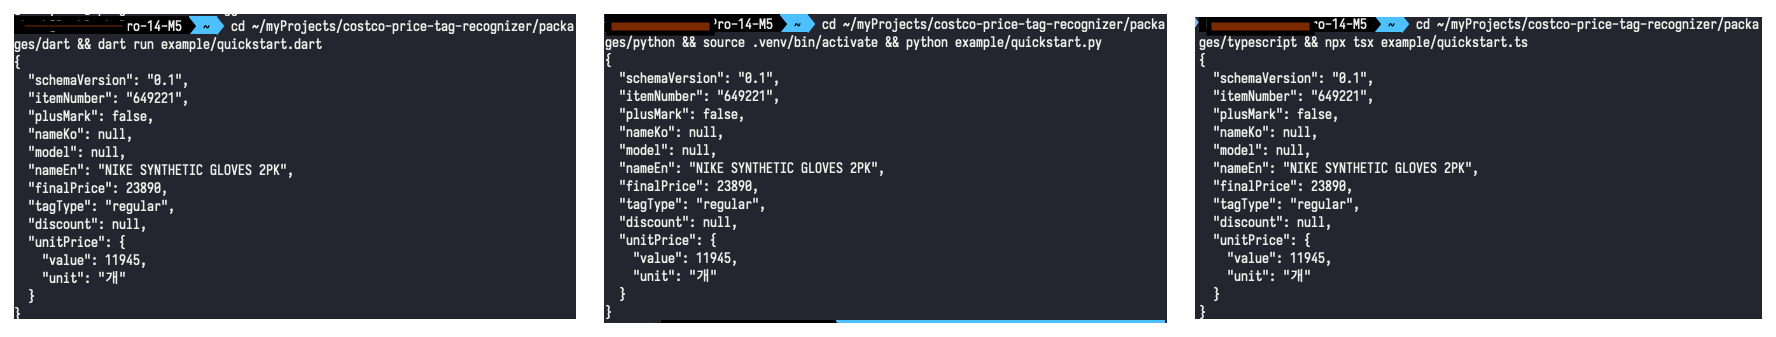
결과는 이렇게 나온다.
// 일반 태그 (NIKE 합성장갑)
{ "itemNumber": "649221", "finalPrice": 23890, "tagType": "regular",
  "unitPrice": { "value": 11945, "unit": "개" } }

// 할인 태그
{ "itemNumber": "685246", "plusMark": true, "finalPrice": 349900, "tagType": "discount",
  "discount": { "originalPrice": 389900, "discountAmount": 40000,
                "periodStart": null, "periodEnd": null } }
3. 여러 언어로 이식하기
같은 파서 로직을 Dart, Python, TypeScript에 각각 손으로 옮기면 처음엔 같아 보여도 갈라진다. 정규식 하나, 정렬 하나, 문자열 처리 하나가 언어마다 미세하게 다르게 동작하기 때문이다. 이걸 자동으로 잡는 방법이 골든 오라클이다.
① 한 언어를 정본(canonical)으로 못박는다. 여기선 Dart가 정본이다.
② 정본 출력을 골든으로 동결한다. 정본 파서를 실사진 46장 전부에 돌려 그 출력을 정답 파일(spec/golden/expected.json)로 저장한다.
// gen_golden.dart — 정본 Dart 파서 출력을 모든 픽스처에 대해 동결
for (final fn in data.keys.toList()..sort()) {
  final lines = (data[fn] as List).map(OcrLine.fromJson).toList();
  out[fn] = parsePriceTag(lines).toJson()..remove('rawText'); // rawText는 pass-through라 제외
}
// → spec/golden/expected.json 에 46장 기대출력 기록
③ 나머지 언어를 같은 골든에 적합성 테스트한다. Python·TypeScript 포트는 각자의 스위트에서 같은 46장을 파싱해 같은 골든과 대조한다. 세 언어가 한 정답지를 공유하는 구조다.
# 세 언어 모두 동일한 골격 — 같은 픽스처, 같은 골든
@pytest.mark.parametrize("fn", sorted(FIXTURES.keys()))
def test_golden_parity(fn):
    got = _parse(fn).to_dict()
    got.pop("rawText")
    assert got == GOLDEN[fn], f"drift from frozen golden for {fn}"
④ CI가 검증한다. GitHub Actions가 main 푸시와 모든 PR마다 세 언어 스위트를 3-job으로 돌린다. 한 언어라도 골든에서 벗어나면 빨간불이 뜬다.
중요 — 골든은 "동작"을 고정하지 "정답"을 보장하지 않는다. 그래서 스위트는 두 종류를 구분한다.
| 그룹 | 범위 | 보장하는 것 |
|---|---|---|
| ground truth | 3장 (사람이 실물 검증) | 실세계 정확성 |
| golden parity | 나머지 43장 | 동작 일치("정본과 같다"일 뿐) |
정본이 틀리면 골든도 틀린 채로 잠긴다. parity는 "세 언어가 똑같다"는 증명이지 "옳다"는 증명이 아니다. 이 구분을 spec/CONFORMANCE.md에 명시해 둔다.
4. 언어 간 이식 함정 3가지
골든 파리티가 46장에서 초록불이어도, 그 46장이 밟지 않는 입력에서 세 언어가 갈릴 수 있다. 다언어 포팅에서 반복되는 함정 셋과 방어를 정리한다. 각 함정은 실사진이 우연히 안 밟기 때문에, 사람이 만든 합성 트랩 테스트로 세 언어에 똑같이 물려 고정한다.
함정 1 — 정렬 비결정성. 후보를 세로 위치(yTop)로 정렬해 맨 위 품목번호를 고를 때, 보조 정렬키가 없으면 위험하다. Dart의 List.sort는 안정 정렬을 보장하지 않는다. yTop이 같은 후보가 둘이면 선택이 비결정적이 되고, 정본 출력 자체가 흔들리면 골든의 신뢰성이 무너진다. 정렬키를 (yTop, x)로 세 언어 모두 통일한다.
int _byReadingOrder(OcrLine a, OcrLine b) {
  final c = a.yTop.compareTo(b.yTop);
  return c != 0 ? c : a.x.compareTo(b.x);  // 동률이면 왼쪽 우선 → 결정적
}
def test_trap_ytop_tie_resolves_leftmost():
tag = parse_price_tag([
OcrLine("222222", 0.50, 0.30, 0.1, 0.05, 1.0), # 오른쪽이 먼저 나열됨
OcrLine("111111", 0.10, 0.30, 0.1, 0.05, 1.0),
])
assert tag.item_number == "111111" # 세 언어 모두 이 값함정 2 — 정규식 유니코드 공백. 가격 패턴 (\d[\d,]{2,})\s*원을 Python에서 re.ASCII 플래그로 컴파일하면, 이 플래그는 \d뿐 아니라 \s까지 ASCII로 좁힌다. Dart·JS의 \s는 유니코드 공백(전각 공백, NBSP)을 포함한다. 그래서 숫자와 원 사이에 전각 공백이 낀 "23890 원"이 오면 Dart·JS는 가격을 잡고 Python만 놓친다. Python에선 \d를 [0-9]로 명시하고 re.ASCII를 뺀다(→ \s는 유니코드 유지).
함정 3 — 문자열 길이 단위. 영문명을 길이로 게이트할 때 언어별 length 단위가 다르다. Dart String.length와 JS/TS string.length는 UTF-16 코드 단위, Python len()은 코드포인트다. 이모지처럼 BMP 밖 문자가 경계에 걸리면 세 언어가 갈린다. 셋 다 코드포인트 기준으로 통일한다 — Dart는 runes.length, TS는 [...t].length(전개로 코드포인트 배열로), Python은 기본이 코드포인트라 len() 그대로.
if (t.runes.length < 5 || !t.contains(' ')) continue; // .length(UTF-16)가 아니라 runes세 함정의 공통점 — 전부 "정상 입력"에선 안 터지고 경계 입력에서만 터진다. 그래서 골든 파리티만으로는 안 잡히고 트랩 테스트가 필요하다. 정리하면 N개 언어를 동기화하는 절차는 이렇다.
- 한 언어를 정본으로 못박는다.
- 정본 출력을 실데이터에 대해 골든으로 동결한다.
- 나머지 언어를 같은 골든에 적합성 테스트한다(CI 게이트).
- 언어 간 위험 지점마다 합성 트랩 테스트를 심어 경계 입력을 고정한다.
5. 한계와 적용 범위
휴리스틱 파서의 한계를 그대로 적는다.
- 한국 코스트코 A포맷 전용. 품목번호 +
원가격 +할인행사/단가라벨과 한국어 OCR을 전제로 튜닝했다. 범용 OCR도, 타국 코스트코도, 일반 영수증도 아니다. - 비-A포맷을 감지하지 못한다. 영수증·베이커리 라벨·풍경샷이 들어와도 그럴듯한 6자리나
…원이 하나라도 잡히면unknown이 아니라regular로 나온다(예: 안내 전화139원이 가격으로). 문맥 없는 휴리스틱의 태생적 한계이고, 비-A포맷 감지가 남은 가장 큰 과제다. - 품목번호가 7자리로 OCR되면
null. 바코드 6자리를 거부하는 경계 가드가, OCR이 숫자를 하나 더 붙인 진짜 품목번호도 함께 거절한다. 틀린 추측보다null을 택했다. - 날짜는 best-effort. 달력상 불가능한 날짜는 버리지만, 그럴듯하지만 틀린 날짜는 통과할 수 있다.
그리고 앞서 말한 대로 parity는 정확성이 아니다. 43장은 "정본이 이렇게 뱉는다"를 고정할 뿐, 정본이 틀리면 골든도 틀린다.
6. 참고
- 저장소: costco-price-tag-parser (MIT) — 세 언어 패키지 +
spec/(계약·골든·픽스처) + CI - 구조:
packages/{dart,python,typescript}각 파서 + 적합성 스위트,spec/SPEC.md(휴리스틱 명세),spec/CONFORMANCE.md(ground truth vs parity 구분) - 확장: 새 언어를 추가하려면 파서를 포팅하고 같은 골든에 적합성 스위트를 붙이면 된다. A포맷 밖으로 넓히려면 문맥 가드(전화·영양성분 배제)를 추가하는 게 출발점이다.
태그: #오픈소스 #파서 #골든오라클 #크로스플랫폼 #OCR