도커 연습용으로 간단한 더미 프로젝트를 만드는 도중 식당 휴무일을 DB에 저장해야 했다.
예를 들어 식당 A, B의 휴무일이 다음과 같을 때:
식당 A의 휴무일 - 월요일, 화요일
식당 B의 휴무일 - 월요일, 화요일, 일요일
데이터베이스의 모든 컬럼은 원자값을 가져야 한다는 제 1 정규형을 준수한다면
휴무일 테이블에는 5개의 인스턴스가 생성될 것이다.
하지만 비트마스킹을 사용한다면 제 1 정규형을 준수하면서도 식당의 수 만큼만 인스턴스를 생성할 수 있다.
즉, 복수의 요일 데이터를 하나의 셀에 담을 수 있다!
기존 포레포레 개인프젝에서는 복수의 요일 데이터를 저장할 때
비트마스킹의 벽을 넘지 못해 아래와 같이 DB를 구성 했었다.
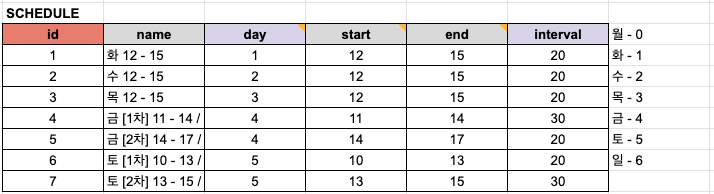
행 1 ~ 3까지의 요일 (화, 수, 목)을 한 줄에 담을 수 없어 인스턴스의 개수가 불필요하게 늘어난 경우이다.
👽 1단계: left 비트 쉬프트 연산(<<) 이해하기
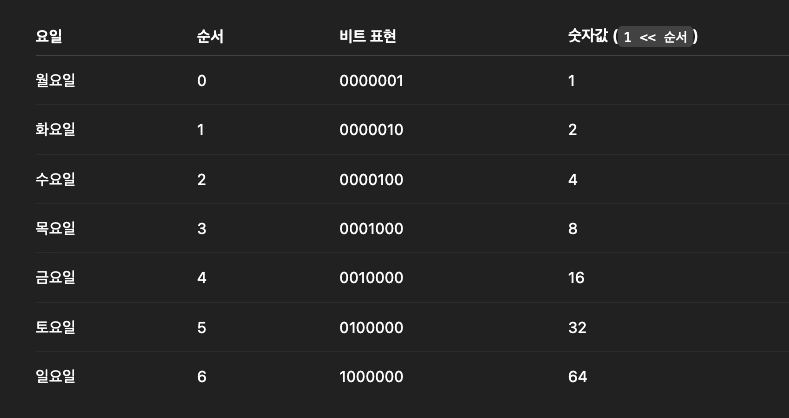
left 쉬프트 비트연산 'x << y'는
<<의 왼쪽에 있는 숫자 x를
<<의 오른쪽에 있는 숫자 y만큼 왼쪽으로 밀어버린다(shift)는 뜻이다.
따라서 월요일(0)을 시작으로 일요일(6) 까지 나열했을 때
월요일(0)을 비트연산으로 표현하면 1 << 0이 되어 0000001이며, 1을 왼쪽으로 0칸 밀면 0000001이 되고, 이는 십진수로 1이다.(2의 0승 = 1)
목요일(3)을 비트연산으로 표현하면 1 << 3이며, 1을 왼쪽으로 3칸 밀면 0001000이 되고, 이는 십진수로 8이 된다.64 (2의 3승 = 8)
일요일(6)을 비트 연산으로 표현하면 1 << 6이 되어 1을 왼쪽으로 6칸 밀면 1000000이 되고, 이는 십진수로 표현하면 (2의 6승 = 64)
+) 이진수 --> 십진수 변환 방법 1000 = (1 x 2의 3승) + (0 x 2의 2승) + (0 x 2의 1승) + (0 x 2의 0승) 1000 = 8 + 0 + 0 + 0 1000 = 8 * 십진수 숫자의 맨 뒤 자리 수를 0번 인덱스로 간주하고 왼쪽으로 인덱싱 하며 2의 index승을 한다. * 참고로 n의 0승은 항상 1이다. (수학적 원리가 그러하다 한다.) * 하지만 0 x n은 항상 0이다.👽 2단계: OR(|) 연산 이해하기
OR 연산은 하나라도 True 이면 True가 되는 연산이다.
T | T = T
T | F = T
F | T = T
F | F = F
예를 들어 목요일과 일요일을 숫자로 나타내면 8 | 64 이고,
목요일을 비트연산자로 나타내면 0001000
일요일을 비트연산자로 나타내면 1000000
OR 연산을 하면 1001000이 나온다.
0 0 0 1 0 0 0
1 0 0 0 0 0 0
-------------
1 0 0 1 0 0 0
1001000을 다시 십진수로 변환하면 72가 나온다.
1001000 = (1 x 2의 6승) + (0 x 2의 5승) + (0 x 2의 4승) + (1 x 2의 3승) + (0 x 2의 2승) + (0 x 2의 1승) + (0 x 2의 0승)
1001000 = 64 + 0 + 0 + 8 + 0 + 0 + 0
1001000 = 72
따라서 휴무일이 목요일과 일요일인 식당의 데이터를 한 행에 저장할 수 있는 것이다! (두둥탁!)
👽 3단계: 비트마스킹 변환 코드 작성
아직 구현 전이라 확실하지는 않지만
프론트에서 휴무일을선택하면
서버로 ["thr", "sun"] 과 같은 데이터가 들어올 것이다.
이를 비트마스킹값으로 변환해보자!
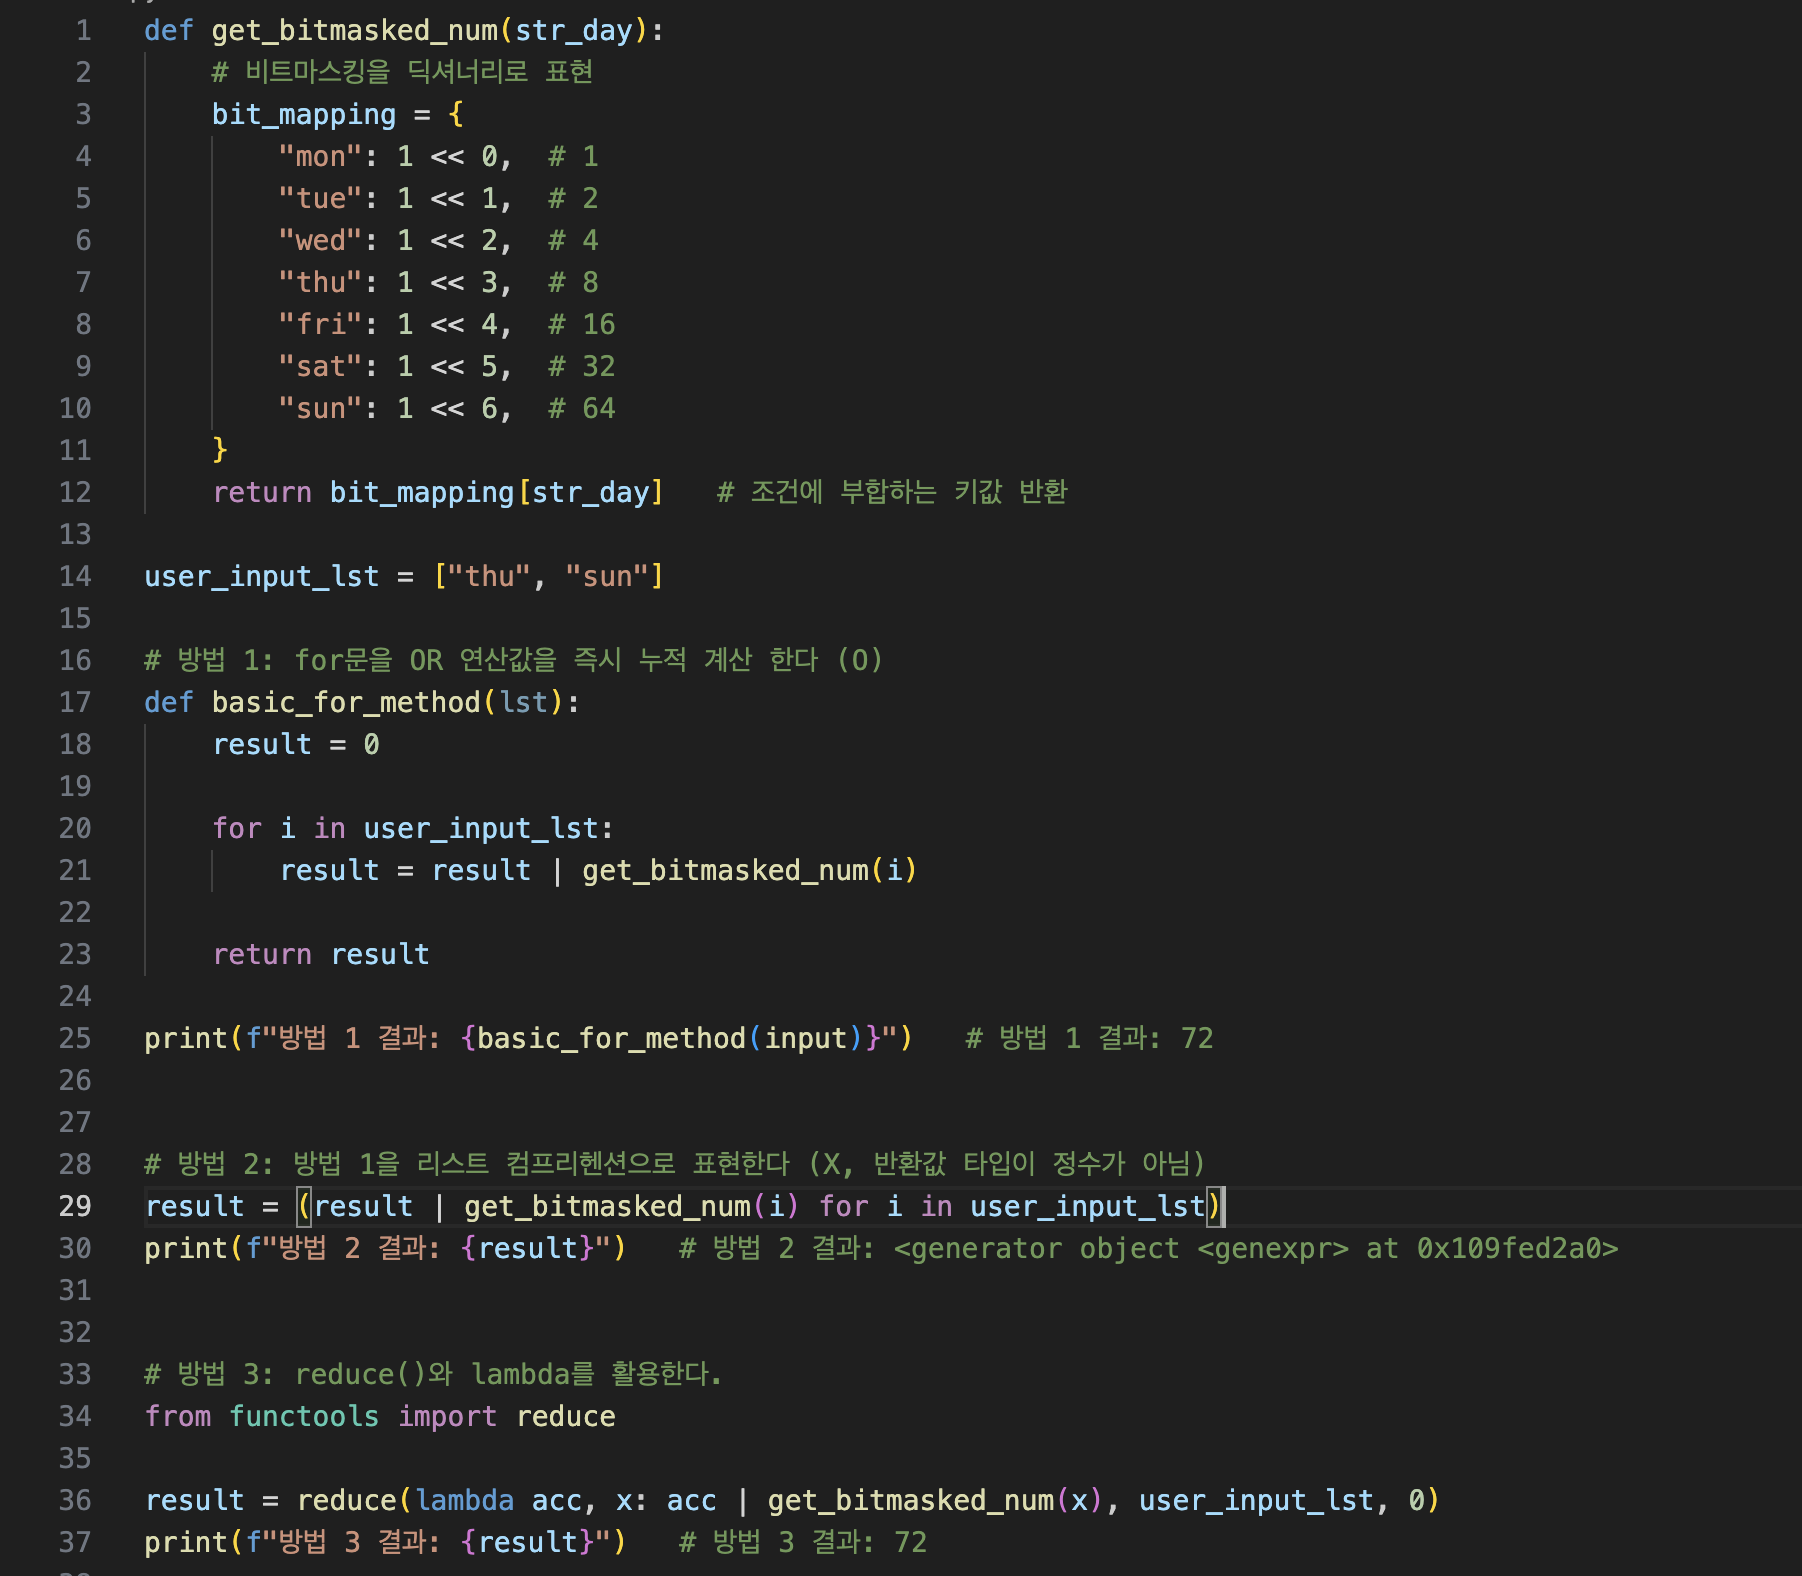
우선 str 형식으로 넘어오는 요일 데이터를 비트값으로 바꿔주는 함수를 작성한다.
def get_bitmasked_num(str_day):
    # 딕셔너리 {문자열_요일: 비트값}
    bit_mapping = {
        "mon": 1 << 0,  # 1
        "tue": 1 << 1,  # 2
        "wed": 1 << 2,  # 4
        "thu": 1 << 3,  # 8
        "fri": 1 << 4,  # 16
        "sat": 1 << 5,  # 32
        "sun": 1 << 6,  # 64
    }
    return bit_mapping[str_day]   # 인자로 넘어온 '문자열 요일'을 키로 갖는 비트값 반환
✅ 방법 1: 단순 for문
def basic_for_method(lst):
    result = 0

    for i in user_input_lst:
        result = result | get_bitmasked_num(i)

    return result
사용자로부터 넘어온 ["thr", "sun"] 리스트를 돌며 OR 연산값을 즉시 누적하여 계산한다.
잘 동작하고 가독성이 좋으며, 예외처리 할 때 편하다.
방법 1 결과: 72❌ 방법 2: 리스트 컴프리헨션(처럼 보이는 어떤것)
result = (result | get_bitmasked_num(i) for i in user_input_lst)
print(f"방법 2 결과: {result}")
괄호가 없으면 문법 오류가 나길래 list-comprehension처럼 보이도록 괄호로 묶어줬다.
하지만 정수가 아닌 gernerator object가 반환 되었다.
방법 2 결과: <generator object <genexpr> at 0x109fed2a0>괄호 안에 반복 가능한 객체를 넣으면 제너레이터 표현식(generator expression)이 된다고 한다.
엄청난 양의 데이터를 한번에 메모리에 로드하는 대신,
필요한 데이터만 어떻게 생성하는지 아는 객체를 만들어서 사용할 때 사용한다고 한다.
즉, 계산된 값 전체를 가져와서 필요한 부분만 필터링해 사용하는 방식이 비효율 적이니
필요한 부분을 계산하는 방법을 객체로 만들어 가져오는 것이다.
(오.. 신기해..)
여튼 내가 원하는 결과를 얻지 못했다.
✅ 방법 3: reduce() + lambda
from functools import reduce

result = reduce(lambda acc, x: acc | get_bitmasked_num(x), user_input_lst, 0)
print(f"방법 3 결과: {result}")
reduce(function, iterable, inital)는 inital부터 시작하여 iterable을 순회하며 function을 수행한 결과들을 누적해서 반환해주는 함수이다.
함수
lambda acc, x: acc | get_bitmasked_num(x)
반복 가능한 객체
user_input_lst
초기값
0
'lambda'는 '매개변수: 표현식'으로 나타내는 익명함수이다.
lambda acc, x: acc | get_bitmasked_num(x)는 아래의 코드를 짧게 쓴 것이다.
def func(acc, x):
    return acc | basic_for_method(x)
즉, 위 코드에서 reduce()는
초기값 0에서부터 시작해
["thr", "sun"]을 순회하며
리스트의 각 요소에 lambda 실행문을 돌리며
그 결과를 누적해서 반환해 준다.
첫 번째 순회에서
람다의 첫번째 인자 acc = 0 (inital)이고
람다의 두번째 인자 x = 8 (basic_for_method("thr"))이다.
람다는 0 | 8 = 8을 리턴한다.
이때 reduce의 누적값은 8이다.
두 번째 순회에서
람다의 첫번째 인자 acc = 8이고
람다의 두번째 인자 x = 64 (basic_for_method("sun")) 이다.
람다는 8 | 64 = 8을 리턴한다.
이때 reduce의 누적값은 72이다.
결과적으로 result에는 reduce() 함수의 총 누적값인 72가 담긴다.
그리고 내 머리가 터졌다..
람다는 고오급 코딩에서 정말 자주 쓰이는데 볼때마다 이해가 힘들다.
map(), reduce(), filter()등과 함께 쓰이니 그럴 수밖에..
어쩔 수 없따!! 숙달 될때까지 반복! 반복! 반복! +) 람다 교과서 참고
도커 컴포즈 테스트 한다고
더미 프로젝트 만들다가 여기까지 왔다.
근데 아직 프로젝트는 시작도 안했다. 구상하다가 여기까지 왔다 ㅎㅎ..
그래도 재미있으니까 됐다!
끝!