1. 배경
이번 프로젝트에서는 사용자 맞춤형 도서 추천 기능을 구현했다.
추천 로직은 ML 서버에서 생성한 추천 도서 후보군(user_recommended_book) 과
주차별 확정본(user_weekly_featured_book) 을 중심으로 돌아간다.
(1) 각 테이블의 용도

(2) 스키마
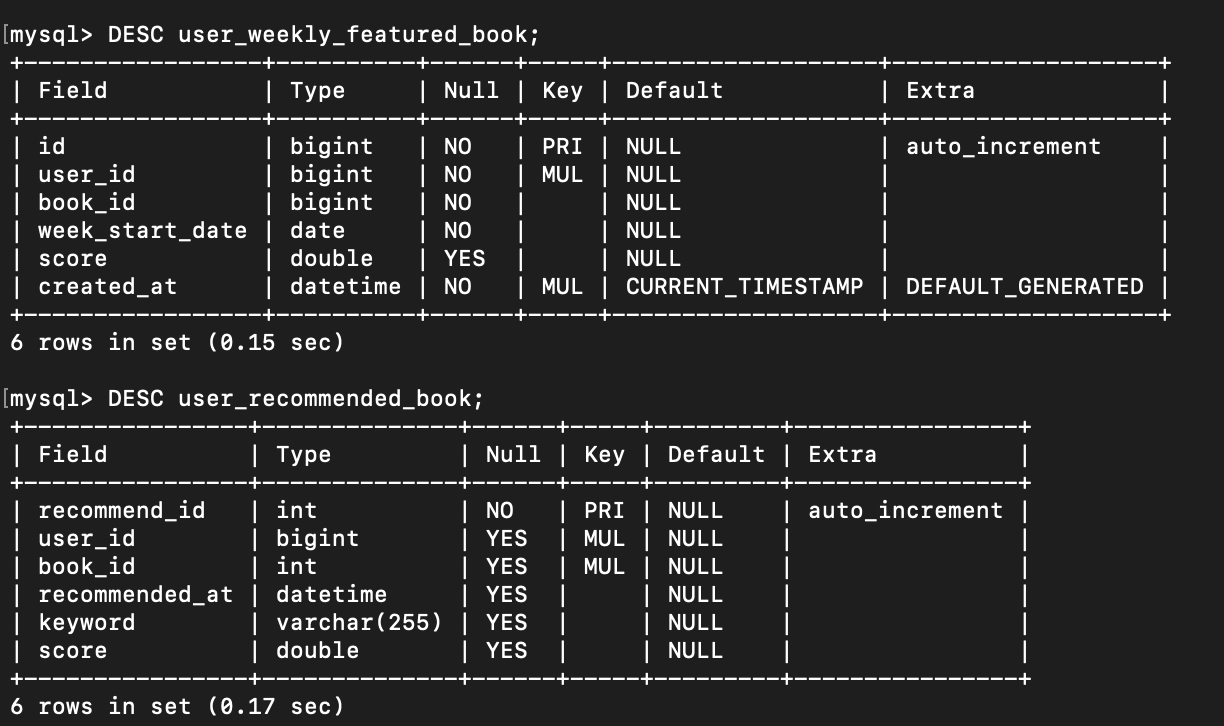
그리고 user_recommended_book에 있는 데이터를 매주 월요일마다 재로딩하며 사용자에게 신선도 높은 데이터를 제공하기 위해서 리팩토링도 진행했다.
2. 구현 과정
(1) 개인 추천 도서 확정 (주차별 Featured Book)
- 매주 사용자의 추천 도서 중
score가 가장 높은 책을 1권만user_weekly_featured_book테이블에 저장 user_weekly_featured_book은 일종의 히스토리 테이블로, 매주 기록이 누적됨- 이미 확정된 데이터가 있으면 멱등성 보장 (중복 저장 X)
- 테스트 결과: 정상적으로 주차별 데이터가 누적됨
(2) B메인 <당신을 위한 도서> 기능
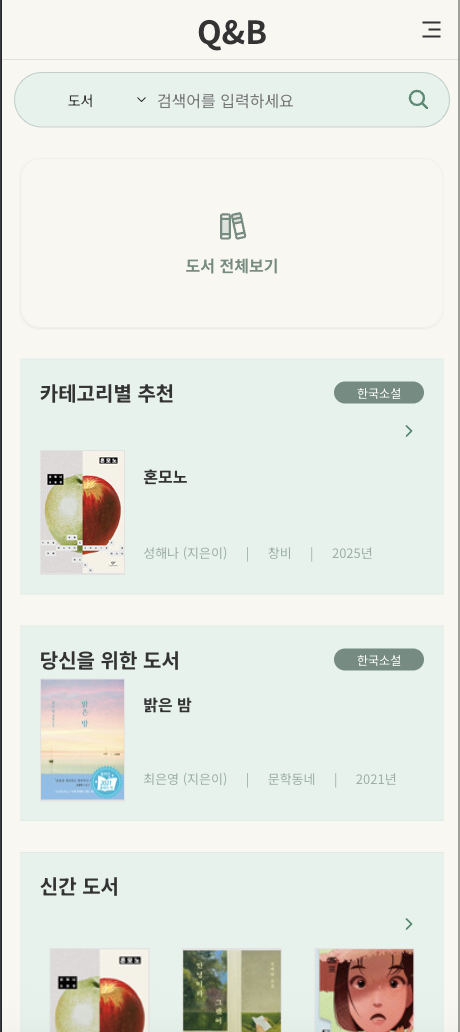
- 기존: 단순히 추천 후보군을 불러오는 구조
- 수정: user_recommended_book 테이블 내 도서 중 랜덤 1권 반환하는 방식으로 변경
- JPQL에 ORDER BY function('RAND') 를 적용해 구현
- 테스트 결과: 호출 시마다 랜덤으로 추천 도서 노출 확인
(3) MY 페이지 <추천 도서 리스트> 조회
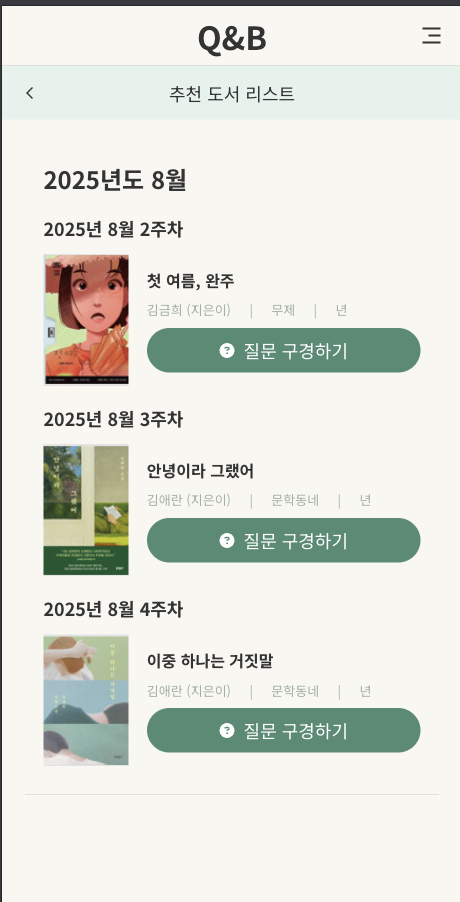
- 기존: 추천 리스트가 단순히 나열되는 구조
- 수정:
user_weekly_featured_book테이블의 데이터를 주차별(Year-Month-Week) 단위로 묶어서 반환 - 최신 주차가 뒤로 가도록 정렬 로직 변경 (1주차 → n주차 순)
- 테스트 결과: UI에서 주차별 히스토리 조회 정상 작동
3. 리팩토링 포인트
- 멱등성 보장: 주차별 확정 도서 저장 시 중복 삽입 방지
- JPQL 최적화: 랜덤 추천 시 Pageable과 함께 사용해 성능 부담 최소화
- 정렬 로직 개선: 최신 도서를 뒤로 배치하여 사용자 경험 개선
- 응답 포맷 통일: 프론트엔드 명세에 맞춰 DTO와 Response 구조 정리
리팩토링을 진행하는게 생각보다 복잡했고, 어려웠다.
하지만 해냈다잉~!!
단순히 기능을 “만드는 것”이 아니라, 데이터 흐름을 어떻게 설계하고 유지할지 고민하는 게 어렵기도 하고 중요하다는 것을 깨닫았다.
특히 추천/히스토리성 데이터는 “실시간”보다는 주기적·누적 관리가 안정적이라는 점을 체감한 리팩토링이었다.
안녕하세요! 백다현입니다