Level 3 / Heap(Priority Queue)
https://school.programmers.co.kr/learn/courses/30/lessons/42627
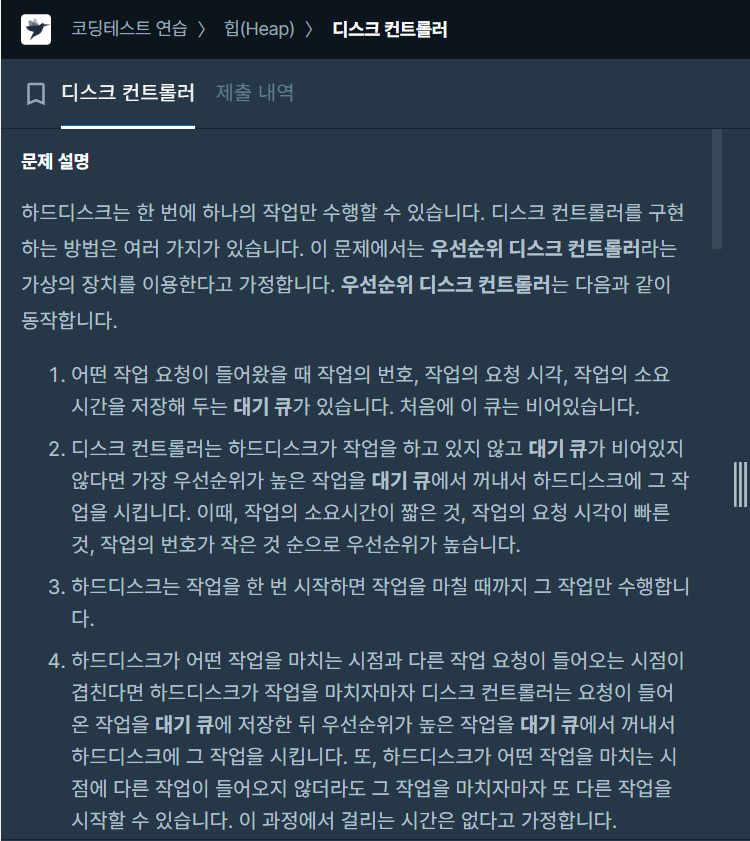
Heap / Priority Queue 알고리즘 문제를 풀기 위해 시도를 했던 문제입니다.
문제 설명
간단히 문제 설명을 하자면,
여러 작업이 각각 요청 시간과 소요 시간을 가지고 들어오고, 현재 처리할 수 있는 작업들 중 우선순위가 높은 작업을 선택하여 처리하는 문제입니다.
- 0ms 시점에 3ms가 소요되는 0번 작업 요청
- 1ms 시점에 9ms가 소요되는 1번 작업 요청
- 3ms 시점에 5ms가 소요되는 2번 작업 요청
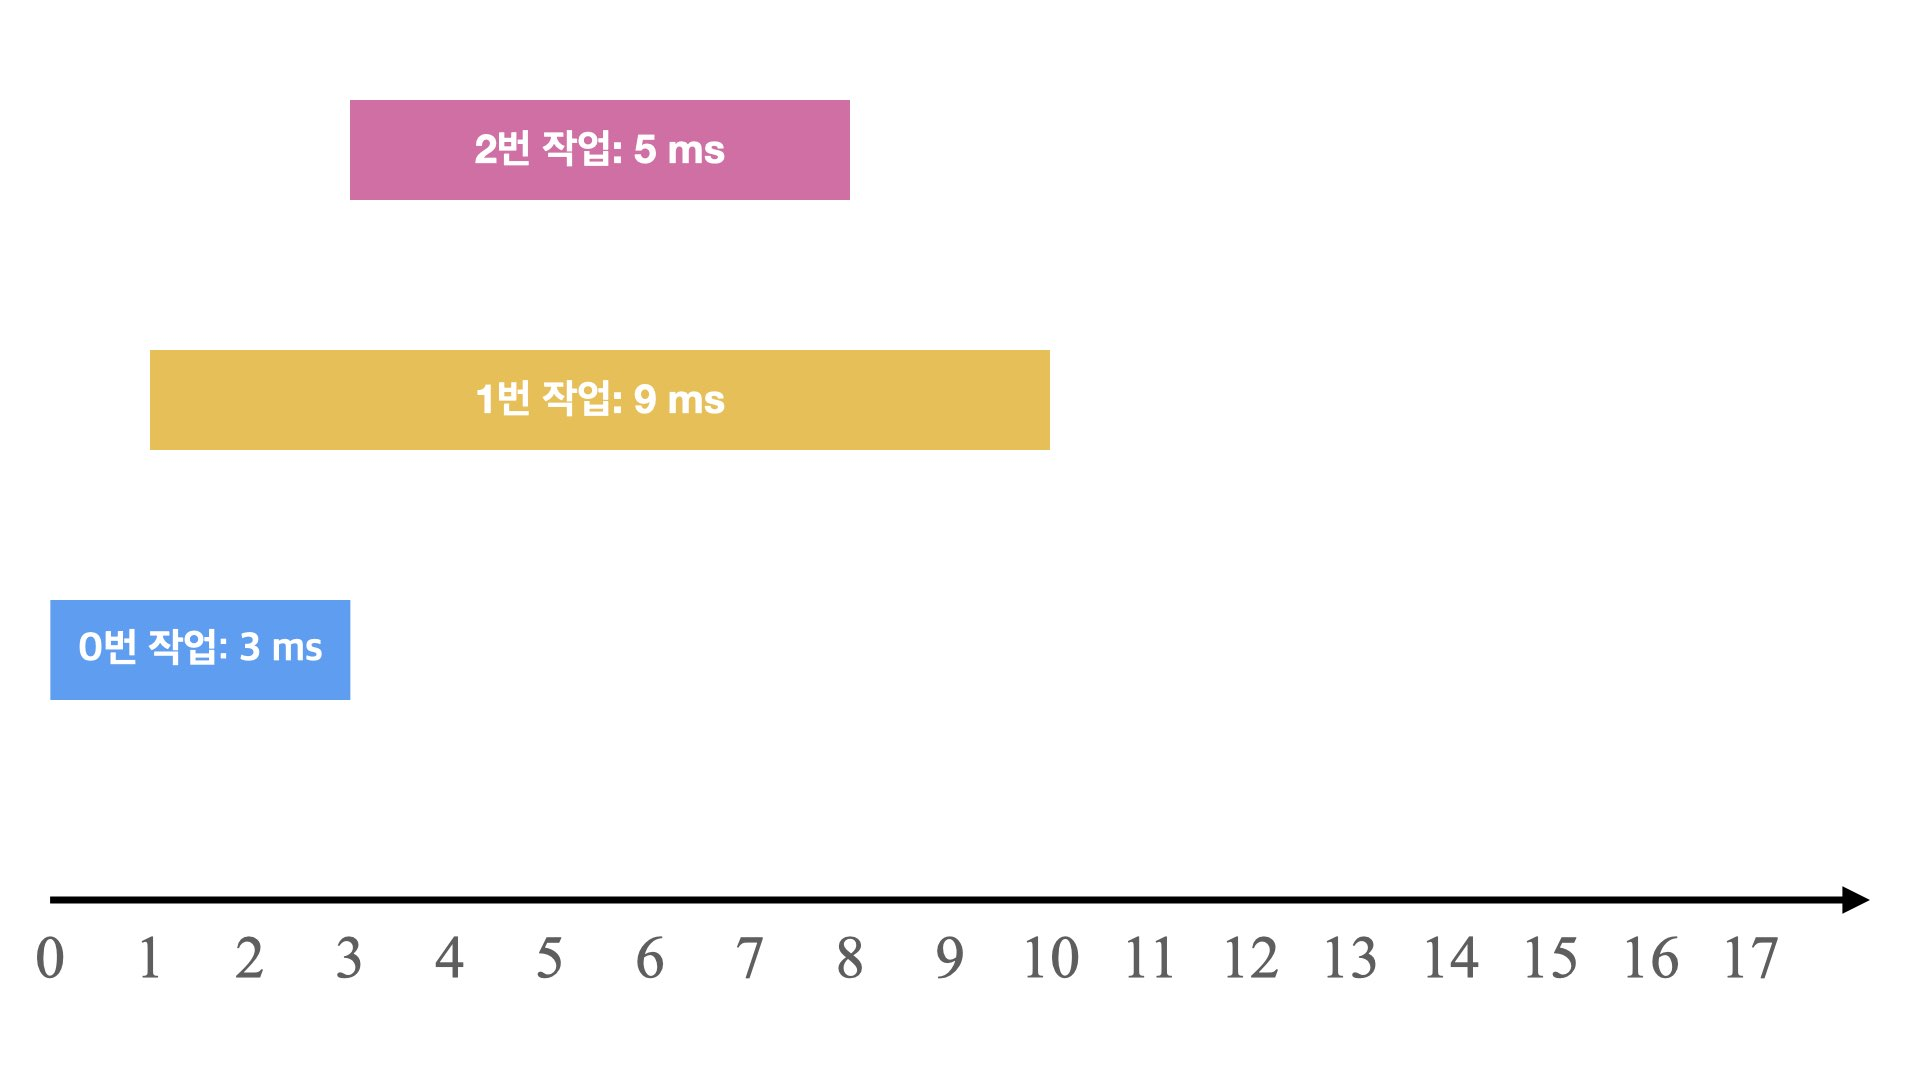
그림과 같이 각 작업은 서로 다른 시점에 요청됩니다.
작업 하나를 처리하면 시간이 그만큼 흐르게 되고, 그 사이에 새롭게 요청된 작업들도 처리 대기 상태가 됩니다.
따라서 단순히 소요 시간이 짧은 작업부터 정렬해서 처리하는 것이 아니라,
현재 시간까지 요청된 작업들을 따로 넣고, 그중 우선순위가 가장 높은 작업을 하나씩 처리해야 한다는 이야기입니다.
우선순위
1. 소요 시간이 짧은 작업
2. 요청 시각이 빠른 작업
3. 작업 번호가 작은 작업
최종적으로는 각 작업에 대해 작업 종료 시간 - 작업 요청 시간을 계산한 반환 시간의 평균을 구하는 문제입니다.
풀이 접근
제일 처음 이 문제를 접했을 때 Min Heap 활용과 이중 배열의 요소 비교를 통해 풀어야겠다고 생각했습니다.
따라서 우선, 들어오는 jobs라는 이중 배열을 heapq.heapify() 메서드를 이용해 Heap으로 만들고 풀어보려고 했습니다.
하지만 생각해보니 jobs 전체를 바로 Heap으로 관리하는 것은 적절하지 않았습니다.
이 문제에서는 아직 요청 시간이 되지 않은 작업까지 함께 들어 있기 때문에, Heap에는 현재 시점에서 실제로 실행 가능한 작업들만 따로 넣어 관리하는 것이 더 적절했습니다.
그래서 전체 jobs는 요청 시간 순으로 tasks로 정렬해두고, 현재 시간까지 요청된 작업들만 별도의 Min Heap에 넣는 방식으로 접근했습니다.
tasks
-> 요청 시간 순으로 정렬된 전체 작업

tasks[idx:]
-> 아직 Heap에 넣지 않은 작업

heap
-> 현재 시간까지 요청되어 실행 가능한 작업
그리고 이미 어떤 작업까지 확인했는지를 기억하기 위해 idx라는 인덱스 포인터를 사용했습니다.
idx는 단순한 반복문의 인덱스라기보다,
아직 확인하지 않은 다음 작업의 위치
를 나타냅니다.
따라서 한 번 Heap에 넣은 작업은 idx가 지나가게 되고, 이후에는 다시 확인할 필요가 없습니다.
이 구조를 사용하면서 전체 흐름은 다음과 같이 정리할 수 있었습니다.
- jobs를 요청 시간 순으로 정렬
- 현재 시간까지 요청된 작업을 Heap에 추가
- Heap에서 우선순위가 가장 높은 작업을 꺼내 실행
- 작업이 끝난 시간까지 새롭게 들어온 작업을 다시 Heap에 추가
- 모든 작업을 확인하고 Heap까지 비면 종료
이 과정에서 전체 작업을 처리하는 바깥 while과, 현재 실행 가능한 작업들을 Heap에 추가하는 안쪽 while을 사용하는 구조가 만들어졌습니다.
핵심 구현
이 문제에서 가장 중요했던 부분은 idx와 두 개의 while 문이었습니다.
idx는 아직 확인하지 않은 다음 작업의 위치를 가리킵니다.
idx = 0한 번 Heap에 넣은 작업은 idx += 1을 통해 지나가게 되므로, 이후에는 다시 확인하지 않습니다.
while idx < len(tasks) and tasks[idx][0] <= current_time:
	...
    idx += 1
처음에는 while문이 두 번 등장해서 헷갈렸는데, 각각의 역할은 다릅니다.
while idx < len(tasks) or heap:바깥쪽 while은 전체 작업이 끝날 때까지 반복하기 위한 것이고,
while idx < len(tasks) and tasks[idx][0] <= current_time:안쪽 while은 현재 시간까지 요청된 작업들을 모두 Heap에 넣기 위한 반복문입니다.
즉
바깥 while
-> 전체 스케줄링 진행

안쪽 while
-> 현재 실행 가능한 작업들을 Heap에 추가
라고 생각하면 이해하기 쉬웠습니다.
Heap에는 우선순위에 맞게
(duration, request, number)형태로 넣었습니다.
Python의 heapq는 튜플의 앞 요소부터 비교하기 때문에 자연스럽게
소요 시간 -> 요청 시간 -> 작업 번호
순으로 우선순위가 결정됩니다.
최종 코드
import heapq


def solution(jobs):
    # (요청 시간, 소요 시간, 작업 번호)
    tasks = sorted(
        (request, duration, number)
        for number, (request, duration) in enumerate(jobs)
    )

    heap = []

    idx = 0
    current_time = tasks[0][0]
    total_time = 0

    while idx < len(tasks) or heap:

        # 현재 실행 가능한 작업이 없다면
        # 다음 작업의 요청 시간으로 이동
        if not heap and idx < len(tasks) and current_time < tasks[idx][0]:
            current_time = tasks[idx][0]

        # 현재 시간까지 요청된 작업들을 모두 Heap에 추가
        while idx < len(tasks) and tasks[idx][0] <= current_time:
            request, duration, number = tasks[idx]

            heapq.heappush(heap, (duration, request, number))
            idx += 1

        # 우선순위가 가장 높은 작업 실행
        duration, request, number = heapq.heappop(heap)

        current_time += duration

        # 반환 시간 = 작업 종료 시간 - 요청 시간
        total_time += current_time - request

    return total_time // len(jobs)
정리
처음에는 단순히 Heap을 사용해서 소요 시간이 짧은 작업부터 꺼내면 된다고 생각했지만, 실제로는 어떤 작업을 언제 Heap에 넣을 것인지 관리하는 과정이 더 중요했던 문제였습니다.
특히 이번 문제를 통해
정렬된 배열
    +
인덱스 포인터
    +
Min Heap
을 함께 사용하는 구조를 익힐 수 있었습니다.
idx를 사용하면
이미 확인한 작업
-> 다시 확인하지 않음

아직 확인하지 않은 작업
-> idx부터 이어서 확인
할 수 있습니다.
또한 전체 코드의 흐름을
바깥 while
-> 전체 작업 처리

if
-> 실행 가능한 작업이 없다면 다음 요청 시간으로 이동

안쪽 while
-> 현재 실행 가능한 작업들을 Heap에 추가

heappop
-> 우선순위가 가장 높은 작업 실행
처럼 역할을 나눠서 생각하니 처음보다 구조를 이해하기 쉬웠습니다.
처음부터 이런 구조를 바로 떠올리기는 쉽지 않았지만, 앞으로 비슷하게 시간에 따라 데이터가 들어오고, 현재 처리 가능한 데이터 중 우선순위에 따라 하나를 선택해야 하는 문제를 만나면 정렬 + 포인터 + Heap 구조를 떠올려볼 수 있을 것 같습니다.