지난 글에서는 컴프리헨션으로 데이터를 변환하고 골라내는 방법을 알아봤다. 이번에는 이런 작업을 함수로 묶었을 때, 전달한 객체가 어떻게 다뤄지는지 살펴보려고 한다.
파이썬에서는 함수를 정의하고 필요한 값을 전달해 작업을 수행할 수 있다.
처음 함수를 배울 때는 보통 다음과 같이 이해한다.
def: 함수를 정의한다.- 매개변수 : 함수에서 전달받을 값을 정의한다.
return: 함수의 실행 결과를 반환한다.
하지만 함수를 사용하다 보면 궁금한 점이 생긴다.
def add_item(items):
    items.append(4)

numbers = [1, 2, 3]

add_item(numbers)

print(numbers)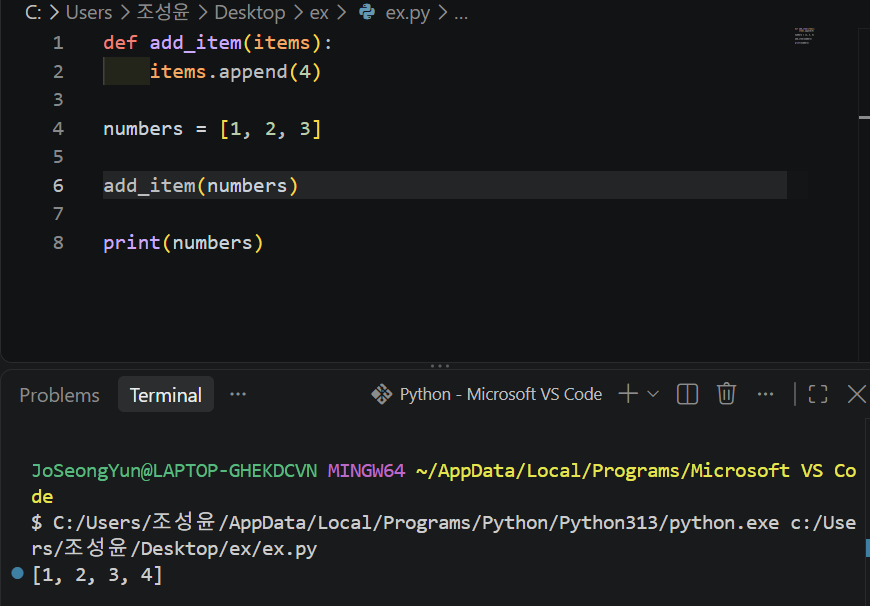
실행 결과는 다음과 같다.
[1, 2, 3, 4]함수 안에서 리스트를 수정했을 뿐인데, 함수 밖의 numbers까지 변경되었다.
그렇다면 다음 코드는 어떨까?
def change_list(items):
    items = [10, 20, 30]

numbers = [1, 2, 3]

change_list(numbers)

print(numbers)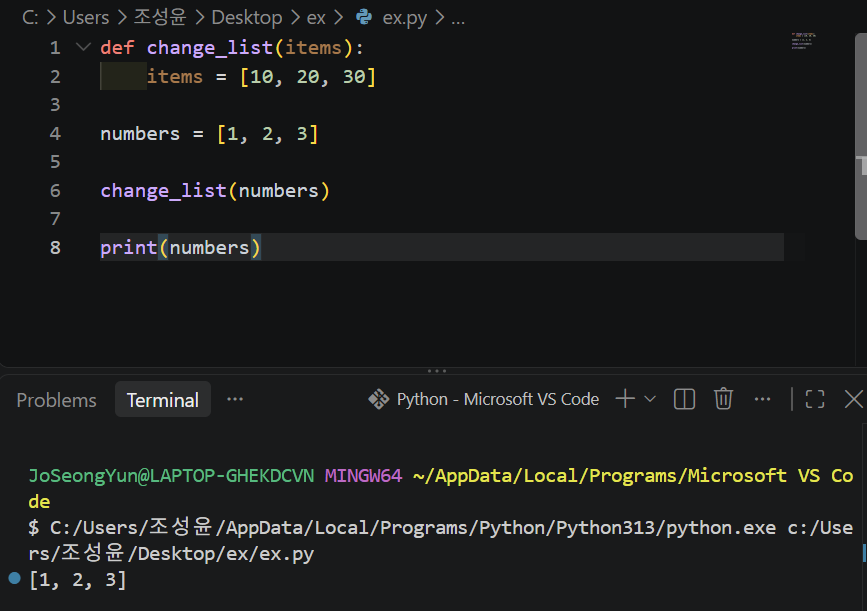
[1, 2, 3]이번에는 함수 안에서 새로운 리스트를 대입했지만 원본은 변경되지 않았다.
두 코드의 차이는 무엇일까?
함수의 기본 문법부터 살펴본 뒤, 객체를 변경하는 코드와 매개변수에 재대입하는 코드가 왜 다르게 동작하는지 정리해보려고 한다. 이어서 기본 인자가 만들어지는 시점과 여러 인자를 전달하는 방식까지 함께 살펴본다.
1. 함수는 왜 사용할까?
함수(Function)는 특정 작업을 수행하는 코드를 하나로 묶어 놓은 것이다.
예를 들어 두 숫자를 더하는 작업이 있다고 하자.
a = 10
b = 20

result = a + b

print(result)
이러한 계산이 여러 곳에서 필요하다면 매번 같은 코드를 작성해야 한다.
하지만 함수로 정의하면 필요한 값을 전달해 반복해서 사용할 수 있다.
def add(a, b):
    return a + b

print(add(10, 20))
print(add(30, 40))
30
70함수는 def 키워드로 정의한다.
def 함수이름(매개변수):
    실행할 코드
    return 반환값
여기서 중요한 점은 함수를 정의하는 것과 실행하는 것은 다르다는 것이다.
def greeting():
    print("안녕하세요.")
위 코드는 함수를 정의한 것이며, 함수 내부의 코드는 아직 실행되지 않는다.
greeting()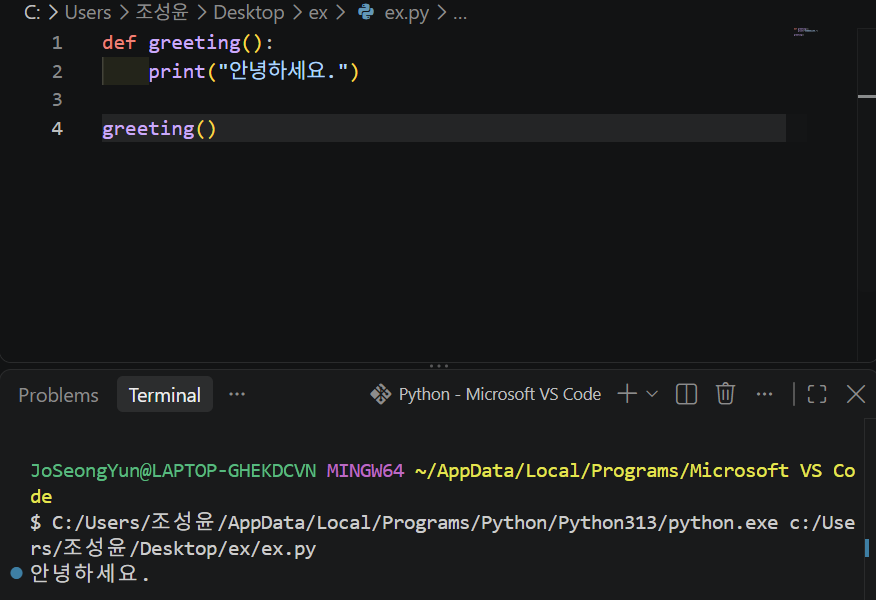
함수를 호출해야 내부 코드가 실행된다.
함수를 사용하면 반복되는 코드를 줄일 수 있을 뿐만 아니라, 특정 작업을 하나의 단위로 구분해 프로그램의 구조를 더 명확하게 만들 수 있다.
2. 매개변수와 인자는 무엇이 다를까?
함수를 설명할 때 자주 등장하는 용어가 있다.
바로 매개변수(Parameter)와 인자(Argument)다.
def add(a, b):
    return a + b

result = add(10, 20)
여기서 a와 b는 매개변수이고, 10과 20은 인자다.
| 구분 | 의미 | 예시 |
|---|---|---|
| Parameter | 함수 정의에서 값을 전달받는 이름 | a, b |
| Argument | 함수 호출 시 전달하는 값 또는 객체 | 10, 20 |
함수가 호출되면 전달된 인자에 따라 매개변수가 해당 객체를 참조하게 된다.
add(10, 20)을 호출하면 매개변수 a는 10을, b는 20을 참조한다. 함수는 a + b를 계산해 30을 반환한다.
그렇다면 이 과정에서 파이썬은 전달받은 객체를 복사하는 것일까?
3. 함수에 전달한 객체는 복사될까?
3편에서 살펴봤듯이 파이썬의 변수는 객체를 직접 담는 상자라기보다, 객체를 참조하는 이름으로 이해할 수 있다.
이러한 특성은 함수에서도 동일하게 적용된다.
다음 코드를 보자.
def check(items):
    print(items is numbers)

numbers = [1, 2, 3]

check(numbers)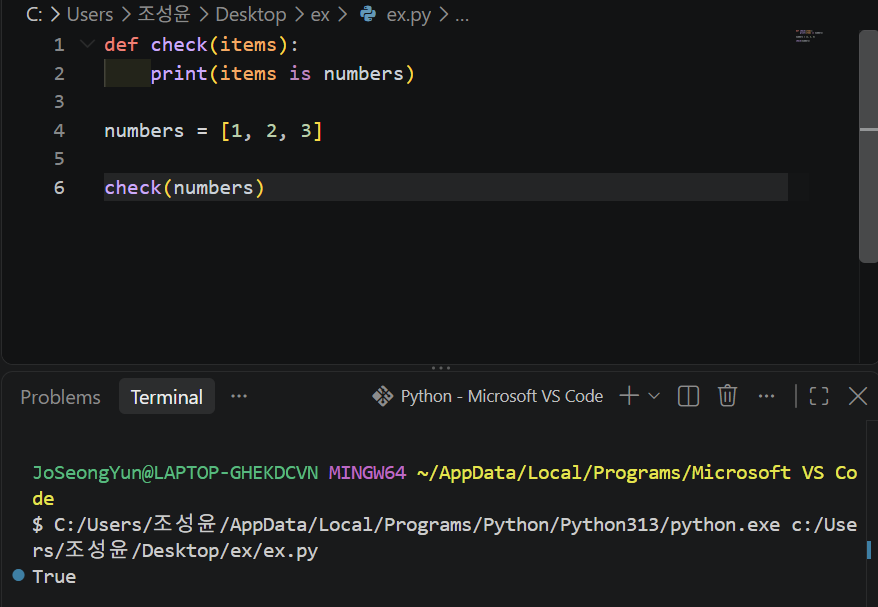
Trueis 연산자는 두 이름이 동일한 객체를 참조하는지 확인한다.
위 코드에서 함수 밖의 numbers와 함수 안의 items는 동일한 리스트 객체를 참조한다.
| 이름 | 범위 | 참조 대상 |
|---|---|---|
numbers | 함수 밖 | 원본 리스트 |
items | 함수 안 | numbers와 같은 리스트 |
함수를 호출했다고 해서 새로운 리스트가 자동으로 복사되는 것은 아니다.
함수 내부에서 매개변수는 전달받은 인자가 참조하던 객체와 연결된다.
이러한 방식을 흔히 객체 참조 전달 또는 객체 공유(Call by Sharing)라고 설명한다.
중요한 점은 C++ 등의 참조 전달처럼 함수가 호출한 쪽의 변수 자체를 변경할 수 있다는 의미는 아니라는 것이다.
파이썬에서는 함수 내부의 매개변수와 함수 밖의 변수가 서로 다른 이름이지만, 같은 객체를 참조할 수 있다.
그렇다면 같은 객체를 참조하는 상태에서 객체를 수정하면 어떻게 될까?
4. 함수 안에서 객체를 변경하면 어떻게 될까?
다음 코드를 보자.
def add_item(items):
    items.append(4)

numbers = [1, 2, 3]

add_item(numbers)

print(numbers)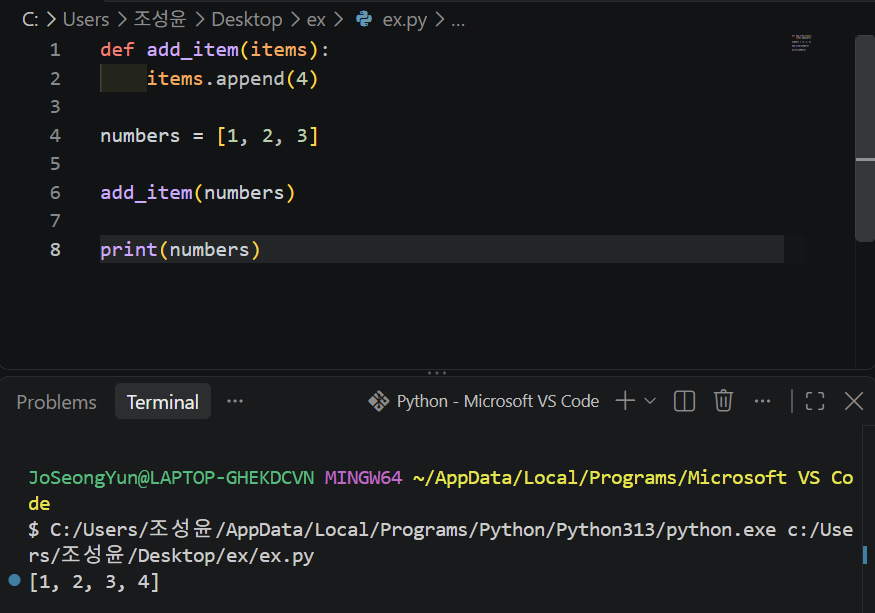
[1, 2, 3, 4]함수 안의 items와 함수 밖의 numbers는 동일한 리스트 객체를 참조한다.
그리고 append()는 기존 리스트 객체의 내용을 변경하는 메서드다.
따라서 함수 안에서 append()를 호출하면 함수 밖에서 참조하는 리스트에도 변경 사항이 반영된다.
| 시점 | 공유하는 리스트의 내용 |
|---|---|
함수 호출 후, append() 실행 전 | [1, 2, 3] |
items.append(4) 실행 후 | [1, 2, 3, 4] |
이처럼 가변 객체(Mutable Object)는 동일한 객체를 참조하는 여러 이름을 통해 내용이 변경될 수 있다.
그렇다면 함수 안에서 items에 새로운 리스트를 대입하면 어떻게 될까?
5. 객체 변경과 재대입은 무엇이 다를까?
다음 코드를 보자.
def change_list(items):
    items = [10, 20, 30]

numbers = [1, 2, 3]

change_list(numbers)

print(numbers)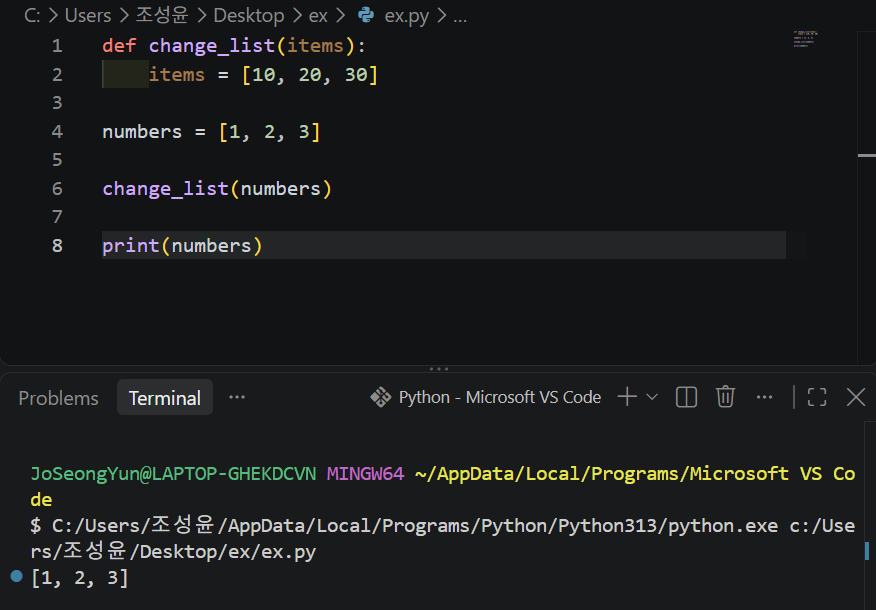
[1, 2, 3]앞선 예제와 달리 원본 리스트는 변경되지 않았다.
왜 그럴까?
items = [10, 20, 30]은 기존 리스트 객체를 수정하는 것이 아니다.
새로운 리스트 객체를 만들고, 함수 내부의 items라는 이름이 그 객체를 참조하도록 재대입(Reassignment)하는 것이다.
| 시점 | numbers | items |
|---|---|---|
| 함수 호출 직후 | 원본 리스트 | 같은 원본 리스트 |
items = [10, 20, 30] 이후 | 원본 [1, 2, 3] | 새 리스트 [10, 20, 30] |
따라서 함수 밖의 numbers는 여전히 기존 리스트를 참조한다.
이 차이는 정수와 같은 불변 객체에서도 확인할 수 있다.
def increase(number):
    number += 1
    print("함수 내부:", number)

value = 10

increase(value)

print("함수 외부:", value)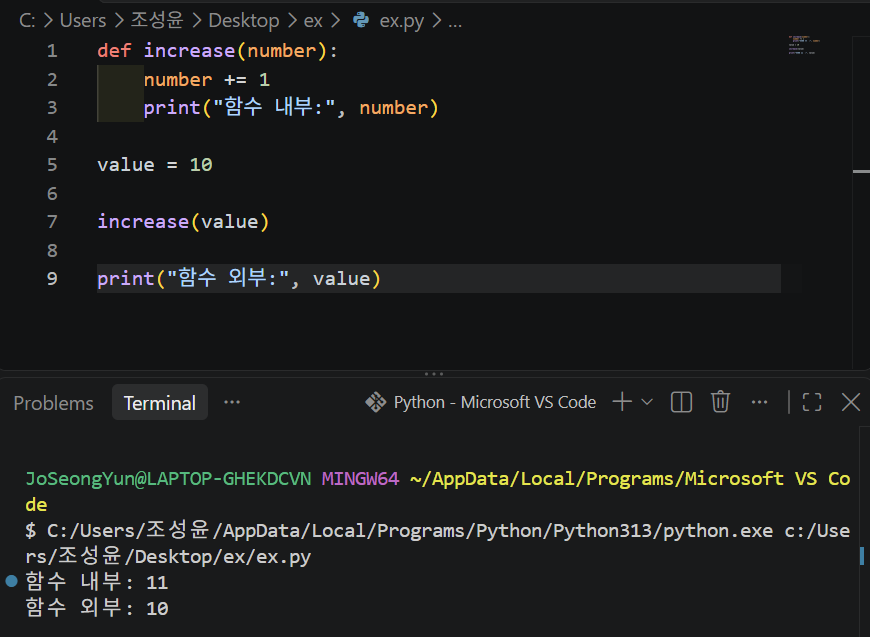
함수 내부: 11
함수 외부: 10
정수는 불변 객체이므로 number += 1은 기존 정수 객체를 수정하지 않고, 연산 결과인 정수 객체에 number를 다시 연결한다. 이때 결과 객체를 항상 새로 생성해야 하는 것은 아니다.
반면 리스트의 `+=`는 기존 객체를 변경할 수 있다.
def extend_list(items):
    items += [4]

numbers = [1, 2, 3]

extend_list(numbers)

print(numbers)  # [1, 2, 3, 4]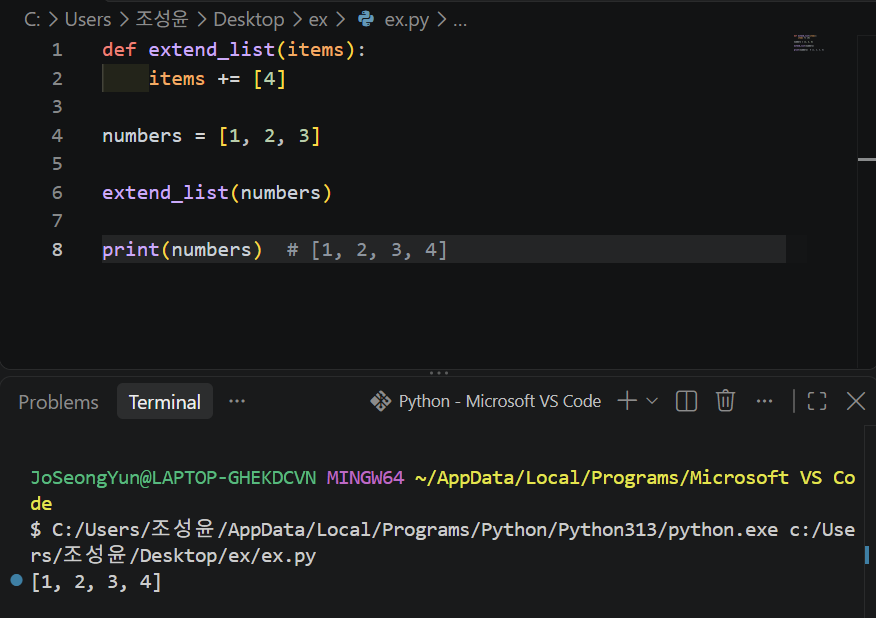
4편에서 살펴봤듯이 +=의 동작은 객체의 자료형에 따라 달라질 수 있다.
결국 함수 안에서 원본 객체가 변경되는지는 단순히 가변 객체를 전달했느냐보다 기존 객체의 내용을 수정했는지, 이름을 다른 객체에 재대입했는지에 달려 있다.
원본을 변경하고 싶지 않다면?
기존 리스트를 수정하지 않고 새로운 리스트를 반환하도록 작성할 수도 있다.
def add_item(items, value):
    new_items = items.copy()
    new_items.append(value)
    return new_items

numbers = [1, 2, 3]

result = add_item(numbers, 4)

print(numbers)
print(result)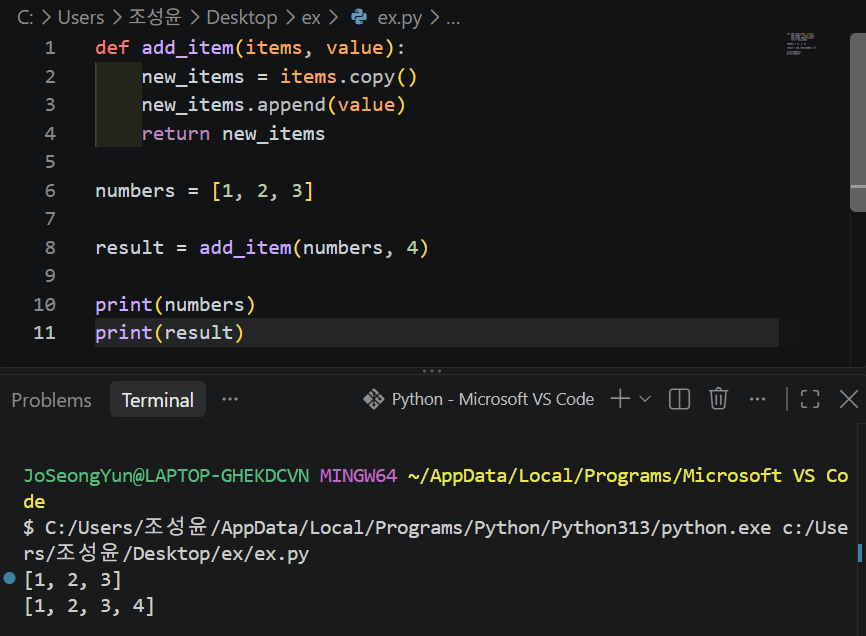
[1, 2, 3]
[1, 2, 3, 4]
여기서는 copy()로 새로운 리스트를 만들었기 때문에 원본의 최상위 리스트는 변경되지 않는다.
다만 5편에서 살펴본 것처럼 copy()는 얕은 복사이므로, 중첩된 가변 객체까지 독립적으로 복사되는 것은 아니다.
6. return은 어떤 역할을 할까?
함수에서는 return을 사용해 호출한 곳으로 결과를 반환할 수 있다.
def add(a, b):
    return a + b

result = add(10, 20)

print(result)30return을 만나면 함수 실행이 종료되고, 지정한 객체가 호출한 곳으로 반환된다.
그런데 return과 print()를 혼동하는 경우가 있다.
다음 두 함수를 비교해 보자.
def print_add(a, b):
    print(a + b)

def return_add(a, b):
    return a + b
두 함수를 호출하면 모두 계산 결과를 확인할 수 있다.
print_add(10, 20)

print(return_add(10, 20))
30
30하지만 반환값은 서로 다르다.
a = print_add(10, 20)
b = return_add(10, 20)

print(a)
print(b)
30
None
30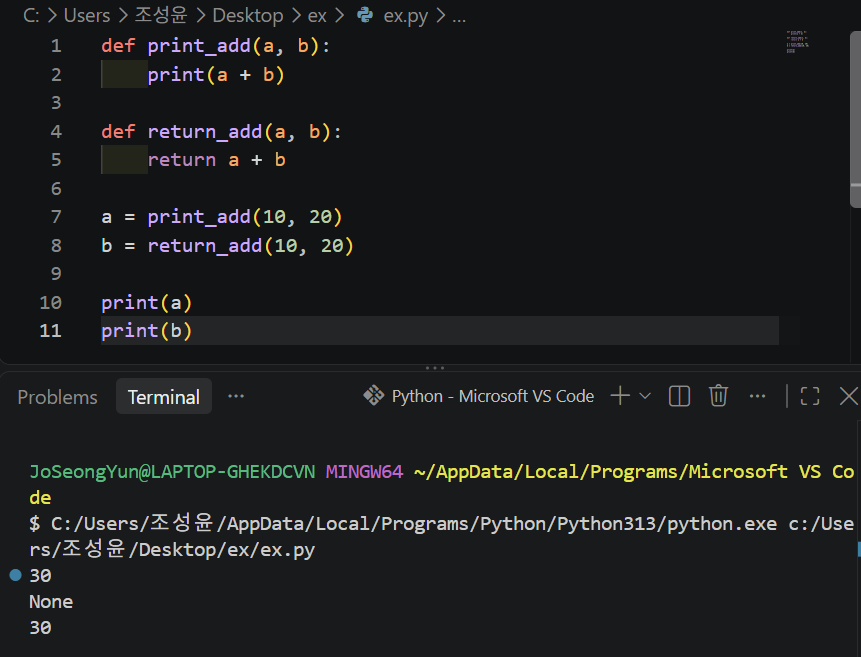
print_add()는 계산 결과를 화면에 출력하지만 명시적인 반환값은 없다.
일반 함수는 본문 끝에 도달하거나 값 없는 return으로 정상 종료하면 None을 반환한다. 예외가 발생해 종료된 경우와는 구분해야 한다.
반면 return_add()는 계산 결과를 호출한 곳으로 반환하기 때문에 다른 연산에도 사용할 수 있다.
result = return_add(10, 20) * 2

print(result)  # 60
return 역시 객체를 자동으로 복사하지 않는다.
def get_items(items):
    return items

numbers = [1, 2, 3]

result = get_items(numbers)

print(result is numbers)  # True
반환받은 result는 기존 numbers와 동일한 리스트 객체를 참조한다.
따라서 반환된 객체가 가변 객체라면, 이후 한쪽에서 내용을 변경했을 때 다른 쪽에서도 변경된 내용이 보일 수 있다.
7. 위치 인자와 키워드 인자는 무엇일까?
파이썬에서는 함수를 호출할 때 인자를 전달하는 방법이 여러 가지 있다.
대표적으로 위치 인자(Positional Argument)와 키워드 인자(Keyword Argument)가 있다.
위치 인자
위치 인자는 전달한 순서에 따라 매개변수에 연결된다.
def introduce(name, age):
    print(f"이름: {name}, 나이: {age}")

introduce("Kim", 24)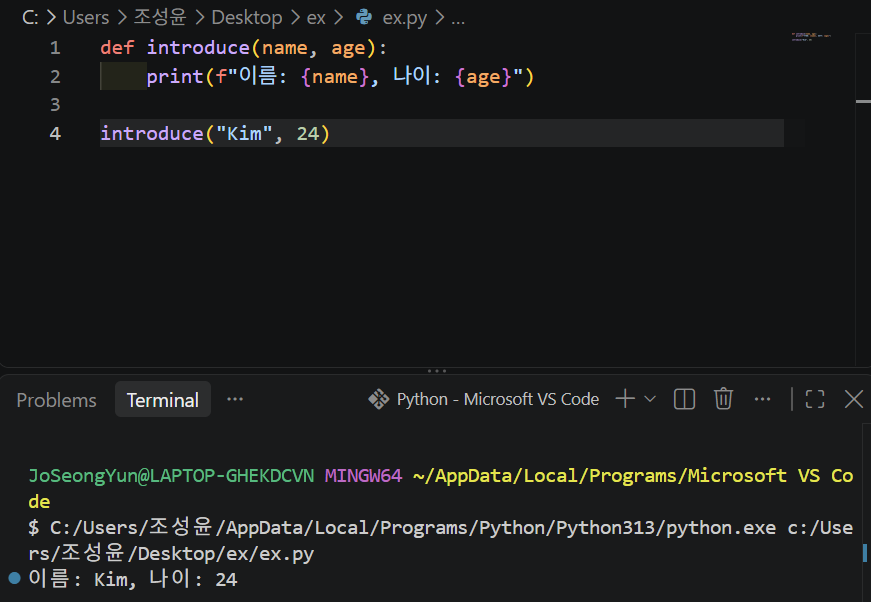
이름: Kim, 나이: 24첫 번째 인자인 "Kim"은 name에, 두 번째 인자인 24는 age에 연결된다.
키워드 인자
키워드 인자는 매개변수의 이름을 명시해 값을 전달한다.
introduce(age=24, name="Kim")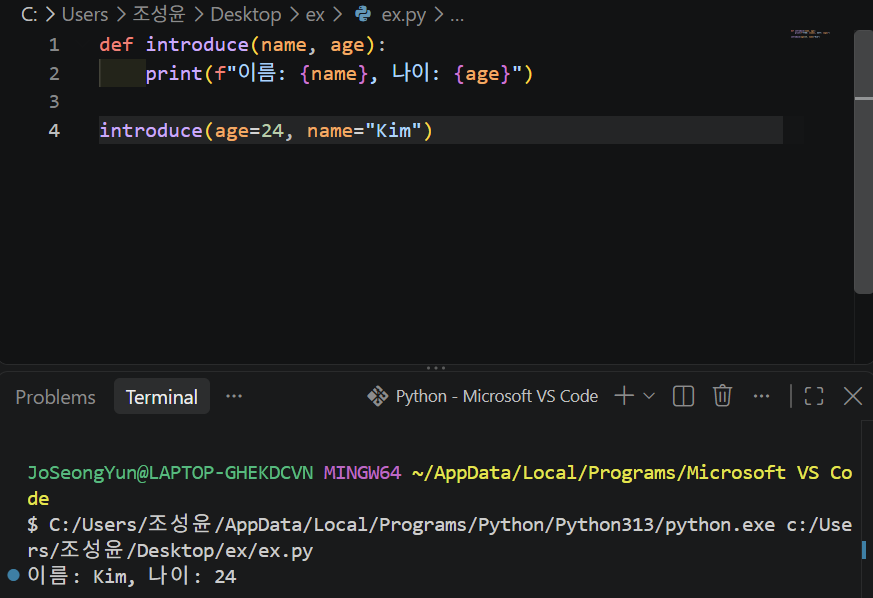
이름: Kim, 나이: 24이 경우 인자의 작성 순서가 달라도 올바르게 전달된다.
위치 인자와 키워드 인자를 함께 사용할 수도 있다.
introduce("Kim", age=24)다만 하나의 매개변수에 값을 중복해서 전달할 수는 없다.
introduce("Kim", name="Lee")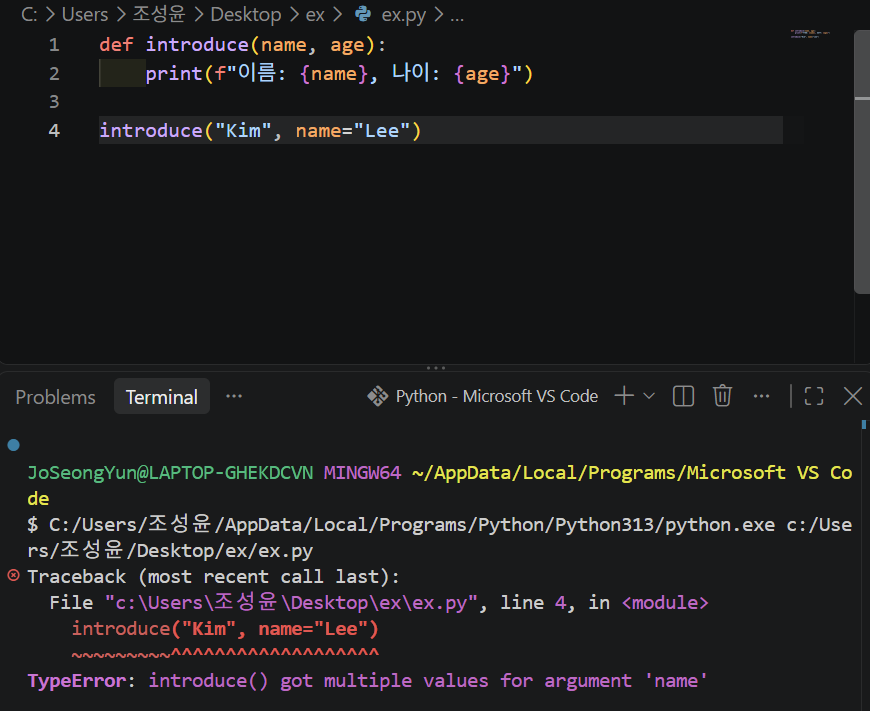
위 코드는 name에 두 개의 값을 전달하려 하므로 TypeError가 발생한다.
일반적으로 위치 인자를 먼저 작성하고, 그 뒤에 키워드 인자를 작성한다.
8. 기본 인자는 언제 만들어질까?
함수의 매개변수에는 기본값을 지정할 수 있다.
def greeting(name, message="안녕하세요"):
    print(f"{name}님, {message}")

greeting("Kim")
greeting("Lee", "반갑습니다")
Kim님, 안녕하세요
Lee님, 반갑습니다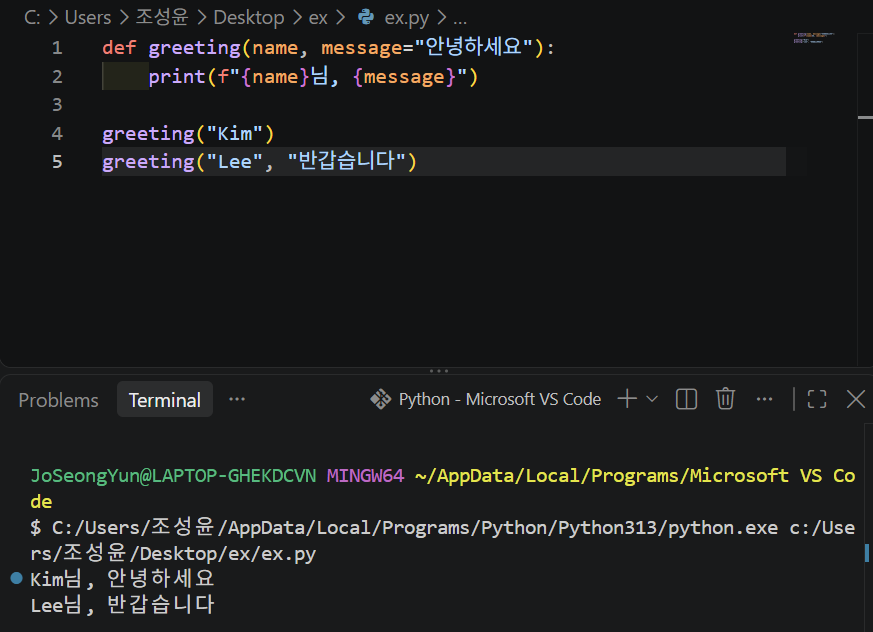
message에 인자를 전달하지 않으면 기본값인 "안녕하세요"가 사용된다.
그런데 여기에는 주의해야 할 특징이 있다.
파이썬의 기본 인자 표현식은 '함수를 정의'할 때 평가된다.
다음 코드를 보자.
def add_item(item, items=[]):
    items.append(item)
    return items

print(add_item(1))
print(add_item(2))
print(add_item(3))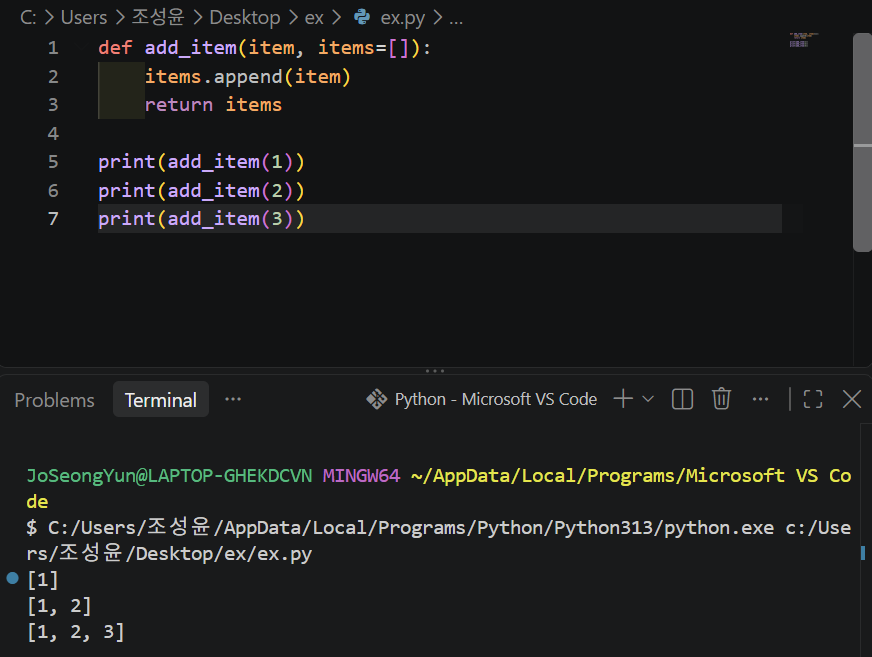
실행 결과는 다음과 같다.
[1]
[1, 2]
[1, 2, 3]
매번 함수를 새롭게 호출했는데, 이전에 추가한 값이 남아 있다.
왜 그럴까?
items=[]의 빈 리스트는 호출할 때마다 만드는 것이 아니라, 해당 def 문이 실행될 때 생성되어 그 함수 객체의 기본값으로 재사용되기 때문이다. 같은 def 문을 다시 실행하면 새로운 함수 객체와 기본값이 만들어진다.
| 시점 | 기본값 리스트의 내용 |
|---|---|
def 실행 | [] |
add_item(1) 이후 | [1] |
add_item(2) 이후 | [1, 2] |
add_item(3) 이후 | [1, 2, 3] |
함수 내부에서 append()로 기본값 리스트를 변경했기 때문에 다음 호출에서도 변경된 리스트가 사용된 것이다.
그렇다면 호출할 때마다 새로운 리스트를 사용하려면 어떻게 해야 할까?
보통 None을 기본값으로 지정하고 함수 내부에서 새로운 리스트를 생성한다.
def add_item(item, items=None):
    if items is None:
        items = []

    items.append(item)
    return items

print(add_item(1))
print(add_item(2))
print(add_item(3))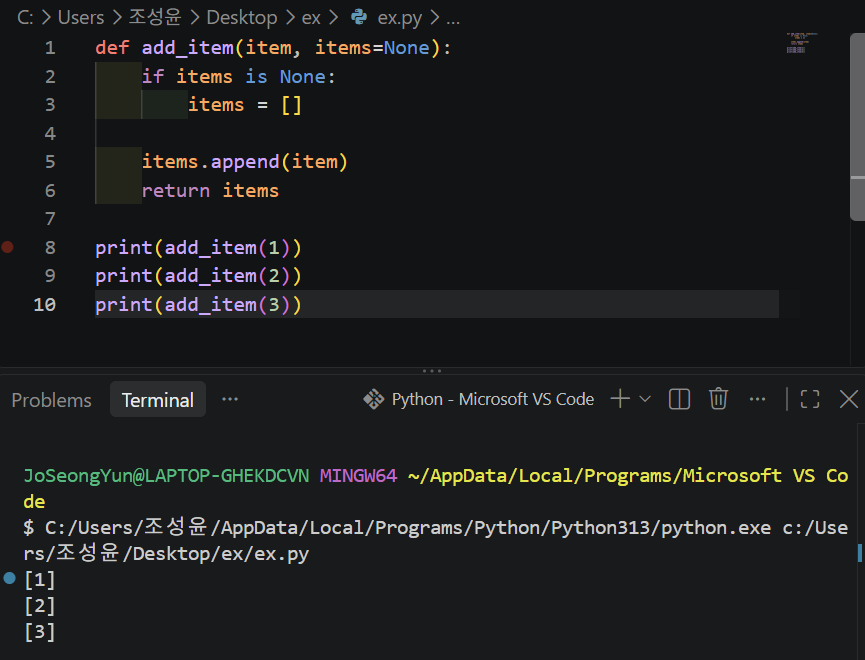
[1]
[2]
[3]
이제 items를 전달하지 않은 호출에서는 매번 새로운 리스트를 생성한다.
물론 리스트를 명시적으로 전달하면 해당 리스트를 수정한다.
numbers = [10, 20]

add_item(30, numbers)

print(numbers)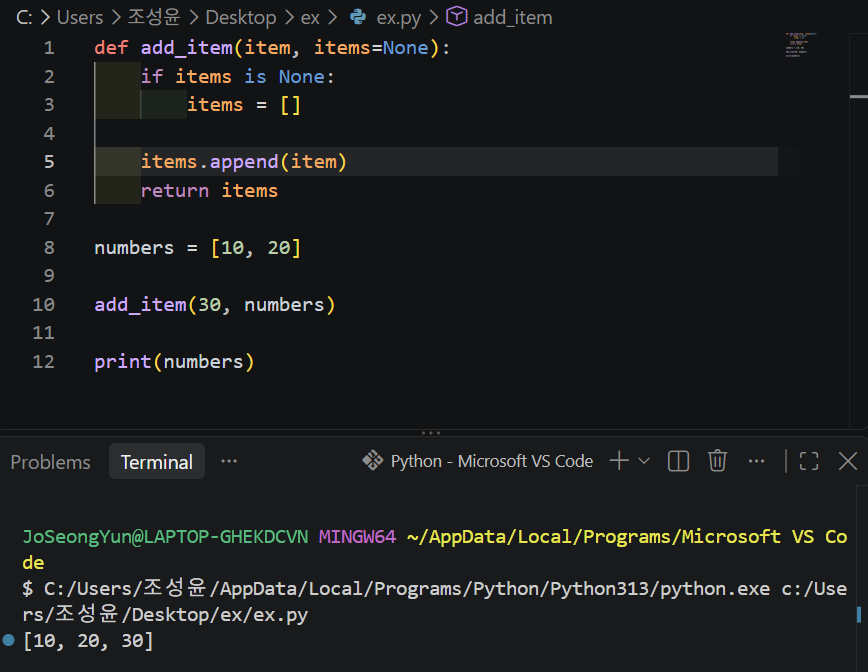
[10, 20, 30]따라서 리스트나 딕셔너리처럼 변경 가능한 객체를 기본값으로 사용할 때는 의도하지 않은 상태 공유가 발생하지 않도록 주의해야 한다.
기본 인자 표현식은 함수 정의 시점에 한 번 평가되며, 생성된 객체는 이후 호출에서 재사용될 수 있다.
9. *args와 **kwargs는 무엇일까?
지금까지는 함수가 전달받을 인자의 개수를 미리 정해놓았다.
그런데 전달해야 할 인자의 개수가 매번 달라진다면 어떻게 해야 할까?
이럴 때 사용할 수 있는 것이 *args와 **kwargs다.
*args : 여러 위치 인자 받기
def add_all(*args):
    print(args)
    return sum(args)

result = add_all(10, 20, 30)

print(result)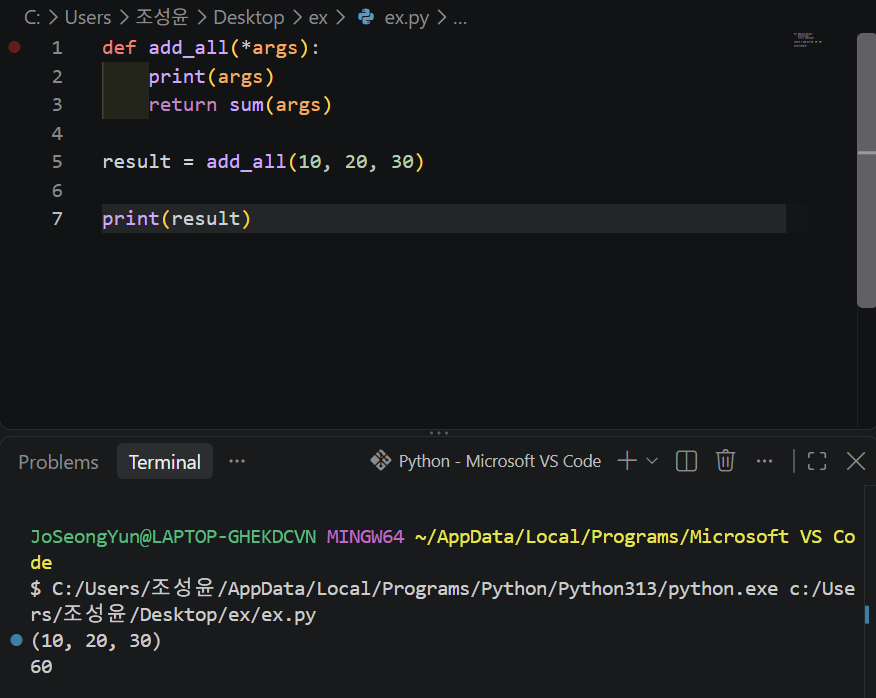
(10, 20, 30)
60*args는 일반 매개변수에 연결되고 남은 위치 인자를 하나의 튜플로 모은다. 이 예시에는 앞선 일반 매개변수가 없으므로 모든 위치 인자가 들어간다.
따라서 인자의 개수가 달라져도 처리할 수 있다.
print(add_all(1, 2))
print(add_all(1, 2, 3, 4))
**kwargs : 여러 키워드 인자 받기
def show_info(**kwargs):
    print(kwargs)

show_info(name="Kim", age=24)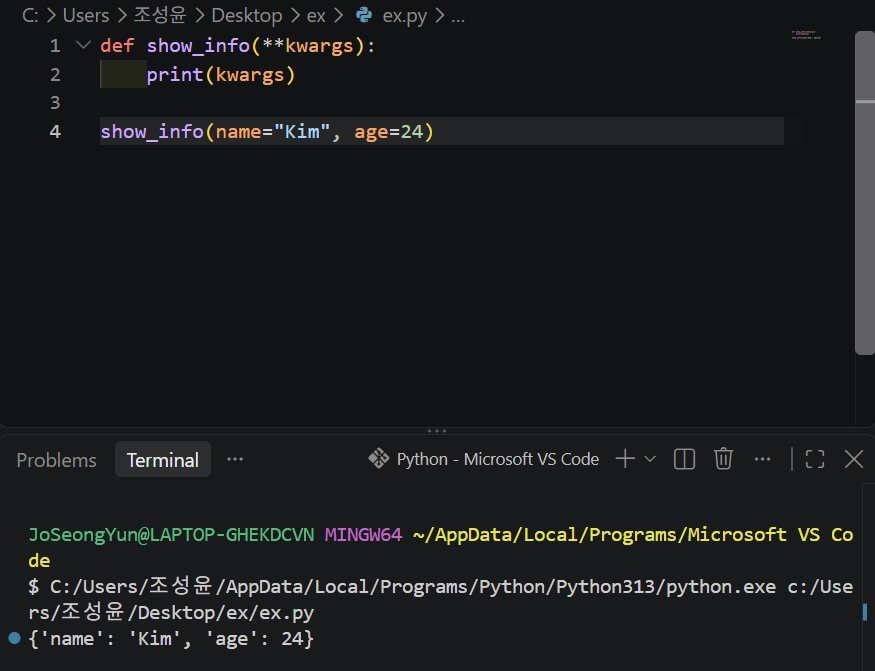
{'name': 'Kim', 'age': 24}**kwargs는 명시된 매개변수에 연결되지 않은 나머지 키워드 인자를 딕셔너리로 모은다.
두 방식을 함께 사용할 수도 있다.
def show_data(*args, **kwargs):
    print("위치 인자:", args)
    print("키워드 인자:", kwargs)

show_data(10, 20, name="Kim", age=24)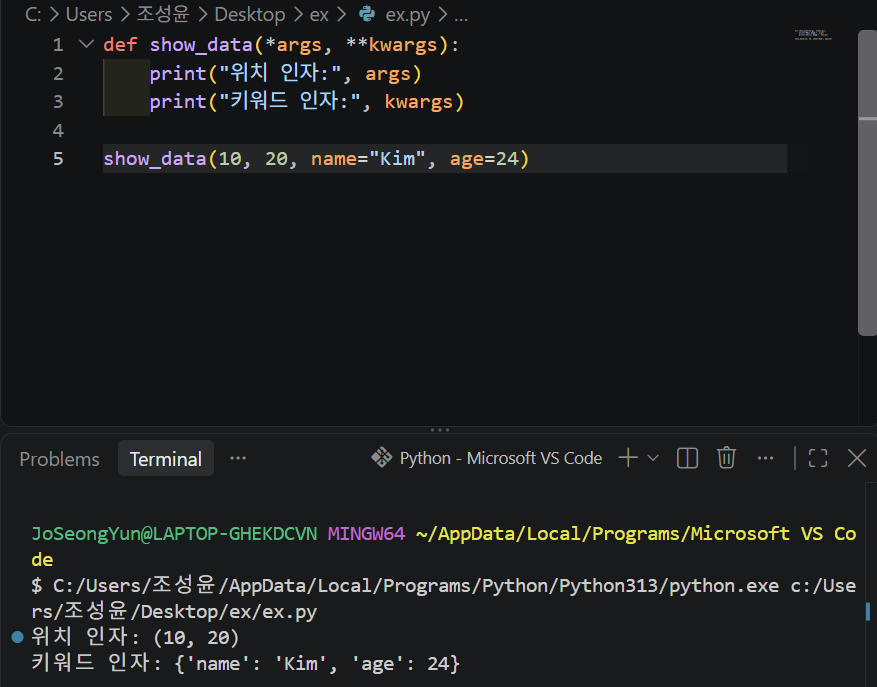
위치 인자: (10, 20)
키워드 인자: {'name': 'Kim', 'age': 24}
정리하면 다음과 같다.
| 구분 | 받는 인자 | 함수 내부 자료형 |
|---|---|---|
*args | 여러 위치 인자 | tuple |
**kwargs | 여러 키워드 인자 | dict |
여기서 args와 kwargs라는 이름은 관례일 뿐이며, 실제로 중요한 것은 *와 ** 기호다.
또한 두 기호는 함수를 호출할 때 리스트나 딕셔너리의 내용을 인자로 풀어 전달하는 데도 사용된다.
def add(a, b):
    return a + b

numbers = [10, 20]

print(add(*numbers))  # 30
values = {"a": 10, "b": 20}
print(add(**values)) # 30첫 번째 코드는 리스트의 요소를 위치 인자로, 두 번째 코드는 딕셔너리의 키와 값을 키워드 인자로 전달한다.
마무리
함수 안팎에서도 변수와 객체의 관계는 같았다. 매개변수는 전달된 객체에 연결되는 이름이고, 인자를 전달하거나 반환한다고 해서 객체가 자동으로 복사되지는 않는다.
그래서 공유 중인 리스트에 append()하면 호출한 쪽에서도 변경이 보이지만, 매개변수에 새 리스트를 대입하면 그 이름의 연결만 바뀐다. 기본값으로 만든 리스트가 다음 호출에서도 남는 이유 역시 같은 객체를 다시 사용하기 때문이다.
함수를 작성할 때는 인자와 반환값뿐 아니라 전달받은 객체를 직접 수정하는지도 확인해야겠다.
다음 글에서는 이름을 찾는 범위를 살펴보려고 한다. 함수 안팎의 이름은 어떻게 구분되고, 같은 이름이 있으면 어느 쪽을 사용할까?