< 필수 기능 구현 >
1. 문제
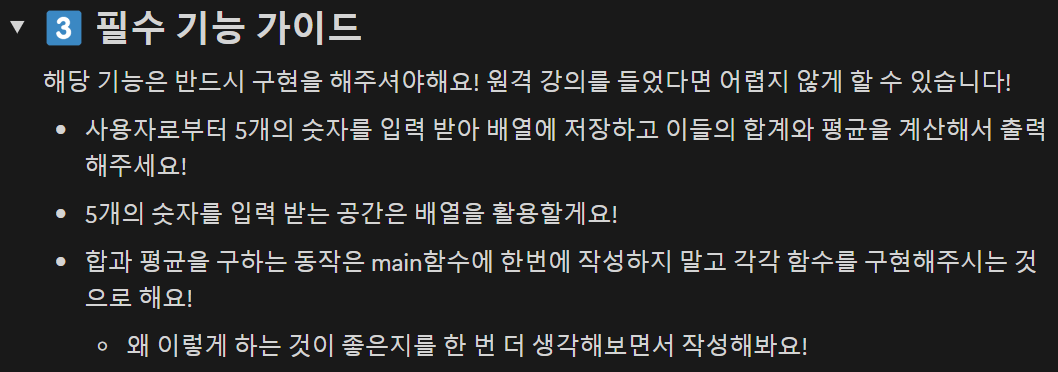
2. 완성 코드
#include <iostream>
#include <cmath>

using namespace std;

// 배열의 합을 구하는 함수
int Sum(const int num[], int size)
{
    int result = 0;
    for (int i = 0; i < size; i++)
    {
        result += num[i];
    }
    return result;
}

// 평균을 구하는 함수
double Avg(const int num[], int size)
{
    if (size == 0)
    {
        cout << "0으로 나눌 수 없습니다." << endl;
        return -1;  // 오류 코드 반환
    }

    double total_num = Sum(num, size);

    return total_num / size;
}

int main()
{
    const int kSize = 5;
    int num[kSize];  // 5개의 숫자를 입력받을 배열

    cout << "5개의 숫자를 입력하시오. " << endl;
    for (int i = 0; i < kSize; i++)
    {
        cin >> num[i];
    }

    int total_num = Sum(num, kSize);  // 총합 계산
    double result = Avg(num, kSize);  // 평균 계산

    if (result != -1)  // 평균이 정상적으로 계산되었을 경우에만 출력
    {
        cout.precision(4);  // 소수점 4자리까지 출력
        cout << fixed; // 소수점 고정
        cout << "평균 : " << result << endl;
    }

    return 0;
}
3. 체크 포인트
▸ 부동소수점
- 부동소수점 데이터 타입
- float : 4바이트 크기, 대략 7자리의 정확도, 접미사 f를 붙여주어야 함
- double : 8바이트 크기, 대략 15자리의 정확도
- long double : 보통 8바이트 이상의 크기, double보다 높은 정밀도
- 부동소수점 출력
- precision : 출력하는 실수 전체 자릿수 중 원하는 자릿수만큼 출력 (원하는 자릿수가 실제 자릿수보다 더 적을 경우 반올림 됨)
    double a = 1111.123456789;

    std::cout.precision(6);
    std::cout << a << std::endl;
    //출력 : 1111.12

    std::cout.precision(8);
    std::cout << a << std::endl;
//출력 : 1111.1235- fixed : 정수부를 신경쓰지 않고 소수부를 고정 (즉, n만큼의 소수부를 출력)
	double a = 1111.123456789;
    std::cout.precision(8);
    std::cout << std::fixed;

    std::cout << a << std::endl;
    //출력 : 1111.12345679
< 도전 기능 구현 >
1. 문제
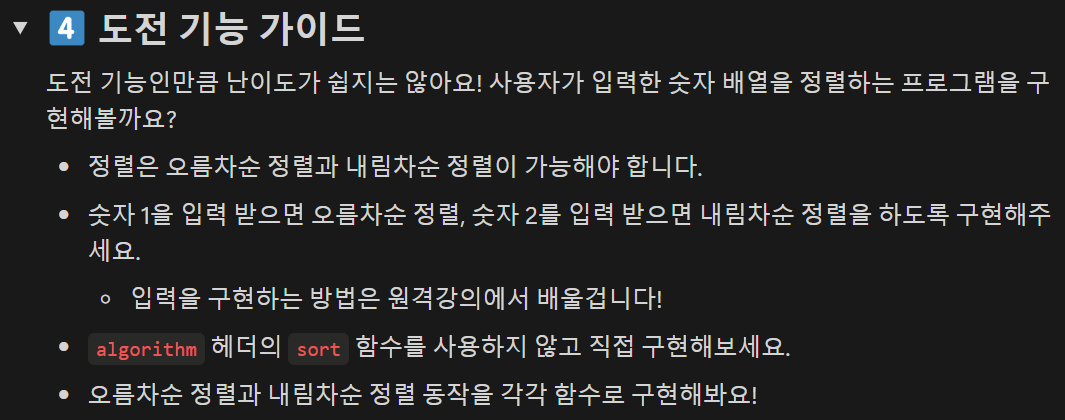
2. 완성 코드
#include <iostream>

using namespace std;

// 내림차순 정렬 함수
void DescendingSort(int num[], int size)
{
    // 배열을 정렬하기 위한 두 개의 중첩된 for문
    for (int i = 0; i < size - 1; i++)
    {
        for (int j = i + 1; j < size; j++)
        {
            // 현재 num[i]가 num[j]보다 작으면 두 값을 교환
            if (num[i] < num[j])
            {
                int temp = num[i];
                num[i] = num[j];
                num[j] = temp;
            }
        }
    }
}

// 오름차순 정렬 함수
void AscendingSort(int num[], int size)
{
    // 배열을 정렬하기 위한 두 개의 중첩된 for문
    for (int i = 0; i < size - 1; i++)
    {
        for (int j = i + 1; j < size; j++)
        {
            // 현재 num[i]가 num[j]보다 크면 두 값을 교환
            if (num[i] > num[j])
            {
                int temp = num[i];
                num[i] = num[j];
                num[j] = temp;
            }
        }
    }
}

int main()
{
    const int kSize = 5;  // 배열의 크기 설정
    int num[kSize];  // 정수 배열 선언
    int type;  // 정렬 방식 선택을 위한 변수

    // 사용자에게 숫자 5개를 입력받도록 요청
    cout << "5개의 숫자를 입력하시오." << endl;

    // 사용자로부터 숫자 5개 입력받기
    for (int i = 0; i < kSize; i++)
    {
        cin >> num[i];
    }

    // 사용자에게 정렬 방식을 선택하도록 요청
    cout << "정렬 방식을 선택하시오. 1-오름차순 / 2-내림차순" << endl;
    cin >> type;  // 정렬 방식 입력받기

    // 선택된 정렬 방식에 따라 분기
    switch (type)
    {
    case 1:
        // 오름차순 정렬
        AscendingSort(num, kSize);
        break;
    case 2:
        // 내림차순 정렬
        DescendingSort(num, kSize);
        break;
    default:
        // 잘못된 번호 입력 시 메시지 출력
        cout << "잘못된 번호입니다." << endl;
        cout << "1-오름차순 / 2-내림차순" << endl;
        break;
    }

    // 정렬된 배열을 출력
    for (int i = 0; i < kSize; i++)
    {
        cout << num[i] << " ";
    }

    return 0;  // 프로그램 종료
}
i번째 값을 i-1 ~ 0번째 값들과 비교하여 정렬이 맞지 않으면 두 수를 스왑해주는 방식을 사용했음
3. 체크 포인트
▸ 버블 정렬 (Bubble Sort)
- 동작 방식
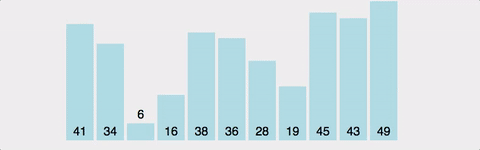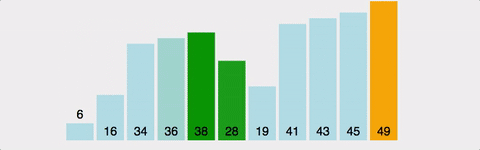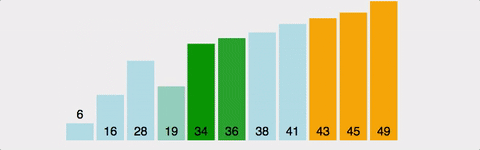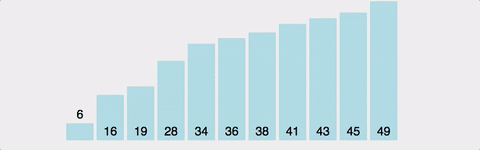
- 정렬 알고리즘 중 가장 단순한 알고리즘
- 서로 인접해 있는 요소 간의 대소 비교를 통해 정렬
- 비효율적
- 시간 복잡도
- Best, Avg, Worst : O(n^2)
- 공간 복잡도
- O(n)
▸ 삽입 정렬 (Insert Sort)
- 동작 방식
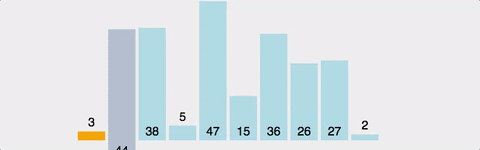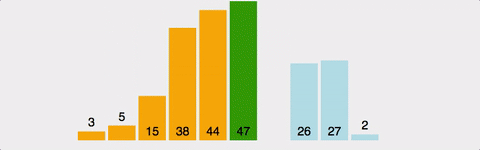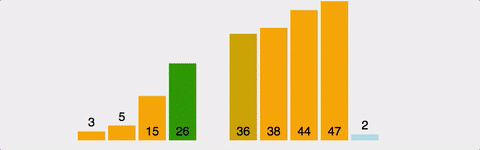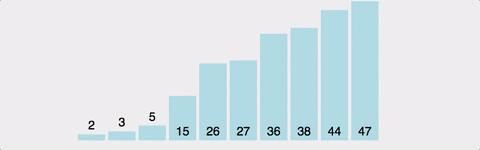
- 배열을 정렬된 부분과 정렬되지 않은 부분으로 나누고, 정렬되지 않은 부분의 첫 번째 원소를 정렬된 부분에 적절한 위치에 삽입하는 방식
- 알고리즘이 동작하는 동안 계속해서 정렬이 진행되므로 반드시 맨 왼쪽 index까지 탐색하지 않아도 된다는 장점이 있음
- 시간 복잡도
- Best : O(n)
- Avg, Worst : O(n^2)
- 공간 복잡도
- O(n)
▸ 선택 정렬 (Selection Sort)
- 동작 방식
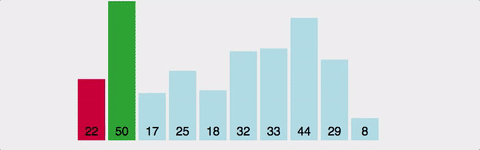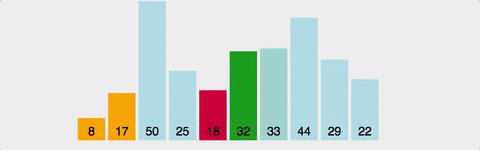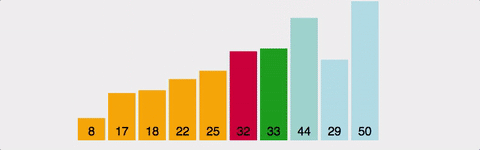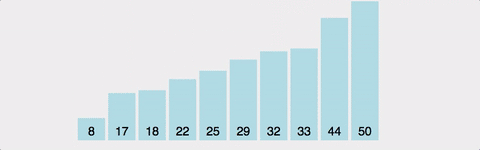
- 주어진 배열에서 가장 작은 값을 찾아 첫 번째 원소와 스왑한 후, 그 다음으로 작은 값을 두 번째 원소와 스왑하는 방식을 반복하며 정렬
- 비효율적
- 시간 복잡도
- Best, Avg, Worst : O(n^2)
- 공간 복잡도
- O(n)
💡 선택 정렬과 삽입 정렬
- 선택 정렬과 삽입 정렬은 k번째 반복 이후, 첫 번째 k요소가 정렬된 순서로 나온다는 점에서 유사함
- But 선택 정렬은 k+1번째 요소를 찾기 위해 나머지 모든 요소들을 탐색, 삽입 정렬은 k+1번째 요소를 배치하는 데 필요한 만큼의 요소만 탐색하기 때문에 훨씬 효율적으로 실행됨
▸ 퀵 정렬 (Quick Sort)
- 동작 방식
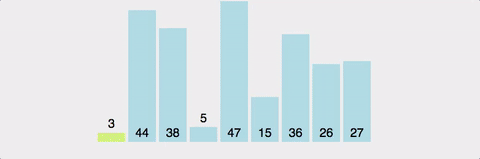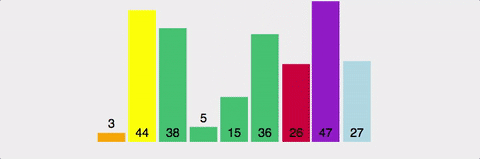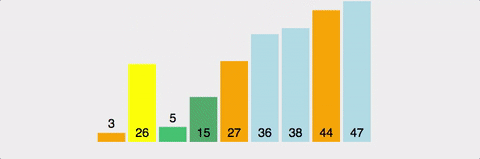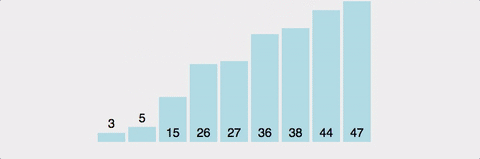
- 분할 정복 방식을 사용하여 배열을 피벗(pivot)을 기준으로 두 부분으로 나눈 후 각 부분을 재귀적으로 정렬
- 데이터 중 임의의 기준값(pivot)을 정해서 두 부분 집합으로 나눔
- 왼쪽은 피벗보다 작은 값, 오른쪽은 피벗보다 큰 값을 배치
- 더 이상 집합을 나눌 수 없을 때까지 재귀적으로 실행
- 삽입 정렬과 반대로 이미 정렬된 데이터라면 매우 비효율적으로 작용
- 시간 복잡도
- Best, Avg : O(n log n)
- Worst : O(n^2)
- 공간 복잡도
- O(n)
▸ 병합 정렬 (Merge Sort)
- 동작 방식
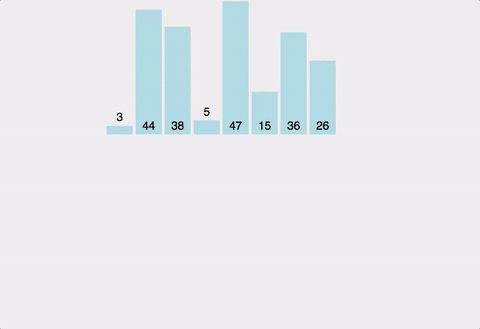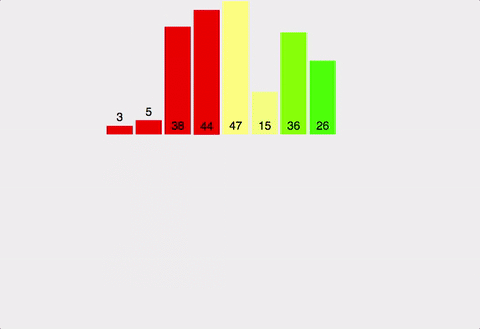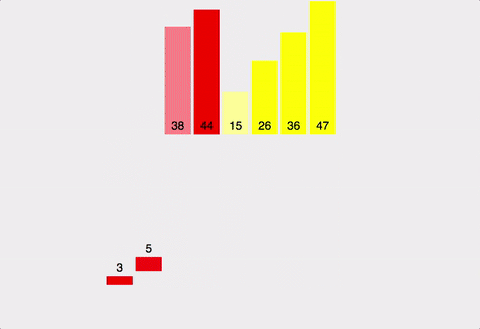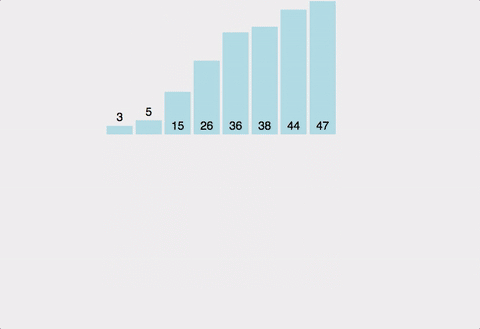
- 분할 정복(Divide and Conquer) 방식을 사용하여 배열을 반으로 나눈 후 각 부분을 재귀적으로 정렬하고, 나중에 병합하여 정렬된 배열을 생성
- 비교 기반 알고리즘
- 순차적인 비교로 정렬을 진행하므로, LinkedList 정렬이 필요할 때 사용하면 효율적
- 항상 일정한 시간 복잡도를 유지하므로 퀵 정렬의 한계점을 보완할 수 있는 장점이 있지만, 다른 알고리즘과 비교했을 때 O(n) 수준의 메모리가 추가로 필요하다는 단점이 있음
- 시간 복잡도
- Best, Avg, Worst : O(n log n)
- 공간 복잡도
- O(n)
💡 퀵 정렬과 병합 정렬
- 퀵 정렬 : 우선 피벗을 통해 정렬 → 영역을 쪼갬
- 병합 정렬 : 영역을 쪼갤 수 있을 만큼 쪼갬 → 정렬
▸ 힙 정렬 (Heap Sort)
- 동작 방식
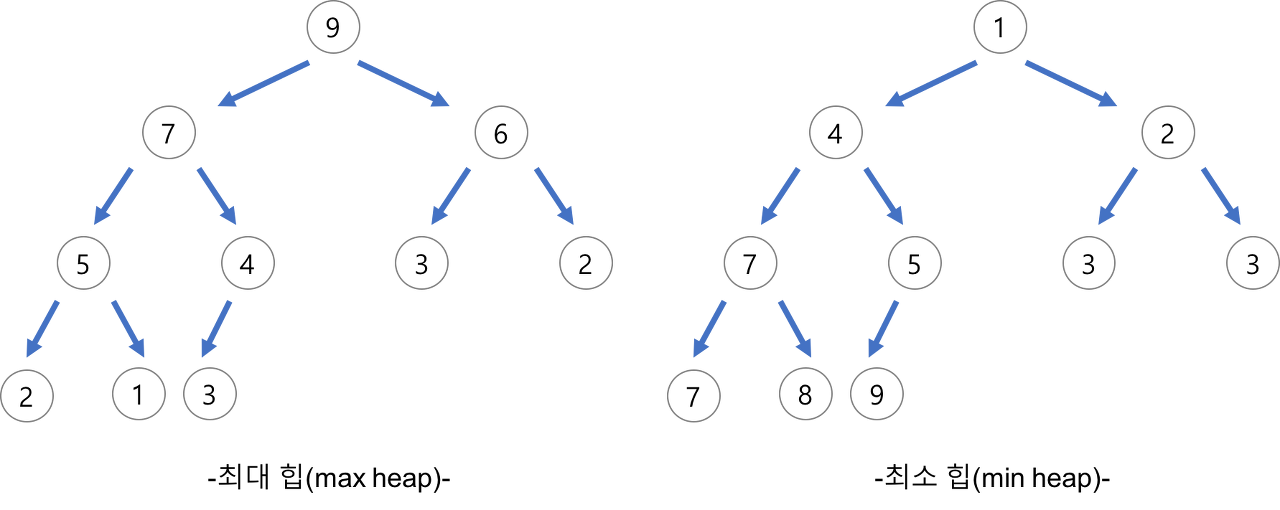
- 힙 자료구조를 사용하여 정렬을 수행하는 방식
- 주어진 배열을 최대 힙 또는 최소 힙으로 구성한 후 힙에서 원소를 하나씩 꺼내 정렬
- 완전 이진트리 사용
💡 힙 (Heap)
- 완전 이진 트리이기 때문에 적절히 중간 레벨의 노드를 추출하면 중앙값에 가까운 값을 근사치로 바르게 추출할 수 있음
- 균형을 유지하려는 특징 때문에 우선순위 큐, 다익스트라, 힙 정렬, 프림 알고리즘에 활용됨
- 시간 복잡도
- Best, Avg, Worst : O(n log n)
- 공간 복잡도
- O(1)