Kafka 소개
Kafka란 실시간 데이터를 처리하기 위해 설계된 오픈소스 분산 스트리밍 플랫폼이다.
2008년 LinkedIn에서 내부 실시간 데이터 처리를 위해 개발되었고, Scala와 Java로 작성되었다. 이후 2011년에 오픈소스화 되었다.
특징
Kafka는 데이터를 partition으로 나눠 다수의 broker(서버)에 저장하는 분산 아키텍처를 따르기 때문에 Scale Out의 형태로 확장 가능한 Scalability(확장성)을 갖는다.
또한 한 partition은 데이터 유실 방지를 위해 3개의 broker에 저장되어 Fault Tolerance(내결함성)를 제공한다.
High Throughput(높은 처리량)과 reasonable하게 낮은 Low Latency(낮은 지연시간/처리속도)를 가지며 정해진 보유기한(default = a week)동안 메시지를 저장하는 Publish-subscription(Producer-Consumer) 메시징 시스템이다.
기존 메시징 시스템 및 DB와 비교
기존의 메시징 시스템은 consumer가 한 번 읽어가면 메시지를 Queue에서 삭제했으나, Kafka는 consumer가 읽어감 여부에 관계 없이 보유기간 동안 저장하기 때문에 다수의 소비자에 동일 데이터를 지원하는 데 문제를 겪지 않는다.
Kafka는 메시지의 생산과 소비를 분리해 독립적으로 작업이 가능하도록 하여 시스템의 안정성을 높였다.
한 파티션 내에서는 메시지의 순서가 데이터의 순서와 같아 순서를 보장할 수 있다. 토픽을 생성할 때 eventual consistency와 strong consistency중 지정할 수 있다.
➕ Eventual Consistency vs. Strong Consistency
분산 시스템에서 보통 하나의 데이터 블록은 여러 서버에 나뉘어 저장된다. 그래서 데이터를 쓰거나 수정하면 모든 replication에 복제될 때까지 시간이 소요된다.
Eventual Consistency란 이런 분산 시스템에서 데이터를 읽을 때 모든 replication에 복제될 때까지 기다리지 않고 n개에 복제가 완료되면 리턴하는 방식이다.
읽기는 보통 여러개의 replication 중에 하나를 대상으로 일어나기 때문에 데이터를 수정하고 읽은 경우 해당 데이터가 new data일 수도 있고 old data일 수도 있다.
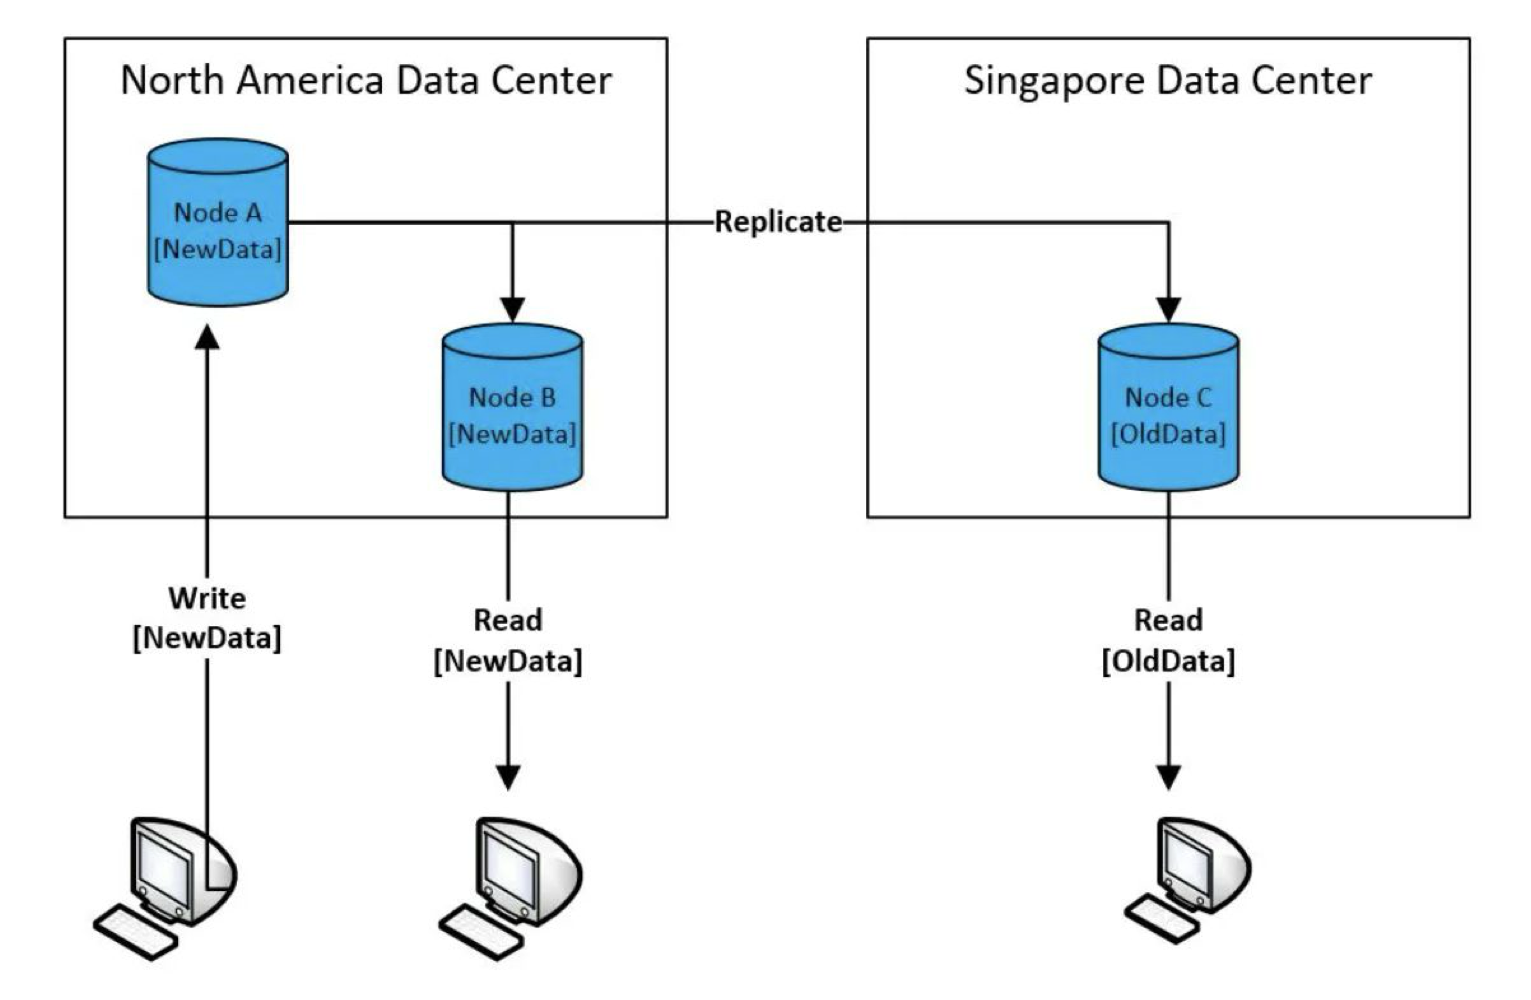
반면 Strong Consistency는 복제가 완료될 때까지 기다리는 구조이다. 따라서 Strong Consistency를 따른다면 항상 new data를 받는 것을 보장할 수 있다.
Eventual Consistency는 쓰는(write/modify) 시간이 적게 걸리는 대신 읽을 때 데이터의 일관성이 떨어질 수있고,
Strong Consistency는 쓰는 시간이 비교적 오래 걸리는 대신 읽을 때 데이터의 일관성이 높다.
참고
데브코스 수업 자료
Amazon DynamoDB Document