낙관적 락이란,
If data conflicts are rare, a strategy where data is read without placing any physical locks.
"충돌은 드물게 일어날 것"이라는 가정을 전제로 하는 전략이다. 그래서 미리 락을 걸어 접근을 막는 대신, 일단 읽고 실행한 뒤 저장하는 시점에만 충돌 여부를 검사한다.
- READ > 그냥 읽기
- UPDATE/DELETE > version 체크하고 적용하기
즉, 선 실행 후 검사(optimistic) 방식이다.
같은 글에 대한 "좋아요"를 여러 사람이 동시에 누르는 상황을 가정하며 낙관락을 적용해 보았다.
Spring에서 낙관적 락 구현, @Version
public class Post {
    ...

    @Version
    private Long version;

    ...
}
이처럼 낙관적 락이 필요한 엔티티에 @Version을 붙인 필드를 생성한다.
그러면 객체의 인스턴트가 생성될 때, 즉, INSERT 구문이 생성될 때, 이 값은 초기화된다.
또, UPDATE나 DELETE의 변경 구문의 실행 시에 WHERE id = ? AND version= ?로 version의 값의 조건이 자동으로 붙으므로써, version 값을 체크하여 충돌을 방지한다.
충돌이 감지될 경우, 해당 로직을 재시도한다. 재시도 로직이 없을 경우, 충돌이 감지되면 JPA가 낙관적 락 예외를 발생시키며, 해당 트랜잭션에서 수행한 변경 사항은 커밋되지 않고 rollback된다.
Before: 재시도 로직 없이 구현할 경우
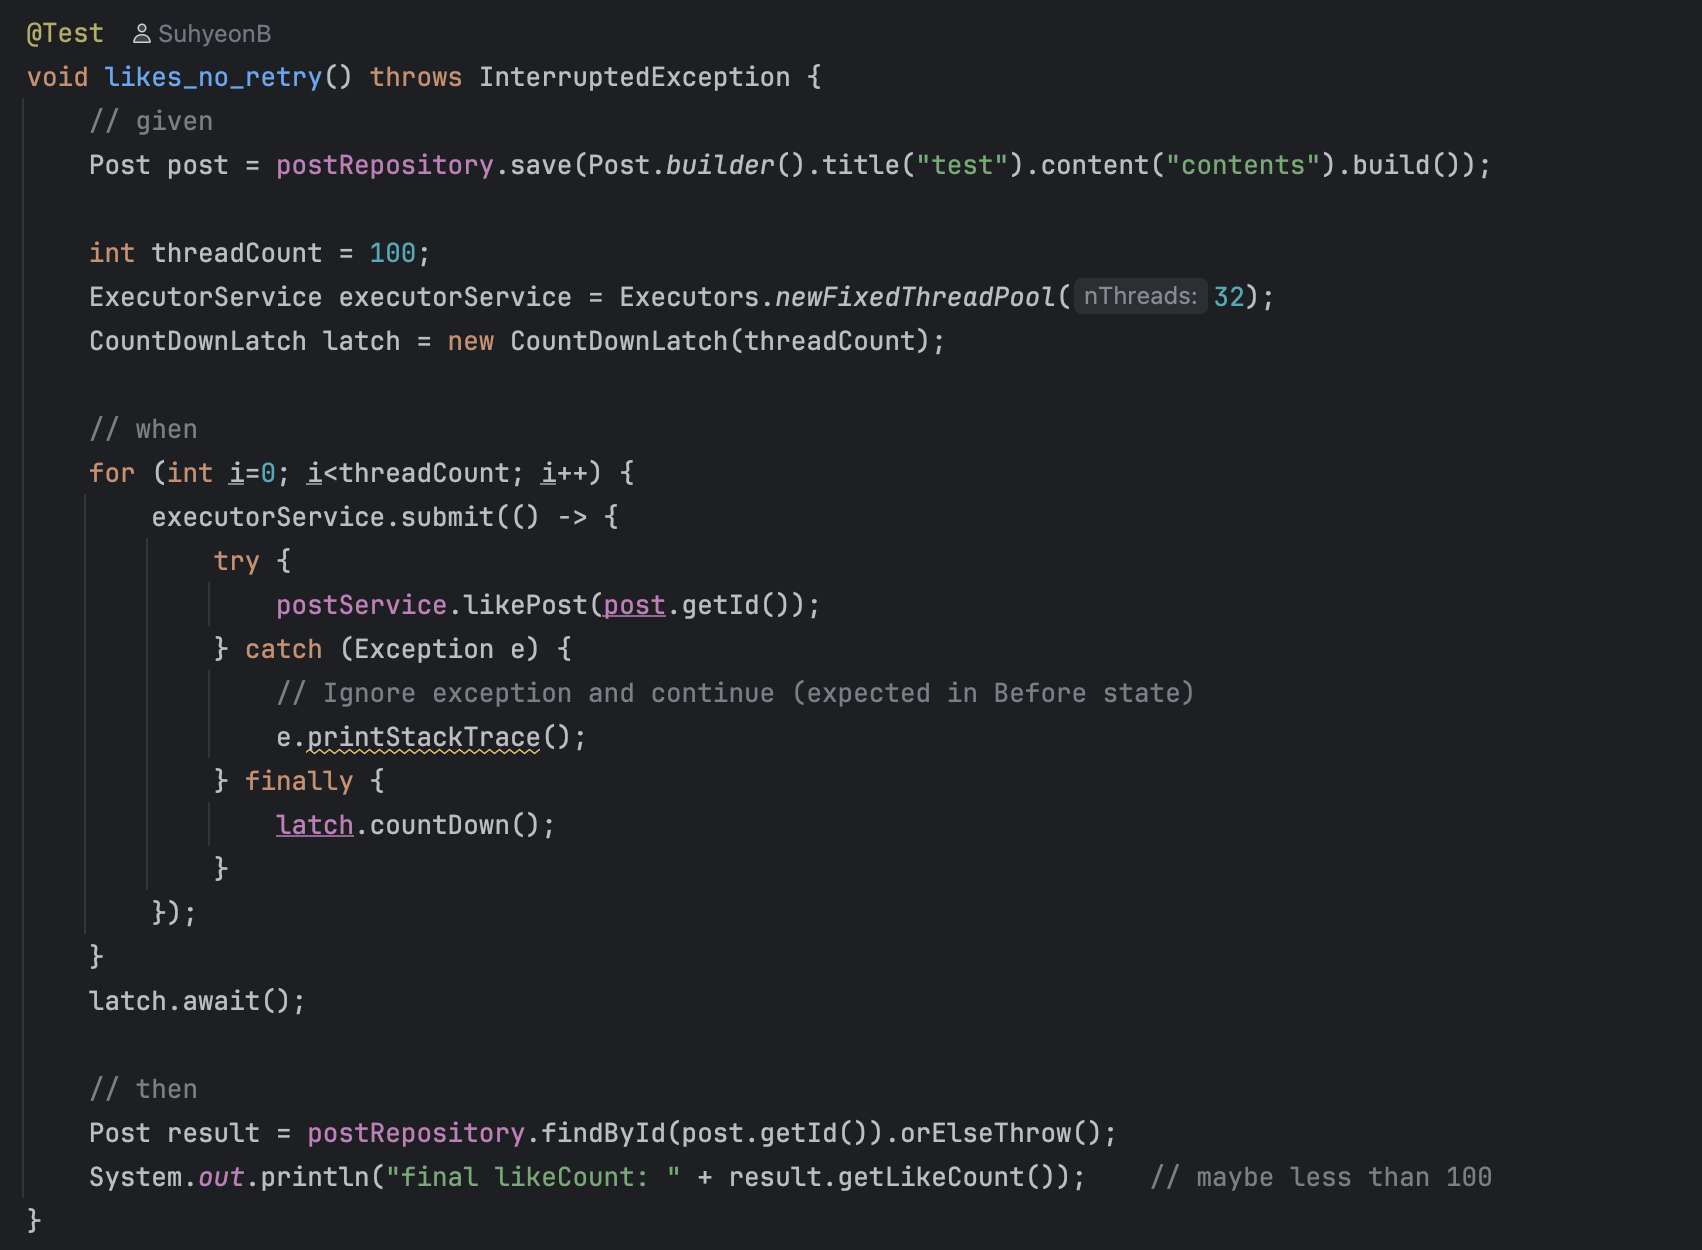
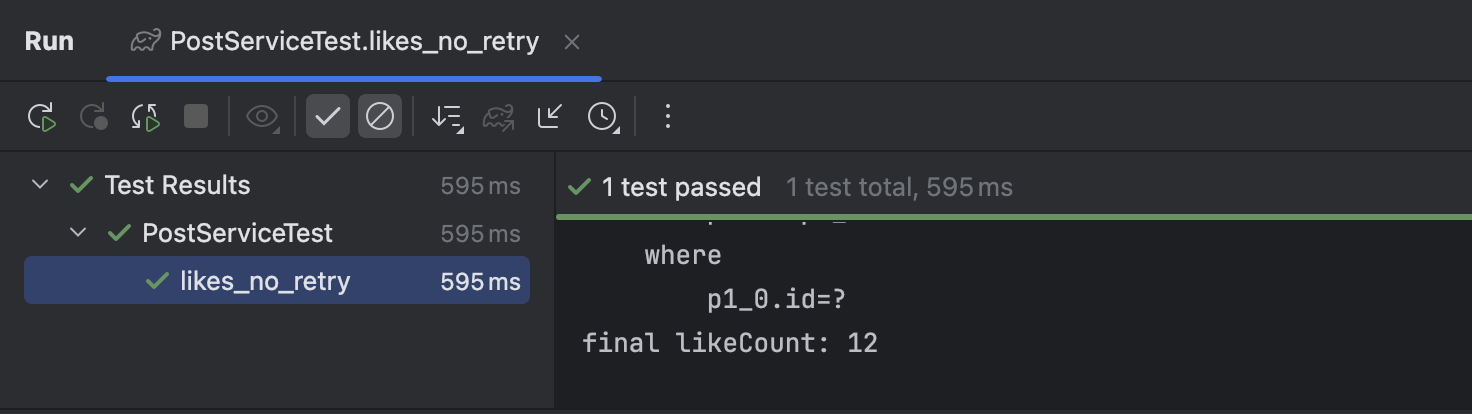
같은 글에 100명이 동시에 "좋아요"를 누르도록 한 상황의 결과는 12건 성공이었다.
또, 여러 번 시도해도 결과가 12건으로 같았는데, 이는 세팅된 Connection Pool의 값에 의한 결과였다.
(hikari: maximum-pool-size: 50로 값을 변경했을 때, 7로 결과값이 바뀌었지만, 성공에 유의미한 결과를 주진 않았다.)
Executor로 만든 동시 요청이 얼마나 동시였는가
ExecutorService로 스레드 100개를 띄웠다고 해서, 실제로 DB에 100개가 동시에 요청을 보내는 건 아니다.
Spring Boot는 기본적으로 HikariCP 커넥션 풀을 최대 10개로 잡는다. 즉 스레드는 100개를 띄웠어도, 실제로 DB 커넥션을 얻어 요청을 보낼 수 있는 건 최대 10개뿐이고, 나머지는 커넥션이 반납될 때까지 대기열에서 기다린다.
그래서 이 테스트가 검증하는 동시성의 실체는 "스레드 100개의 경쟁"이 아니라, "커넥션 풀 크기만큼의 경쟁 + 대기열"에 더 가깝다. 풀 크기를 10 → 50으로 늘렸을 때 결과가 12에서 7로 바뀐 것도 이 때문이다 — 이번 테스트에서는 커넥션 풀이 커지면서 더 많은 요청이 동시에 DB 작업을 진행할 수 있었고, 그 결과 동일한 version을 읽고 경쟁하는 요청이 늘어나 충돌 양상이 달라진 것으로 볼 수 있다.
After: 재시도 로직 포함하여 구현할 경우
수동으로 재시도 로직을 만드는 방법도 있지만(for문), Spring의 Spring Retry를 사용하여 구현해봤다.
@Retryable(
            retryFor = ObjectOptimisticLockingFailureException.class,
            maxAttempts = 20,
            backoff = @Backoff(delay = 10)
    )
    @Transactional
    public void likePost(Long id) {
        Post post = postRepository.findById(id)
                .orElseThrow(() -> new EntityNotFoundException("Post not found: " + id));
        post.increaseLikeCount();
    }
결과는 final likeCount 값이 90이상으로 재시도 로직이 없을 때에 비해 높은 성공률을 보였다.
그리고, maxAttepts의 값에 비례해 성공률의 차이를 보였는데, 5일때 보다 20일때 더 높은 값을 얻을 수 있었으나, 그만큼 실행 시간도 늘어났다.
maxAttempts와 backoff가 미치는 영향
trade-off
| maxAttempts | 성공(likeCount) | 소요시간 |
|---|---|---|
| 5 | 49 | 609ms |
| 10 | 73 | 863ms |
| 20 | 92 | 1s 11ms |
재시도 횟수를 늘릴수록 성공률은 올라가지만, 그만큼 시간도 늘어난다. 재시도할 때마다 "실패 → 재조회 → 재시도" 사이클이 도니, 시도 횟수만큼 시간이 누적되는 구조다.
backoff는 이 사이클 사이에 짧은 대기(delay)를 주는 설정이다. 재시도가 실패하자마자 곧바로 다시 시도하면, 방금 실패한 것과 같은 타이밍에 또 충돌할 가능성이 높다. @Backoff(delay = 10)처럼 짧은 텀을 주면 재충돌 확률을 어느 정도 낮출 수 있다.
다만 maxAttempts를 무한정 늘리는 게 답은 아니다. 재시도가 많아질수록 응답 시간이 늘어나 사용자 체감 지연으로 이어지고, 경쟁이 극심한 상황에서는 재시도만으로 100%를 보장하기도 어렵다. 그래서 실무에서는 재시도 한도를 합리적인 선에서 정하고, 좋아요처럼 약간의 유실이 허용되는 데이터는 그 선에서 타협하는 편이 현실적이다.
마무리 - 왜 '좋아요' 기능에 낙관락을 사용했는가
이번 프로젝트에서는 좋아요 요청이 동시에 발생하는 상황을 가정해 낙관적 락을 적용해 보았다. 낙관적 락은 충돌이 발생하더라도 사전에 다른 트랜잭션의 접근을 막지 않고, 충돌이 발생한 경우에만 재시도하는 방식이다. 따라서 충돌이 지속적으로 발생하는 상황에서는 재시도 비용이 증가하지만, 충돌이 빈번하지 않은 상황에서는 비관적 락처럼 사전에 DB 자원을 점유하지 않고 처리할 수 있다는 장점이 있다.