DDPM 이해해보기 - 1 에서는 Sampling 함수와 Forward, Reverse Process에 대해 간단히 보았고 P θ P_{\theta} P θ q q q
그러면 이제 intractable한 식을 tractable하게 바꿔주는 작업을 보겠습니다.
뒤에 나올 내용을 미리 말하자면 X t X_{t} X t X t − 1 X_{t-1} X t − 1 X 0 X_{0} X 0
DDPM Loss
DDPM Loss
다시 NLL부터 보도록 하겠습니다.
E x T ∼ q ( x t ∣ x 0 ) [ − l o g P θ ( x 0 ) ] = E x T ∼ q ( x t ∣ x 0 ) [ − l o g P θ ( x 0 , x 1 , . . . , x T ) P θ ( x 1 , x 2 , . . . , x T ∣ x 0 ) ] = E x T ∼ q ( x t ∣ x 0 ) [ − l o g P θ ( x 0 , x 1 , . . . , x T ) P θ ( x 1 , x 2 , . . . , x T ∣ x 0 ) ⋅ q ( x 1 : T ∣ x 0 ) q ( x 1 : T ∣ x 0 ) ] = E x T ∼ q ( x t ∣ x 0 ) [ − l o g P θ ( x 0 , x 1 , . . . , x T ) q ( x 1 : T ∣ x 0 ) ] − K L ( q ∣ ∣ P θ ) ∵ K L ( P ∣ ∣ Q ) = ∫ P ( x ) l o g P ( x ) Q ( x ) d x = E x [ l o g P ( x ) Q ( x ) ] ≤ E x T ∼ q ( x t ∣ x 0 ) [ − l o g P θ ( x 0 , x 1 , . . . , x T ) q ( x 1 : T ∣ x 0 ) ] \begin{aligned} \mathbb{E_{x_{T}\sim q(x_{t}|x_{0})}}[-logP_{\theta}(x_{0})]&=\mathbb{E_{x_{T}\sim q(x_{t}|x_{0})}}[-log{{P_{\theta}(x_{0},\,x_{1},\,...,\,x_{T})}\over{P_{\theta}(x_{1},\,x_{2},\,...,\,x_{T}|x_{0})}}]\\ &=\mathbb{E_{x_{T}\sim q(x_{t}|x_{0})}}[-log{{P_{\theta}(x_{0},\,x_{1},\,...,\,x_{T})}\over{P_{\theta}(x_{1},\,x_{2},\,...,\,x_{T}|x_{0})}}\cdot {{q(x_{1:T}|x_{0})}\over{q(x_{1:T}|x_{0})}}]\\ &=\mathbb{E_{x_{T}\sim q(x_{t}|x_{0})}}[-log{{P_{\theta}(x_{0},\,x_{1},\,...,\,x_{T})}\over{q(x_{1:T}|x_{0})}}]-KL(q||P_{\theta})\quad\because KL(P||Q)=\int{P(x)}log{{P(x)}\over{Q(x)}}dx=\mathbb{E_{x}}[log{{P(x)}\over{Q(x)}}]\\ &\leq \mathbb{E_{x_{T}\sim q(x_{t}|x_{0})}}[-log{{P_{\theta}(x_{0},\,x_{1},\,...,\,x_{T})}\over{q(x_{1:T}|x_{0})}}]\\ \end{aligned} E x T ∼ q ( x t ∣ x 0 ) [ − l o g P θ ( x 0 ) ] = E x T ∼ q ( x t ∣ x 0 ) [ − l o g P θ ( x 1 , x 2 , . . . , x T ∣ x 0 ) P θ ( x 0 , x 1 , . . . , x T ) ] = E x T ∼ q ( x t ∣ x 0 ) [ − l o g P θ ( x 1 , x 2 , . . . , x T ∣ x 0 ) P θ ( x 0 , x 1 , . . . , x T ) ⋅ q ( x 1 : T ∣ x 0 ) q ( x 1 : T ∣ x 0 ) ] = E x T ∼ q ( x t ∣ x 0 ) [ − l o g q ( x 1 : T ∣ x 0 ) P θ ( x 0 , x 1 , . . . , x T ) ] − K L ( q ∣ ∣ P θ ) ∵ K L ( P ∣ ∣ Q ) = ∫ P ( x ) l o g Q ( x ) P ( x ) d x = E x [ l o g Q ( x ) P ( x ) ] ≤ E x T ∼ q ( x t ∣ x 0 ) [ − l o g q ( x 1 : T ∣ x 0 ) P θ ( x 0 , x 1 , . . . , x T ) ] 더 이어가기 전에 전개에 필요한 내용 먼저 보겠습니다.
1 : P θ ( x 0 : T ) = P ( x T ) ∏ t = 1 T P θ ( x t − 1 ∣ x t ) 2 : q ( x 1 : T ∣ x 0 ) = ∏ t = 1 T q ( x t ∣ x t − 1 ) 1: P_{\theta}(x_{0:T})=P(x_{T})\prod_{t=1}^{T}P_{\theta}(x_{t-1}|x_{t})\\ 2: q(x_{1:T}|x_{0})=\prod_{t=1}^{T}q(x_{t}|x_{t-1}) 1 : P θ ( x 0 : T ) = P ( x T ) t = 1 ∏ T P θ ( x t − 1 ∣ x t ) 2 : q ( x 1 : T ∣ x 0 ) = t = 1 ∏ T q ( x t ∣ x t − 1 ) 3 : q ( x t ∣ x t − 1 ) = q ( x t ∣ x t − 1 , x 0 ) = q ( x t − 1 ∣ x t , x 0 ) ⋅ q ( x t ∣ x 0 ) q ( x t − 1 ∣ x 0 ) ∵ b a y e s r u l e \begin{aligned} 3: q(x_{t}|x_{t-1})&=q(x_{t}|x_{t-1}, x_{0})\\ &=q(x_{t-1}|x_{t}, x_{0})\cdot{{q(x_{t}|x_{0})}\over{q(x_{t-1}|x_{0})}}\quad \because bayes\ rule \end{aligned} 3 : q ( x t ∣ x t − 1 ) = q ( x t ∣ x t − 1 , x 0 ) = q ( x t − 1 ∣ x t , x 0 ) ⋅ q ( x t − 1 ∣ x 0 ) q ( x t ∣ x 0 ) ∵ b a y e s r u l e 이제 위 식들을 통해 전개에 필요한 변형에 필요한 내용은 숫자로 간단하게 표기하면서 넘어가고, 이어서 진행해보겠습니다.
E x T ∼ q ( x t ∣ x 0 ) [ − l o g P θ ( x 0 ) ] ≤ E x T ∼ q ( x t ∣ x 0 ) [ − l o g P θ ( x 0 : T ) q ( x 1 : T ∣ x 0 ) ] = E x T ∼ q ( x t ∣ x 0 ) [ − l o g P ( x T ) ∏ t = 1 T P θ ( x t − 1 ∣ x t ) ∏ t = 1 T q ( x t ∣ x t − 1 ) ] ∵ 1 , 2 = E x T ∼ q ( x 1 : t ∣ x 0 ) [ − l o g P ( x T ) − ∑ t = 2 T l o g P θ ( x t − 1 ∣ x t ) q ( x t ∣ x t − 1 ) − l o g P θ ( x 0 ∣ x 1 ) q ( x 1 ∣ x 0 ) ] = E x T ∼ q ( x 1 : t ∣ x 0 ) [ − l o g P ( x T ) − ∑ t = 2 T l o g P θ ( x t − 1 ∣ x t ) q ( x t − 1 ∣ x t , x 0 ) ⋅ q ( x t − 1 ∣ x 0 ) q ( x t ∣ x 0 ) − l o g P θ ( x 0 ∣ x 1 ) q ( x 1 ∣ x 0 ) ] ∵ 3 = E x T ∼ q ( x 1 : t ∣ x 0 ) [ − l o g P ( x T ) − ∑ t = 2 T l o g P θ ( x t − 1 ∣ x t ) q ( x t − 1 ∣ x t , x 0 ) − ∑ t = 2 T l o g q ( x t − 1 ∣ x 0 ) q ( x t ∣ x 0 ) − l o g P θ ( x 0 ∣ x 1 ) q ( x 1 ∣ x 0 ) ] = E x T ∼ q ( x 1 : t ∣ x 0 ) [ − l o g P ( x T ) − ∑ t = 2 T l o g P θ ( x t − 1 ∣ x t ) q ( x t − 1 ∣ x t , x 0 ) − log q ( x 1 ∣ x 0 ) q ( x T , x 0 ) − l o g P θ ( x 0 ∣ x 1 ) q ( x 1 ∣ x 0 ) ] = E x T ∼ q ( x 1 : t ∣ x 0 ) [ − l o g P ( x ) q ( x T ∣ x 0 ) − ∑ t = 2 T l o g P θ ( x t − 1 ∣ x t ) q ( x t − 1 ∣ x t , x 0 ) − l o g P θ ( x 0 ∣ x 1 ) ] = E x T ∼ q ( x 1 : t ∣ x 0 ) [ D K L ( q ( x T ∣ x 0 ) ∣ ∣ P ( x T ) ) + ∑ t > 1 T D K L ( q ( x t − 1 ∣ x t , x 0 ) ∣ ∣ P θ ( x t − 1 ∣ x t ) ) − l o g P θ ( x 0 ∣ x 1 ) ] \begin{aligned} \mathbb{E_{x_{T}\sim q(x_{t}|x_{0})}}[-logP_{\theta}(x_{0})]&\leq\mathbb{E_{x_{T}\sim q(x_{t}|x_{0})}}[-log{{P_{\theta}(x_{0:T})}\over{q(x_{1:T}|x_{0})}}]\\ &=\mathbb{E_{x_{T}\sim q(x_{t}|x_{0})}}[-log{{P(x_{T})\prod_{t=1}^{T}P_{\theta}(x_{t-1}|x_{t})}\over{\prod_{t=1}^{T}q(x_{t}|x_{t-1})}}]\quad \because 1, 2\\ &=\mathbb{E_{x_{T}\sim q(x_{1:t}|x_{0})}}[-logP(x_{T})-\sum_{t=2}^{T}log{{P_{\theta}(x_{t-1}|x_{t})}\over{q(x_{t}|x_{t-1})}}-log{{P_{\theta}(x_{0}|x_{1})}\over{q(x_{1}|x_{0}})}]\\ &=\mathbb{E_{x_{T}\sim q(x_{1:t}|x_{0})}}[-logP(x_{T})-\sum_{t=2}^{T}log{{P_{\theta}(x_{t-1}|x_{t})}\over{q(x_{t-1}|x_{t}, x_{0})}}\cdot{{q(x_{t-1}|x_{0})}\over{q(x_{t}|x_{0})}}-log{{P_{\theta}(x_{0}|x_{1})}\over{q(x_{1}|x_{0}})}]\quad \because 3\\ &=\mathbb{E_{x_{T}\sim q(x_{1:t}|x_{0})}}[-logP(x_{T})-\sum_{t=2}^{T}log{{P_{\theta}(x_{t-1}|x_{t})}\over{q(x_{t-1}|x_{t}, x_{0})}}-\sum_{t=2}^{T}log{{q(x_{t-1}|x_{0})}\over{q(x_{t}|x_{0})}}-log{{P_{\theta}(x_{0}|x_{1})}\over{q(x_{1}|x_{0}})}]\\ &=\mathbb{E_{x_{T}\sim q(x_{1:t}|x_{0})}}[-logP(x_{T})-\sum_{t=2}^{T}log{{P_{\theta}(x_{t-1}|x_{t})}\over{q(x_{t-1}|x_{t}, x_{0})}}-\log{{q(x_{1}|x_{0})}\over{q(x_{T}, x_{0})}}-log{{P_{\theta}(x_{0}|x_{1})}\over{q(x_{1}|x_{0}})}]\\ &=\mathbb{E_{x_{T}\sim q(x_{1:t}|x_{0})}}[-log{{P(x)}\over{q(x_{T}|x_{0}})}-\sum_{t=2}^{T}log{{P_{\theta}(x_{t-1}|x_{t})}\over{q(x_{t-1}|x_{t}, x_{0})}}-logP_{\theta}(x_{0}|x_{1})]\\ &=\mathbb{E_{x_{T}\sim q(x_{1:t}|x_{0})}}[D_{KL}(q(x_{T}|x_{0})||P(x_{T}))+\sum_{t>1}^{T}D_{KL}(q(x_{t-1}|x_{t}, x_{0})||P_{\theta}(x_{t-1}|x_{t}))-logP_{\theta(x_{0}|x_{1})}] \end{aligned} E x T ∼ q ( x t ∣ x 0 ) [ − l o g P θ ( x 0 ) ] ≤ E x T ∼ q ( x t ∣ x 0 ) [ − l o g q ( x 1 : T ∣ x 0 ) P θ ( x 0 : T ) ] = E x T ∼ q ( x t ∣ x 0 ) [ − l o g ∏ t = 1 T q ( x t ∣ x t − 1 ) P ( x T ) ∏ t = 1 T P θ ( x t − 1 ∣ x t ) ] ∵ 1 , 2 = E x T ∼ q ( x 1 : t ∣ x 0 ) [ − l o g P ( x T ) − t = 2 ∑ T l o g q ( x t ∣ x t − 1 ) P θ ( x t − 1 ∣ x t ) − l o g q ( x 1 ∣ x 0 ) P θ ( x 0 ∣ x 1 ) ] = E x T ∼ q ( x 1 : t ∣ x 0 ) [ − l o g P ( x T ) − t = 2 ∑ T l o g q ( x t − 1 ∣ x t , x 0 ) P θ ( x t − 1 ∣ x t ) ⋅ q ( x t ∣ x 0 ) q ( x t − 1 ∣ x 0 ) − l o g q ( x 1 ∣ x 0 ) P θ ( x 0 ∣ x 1 ) ] ∵ 3 = E x T ∼ q ( x 1 : t ∣ x 0 ) [ − l o g P ( x T ) − t = 2 ∑ T l o g q ( x t − 1 ∣ x t , x 0 ) P θ ( x t − 1 ∣ x t ) − t = 2 ∑ T l o g q ( x t ∣ x 0 ) q ( x t − 1 ∣ x 0 ) − l o g q ( x 1 ∣ x 0 ) P θ ( x 0 ∣ x 1 ) ] = E x T ∼ q ( x 1 : t ∣ x 0 ) [ − l o g P ( x T ) − t = 2 ∑ T l o g q ( x t − 1 ∣ x t , x 0 ) P θ ( x t − 1 ∣ x t ) − log q ( x T , x 0 ) q ( x 1 ∣ x 0 ) − l o g q ( x 1 ∣ x 0 ) P θ ( x 0 ∣ x 1 ) ] = E x T ∼ q ( x 1 : t ∣ x 0 ) [ − l o g q ( x T ∣ x 0 ) P ( x ) − t = 2 ∑ T l o g q ( x t − 1 ∣ x t , x 0 ) P θ ( x t − 1 ∣ x t ) − l o g P θ ( x 0 ∣ x 1 ) ] = E x T ∼ q ( x 1 : t ∣ x 0 ) [ D K L ( q ( x T ∣ x 0 ) ∣ ∣ P ( x T ) ) + t > 1 ∑ T D K L ( q ( x t − 1 ∣ x t , x 0 ) ∣ ∣ P θ ( x t − 1 ∣ x t ) ) − l o g P θ ( x 0 ∣ x 1 ) ]
Loss Term
이렇게 NLL로 부터 유도된 Loss는 마지막 줄 과 같습니다.
L o s s = E x T ∼ q ( x 1 : t ∣ x 0 ) [ D K L ( q ( x T ∣ x 0 ) ∣ ∣ P ( x T ) ) + ∑ t > 1 T D K L ( q ( x t − 1 ∣ x t , x 0 ) ∣ ∣ P θ ( x t − 1 ∣ x t ) ) − l o g P θ ( x 0 ∣ x 1 ) ] Loss = \mathbb{E_{x_{T}\sim q(x_{1:t}|x_{0})}}[D_{KL}(q(x_{T}|x_{0})||P(x_{T}))+\sum_{t>1}^{T}D_{KL}(q(x_{t-1}|x_{t}, x_{0})||P_{\theta}(x_{t-1}|x_{t}))-logP_{\theta(x_{0}|x_{1})}] L o s s = E x T ∼ q ( x 1 : t ∣ x 0 ) [ D K L ( q ( x T ∣ x 0 ) ∣ ∣ P ( x T ) ) + t > 1 ∑ T D K L ( q ( x t − 1 ∣ x t , x 0 ) ∣ ∣ P θ ( x t − 1 ∣ x t ) ) − l o g P θ ( x 0 ∣ x 1 ) ] Regularization Term
L T = D K L ( q ( x T ∣ x 0 ) ∣ ∣ P ( x T ) ) L_{T}=D_{KL}(q(x_{T}|x_{0})||P(x_{T})) L T = D K L ( q ( x T ∣ x 0 ) ∣ ∣ P ( x T ) ) x T x_{T} x T β \beta β q ( x T ∣ x 0 ) q(x_{T}|x_{0}) q ( x T ∣ x 0 )
Denoising Process
L 1 : T = ∑ t > 1 T D K L ( q ( x t − 1 ∣ x t , x 0 ) ∣ ∣ P θ ( x t − 1 ∣ x t ) ) L_{1:T}=\sum_{t>1}^{T}D_{KL}(q(x_{t-1}|x_{t}, x_{0})||P_{\theta}(x_{t-1}|x_{t})) L 1 : T = ∑ t > 1 T D K L ( q ( x t − 1 ∣ x t , x 0 ) ∣ ∣ P θ ( x t − 1 ∣ x t ) ) P θ ( x t − 1 ∣ x t ) P_{\theta}(x_{t-1}|x_{t}) P θ ( x t − 1 ∣ x t ) q ( x t − 1 ∣ x t , x 0 ) q(x_{t-1}|x_{t}, x_{0}) q ( x t − 1 ∣ x t , x 0 ) q ( x t − 1 ∣ x t , x 0 ) q(x_{t-1}|x_{t}, x_{0}) q ( x t − 1 ∣ x t , x 0 ) N ( x t − 1 ; μ t ~ ( x t , x 0 ) , β t ~ I ) \mathcal{N}(x_{t-1};\tilde{\mu_{t}}(x_{t}, x_{0}),\tilde{\beta_{t}}I) N ( x t − 1 ; μ t ~ ( x t , x 0 ) , β t ~ I )
q ( x t − 1 ∣ x t , x 0 ) = q ( x t ∣ x t − 1 ) ⋅ q ( x t − 1 ∣ x 0 ) q ( x t ∣ x 0 ) q(x_{t-1}|x_{t}, x_{0})=q(x_{t}|x_{t-1})\cdot{{q(x_{t-1}|x_{0})}\over{q(x_{t}|x_{0})}}\\ q ( x t − 1 ∣ x t , x 0 ) = q ( x t ∣ x t − 1 ) ⋅ q ( x t ∣ x 0 ) q ( x t − 1 ∣ x 0 ) q q q
N ( x , μ , Σ ) = 1 ( 2 π ) D β D exp ( − 1 2 β ( x − μ ) T ( x − μ ) ) ( Σ = β I ) \mathcal{N}(x, \mu, \Sigma)={{1}\over{(\sqrt{2\pi})^D\sqrt{\beta}^D}}\exp(-{{1}\over{2\beta}}(x-\mu)^T(x-\mu))\quad(\Sigma=\beta I) N ( x , μ , Σ ) = ( 2 π ) D β D 1 exp ( − 2 β 1 ( x − μ ) T ( x − μ ) ) ( Σ = β I ) 로 나타낼 수 있습니다. (D D D x x x q ( x t ∣ x t − 1 ) , q ( x t − 1 ∣ x 0 ) , q ( x t ∣ x 0 ) q(x_{t}|x_{t-1}),\ q(x_{t-1}|x_{0}),\ q(x_{t}|x_{0}) q ( x t ∣ x t − 1 ) , q ( x t − 1 ∣ x 0 ) , q ( x t ∣ x 0 )
q ( x t − 1 ∣ x t , x 0 ) = K exp ( − 1 2 ( x t − α t x t − 1 ) 2 β t + ( x t − 1 − α ~ t − 1 x 0 ) 2 1 − α ~ t − 1 − ( x t − α ~ t x 0 ) 2 1 − α ~ t ) = K exp ( − 1 2 ( ( α t β t + 1 1 − α ~ t − 1 ) x t − 1 2 − 2 ( α t β t x t + α ~ t − 1 1 − α ~ t − 1 x 0 ) x t − 1 + C ( x t , x 0 ) ) \begin{aligned} q(x_{t-1}|x_{t}, x_{0})&= K\exp(-{{1}\over{2}}{({x_{t}-\sqrt{\alpha_{t}}x_{t-1})^2}\over{\beta_{t}}}+{{(x_{t-1}-\sqrt{\tilde{\alpha}_{t-1}}x_{0})^2}\over{1-\tilde{\alpha}_{t-1}}}-{{(x_{t}-\sqrt{\tilde{\alpha}_{t}}x_{0})^2}\over{1-\tilde{\alpha}_{t}}})\\ &=K\exp(-{{1}\over{2}}(({{\alpha_{t}}\over{\beta_{t}}}+{{1}\over{1-\tilde{\alpha}_{t-1}}})x_{t-1}^2-2({{\sqrt{\alpha_{t}}}\over{\beta_{t}}}x_{t}+{{\sqrt{\tilde{\alpha}_{t-1}}}\over{1-\tilde{\alpha}_{t-1}}}x_{0})x_{t-1}+C(x_{t},x_{0}))\\ \end{aligned} q ( x t − 1 ∣ x t , x 0 ) = K exp ( − 2 1 β t ( x t − α t x t − 1 ) 2 + 1 − α ~ t − 1 ( x t − 1 − α ~ t − 1 x 0 ) 2 − 1 − α ~ t ( x t − α ~ t x 0 ) 2 ) = K exp ( − 2 1 ( ( β t α t + 1 − α ~ t − 1 1 ) x t − 1 2 − 2 ( β t α t x t + 1 − α ~ t − 1 α ~ t − 1 x 0 ) x t − 1 + C ( x t , x 0 ) ) 이 식을 끔찍하게 복잡하게 풀어서 아래와 같은 정규분포로 모양으로 나타낼 수 있습니다.
A ( x t , x 0 ) exp ( − 1 2 β ~ t ( x t − 1 − μ ~ t ( x t , x 0 ) ) 2 ) A(x_{t}, x_{0})\exp(-{{1}\over{2\tilde{\beta}_{t}}}(x_{t-1}-\tilde{\mu}_{t}(x_{t}, x_{0}))^2)\\ A ( x t , x 0 ) exp ( − 2 β ~ t 1 ( x t − 1 − μ ~ t ( x t , x 0 ) ) 2 )
그렇게 나온 식을 가져와서 대응시켜보면μ t ~ \tilde{\mu_{t}} μ t ~ β t ~ \tilde{\beta_{t}} β t ~
β ~ t = 1 − α ~ t − 1 1 − α ~ β t μ ~ t ( x t , x 0 ) = α ~ t − 1 β t 1 − α ~ t x 0 + α t ( 1 − α ~ t − 1 ) 1 − α ~ t x t \tilde{\beta}_{t}={{1-\tilde{\alpha}_{t-1}}\over{1-\tilde{\alpha}}}\beta_{t}\\ \tilde{\mu}_{t}(x_{t},x_{0})={{\sqrt{\tilde{\alpha}_{t-1}}\beta_{t}}\over{1-\tilde{\alpha}_{t}}}x_{0}+{{\sqrt{\alpha_{t}}(1-\tilde{\alpha}_{t-1})}\over{1-\tilde{\alpha}_{t}}}x_{t} β ~ t = 1 − α ~ 1 − α ~ t − 1 β t μ ~ t ( x t , x 0 ) = 1 − α ~ t α ~ t − 1 β t x 0 + 1 − α ~ t α t ( 1 − α ~ t − 1 ) x t 이제 최종 Loss까지 얼마남지 않았습니다.
D K L ( q ( x t − 1 ∣ x t , x 0 ) ∣ ∣ P θ ( x t − 1 ∣ x t ) ) = D K L ( N ( x t − 1 ; μ ~ t ( x t , x 0 ) , β ~ t I ) ∣ ∣ N ( x t − 1 ; μ θ ( x t , t ) , σ t 2 I ) ) = 1 2 σ t 2 ∥ μ ~ t ( x t , x 0 ) − μ θ ( x t , t ) ∥ 2 + C \begin{aligned} D_{KL}(q(x_{t-1}|x_{t}, x_{0})||P_{\theta}(x_{t-1}|x_{t}))&=D_{KL}(\mathcal{N}(x_{t-1};\tilde{\mu}_{t}(x_{t}, x_{0}),\tilde{\beta}_{t}I)||\mathcal{N}(x_{t-1};\mu_{\theta}(x_{t}, t), \sigma_{t}^{2}I))\\ &={{1}\over{2\sigma_{t}^2}}\lVert\tilde{\mu}_{t}(x_{t}, x_{0})-\mu_{\theta}(x_{t}, t)\rVert^2+C \end{aligned} D K L ( q ( x t − 1 ∣ x t , x 0 ) ∣ ∣ P θ ( x t − 1 ∣ x t ) ) = D K L ( N ( x t − 1 ; μ ~ t ( x t , x 0 ) , β ~ t I ) ∣ ∣ N ( x t − 1 ; μ θ ( x t , t ) , σ t 2 I ) ) = 2 σ t 2 1 ∥ μ ~ t ( x t , x 0 ) − μ θ ( x t , t ) ∥ 2 + C ∴ L t − 1 = E q [ 1 2 σ t 2 ∥ μ ~ t ( x t , x 0 ) − μ θ ( x t , t ) ∥ 2 ] + C \therefore L_{t-1}=\mathbb{E}_{q}[{{1}\over{2\sigma_{t}^2}}\lVert\tilde{\mu}_{t}(x_{t}, x_{0})-\mu_{\theta}(x_{t}, t)\rVert^2]+C ∴ L t − 1 = E q [ 2 σ t 2 1 ∥ μ ~ t ( x t , x 0 ) − μ θ ( x t , t ) ∥ 2 ] + C 이제 이 식의 목적이 확고해졌습니다. μ ~ t ( x t , x 0 ) \tilde{\mu}_{t}(x_{t}, x_{0}) μ ~ t ( x t , x 0 ) μ θ ( x t , t ) \mu_{\theta}(x_{t}, t) μ θ ( x t , t )
여기서 더 나아가 reparameterizing을 해볼 수 있습니다.
r e c a l l : x t ( x 0 , ϵ ) = α ~ t x 0 + 1 − α ~ t ϵ ϵ ∼ N ( 0 , I ) recall\ : \ x_{t}(x_{0}, \epsilon)=\sqrt{\tilde{\alpha}_{t}}x_{0}+\sqrt{1-\tilde{\alpha}_{t}}\epsilon \quad \epsilon \sim\mathcal{N}(0,I)\\ r e c a l l : x t ( x 0 , ϵ ) = α ~ t x 0 + 1 − α ~ t ϵ ϵ ∼ N ( 0 , I ) x 0 x_{0} x 0
x 0 = 1 α ~ t ( x t ( x 0 , ϵ ) − 1 − α ~ t ϵ ) x_{0}={{1}\over{\sqrt{\tilde{\alpha}_{t}}}}(x_{t}(x_{0}, \epsilon)-\sqrt{1-\tilde{\alpha}_{t}}\epsilon) x 0 = α ~ t 1 ( x t ( x 0 , ϵ ) − 1 − α ~ t ϵ )
L t − 1 − C = E x 0 , ϵ [ ∥ μ ~ t ( x t ( x 0 , ϵ ) , 1 α ~ t ( x t ( x 0 , ϵ ) − ( 1 − α ~ t ) ϵ ) ) − μ θ ( x t ( x 0 , ϵ ) , t ) ∥ 2 ] L_{t-1}-C=\mathbb{E}_{x_{0}, \epsilon}[\lVert\ \tilde{\mu}_{t}(x_{t}(x_{0}, \epsilon),\ {{1}\over{\sqrt{\tilde{\alpha}_{t}}}}(x_{t}(x_{0}, \epsilon)-\sqrt{(1-\tilde{\alpha}_{t})}\epsilon))-\mu_{\theta}(x_{t}(x_{0}, \epsilon), t)\ \rVert^{2}]\\ L t − 1 − C = E x 0 , ϵ [ ∥ μ ~ t ( x t ( x 0 , ϵ ) , α ~ t 1 ( x t ( x 0 , ϵ ) − ( 1 − α ~ t ) ϵ ) ) − μ θ ( x t ( x 0 , ϵ ) , t ) ∥ 2 ]
μ ~ t ( x t ( x 0 , ϵ ) , x 0 ) = α ~ t − 1 β t 1 − α ~ t x 0 + α t ( 1 − α ~ t − 1 ) 1 − α ~ t x t = α ~ t − 1 β t 1 − α ~ t ( 1 α ~ t ( x t ( x 0 , ϵ ) − 1 − α ~ t ϵ ) ) + α t ( 1 − α ~ t − 1 ) 1 − α ~ t x t = . . . = 1 α t ( x t ( x 0 , ϵ ) − β t 1 − α ~ t ϵ ) \begin{aligned} \tilde{\mu}_{t}(x_{t}(x_{0}, \epsilon), x_{0})&={{\sqrt{\tilde{\alpha}_{t-1}}\beta_{t}}\over{1-\tilde{\alpha}_{t}}}x_{0}+{{\sqrt{\alpha_{t}}(1-\tilde{\alpha}_{t-1})}\over{1-\tilde{\alpha}_{t}}}x_{t}\\ &={{\sqrt{\tilde{\alpha}_{t-1}}\beta_{t}}\over{1-\tilde{\alpha}_{t}}}({{1}\over{\sqrt{\tilde{\alpha}_{t}}}}(x_{t}(x_{0}, \epsilon)-\sqrt{1-\tilde{\alpha}_{t}}\epsilon))+{{\sqrt{\alpha_{t}}(1-\tilde{\alpha}_{t-1})}\over{1-\tilde{\alpha}_{t}}}x_{t}\\ &=...\\ &={{1}\over{\sqrt{\alpha_{t}}}}(x_{t}(x_{0}, \epsilon)-{{\beta_{t}}\over{\sqrt{1-\tilde{\alpha}_{t}}}}\epsilon) \end{aligned} μ ~ t ( x t ( x 0 , ϵ ) , x 0 ) = 1 − α ~ t α ~ t − 1 β t x 0 + 1 − α ~ t α t ( 1 − α ~ t − 1 ) x t = 1 − α ~ t α ~ t − 1 β t ( α ~ t 1 ( x t ( x 0 , ϵ ) − 1 − α ~ t ϵ ) ) + 1 − α ~ t α t ( 1 − α ~ t − 1 ) x t = . . . = α t 1 ( x t ( x 0 , ϵ ) − 1 − α ~ t β t ϵ ) 복잡한 전개를 생략하면 결과는 가장 아래 줄의 식과 같습니다.
위에서 나온 결과를 대입을 하면 아래식이 나옵니다.
L t − 1 − C = E x 0 , ϵ [ ∥ 1 α t ( x t ( x 0 , ϵ ) − β t 1 − α ~ t ϵ ) − μ θ ( x t ( x 0 , ϵ ) , t ) ∥ 2 ] L_{t-1}-C=\mathbb{E}_{x_{0}, \epsilon}[\lVert\ {{1}\over{\sqrt{\alpha_{t}}}}(x_{t}(x_{0}, \epsilon)-{{\beta_{t}}\over{\sqrt{1-\tilde{\alpha}_{t}}}}\epsilon)-\mu_{\theta}(x_{t}(x_{0}, \epsilon), t)\ \rVert^{2}] L t − 1 − C = E x 0 , ϵ [ ∥ α t 1 ( x t ( x 0 , ϵ ) − 1 − α ~ t β t ϵ ) − μ θ ( x t ( x 0 , ϵ ) , t ) ∥ 2 ] 이제 μ θ \mu_{\theta} μ θ 1 α t ( x t ( x 0 , ϵ ) − β t 1 − α ~ t ϵ ) {{1}\over{\sqrt{\alpha_{t}}}}(x_{t}(x_{0}, \epsilon)-{{\beta_{t}}\over{\sqrt{1-\tilde{\alpha}_{t}}}}\epsilon) α t 1 ( x t ( x 0 , ϵ ) − 1 − α ~ t β t ϵ ) μ θ \mu_{\theta} μ θ ϵ \epsilon ϵ x t x_{t} x t ϵ θ \epsilon_{\theta} ϵ θ
μ θ ( x t , t ) = μ ~ t ( x t , 1 α t ( x t − 1 − α ~ t ϵ θ ( x t ) ) ) = 1 α t ( x t − β t 1 − α ~ t ϵ θ ( x t , t ) ) \mu_{\theta}(x_{t}, t)=\tilde{\mu}_{t}(x_{t}, {{1}\over{\sqrt{\alpha_{t}}}}(x_{t}-{\sqrt{1-\tilde{\alpha}_{t}}}\epsilon_{\theta}(x_{t})))={{1}\over{\sqrt{\alpha_{t}}}}(x_{t}-{{\beta_{t}}\over{\sqrt{1-\tilde{\alpha}_{t}}}}\epsilon_{\theta}(x_{t}, t)) μ θ ( x t , t ) = μ ~ t ( x t , α t 1 ( x t − 1 − α ~ t ϵ θ ( x t ) ) ) = α t 1 ( x t − 1 − α ~ t β t ϵ θ ( x t , t ) ) P θ ( x t − 1 ∣ x t ) P_{\theta}(x_{t-1}|x_{t}) P θ ( x t − 1 ∣ x t )
x t − 1 = 1 α t ( x t − β t 1 − α ~ t ϵ θ ( x t , t ) ) + σ t z z ∼ N ( 0 , I ) x_{t-1}={{1}\over{\sqrt{\alpha}_{t}}}(x_{t}-{{\beta_{t}}\over{\sqrt{1-\tilde{\alpha}_{t}}}}\epsilon_{\theta}(x_{t}, t))+\sigma_{t}z \quad z\sim\mathcal{N}(0, I) x t − 1 = α t 1 ( x t − 1 − α ~ t β t ϵ θ ( x t , t ) ) + σ t z z ∼ N ( 0 , I ) 이제 이렇게 구한 μ θ \mu_{\theta} μ θ (사실 최종까지 조금 더 남았습니다)
L t − 1 − C = E x 0 , ϵ [ β t 2 2 σ t 2 α t ( 1 − α ~ t ) ∥ ϵ − ϵ θ ( α ~ t x 0 + 1 − α ~ t ϵ , t ) ∥ 2 ] L_{t-1}-C=\mathbb{E}_{x_{0}, \epsilon}[{{\beta_{t}^{2}}\over{2\sigma_{t}^{2}\alpha_{t}(1-\tilde{\alpha}_{t})}}\lVert\ \epsilon - \epsilon_{\theta}(\sqrt{\tilde{\alpha}_{t}}x_{0}+\sqrt{1-\tilde{\alpha}_{t}}\epsilon,\,t) \rVert^{2}] L t − 1 − C = E x 0 , ϵ [ 2 σ t 2 α t ( 1 − α ~ t ) β t 2 ∥ ϵ − ϵ θ ( α ~ t x 0 + 1 − α ~ t ϵ , t ) ∥ 2 ] Reconstruction Term
− l o g P θ ( x 0 ∣ x 1 ) -logP_{\theta(x_{0}|x_{1})} − l o g P θ ( x 0 ∣ x 1 ) x 1 x_{1} x 1 x 0 x_{0} x 0
디코더는 입력으로 x 1 x_{1} x 1 x 0 x_{0} x 0 θ \theta θ
디코더의 loss function은 아래와 같습니다.
P θ ( x 0 ∣ x 1 ) = ∏ i = 1 D ∫ δ − ( x 0 i ) δ + ( x 0 i ) N ( x ; μ θ i ( x 1 , 1 ) , σ 1 2 ) d x δ + = { ∞ i f x = 1 x + 1 255 i f x < 1 δ − = { − ∞ i f x = − 1 x − 1 255 i f x > − 1 P_{\theta}(x_{0}|x_{1})=\prod_{i=1}^{D}\int_{\delta_{-}(x_{0}^{i})}^{\delta_{+}(x_{0}^{i})}\mathcal{N}(x;\mu_{\theta}^{i}(x_{1}, 1), \sigma_{1}^{2})dx\\ \delta_{+}= \begin{cases} \infin & if\ x = 1\\ x+{{1}\over{255}} & if\ x < 1\\ \end{cases} \quad \delta_{-}= \begin{cases} -\infin & if\ x = -1\\ x-{{1}\over{255}} & if\ x >- 1\\ \end{cases} P θ ( x 0 ∣ x 1 ) = i = 1 ∏ D ∫ δ − ( x 0 i ) δ + ( x 0 i ) N ( x ; μ θ i ( x 1 , 1 ) , σ 1 2 ) d x δ + = { ∞ x + 2 5 5 1 i f x = 1 i f x < 1 δ − = { − ∞ x − 2 5 5 1 i f x = − 1 i f x > − 1 i i i
모든 픽셀이 독립이라는 가정
최종이미지는 이산확률변수x 0 x_{0} x 0 i i i x 1 x_{1} x 1 μ θ i ( x 1 , 1 ) \mu_{\theta}^{i}(x_{1}, 1) μ θ i ( x 1 , 1 ) x 0 i x_{0}^{i} x 0 i 1 255 1\over255 2 5 5 1
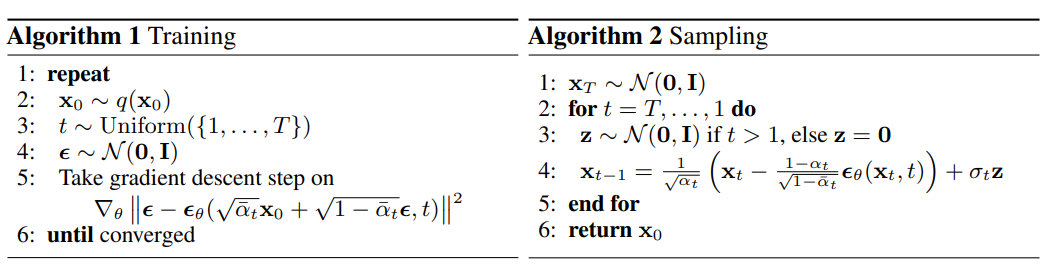
논문에 나와있는 훈련과 샘플링 과정입니다.
손실함수 단순화
L s i m p l e = E t , x 0 , ϵ [ ∥ ϵ − ϵ θ ( α ~ t x 0 + 1 − α ~ t ϵ , t ) ∥ 2 ] L_{simple}=\mathbb{E}_{t, x_{0}, \epsilon}[\lVert\ \epsilon - \epsilon_{\theta}(\sqrt{\tilde{\alpha}_{t}}x_{0}+\sqrt{1-\tilde{\alpha}_{t}}\epsilon,\,t) \rVert^{2}] L s i m p l e = E t , x 0 , ϵ [ ∥ ϵ − ϵ θ ( α ~ t x 0 + 1 − α ~ t ϵ , t ) ∥ 2 ]
denoising score matching over multiple noise scales
Langevin-like reverse process
Langevin dynamics
참고 링크
영상
블로그
논문