딥러닝을 이용한 AI 심리 상담 챗봇을 구현해 봤다.
짧은 기간이었기 때문에 성능은 고려하지 않았고
개념 이해 & 모델 작동에 초점을 맞춘 프로젝트다.
후기는 처음 써보는 거라 아직 많이 어색하지만 나아질 거라 생각한다.
체크포인트는 6가지로 구성된다.
1. 왜 이 문제를 선택했는가?
2. 데이터 전처리는 왜 그렇게 했는가? (ex. 이상치 처리 기준 등등)
3. 왜 이 모델을 선택했는가?
4. 어떤 인사이트를 얻을 수 있었는가?
5. 프로젝트 과정에서 어떤 어려움을 겪었는가?
6. 프로젝트 과정에서 깨달은 바는 무엇인가?
1. 왜 이 문제를 선택했는가?
이 프로젝트를 하게 된 계기는 크게 3가지이다.
- 트랜스포머(Transformer) 모델의 이해 욕구
- '우울증'과 관련된 뉴스 기사들
- 과거 심리 상담 앱의 챗봇 이용 경험
이 3가지를 모두 고려해 본 결과 '챗봇' 을 만들기로 결정했다.
우선, 트랜스포머를 처음 배웠을 때 내용이 너무 어렵고 복잡해서 대충 흐름만 이해하고
말았는데 시간이 좀 지나고 나니 오기(?)도 생기고 심적으로도 조금 편해져서 도전해 보기로 했다.
그리고 4,5월에 진로 고민 때문에 무척 힘들었는지 우울감이 좀 생긴 거 같아 구글에 검색해 보니 100명 중 15명은 우울증을 겪는다는 기사를 봤고 과거 힘들었을 때 어떻게든 해소하고 싶어 챗봇을 이용한 경험도 갖고 있었다.
어떻게 하면 나한테도, 다른 사람에게도 도움이 될 수 있을지를 생각해 본 결과
챗봇을 먼저 생각하게 되었고 그중에서도 현재 문제와 가장 관련 있는 심리 상담 챗봇을 만들기로 선택했다.
2. 데이터 전처리는 어떻게 했는가?
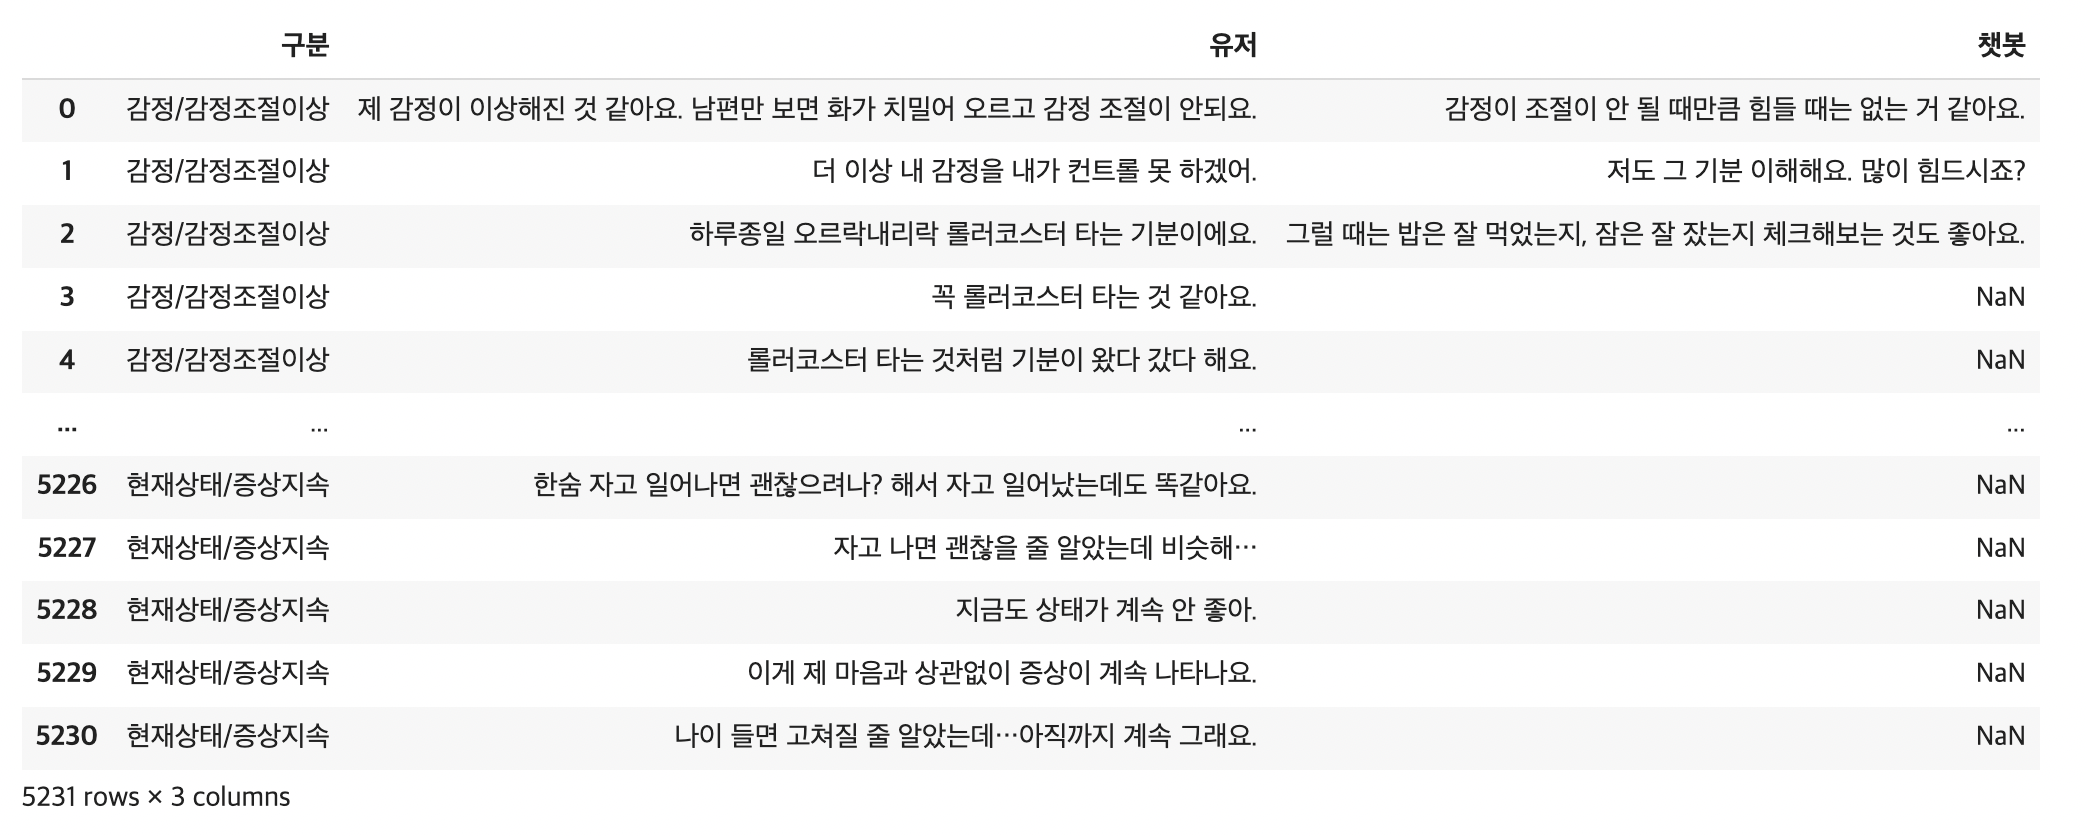
일단 심리상담 데이터셋을 가지고 왔으나 5000개중 4000개는 결측치 였다.
결측치를 모두 제거하니 1000개 밖에 안남았다.
데이터가 너무 적길래 일상 대화 데이터셋을 혼합해 사용하기로 했다.
(친근한 심리상담사 컨셉)
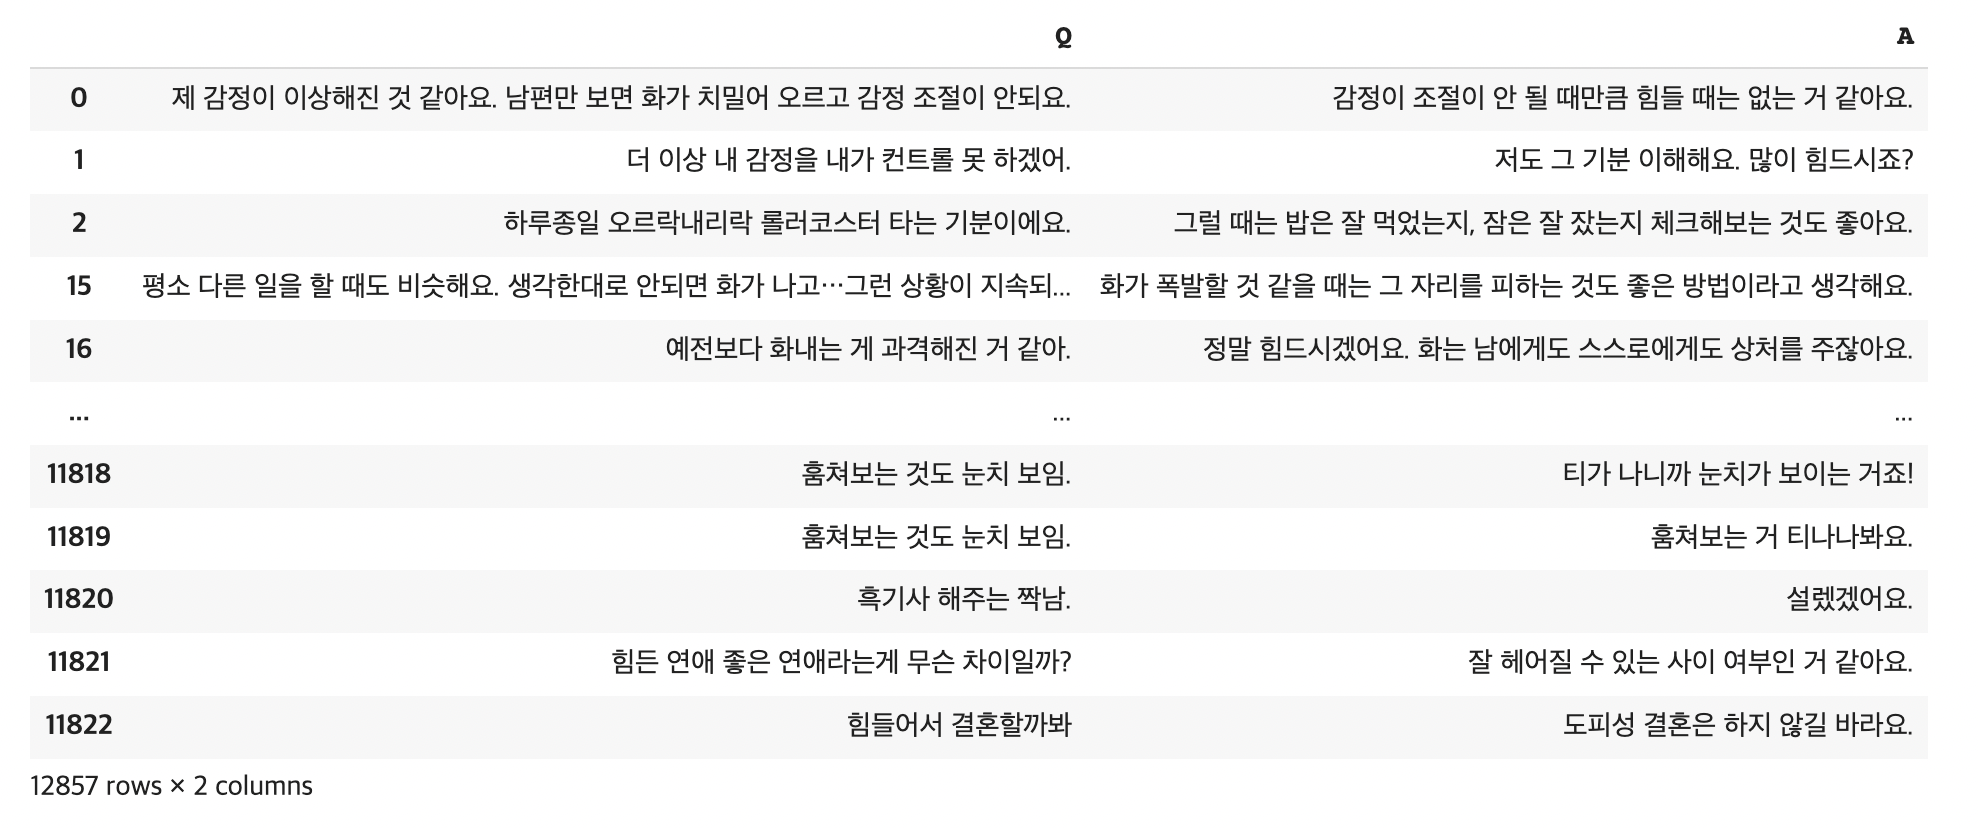
2개의 데이터셋을 합친 결과다.

텍스트 전처리는 한글, 물음표, 느낌표, 쉼표, 공백을 제외한 나머지 문자는 공백 처리해 주었다. 구두점을 어떻게 처리해야 할지 고민했는데 그 이유는 마침표 역할도 하지만 ... 과 같은 감정 표현의 역할도 하기 때문이다. 하지만 한정된 시간 안에 모델 이해도 버거웠기 때문에 일단 제거하기로 했다.
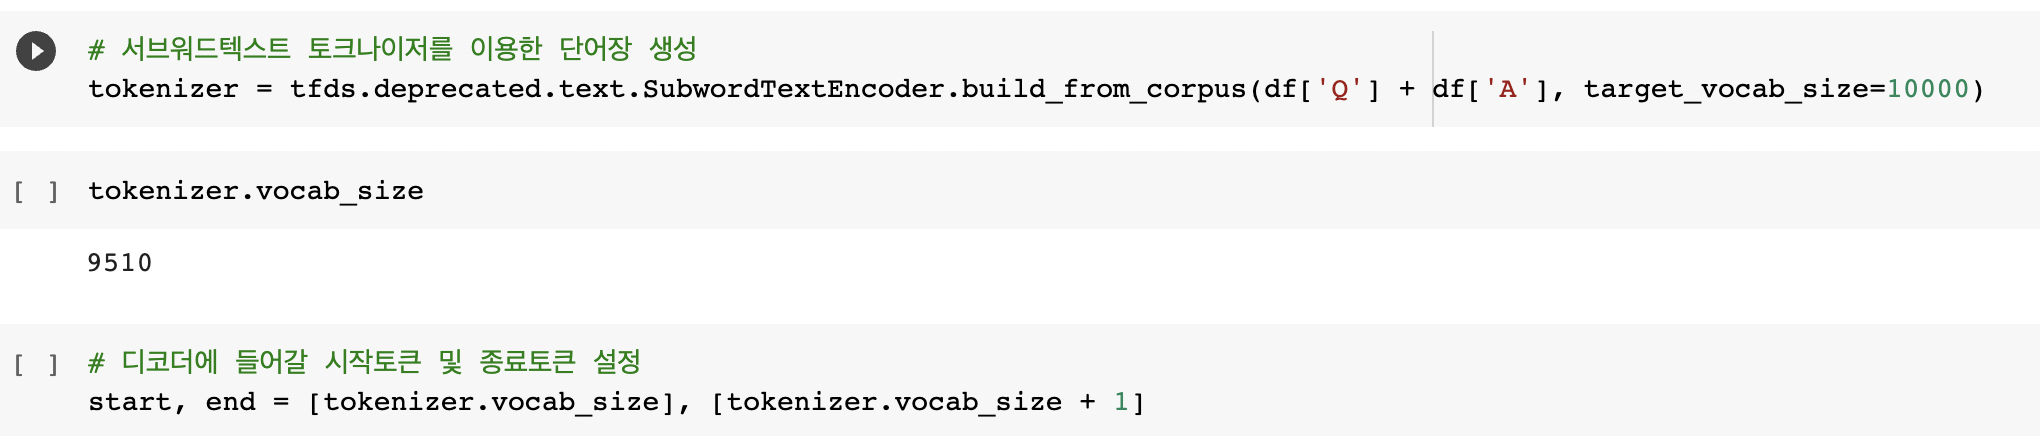
subwordtextencoder로 질문과 답변에 대한 단어장을 간단하게 만들 수 있다.(프로젝트 진행 당시 단어장을 직접 만드는 과정이 이해가 가지 않아 어쩔 수 없이 남의 코드를 가져다 썼다.)
시작 토큰, 종료 토큰을 문장마다 설정해 줘야 하는데 시작 토큰은 단어 예측을 위해 필요하며 종료 토큰은 문장 번역의 끝을 지정해 줘야 하기 때문에 필요하다.

프로젝트 제출후에 이해가 되어서 단어장을 직접 만들어 보았다.
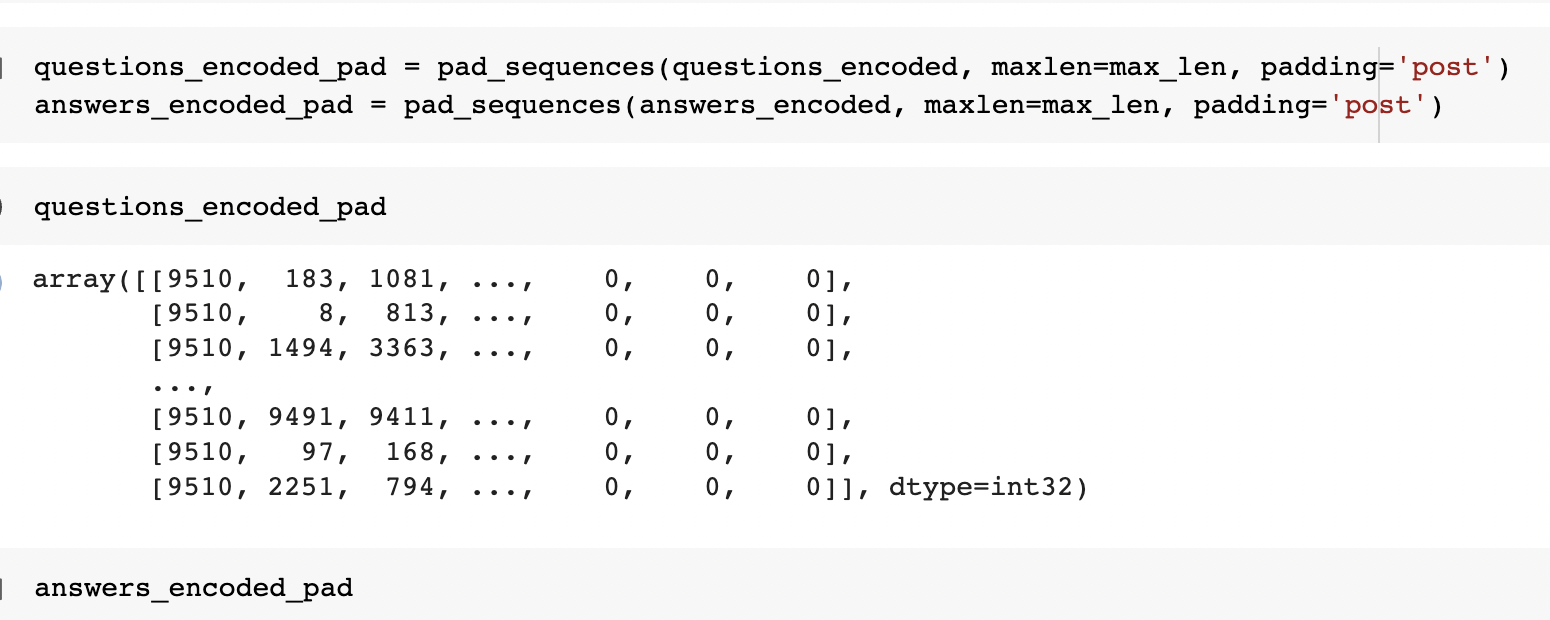
연산을 원활하게 하기 위해 패딩처리를 해줬다.
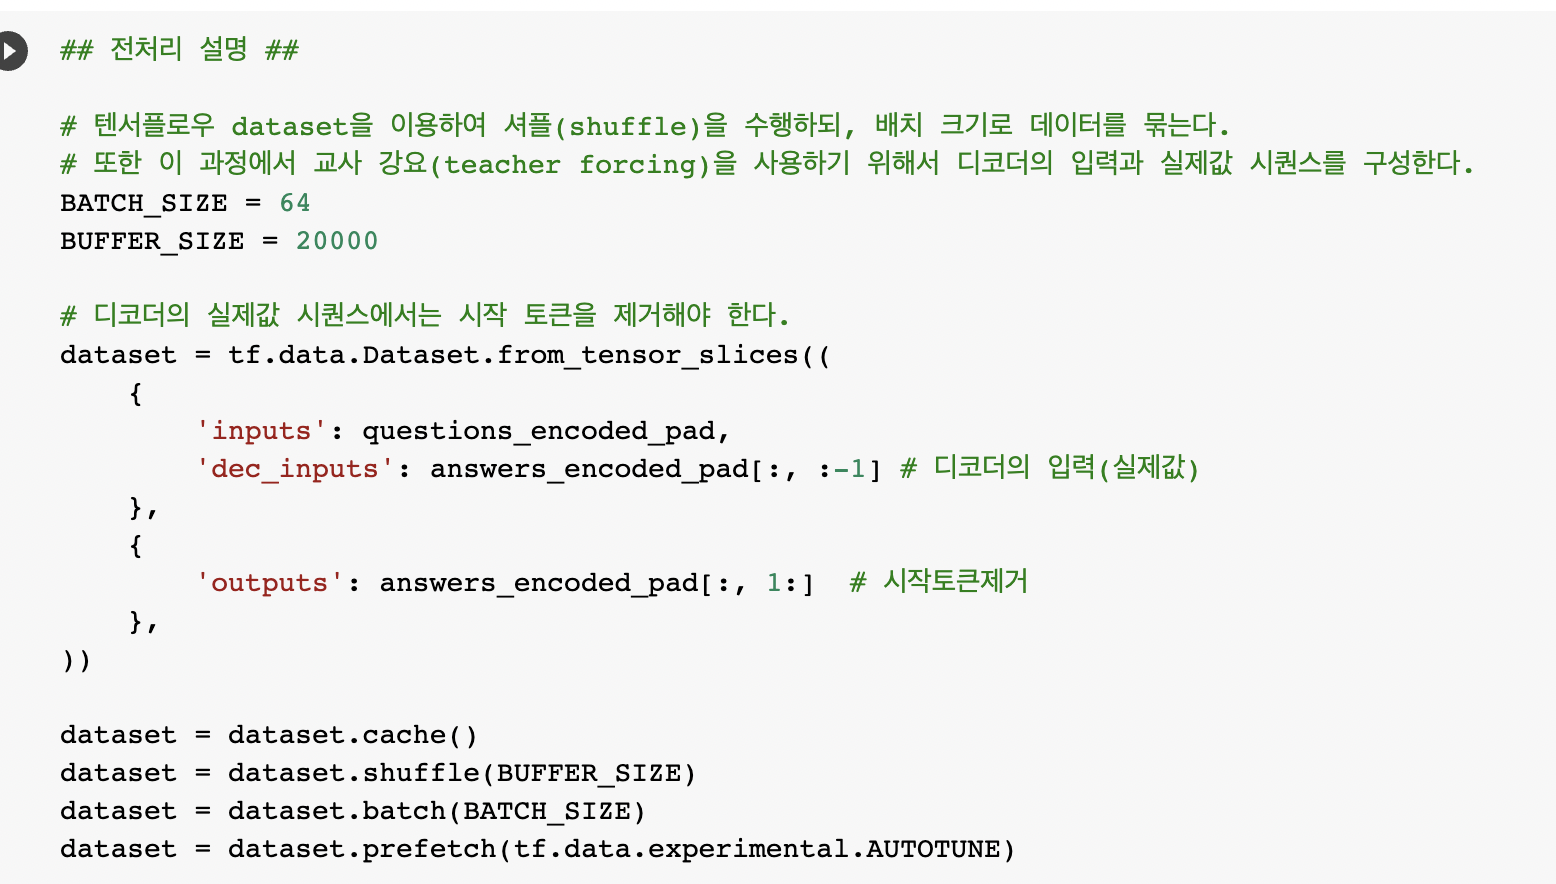
Attention 기능을 사용할때는 안정된 학습을 위해 교사 강요(Teacher Forcing)작업을 해야 한다.
교사 강요

학습에 예측값이 아닌 실제 값을 넣어준다.
디코더의 학습은 인코더의 출력 벡터 + 시작 토큰 + 단어들의 실제 벡터 값을 통해 이루어진다.
그리고 디코더의 예측은 인코더의 출력 벡터 + 시작 토큰 만을 가지고 예측을 하게 된다.
이전에 문장마다 시작 토큰과 종료 토큰을 넣어줘야 한다고 했었다.
임베딩 + 패딩 처리를 하고 나면
각 문장마다 시작 토큰 + 각 단어들 + 종료 토큰으로 구성되어 있기 때문에
위의 코드 answers_encoded_pad[:, :-1]에 -1을 입력해 주어 디코더의 학습 데이터로 만들어 준 것이고, 결괏값은 각 단어들 + 종료 토큰으로 구성되어 있으므로 answers_encoded_pad[:, 1:] 1:을 입력해 주어 시작 토큰을 제거해 주어야 한다.
3. 왜 이 모델을 선택했는가?
트랜스포머는 문장 길이가 길어질 때 정보의 손실을 완화시켜주는 LSTM의 기능을 수행해 줌과 동시에 Skip Connection(리지 듀얼 커넥션)을 이용해 병렬 처리를 수행할 수 있어 학습 시간을 단축시켜준다. 또한 멀티 헤드 어텐션(Multi-Head Attention)을 이용해 각 단어의 연관도를 다양하게 출력할 수 있기 때문에 번역의 성능 또한 좋아진다.
4. 어떤 인사이트를 얻을 수 있었는가?
이 모델은 범용성이 뛰어나다고 보는데
그 이유는 셀프 어텐션 및 멀티 헤드 어텐션을 사용하기 때문이라고 생각한다.
이것들의 핵심 키워드는 '관계'이다.
지금 프로젝트는 문장 속 단어의 관계를 학습하고 추론한 것이지만
다른 분야의 프로젝트(예를 들어 화학 분자 구조 간의 관계 파악) 등도 수행할 수 있을 거 같고 실제로 컴퓨터 비전에서도 시도하고 있는 걸로 안다.
멀티 헤드 어텐션으로 복잡한 관계 해석도 수행할 수 있을 거 같다.
5. 프로젝트 과정에서 어떤 어려움을 겪었는가?
가장 큰 어려움은 짧은 시간 안에 모델을 이해하고 실전에 응용하는 것이었다.
트랜스포머의 개념과 코드 구성 파악이 힘들었지만 그래도 기간 안에 프로젝트를 완료해야 했기 때문에 해결 방안은 일단은 원치 않게 다른 사람의 코드를 많이 참조하고 코드의 의미들만 어느 정도 파악할 수 있게 공부하면서 프로젝트를 우선 제출한 후에 그전에 몰랐던 코드에 최대한 주석을 많이 달기로 했다.
다음 사진들은 프로젝트 제출 당시의 코드와 제출 후 추가적인 공부 및 코드 필사를 통해 수정한 코드의 비교 사진이다.
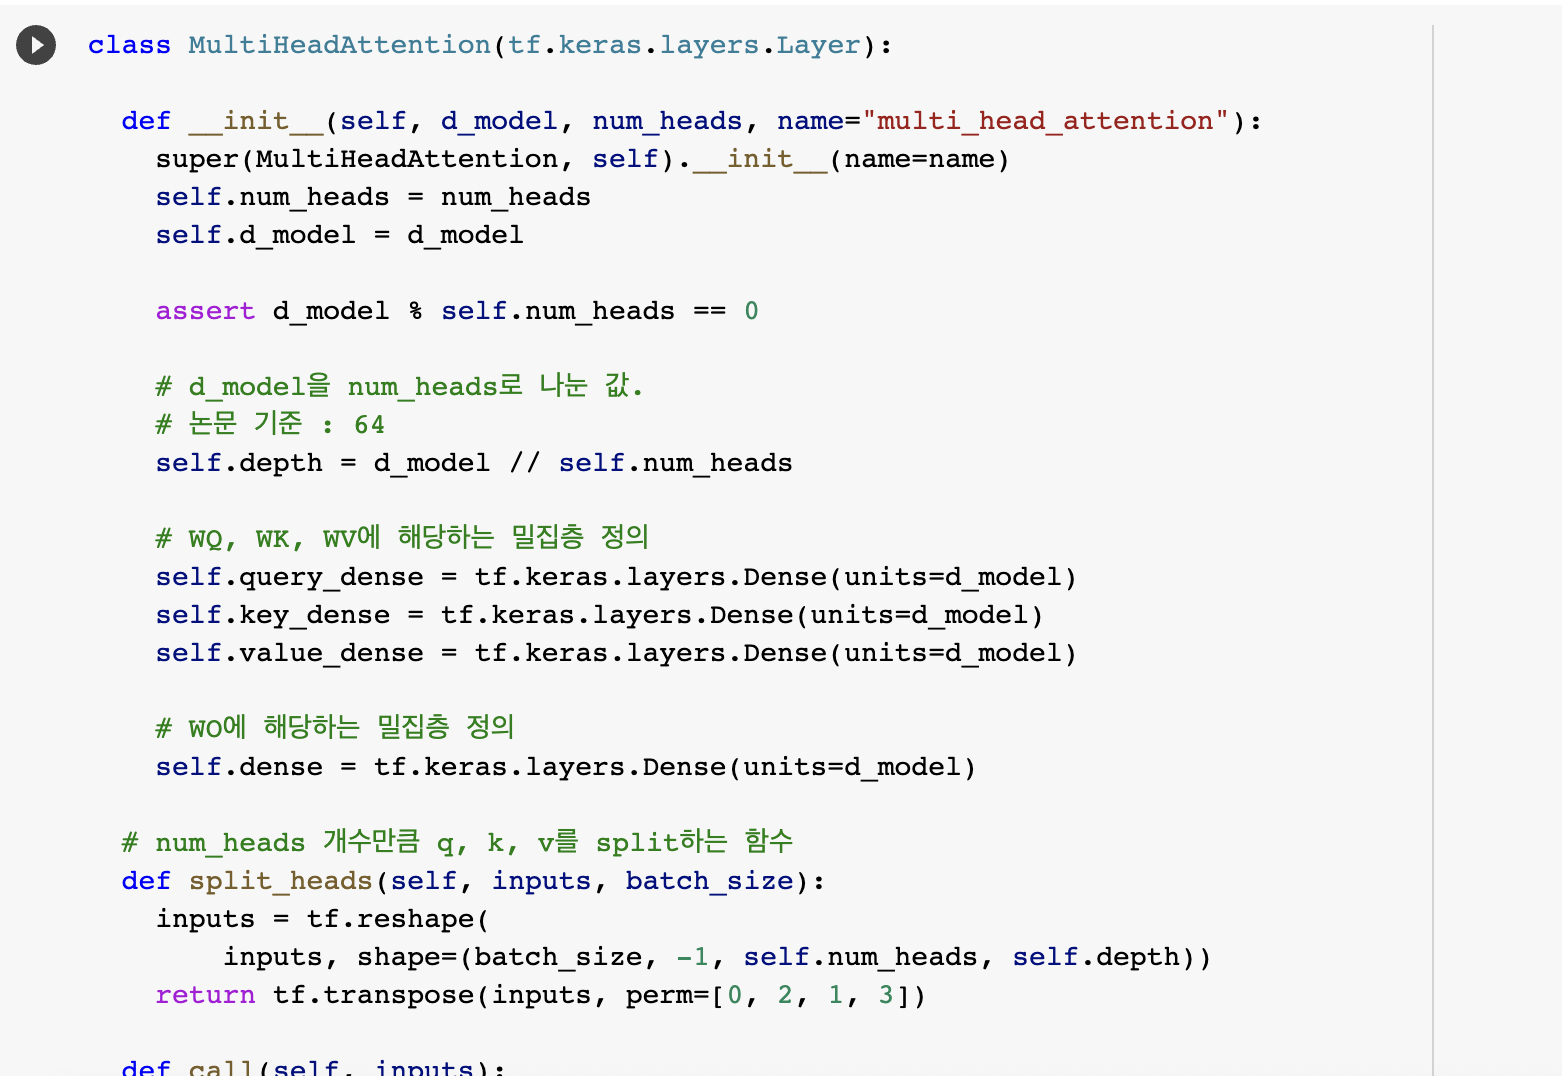
기존 멀티 헤드 어텐션 코드

수정한 멀티 헤드 어텐션 코드

기존 내적 연산 어텐션 코드
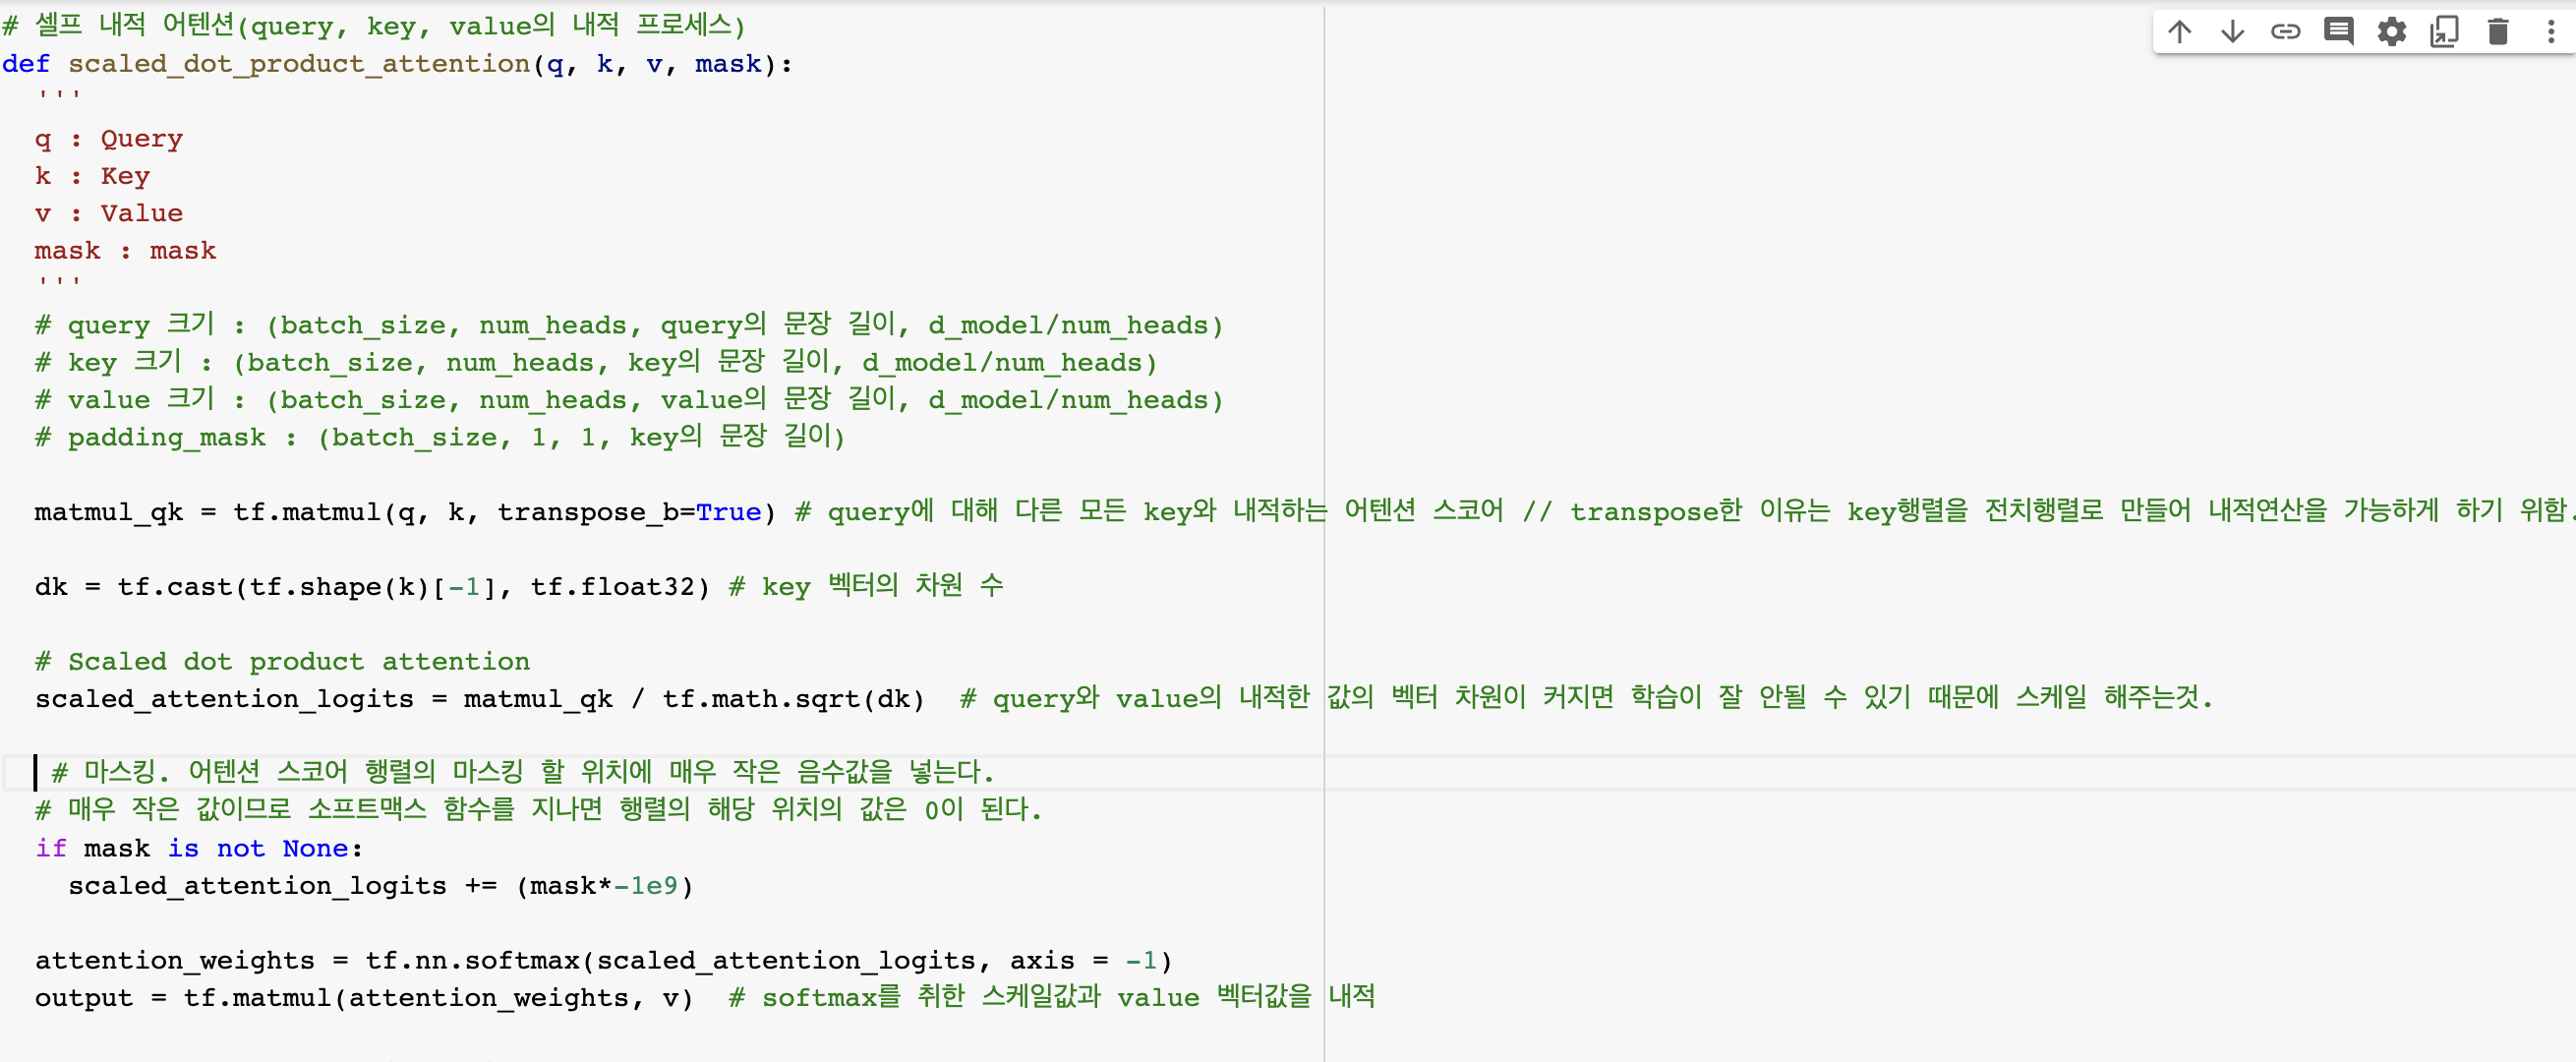
수정한 내적 연산 어텐션 코드
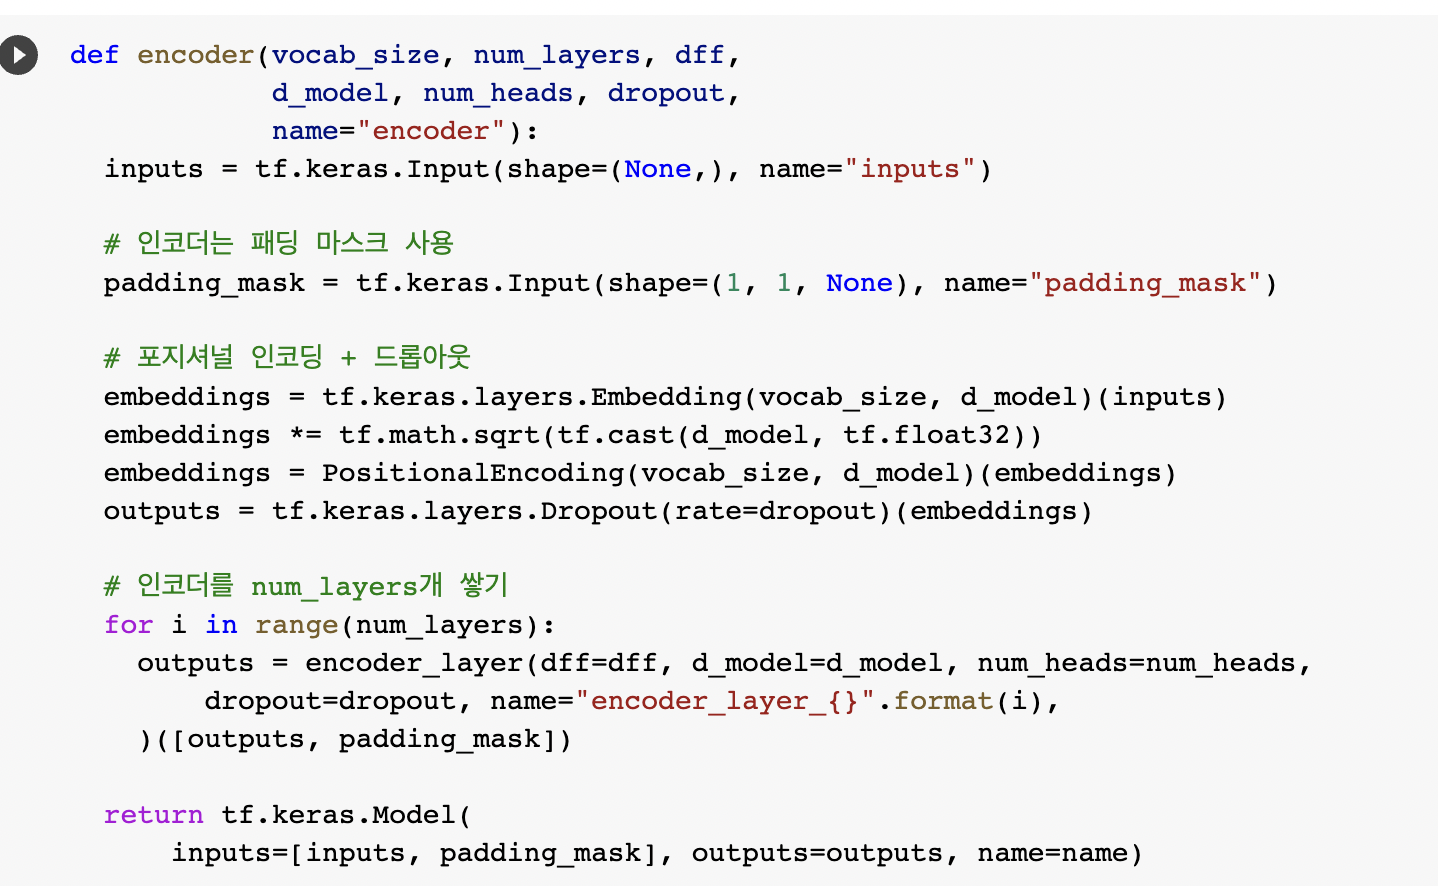
기존 Encoder 코드
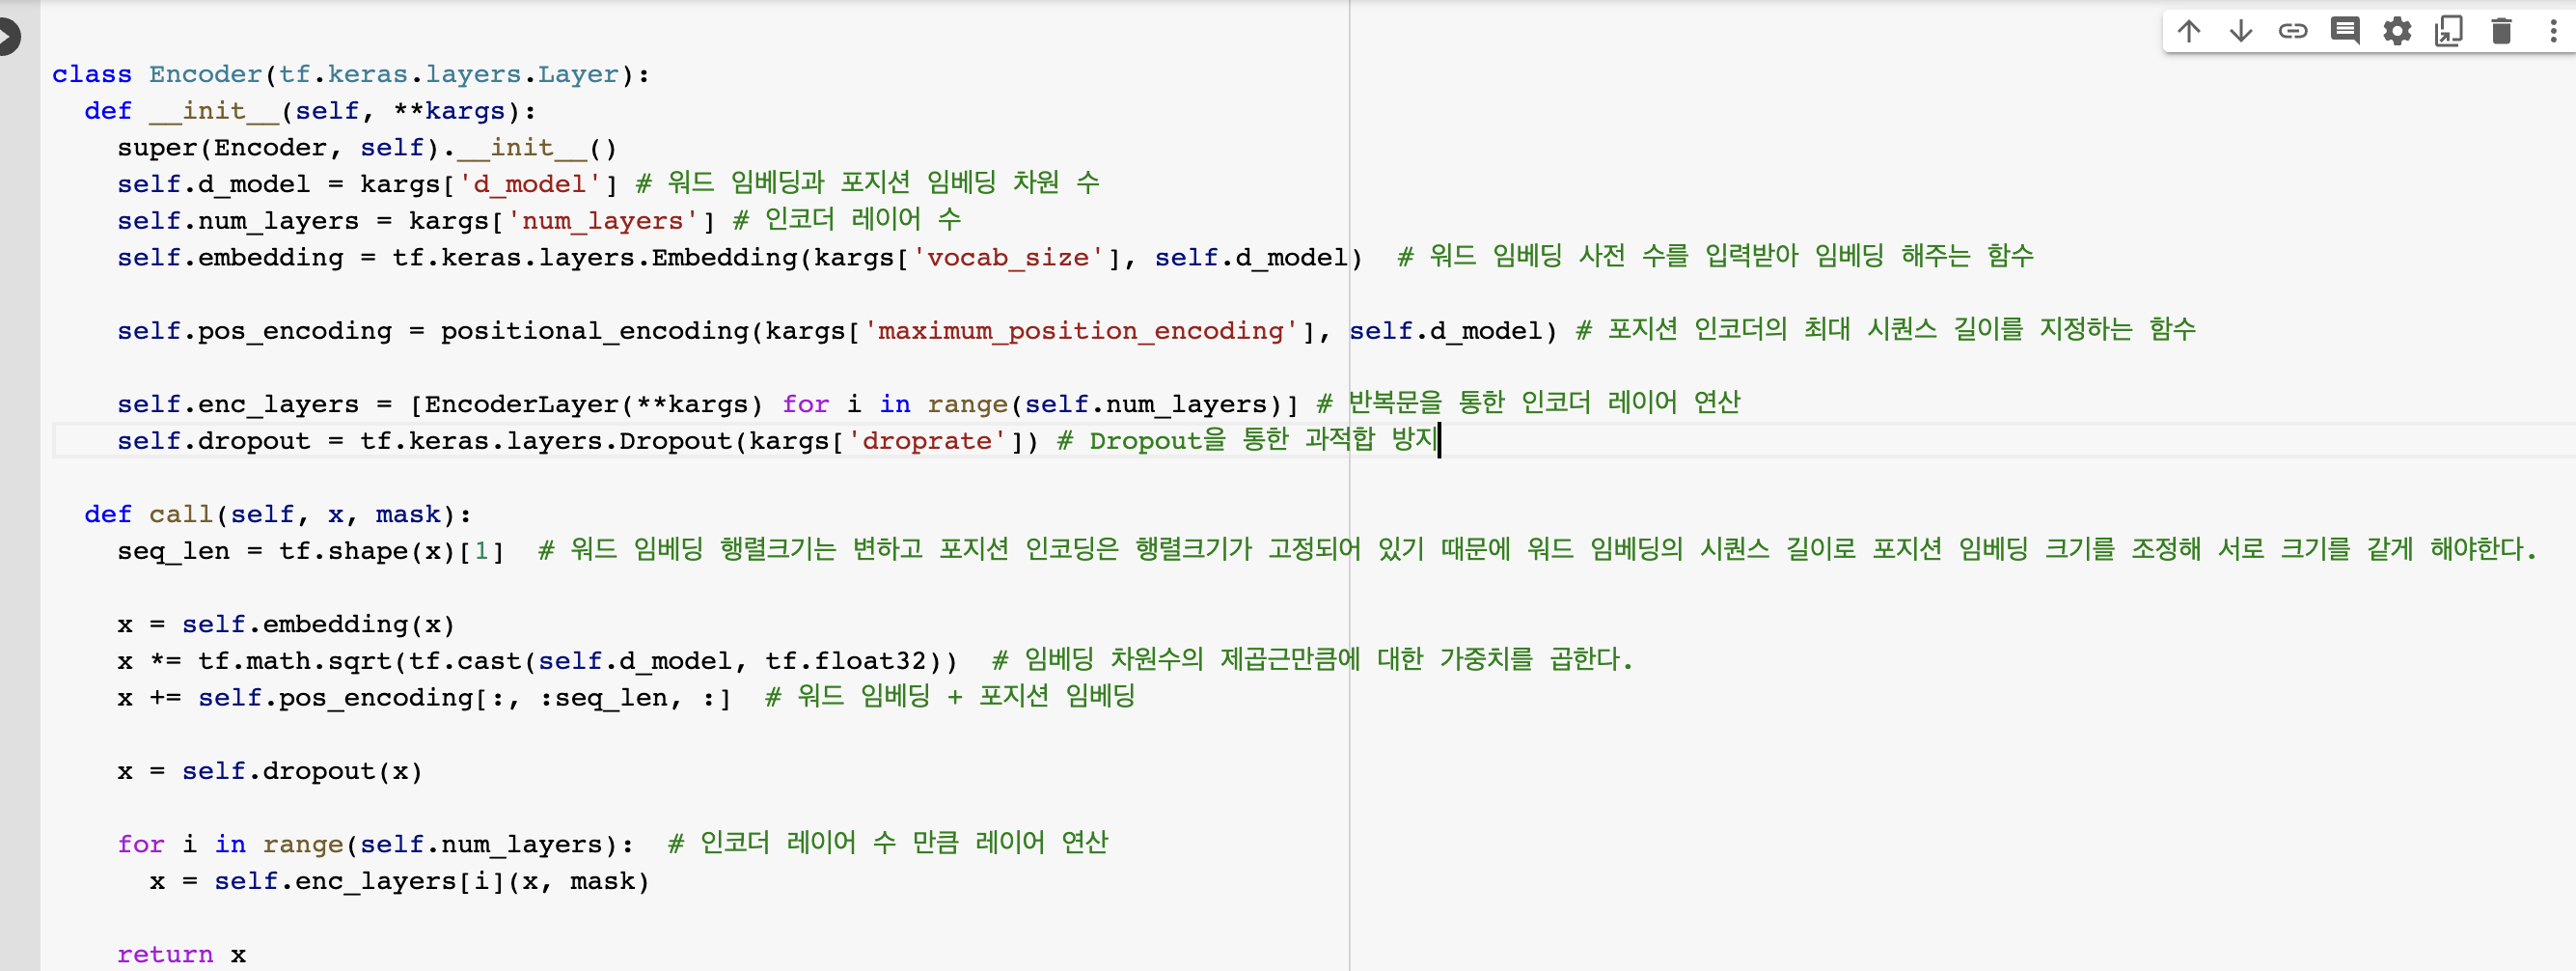
수정한 Encoder 코드
이렇게 하나씩 뜯어보니 모델을 전보다 깊이있게 이해할 수 있게 되었다.
지금도 작업중이고 최대한 빨리 마무리 짓고 싶다.
6. 프로젝트 과정에서 깨달은 바는 무엇인가?
처음 보는 코드를 뜯어보고 이해하는 과정에서 한 가지 사고방식을 터득하게 되었다.
"만약 이 코드가 없다면 결과가 어떻게 되는 거지?"
이 생각을 하면서 코드를 만져보니 보다 디테일하게 코드의 의미를 파악할 수 있었다.
이것은 질의응답 형식으로도 응용할 수 있다.
질문 : 만약 xxxx가 없으면 어떻게 되는 걸까?
답 : xxxx 일 것이다.
또한 이것은 처음 배우는 개념에도 적용할 수 있다.
이번에 적용한 트랜스포머의 경우
"질문 : 순방향 마스크 어텐션이 없다면 어떻게 진행되는 거지?"
"답 : 트랜스포머는 디코더에 전체 문장이 거의 한꺼번에 들어가기 때문에 디코더는 문장의 위치와 상관없이 모든 단어를 참고해서 예측한다. 순방향 마스크 어텐션은 그 예측 과정에서 현재 단어 뒤에 나올 단어 정보를 보이지 않게 해주는 기능인데 만약 이 기능이 없다면 과거 시점의 단어들만 참고해서 예측을 해야 하는데 미래에 나올 단어들까지 전부 참조하기 때문에 예측이 불가능해진다."
이번 프로젝트는 진로 고민 때문에 심적으로 많이 힘든 상태에서 진행해서 그런지 더욱 아쉬움이 남는 프로젝트였다.
그래도 Section Wrap-up 시간 동안 코치님께서
데이터 분석가 = 현재
데이터 사이언티스트 = 미래
라는 심플하지만 핵심적인 팁을 주셔서
불안함이 많이 해소되었다.
그 덕에 코드를 뜯어볼 힘을 얻은 거 같기도 하다.
(머신러닝 엔지니어, 데이터 엔지니어는 어떻게 정의하지..?)
피드백은 소중히 받겠습니다.
감사합니다.
혹시 일상 대화 데이터셋은 어디서 구하셨나요?