velog 플랫폼에서 첫 포스팅입니다.
그렇기에, 과거 노션에 정리했던 글을 그대로 복사해왔기 때문에 가독성에서 문제가 발생할 수도 있기 때문에, 해당사항을 댓글로 남겨주시면 빠른 수정하겠습니다. 해당 정리본은 24년 8월 24일에 시험을 치루기 전에 작성했던 것으로 최신 경향과 큰 차이가 없음을 알립니다.
1과목과 2과목을 분리하려고 했었으나, 포스팅용이 아니었기에 노션에 정리한 원본 그대로 올립니다.
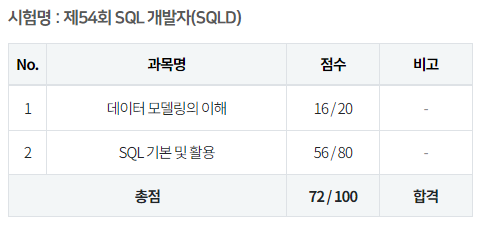
SQLD 개념 정리
데이터 모델링의 이해
데이터 모델링이란?
- 데이터 모델링은 ‘현실 세계’를 단순화하여 표현하는 기법
데이터 모델링 특징과 목적
- 추상화 : 현실 개념을 ‘간략하게’ 표현
- 단순화 : 단순하고 쉽게 표현함으로써 핵심에 집중 + 불필요 제거
- 명확화 : 애매모호함을 제거하고, ‘정확하게’ 현상을 기술
데이터 모델링 유의점 및 3가지 관점과 중요 3요소
유의점
- 중복
- 같은 데이터가 엔티티에 중복 저장되면 안 된다.
- 비유연성
- 사소한 변경에 데이터 모델이 수시로 변경되면 안 된다. → 모델과 프로세스를 분리해 변화를 일으킬 가능성을 줄인다.(유연성 있도록)
- 비일관성
- 연관 관계를 명확하게 정의해야 한다.(일관성 있도록)
관점
- 데이터 관점(What, Data)
- 어떤 데이터들이 업무와 얽혀있는지
- 프로세스 관점(How, Process)
- 업무가 실제로 처리하고 있는 일이 무엇인지, 무엇을 해야하는지
- 데이터와 프로세스의 상관 관점(Data vs Process, Interaction)
- 프로세스 흐름에 따라 데이터가 어떻게 영향을 받고 있는지
중요 요소
- 대상(Entity)
- 속성(Attribute)
- 관계(Relationships)
모델링의 3가지 단계
[ㄱ - ㄴ - ㅁ]
- 개념적 데이터 모델링
- ‘전사적’으로 수행, 추상화 레벨이 가장 높음
- E-R Diagram을 생성
- 논리적 데이터 모델링
- Key, 속성, 관계들을 표현하는 단계
- 정규화 활동이 이뤄지는 단계 → 논리적 데이터 모델을 대상으로 정규화 한다.
- 물리적 데이터 모델링
- 실제 DB를 구현할 수 있도록 성능, 가용성 등을 고려하는 단계
데이터 스키마 단계에 따른 독립성
스키마란?
- 테이블이 어떤 구성으로 되어있는지에 대한 기본적인 테이블의 구조를 정의한 것
데이터 스키마의 구조
User
↑
- 외부 스키마
- 여러 사용자가 보는 스키마 정의 및 표현(View), 사용자 관점
- 개념 스키마
- 모든 사용자가 보는 데이터 정의 및 표현 관계를 정의하는 단계, DB 정의, 설계자 관점
- 내부 스키마
- 물리적인 저장 구조를 나타내는 단계 → 저장 구조, 칼럼, 인덱스 정의, 개발자 관점
↓
DB
- 논리적 독립성
- 외부 스키마와 개념 스키마의 연관 관계. 개념이 변경되어도 외부 스키마 영향 X
- 물리적 독립성
- 개념 스키마와 내부 스키마의 연관 관계. 내부가 변경되어도 외부/개념 영향 X
엔터티
엔터티란?
- 업무에서 쓰이는 데이터들을 용도별로 분류한 데이터의 그룹. 테이블
엔터티의 특징
- 업무에서 쓰이는 정보여야 함
- 식별자가 있어야함
- 2개 이상의 인스턴스를 가져야 함.
- 반드시 속성을 가져야 하며, 하나의 인스턴스는 2개 이상의 속성을 가진다.
- 엔터티는 2개 이상의 속성을 가진다.
- 다른 엔티티와 1개 이상의 관계를 가져야한다.
엔터티 분류 방법과 그에 따른 종류
유형, 무형에 따른 분류
※ 유개사유~
- 개념 엔티티
- 형태가 없음 ex) 부서, 학과
- 유형 엔티티
- 물리적인 형태가 존재 ex) 상품, 회원
- 사건 엔티티
- 행위로 인해 발생하는 것 ex) 주문, 이벤트 응모
발생 시점에 따른 분류
※ 발퀴중~(기본, 행위, 중심)
- 기본 엔티티
- 원래 존재하는 요소로 독릭접 엔티티가 가능
- 상품, 회원, 부서
- 중심 엔티티
- 업무 과정 중 하나, 기본 엔티티로부터의 파생, 행위 엔티티를 생성
- 주문, 매출, 계약
- 행위 엔티티
- 2개 이상의 엔티티로부터 파생
- 주문 내역, 이벤트 응모 이력 등
엔티티 명명 주의점
- 실제 업무에서 쓰이는 용어를 사용
- 되도록 약어는 지양.
- 단수 명사로 표현
- 중복 X, 유일
- 엔터티 생성 의미대로 이름 부여
속성
속성이란
- 엔티티의 특징을 나타내는 최소의 데이터 단위
속성의 특징
- 더 이상 쪼개지지 않음.
- 업무에서 필요로 하는 항목
- 엔터티와 인스턴스를 설명
- 하나의 속성은 하나의 속성값만 가진다. → 여러 개일 경우 1차 정규화를 해줘야 한다.
- 일반 속성은 주식별자에 함수적 종속성을 가져야 한다. → 부분적 종속일 경우에는 2차 정규화 과정을 거쳐야 한다.
※ 정규화는 2장에서
속성의 특성에 따른 분류
일반적인 특성에 따른 분류
※ 특파썰기~
- 기본 속성
- 바로 정의 가능한 속성
- 설계 속성
- PK의 토대
- 파생 속성
- 원래 속성을 계산해 저장할 수 있도록 하는 속성으로 빠른 성능을 기대
구성 방식에 따른 분류
- PK 속성
- FK 속성
- 일반 속성
속성의 분해 가능 여부에 따른 분류
- 단일 속성
- 복합 속성
- 다중값 속성
속성이 만들어낸 데이터 모델의 개념
도메인
- 속성이 가질 수 있는 속성 값의 범위
용어 사전
- 속성의 이름을 정확하고 직관적으로 부여하기 위한 용어 사전
시스템 카탈로그
- 시스템과 관련있는 데이터를 가진 DB
- SQL로 조회 가능
- 메타 데이터, Select만 가능하고, insert, update 등은 불가능하다.
관계
관계란
- 엔터티와 엔터티 사이에 속성끼리의 연결에 의해 만들어지는 상관 관계
종류
- 존재 관계
- 모델링 된 엔터티들이 존재로 관계를 가짐
- 행위 관계
- 모델링 된 엔터티들이 행위에 의해 관계를 가짐
UML 클래스 다이어그램에 의해 나뉘는 종류
- 연관 관계
- 필수적 관계(존재적 관계, 식별자 관계).
- 항상 서로를 이용한다.(실선)
- 멤버 변수로 선언
- 의존 관계
- 선택적 관계(비식별자 관계)
- 상대 클래스 행위에 따라 이용한다.(점선)
- 행위 코드 오퍼레이션에서 파라미터로 사용
관계 표기 방법(ERD)에 따른 특성 분류
- 관계명
- 동사 사용
- 관계 차수
- 1:1, 1:M, M:N으로 구분
- 관계 선택 사양
- 필수적 관계, 선택적 관계
관계 체크 사항
- 엔터티 사이 관심있는 연관 규칙이 존재하는가?
- 두 엔터티 사이 정보의 조합이 발생하는가?
- 업무기술서, 장표에 관계연결에 대한 규칙이 서술되어 있는가?
- 업무기술서, 장표에 관계연결을 가능하게 하는 동사(Verb)가 있는가?
식별자
식별자란
- 각각의 인스턴스를 구분 가능하게 만들어주는 대표 속성
주식별자
- PK에 해당하는 속성
- 유일성
- 최소성
- 불변성
- 존재성
식별자의 특성과 특정 여부에 따른 분류
대표성 여부
- 주식별자(PK) - #으로 표현
- PK는 여러 속성이 존재 할 수 있으나, 여러 속성이 존재 할 경우 나머지 일반 속성들이 해당 PK들 속성에 대해 함수적 종속성을 띄어야 하며, 그렇지 않을 경우 2차 정규화를 통해 부분 종속에 해당하는 속성을 따로 엔터티로 관리한다.
- 보조식별자
- 식별은 가능하나 엔터티를 대표하지는 앟는다,.
- 대른 엔터티와의 참조 관계로 연결되지 않는다.
스스로 생성 되었는가
- 내부식별자
- 다른 엔터티 참조 없이 내부에서 스스로 생성된 식별자
- 외부식별자
- 다른 엔터티와 연결고리 역할
- 부모 엔터티의 FK를 받아 주식별자로 사용하면 해당 자식 엔터티 PK는 SQL 조인에서 반드시 사용되고 WHERE 절에서 사용할 가능성이 높다.
단일 속성인지에 대한 여부(주식별자 구성이 여러 속성인가)
- 단일 식별자
- 복합 식별자
대체되었는지 기존에 있는지에 대한 분류
- 원조 식별자
- 업무에 의해 만들어지는 식별자.
- 가공되지 않은 식별자
- 인조 식별자
- 인위적으로 만든 식별자
- 주식별자가 복잡할 때 이를 통합
- 불필요한 인덱스를 생성해 성능이 저하될 수 있다.
- 중복 데이터 발생 가능성이 존재
- 개발 편의성이 줄어들 수 있다.
식별자 관계 vs 비식별자 관계
식별자 관계
- 트랜잭션에 의한 관계. 모든 것이 동시에 커밋, 롤백
- 부모 엔터티의 식별자 속성이 자식 엔터티의 주식별자가 된다.
- 강한 연결 관계
- 실선(항시 연결)
- 부모-자식 관계가 상시 유지
- SQL문의 조인을 최소화
비식별자 관계
- 부모 엔터티의 식별자 속성이 자식 엔터티의 일반 속성이 되는 관계
- 약한 연결 관계
- 점선(선택적 연결)
- 부모-자식 관계 유지 안 될 수 있음
성능 데이터 모델링의 개요
성능 데이터 모델링의 정의
- 설계단계의 데이터모델링 때부터 성능과 관련된 사항이 모델링에 반영될 수 있도록 하는 것
성능 데이터 모델링 수행시점
- 사전에 할수록 비용은 적게 든다.
- 분석/설계 단계에서 성능을 고려해 재업무 비용을 최소화할 수 있다.
성능 데이터 모델링 고려사항
- 성능 데이터 모델링 프로세스
-
정규화
-
DB 용량 산정
-
트랜잭션의 유형 파악 → 테이블 수직 분할(반정규화)
등등.
-
정규화
정규화란
- 엔터티를 작은 단위로 분리하는 과정
- 논리 데이터 모델에서 행하는 과정이다.
- 개념 모델링, 물리 모델링에서 일어나는 일이 아니다.
정규화의 장점
- 데이터의 무결성을 위해 수행
- 일관성 확보
- 독립성 확보 → 데이터 중복 제거
- 유연성 확보 → 데이터 분할로 인해 유연하게 접근 가능
- 입력, 수정, 삭제 성능은 일반적으로 향상
정규화의 단점
- 엔터티 갯수 증가 → 관계 증가
- 조회 성능의 저하
제 1 정규화
- 모든 속성은 반드시 하나의 값을 가진다.
제 2 정규화
- PK가 두 개 이상일 때, 그 PK의 부분집합으로 종속되는 관계가 있다면 분리해야한다.
- 이를 부분 함수적 종속 제거라고 한다.
제 3 정규화
- PK가 아닌 일반 칼럼에 의존하는 칼럼이 존재할 시 이를 제거한다.
- A→B, B→C일 때, A→C가 성립하는 것을 의미한다.
반정규화
반정규화란
- 정규화된 데이터 모델에 대해 성능 향상과 단순화를 위해 데이터를 중복, 통합, 분리하는 기법
- 보통 정규화 시 여러 조인을 요구해 성능이 떨어지기 때문에 의도적으로 정규화를 위배하는 것을 말한다.
관계와 조인
관계란
- 부모 엔터티의 식별자를 자식에 상속하고, 상속된 속성을 매핑키로 활용
관계의 분류
- 존재 관계
- 행위 관계
조인이란
- 데이터 중복을 피하기 위해 테이블은 정규화에 의해 분리
- using을 사용해 조인을 만들었을 때, 접두사를 붙일 수 없다.
- https://cceeun.tistory.com/189


- 결과


- 결과


- 결과

Right Join에서도 이와 같이 문장을 구성하면 된다.
트랜잭션
트랜잭션이란
- 하나의 연속적인 업무 단위를 뜻한다.
- 하나의 트랜잭션에 속한 동작들은 모두 성공하거나, 모두 취소되어야 한다.
- 서로 독립적으로 업무가 발생하면 안 된다.
- 부분 커밋 불가하다.
SQL 기본 및 활용
SQL 문을 읽는 순서
- from - where - group by - having - select - order by 순서
Where 절 특징
where절에서 함수를 사용하는 것은 가능하나, 집계 함수(SUM,AVG,COUNT등)를 직접 사용하는 것은 허용하지 않는다.where절은 개별적으로 필터링을 해야하나, 집계 함수는 여러 행의 데이터를 요약해 결과를 생성하기 때문에 적용할 수가 없다.- 즉,
where sum(sala) > 20000은 잘못된 예인데,sum(sala)는 여러 행의sala값을 합산하는데,where절에서 수행할 수 있는 개별 행에 대한 조건이 아니다. - 사용하기 위해서는
having절을 사용해야 한다.having절은group by절과 함께 사용해 그룹화된 결과에 대해 조건을 적용한다. - Alias를 사용할 수 없다. 이유는 select 절이 실행되기 전에 처리되기 때문이다.
관리 구문
- DML(데이터 조작어)
- 인셀업대~
- insert, select, update, delete, merge
- SQL Auto
insert into 테이블명 칼럼명 values 리스트
update 테이블명 set 칼럼명 = data where 조건
delete from where
merge
into : 애를 수정할 것
using : 애를 참조해서 수정할 것
on : 조건이 true, false이면 그에 따라 수정할 것
- DDL(데이터 정의어)
- create, alter, drop, rename, truncate
- ORACLE, MYSQL 둘 다 Auto Commit
- varchar2는 오라클에서, varchar는 sql에서 사용
ALTER TABLE 테이블명 ADD 칼럼명 데이터타입 {DEFAULT} {제약조건}
ALTER TABLE 테이블명 ADD CONSTRAINT 제약속성명 제약조건 (칼럼명) -> 괄호 필요

		-> NOT NULL 속성은 맨처음에 부여 불가능
		-> 이미 TABLE에 여러 속성들 있을텐데 거기에 ADD 되는거다 보니 애초에 값이
		-> 모두 NULL로 채워지기 때문
		-> BUT ! 만약 DEFAULT 선언해놓은 상태면 NOT NULL 걸면 제약 가능
		-> DEFAULT 값으로 이미 NULL말고 다른 값들이 다 들어가있어서

[ 칼럼 수정 ORACLE = MODIFY ]
ALTER TABLE 테이블명 MODIFY 칼럼명 데이터타입 {DEFAULT} {제약조건}
ALTER TABLE 테이블명 MODIFY (칼럼명 데이터타입 {DEFAULT} {제약조건})
		-> () 괄호 붙여도 되고 안붙여도 된다.
		-> MODIFY는 동시에 여러개 불가능하다.

[ 칼럼 수정 SQL SERVER = ALTER COLUMN ]
ALTER TABLE 테이블명 ALTER COLUMN 칼럼명 데이터타입 {DEFAULT} {제약조건}
		-> ALTER COLUMN 은 () 사용하지 않고
		-> 여러개 동시에 수정 불가능하다.

(기존에 있던 칼럼을 KEY로 만들 수도 있음)
ALTER TABLE 테이블명1 ADD CONSTRAINT KEY이름 FOREIGN KEY (지정칼럼)
REFERENCES 테이블명2(지정칼럼)
		-> KEY 지정할 땐 칼럼에 무조건 () 씌워줘야한다.

		-> ADD, MODIFY 둘 다 명령어 뒤에 COLUMN 이 오지 않음
		-> MODIFY로 데이터 크기 줄이는건 안됨, 그러나 늘리는건 상관없음
		-> 데이터 타입도 바꾸려면 안에 들어있는 데이터가 없어야함 -> BUT CHAR -> VARCHAR는 가능
		-> NULL값이 칼럼에 없어야 NOT NULL 제약 조건이 추가 가능
---------------------
ALTER TABLE 테이블명 DROP COLUMN 칼럼명;
ALTER TABLE 테이블명 RENAME COLUMN 기존 칼럼명 TO 변경할 칼럼명;

		-> DROP, RENAME은 COLUMN 이 붙어야한다.
-> 왜냐 !? DROP, RENAME은 COLUMN 말고 TABLE에도 가능하니깐 구분해야함- DCL(데이터 제어어)
- grant, revoke
- TCL(트랜잭션 제어어)
- commit, rollback, savepoint
- 오라클 Auto
SELECT
- select, from은 필수이며 where 절은 필수가 아니므로 생략이 가능하다.
함수
문자형 함수
- CHR
- 코드 값에 따른 문자 출력(ASCII 코드)
- LOWER
- 입력 문자열을 소문자로 변환
- UPPER
- 입력 문자열을 대문자로 변환
- LTRIM(문자열, [특정문자])
- 왼쪽 특정문자 제거(제거 되면 멈춤)
- RTRIM
- SUBSTR(문자열, 시작점, [길이])
- 1부터 시작하며, 문자열의 원하는 부분만 잘라서 추출한다.
- SUBSTR(’블랙핑크제니’, 3, 2) → ‘핑크’
- SUBSTR(’블랙핑’, 3, 3) → ‘핑’
- INSTR(문자열, 특정문자, [시작점], 몇번째에 발견])
- 문자열에서 원하는 문자 찾아서 위치 반환
- INSTR(’A#B#C#’, ‘#’, 3, 2) → 6
- LENGTH(문자열)
- 문자열의 길이를 반환
- REPLACE(문자열, 찾는 문자열, [변경 할 문자열])
- 문자열에서 특정 문자열을 찾아서 이를 변경 → 변경 할 문자 입력 안하면 없앤다.
- LPAD(문자열, 길이, 특정 문자)
- 문자열이 설정한 길이가 될 때 까지 왼쪽을 특정 문자로 채운다.
- RPAD
- CONCAT(문자, 문자)
- 두 문자를 결합하는 함수
숫자형 함수
- ABS(수)
- SIGN(수)
- 부호를 반환.
- 0은 0을 반환한다.
- CEIL(수) → 올림
- 소수점 이하의 수를 올림
- 음수일 때는 커진다.
- ROUND(수, [자릿수]) → 반올림
- 수를 지정한 소수점 자릿수까지 반올림.
- Default 시에는 정수로 만든다.
- 음수는 해당 자릿수의 정수를 반올림
- ex) ROUND(163.76, 1) → 163.8 / 소수 첫째 자리에서 반올림
- ex) ROUND(163.76, -2) → 200 / 십의 자리에서 반올림
- TRUNC(수,[자릿수]) → 버림
- 수를 지정한 소숫점 자릿수까지 버림.
- Default = 정수로 만든다.
- ex) TRUNC(54.29, 1) → 54.2
- ex) TRUNC(54.29, -1) → 50
- FLOOR(수) → 소수점 이하 버림
- 소수점 이하의 수를 버림
- ex) FLOOR(22.3) → 22
- ex) FLOOR(-22.3) → -23
- 소수점 이하의 수를 버림
- MOD(수1, 수2) → 나머지
- 수1을 수2로 나눈 나머지를 반환
- 수2가 0일 경우 수1을 그대로 반환
- ex) MOD(15, 7) → 1
- ex) MOD(15, -4) → 3
- 음수를 MOD할 경우에는 양수라 생각한다.
날짜 함수
- SYSDATE
- 현재 연, 월, 일, 시, 분, 초를 반환
- EXTRACT(특정 단위 FROM 날짜데이터 OR SYSDATE)
- 특정 단위의 날짜를 반환
- ex) EXTRACT(YEAR FROM SYSDATE) → 2024
- ex) EXTRACT(MONTH FROM SYSDATE) → 8
- ADD_MONTHS(날짜 데이터, 특정 개월 수)
- 날짜를 더해 반환하는 함수
- 기준 날짜 일자가 존재하지 않으면 해당 월의 마지막 일자 반환
- ex) ADD_MONTHS(TO_DATE(’2021-12-31’), 1) → 2022-01-31
- ex) ADD_MONTHS(DATE ‘2022-01-31’, 1) → 2022-02-28
변환 함수
- TO_NUMBER(문자열)
- 문자열을 숫자로 변환
- TO_CHAR(수 OR 날짜, [포맷])
- 수나 날짜 데이터를 문자형 또는 입력 포맷으로 변환
- TO_DATE(문자열, 포맷)
- 포맷 형식의 문자 데이터를 YYYY-MM-DD 형식의 날짜 데이터로 바꿈
그룹 함수
- COUNT(대상)
- 행의 수 리턴
- SUM(대상)
- 합을 리턴
- AVG(대상)
- 평균을 리턴
- MIN(대상)
- 최솟값 리턴
- MAX(대상)
- 최댓값 리턴
- VARIANCE(대상)
- 분산 리턴
- STDDEV(대상)
- 표준편차 리턴
※ 그룹함수에서 NULL은 무시한다.
NULL 함수 & 치환 함수
- NVL(인수1, 인수2)
- 인수1의 값이 NULL일 경우 인수2를 반환
- NULL이 아니면 그대로 인수1 반환
- NULLIF(인수1, 인수2)
- 인수1과 인수2가 같으면 NULL 반환
- 같지 않으면 인수1을 반환
- COALESCE(인수1, 인수2, 인수3, … )
- NULL이 아닌 최초의 인수를 반환
- NVL2(인수1, 인수2, 인수3) → 3개 까지
- 인수1이 NULL이 아니면 인수2, NULL이면 인수 3반환
- ex) NVL2(REVIEW_SCORE, ‘리뷰있음’, ‘리뷰없음’)
- 인수1이 NULL이 아니면 인수2, NULL이면 인수 3반환
- CASE
- 별도의 else가 없으면 NULL 값이 else의 default가 된다.
- DECODE(대상, 값1, 리턴1, 값2, 리턴2, … ELSE 값)
- CASE 구문과 같은 역할 조건의 구분은 없다.
윈도우 함수
RANK(1,2,2,4), DENSE_RANK(1,2,2,3), ROW_NUMBER(1,2,3,4)
LAG(이전 결과 가져온다.), LEAD(이후 결과 가져온다)
LAG(SAL, 2, 0) → SAL은 두 번째 앞의 행을 가져오며, 없을 경우에는 0을 입력한다. 기본은 NULL이다.
CUME_DIST, PERCENT_RANK, NTILE, RATIO_TO_REPORT
CUME_DIST : 전체건수에서 현재 행보다 작거나 같은 건수에 대한 누적백분율
PERCENT_RANK : 제일 먼저 나오는 것을 0, 늦게 나오는 것을 1로 하여 순서별 백분율을 구한다.
NTILE : NTILE(4) 4개 그룹으로 분류한다.
RATIO_TO_REPORT : SUM 값에 대한 행별 컬럼 값의 백분율을 소수점으로 변환한다.
그룹핑
<GROUPING SETS>

SELECT department, job, SUM(salary)
FROM employees
GROUP BY GROUPING SETS (
  (department, job),
  (department),
  (job),
  ()
);

department와 job으로 그룹화된 결과
department로만 그룹화된 결과
job으로만 그룹화된 결과
전체 데이터의 합계 (그룹화 없음)

<ROLLUP>

SELECT department, job, SUM(salary)
FROM employees
GROUP BY ROLLUP (department, job);

department와 job으로 그룹화된 결과
department로만 그룹화된 결과 (각 부서별 합계)
전체 합계 (모든 부서와 직무를 포함한 합계)
특징: ROLLUP은 지정된 순서대로 그룹화를 수행하며, 마지막에 전체 합계를 추가합니다.
예를 들어 ROLLUP (A, B, C)는 다음과 같은 집계 결과를 반환합니다:
(A, B, C)
(A, B)
(A)
()

<CUBE>

SELECT department, job, SUM(salary)
FROM employees
GROUP BY CUBE (department, job);

department와 job으로 그룹화된 결과
department로만 그룹화된 결과
job으로만 그룹화된 결과
전체 합계
그리고 다른 모든 가능한 조합들
징: CUBE는 모든 가능한 조합을 계산하므로,
예를 들어 CUBE (A, B, C)는 다음과 같은 모든 조합에 대한 결과를 반환합니다:
(A, B, C)
(A, B)
(A, C)
(B, C)
(A)
(B)
(C)
()
한 편의 주마등이 망작이 될 수는 없잖아.