2강은 오믹스 데이터를 얻은 뒤에 무엇을 분석하는가에 대한 내용이며 전체 흐름은 크게 두 갈래인 유전체 데이터 분석,전사체/단백체 데이터 분석으로 나뉨
- 유전체는 변이 해석, 드라이버 유전자 탐색, 변이 패턴 분석을 중심으로 다루고 전사체·단백체는 정규화, 차등 발현 분석, gene set 분석, 클러스터링, 차원축소를 중심으로 정리함
1. Downstream analysis란?
-
Downstream analysis는 전처리가 끝난 데이터를 가지고 실제 생물학적 의미를 해석하는 분석 단계임
-
예를 들어 NGS 데이터는 처음에 FASTQ 형태로 나오고 alignment를 거쳐 BAM 파일이 만들어짐
-
DNA-seq에서는 이후 variant calling을 통해 VCF 파일을 만들고, RNA-seq에서는 quantification을 통해 read count matrix를 만듦
-
전처리 결과물을 가지고 질병과 관련된 변이, 유전자 발현 차이, pathway 변화 등을 해석하는 과정이 downstream analysis임
2. 유전체 데이터 분석
- 유전체 데이터에서는 주로 DNA 변이를 분석함
| 분석 | 설명 |
|---|---|
| Variant annotation | 발견된 변이가 어떤 의미를 가지는지 해석 |
| Functional prediction | 변이가 유전자나 단백질 기능에 미치는 영향 예측 |
| Driver gene identification | 암 발생이나 진행에 영향을 주는 주요 유전자 탐색 |
| Co-occurrence / mutual exclusivity | 변이들이 함께 나타나는지, 서로 배타적으로 나타나는지 분석 |
3. Variant annotation
-
Variant annotation은 변이의 의미를 해석하는 과정임
-
예를 들어 어떤 환자에게 특정 유전자 변이가 발견되었다고 했을 때 그 변이가 질병과 관련 있는지, 단백질 기능을 바꾸는지, 기존 연구에서 보고된 변이인지 확인해야 함
-
대표적인 데이터베이스와 도구는 다음과 같음
| 구분 | 예시 |
|---|---|
| 기존 연구 기반 annotation | ClinVar, OncoKB, COSMIC |
| 변이 영향 예측 도구 | SnpEff, SnpSift, ANNOVAR, VEP |
-
ClinVar에서는 변이를 pathogenic, likely pathogenic, uncertain significance, likely benign, benign 등으로 분류함
-
변이가 질병을 일으킬 가능성이 있는지 단계별로 정리해주는 데이터베이스라고 보면 되며 OncoKB는 암 관련 변이에 초점을 맞춘 데이터베이스임
-
암 진단, 예후, 치료와 관련된 변이 정보를 전문가들이 정리해둔 자료라서 연구뿐만 아니라 임상 의사결정에도 활용됨
4. Driver gene identification
-
Driver gene은 암 발생이나 진행에 실제로 영향을 주는 유전자를 의미함
-
환자 집단에서 어떤 유전자나 염기 위치가 무작위로 기대되는 것보다 더 자주 변이된다면
그 변이가 암 발생 과정에서 선택되었을 가능성이 있음 -
쉽게 말하면 그냥 우연히 생긴 변이가 아니라 암세포에게 유리해서 반복적으로 나타난 변이를 찾는 것임
-
다만 주의할 점은 어떤 영역은 원래 mutation rate가 높을 수 있음
-
예를 들어 자료에서는 다음과 같은 영역들이 mutation rate에 영향을 줄 수 있다고 설명함
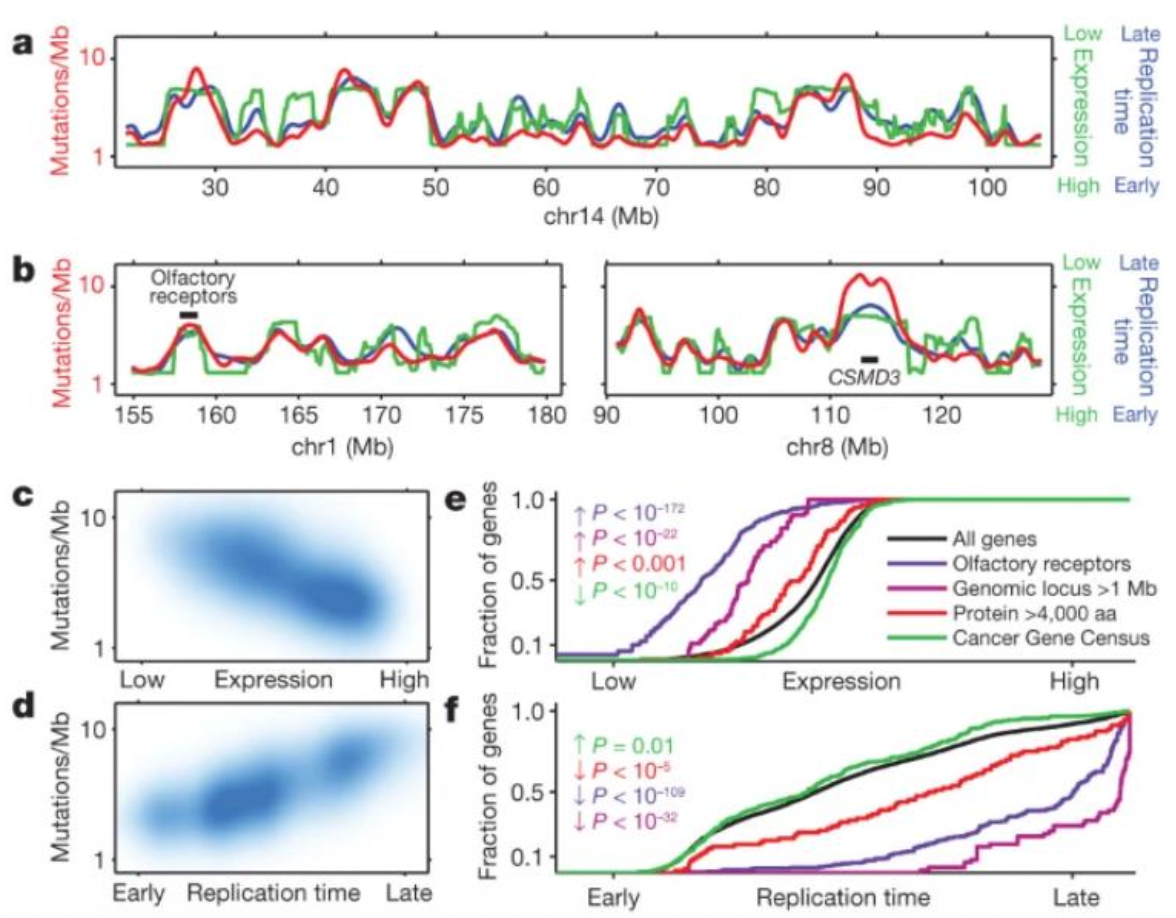
| 요인 | 의미 |
|---|---|
| Late-replicating regions | DNA 복제가 늦게 일어나는 영역 |
| Lowly expressed genes | 발현량이 낮은 유전자 |
| Heterochromatin regions | 조밀하게 응축된 염색질 영역 |
Driver gene을 찾을 때 단순히 변이 빈도만 보면 안되고 일부 유전체 영역은 발현량이 낮거나 복제 시간이 늦거나 heterochromatin 영역에 위치해 원래 mutation rate가 높을 수 있으며 변이가 많이 관찰되더라도 이것이 암 발생 과정에서 선택된 결과인지 단순히 배경 mutation rate가 높은 영역이기 때문인지 구분해야 함
5. Co-occurrence와 Mutual exclusivity
- 유전자 변이 패턴을 볼 때 중요한 개념이 co-occurrence와 mutual exclusivity임
| 개념 | 의미 |
|---|---|
| Co-occurrence | 두 변이가 같은 샘플에서 함께 자주 나타남 |
| Mutual exclusivity | 두 변이가 같은 샘플에서 잘 같이 나타나지 않음 |
-
Co-occurrence는 두 유전자가 서로 협력할 가능성을 시사할 수 있음
-
반대로 mutual exclusivity는 두 변이가 같은 pathway에서 비슷한 역할을 하거나 동시에 생길 필요가 없다는 의미일 수 있음
6. RNA-seq 데이터 분석
-
RNA-seq 데이터에서는 각 유전자가 얼마나 발현되었는지를 read count로 측정하지만 raw count를 그대로 비교하면 안 됨
-
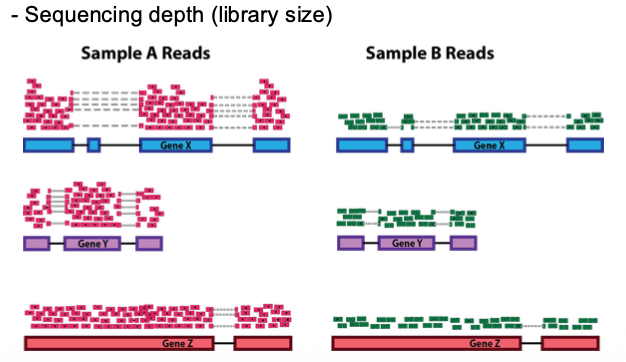
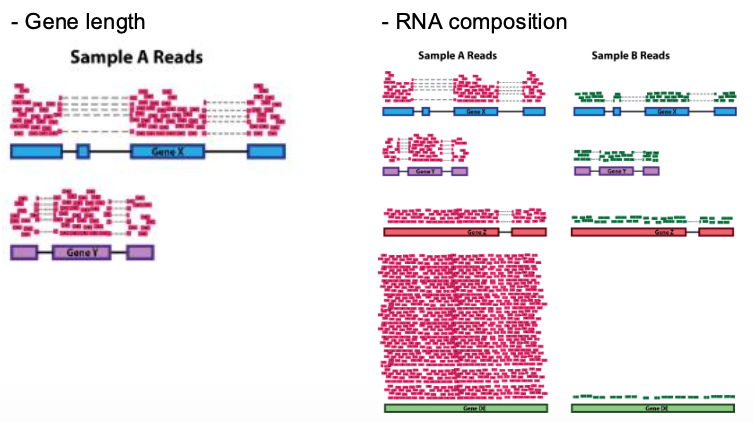
샘플마다 sequencing depth가 다르고 유전자 길이도 다르며 RNA composition도 다를 수 있기 때문에 normalization이 필요함
7. RNA-seq normalization
- RNA-seq 정규화에서 고려해야 하는 요소
| 요소 | 설명 |
|---|---|
| Sequencing depth | 샘플마다 전체 read 수가 다름 |
| Gene length | 긴 유전자는 read가 더 많이 붙을 가능성이 있음 |
| RNA composition | 특정 유전자가 과도하게 발현되면 전체 분포가 왜곡될 수 있음 |
- 대표적인 normalization 방법
| 방법 | 특징 |
|---|---|
| CPM | sequencing depth만 보정 |
| TPM | gene length와 sequencing depth 보정 |
| RPKM/FPKM | gene length와 sequencing depth 보정 |
| DESeq2 median of ratios | sequencing depth와 composition bias 보정 |
| edgeR TMM | library size와 composition bias 보정 |
- RNA-seq 차등발현분석에서는 DESeq2나 edgeR이 자주 사용됨
8. Differential expression analysis
-
Differential expression analysis는 조건 간 유전자 발현 차이를 찾는 분석임
-
예를 들어 정상 조직과 암 조직을 비교해서 어떤 유전자가 암 조직에서 더 많이 발현되는지, 또는 더 적게 발현되는지 확인하는 과정이며 RNA-seq count data는 일반적인 연속형 데이터가 아니라 count data임
-
생물학적 반복 샘플 사이의 변동성도 크기 때문에 negative binomial distribution이 자주 사용됨
-
대표적인 도구는 다음과 같음
| 도구 | 특징 |
|---|---|
| DESeq2 | median ratio normalization 사용 |
| edgeR | TMM normalization 사용 |
9. 단백체 데이터 분석
-
단백체 데이터도 샘플 간 비교를 위해 normalization이 필요함
-
MS-proteomics 데이터에서는 기술적 변동을 줄이고, 실제 생물학적 차이가 잘 드러나게 만드는 것이 중요함
-
대표적인 정규화 방법
| 방법 | 설명 |
|---|---|
| Median/mean normalization | 샘플별 median 또는 mean intensity를 맞춤 |
| Quantile normalization | 모든 샘플의 intensity 분포를 같게 맞춤 |
| Z-score normalization | 평균 0, 표준편차 1로 변환 |
| VSN | intensity 수준에 따른 분산 차이를 안정화 |
-
단백체 차등분석에서는 t-test, Wilcoxon rank-sum test, limma 같은 방법이 사용됨
-
limma는 작은 샘플 수에서도 안정적으로 분석할 수 있도록 empirical Bayes 방법을 사용한다는 점이 특징임
10. Gene set analysis
-
유전자 하나하나만 보는 것보다 여러 유전자가 모인 pathway나 biological process 단위로 보는 것이 더 해석하기 쉬울 때가 많음
-
Gene set analysis는 미리 정의된 유전자 집합이 특정 조건에서 유의미하게 변화하는지 확인하는 분석임
-
대표적인 gene set database는 다음과 같음
| 데이터베이스 | 설명 |
|---|---|
| MSigDB Hallmark | 잘 정의된 생물학적 상태나 과정 50개 |
| KEGG | 분자 상호작용과 pathway map |
| Reactome | curated, peer-reviewed pathway database |
| Gene Ontology | gene function 정보, BP/CC/MF로 구분 |
- GO는 세가지로 나뉨
| GO 분류 | 의미 |
|---|---|
| BP | Biological Process |
| CC | Cellular Component |
| MF | Molecular Function |
11. ORA와 GSEA
-
Gene set analysis에는 대표적으로 ORA와 GSEA가 있음
-
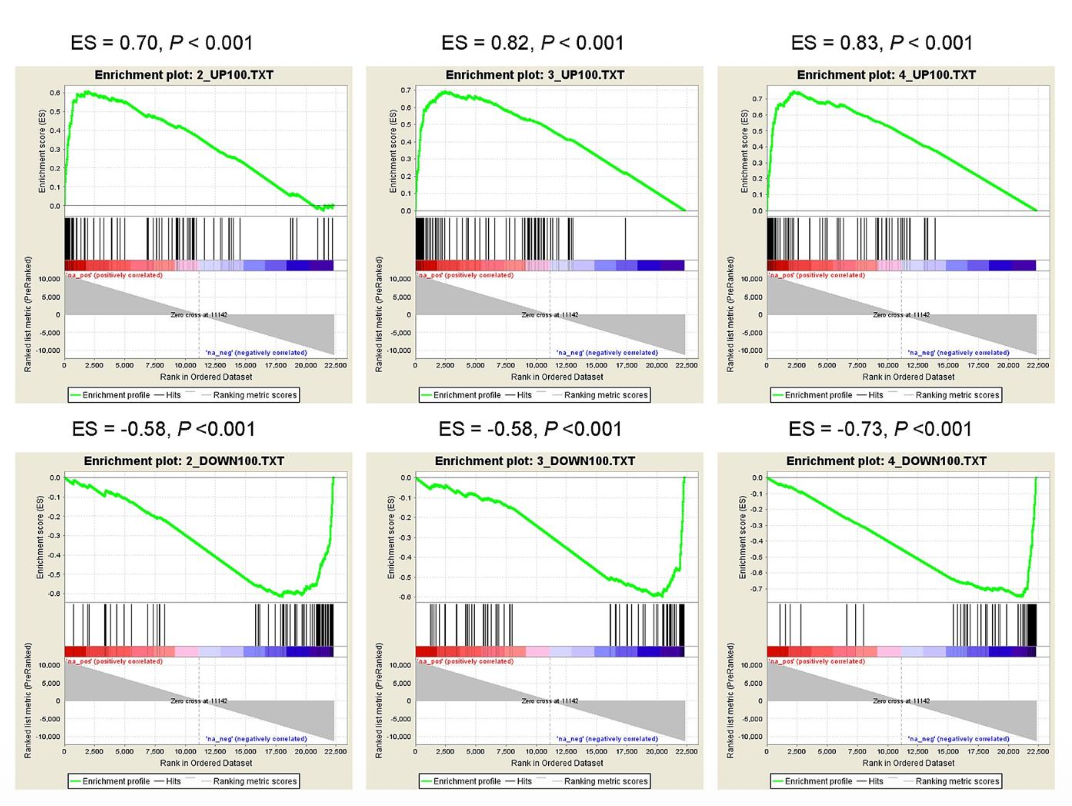
ORA는 유의미하게 변한 유전자 리스트를 먼저 정하고 그 리스트 안에 특정 gene set이 과하게 많이 포함되어 있는지 보는 방식임
-
GSEA는 유전자를 통계량 기준으로 정렬한 뒤 특정 gene set의 유전자들이 위쪽이나 아래쪽에 몰려 있는지 확인하는 방식임
12. Clustering analysis
-
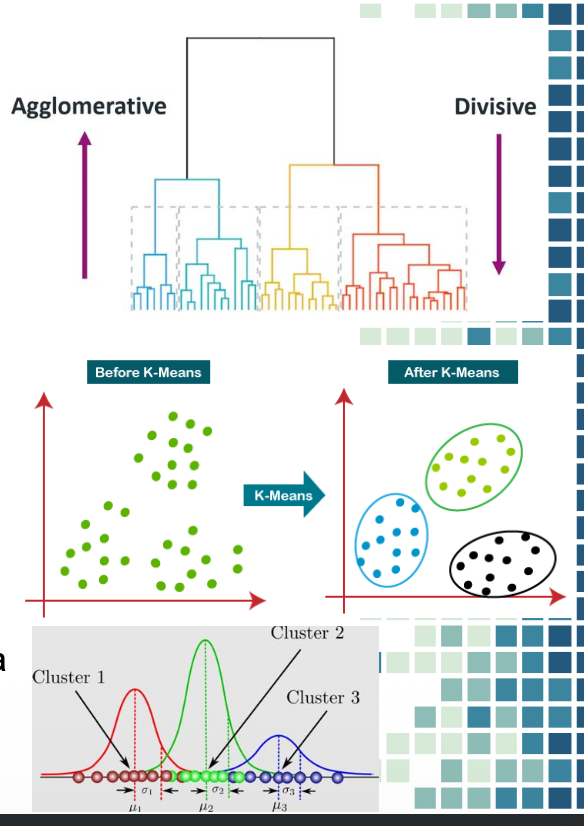
Clustering은 비슷한 특성을 가진 샘플이나 유전자를 묶는 분석임
-
오믹스 데이터에서는 비슷한 발현 패턴을 가진 유전자끼리 묶거나 비슷한 분자적 특성을 가진 환자 샘플끼리 묶을 때 사용함
대표적인 방법은 다음과 같음
| 방법 | 설명 |
|---|---|
| Hierarchical clustering | dendrogram 형태로 계층적 군집 형성 |
| K-means clustering | K개의 cluster 중심을 기준으로 군집화 |
| Gaussian mixture model | 여러 Gaussian distribution의 혼합으로 데이터 설명 |
13. Dimensional reduction
-
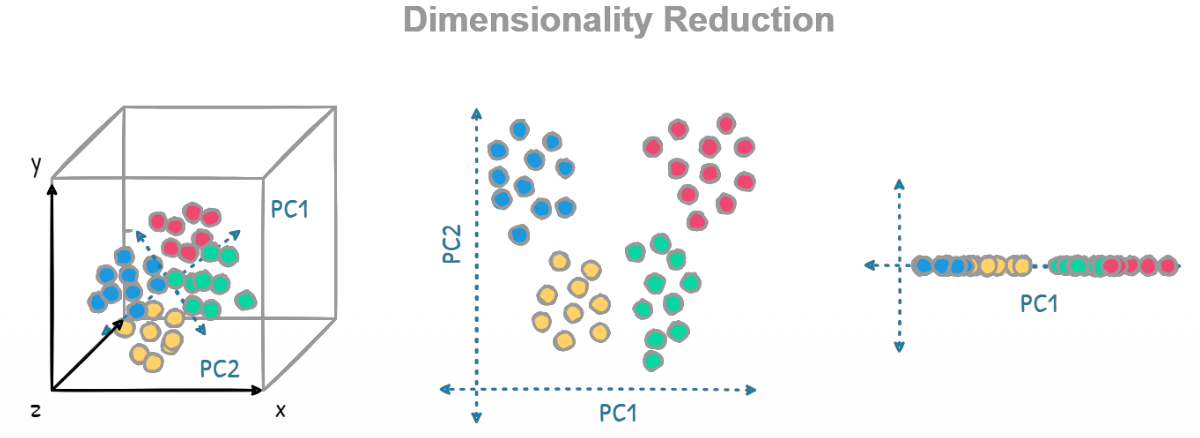
오믹스 데이터는 보통 feature 수가 매우 많음
-
예를 들어 유전자는 수천 개 이상인데 샘플 수는 상대적으로 적은 경우가 많은데 이런 데이터를 그대로 시각화하거나 해석하기 어렵기 때문에 차원축소를 사용함
-
대표적인 방법은 다음과 같음
| 방법 | 특징 |
|---|---|
| PCA | 선형 차원축소, 분산을 가장 잘 설명하는 축을 찾음 |
| UMAP | 비선형 차원축소, local/global structure를 모두 고려 |
| t-SNE | 비선형 차원축소, local structure 보존에 강함 |
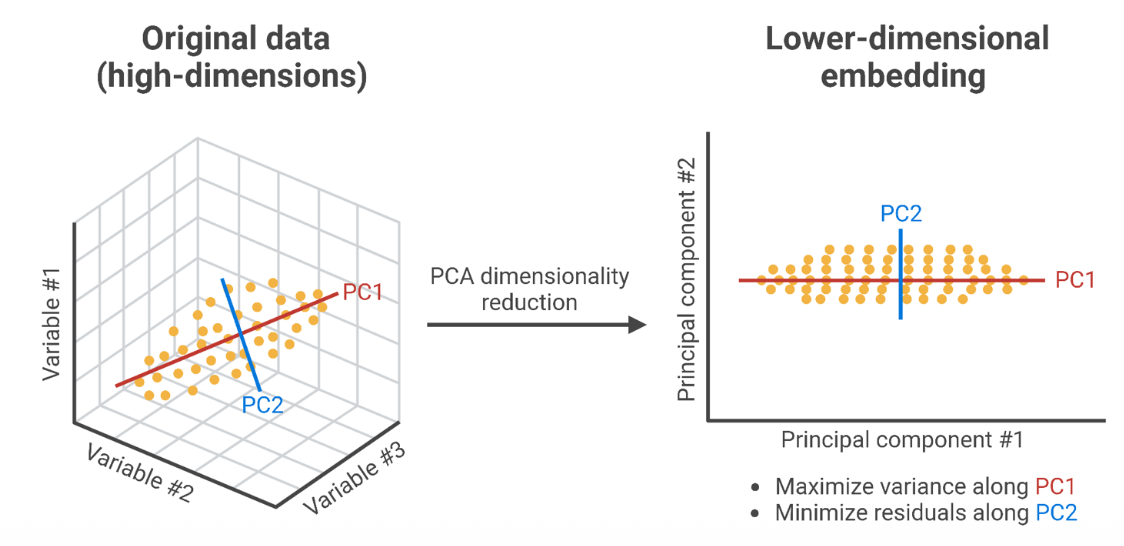
- PCA는 전체적인 분산 구조를 보는 데 좋고 UMAP과 t-SNE는 복잡한 비선형 구조를 2차원으로 시각화할 때 많이 사용됨
14. 전체 요약
-
이번 강의는 오믹스 데이터의 downstream analysis를 다룬 내용임
-
유전체 데이터에서는 변이를 해석하고 질병과 관련된 driver gene을 찾고 유전자 변이 간 관계를 분석함
-
전사체와 단백체 데이터에서는 normalization을 통해 샘플 간 비교가 가능하도록 만들고 differential expression analysis로 조건 간 차이를 찾음
-
그 다음 gene set analysis를 통해 pathway 수준에서 해석하고 clustering과 dimensional reduction을 통해 샘플이나 유전자의 패턴을 파악함
오믹스 분석은 단순히 데이터를 만드는 것에서 끝나는 게 아니라 변이·발현·단백질 변화가 생물학적으로 어떤 의미를 가지는지 해석하는 과정임