한국어 정서지지 챗봇 다온(Daon) 을 만들면서 겪은 과정을 기록하는 시리즈다.
이번 편에서는 데이터 전처리부터 KoBERT 감정 분류기 학습까지 다룬다.
학습·포트폴리오용 프로토타입이며, 전문 상담을 대체하지 않는다.
1. 다온은 어떤 프로젝트인가
| 항목 | 내용 |
|---|---|
| 유형 | 대화형 정서지지 챗봇 |
| 엔진 | 하이브리드 (직접 학습한 감정 분류기 + LLM API) |
| 핵심 가치 | Safety-First: 위기 탐지 게이트 |
| 스택 | Python, pandas, PyTorch, HuggingFace Transformers, Colab(GPU), Gemini API |
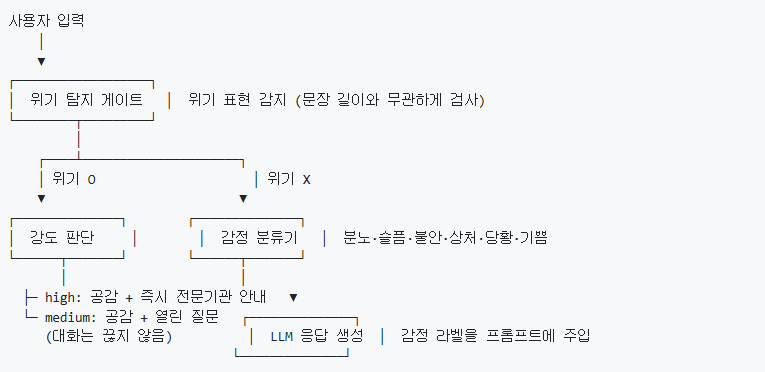
LLM에 사용자 말을 그대로 던지는 챗봇이 아니라, 세 단계를 거치도록 설계했다.
사용자 입력
↓
[위기 탐지 게이트] ── 위기 O → 공감 + 전문기관 안내 (대화는 끊지 않음)
↓ 위기 X
[KoBERT 감정 분류] → 6개 감정 중 하나
↓
[LLM(Gemini)] → 감정 정보를 주입한 프롬프트로 공감 응답 생성
핵심은 "판단은 내가 만든 부품이, 말은 LLM이" 하는 구조다.
이번 편은 이 중 가운데, 감정 분류기를 만드는 과정이다.
2. 데이터 준비: 5만 건의 중첩 JSON을 2열 표로
데이터 확보
AI Hub의 감성대화 말뭉치를 사용했다. 발화마다 감정이 라벨링되어 있고, 60개 세부 감정이 6개 대분류로 묶여 있다.
처음엔 엑셀 파일일 거라 생각했는데 받아 보니 JSON이었다. 첫 교훈: 가정은 반드시 확인하자.
import pandas as pd

df = pd.read_json("data/감성대화말뭉치(최종데이터)_Training.json")
print(df.shape)    # (51628, 2)
print(df.columns)  # ['profile', 'talk']
필요한 값은 깊숙이 중첩되어 있었다.
- 감정 코드:
profile → emotion → type(예:E18) - 사람 발화:
talk → content → HS01
설계 결정: 60개가 아닌 6개 감정
감정 코드의 앞자리로 대분류가 정해진다.
| 코드 | E1x | E2x | E3x | E4x | E5x | E6x |
|---|---|---|---|---|---|---|
| 감정 | 분노 | 슬픔 | 불안 | 상처 | 당황 | 기쁨 |
세부 60개 대신 대분류 6개만 쓰기로 했다. 학습이 쉽고, 챗봇이 사용자 상태를 파악하는 데는 6개로 충분하다고 판단했다.
전처리 코드
def code_to_emotion(emotion_code: str) -> str:
    code_num = emotion_code[1]          # "E18" → "1" (문자!)
    mapping = {"1": "분노", "2": "슬픔", "3": "불안",
               "4": "상처", "5": "당황", "6": "기쁨"}
    return mapping.get(code_num, "알 수 없음")

sentences, emotions = [], []
for i in range(len(df)):
    sentences.append(df.loc[i, "talk"]["content"]["HS01"])
    emotions.append(code_to_emotion(df.loc[i, "profile"]["emotion"]["type"]))

result = pd.DataFrame({"sentence": sentences, "emotion": emotions})
🐛 첫 번째 버그: 문자 "1"과 숫자 1
처음엔 code_num == 1로 비교했다가 모든 데이터가 else로 빠졌다.
"E18"[1]로 꺼낸 값은 문자열 "1"이지 숫자가 아니다. type()으로 찍어 보고 나서야 알았다.
코드는 맞는 것 같은데 결과가 이상하면, 타입부터 의심하자.
결과 검증
print(result["emotion"].value_counts())합계 51,628건, "알 수 없음" 0건. 다만 기쁨이 다른 감정보다 약 3천 건 적은 불균형이 보였다. 이게 나중에 성능 한계의 원인 중 하나가 된다.
3. KoBERT 파인튜닝
개념 한 줄 정리
- KoBERT: 한국어를 이미 잘 아는 사전학습 모델 (국어 잘하는 전학생)
- 파인튜닝: 그 전학생에게 "감정 구분법"만 추가로 가르치는 것
KoBERT에는 한국어를 이해하는 "몸통"만 있고 감정을 고르는 "머리"는 없다.
num_labels=6으로 머리를 새로 달고, 그 머리를 내 데이터로 훈련시키는 것이 파인튜닝이다.
파이프라인
from sklearn.model_selection import train_test_split
from transformers import AutoTokenizer, AutoModelForSequenceClassification

# 1. 라벨 인코딩 (감정 → 숫자)
label_map = {"분노": 0, "슬픔": 1, "불안": 2, "상처": 3, "당황": 4, "기쁨": 5}
result["label"] = result["emotion"].map(label_map)

# 2. 학습/검증 분리 (8:2, 감정 비율 유지)
X_train, X_test, y_train, y_test = train_test_split(
    result["sentence"].tolist(), result["label"].tolist(),
    test_size=0.2, random_state=42, stratify=result["label"])

# 3. 토큰화 (문장 → 숫자)
tokenizer = AutoTokenizer.from_pretrained("monologg/kobert", trust_remote_code=True)
train_enc = tokenizer(X_train, truncation=True, padding=True,
                      max_length=64, return_tensors="pt")

# 4. 모델 불러오기 (6갈래 분류 머리 부착)
model = AutoModelForSequenceClassification.from_pretrained(
"monologg/kobert", num_labels=6, trust_remote_code=True)- 학습용 41,302건 / 검증용 10,326건
stratify로 두 세트 모두 6개 감정 비율을 똑같이 맞췄다- Colab 무료 GPU(T4)에서 학습
🔥 과적합을 직접 목격하다
3에폭으로 학습한 결과다.
| Epoch | Training Loss | Validation Loss |
|---|---|---|
| 1 | 1.022 | 1.207 ← 가장 균형 좋음 |
| 2 | 0.785 | 1.319 ⚠️ |
| 3 | 0.560 | 1.451 ⚠️ |
Training Loss는 계속 내려가는데 Validation Loss는 오히려 올라간다.
모델이 문제집을 외우기 시작해서, 처음 보는 문장은 더 못 맞히게 된 상태, 즉 과적합이다.
개선: 진단 → 조치 → 검증
에폭을 2로 줄여 다시 학습했다. 이때 함정이 하나 있었다.
⚠️ 모델을
from_pretrained로 새로 불러오지 않고 다시train()하면,
이미 3에폭 학습된 모델에 2에폭이 누적되어 과적합이 더 심해진다.
| 구분 | 3에폭 | 2에폭 |
|---|---|---|
| Validation Loss | 1.451 | 1.135 |
| 정확도 | 56.54% | 57.40% |
랜덤으로 찍으면 16.7%(1/6)이니 약 3.4배 수준이다.
개선 폭이 크지 않다는 건 과적합만이 원인은 아니었다는 뜻이다. 남은 원인으로 보는 것들은 다음과 같다.
- 슬픔 ↔ 상처처럼 경계가 모호한 감정 쌍
- 기쁨 클래스의 데이터 불균형
- 학습률·배치 크기 등 하이퍼파라미터 미튜닝
지금은 "전체 파이프라인 완성"이 우선이라 57%로 확정하고, 성능 최적화는 뒤 단계로 미뤘다.
4. 이번 편에서 배운 것
- 원본 데이터는 항상 지저분하다. 모델링보다 전처리에 더 많은 시간을 썼고, 그게 정상이다.
- 숫자 하나 올리는 것보다 원인을 아는 게 중요하다. 0.86%p 개선보다, 과적합을 진단하고 고치고 검증한 사이클 자체가 더 큰 수확이었다.
- 실험은 조건을 통제해야 한다. 모델을 새로 불러오지 않으면 비교 자체가 무의미해진다.
다음 편 예고
정확도 57%짜리 모델에 사람의 안전을 맡길 수는 없다.
다음 편에서는 감정 분류보다 먼저, 별도로 동작하는 위기 탐지 게이트를 어떻게 설계했는지, 그리고 테스트 중 실제로 터진 미탐 버그를 다룬다.