일반적으로 10000건 이상의 데이터부터는,
데이터를 검색할 때 인덱스를 사용하는 것이 효율적입니다.
그러나 to_char함수를 사용할 경우,
이 인덱스를 사용하지 못하게되어 데이터 양이 많으면 많을수록 검색에만 오랜 시간이 걸리게됩니다.
테스트를 한번 해보겠습니다.
제가 임의로 만든 EMP 테이블의 'HIREDATE' 컬럼에 인덱스를 생성해주겠습니다.
CREATE INDEX emp_idx ON EMP USING btree(HIREDATE);제 EMP 테이블의 데이터 수는 10000건 미만이기 때문에,
index scan이 상대적으로 느려 시스템 내에서 sequence scan을 자동으로 선택하게 됩니다.
따라서, sequence scan을 임의로 꺼주겠습니다.
SET enable_seqscan = OFF;이제 explain analyse를 사용하여 한번 테스트 쿼리 결과를 살펴보겠습니다.
첫 번째로 to_char를 사용하지 않은 쿼리입니다.
explain analyse
SELECT *
FROM EMP
WHERE HIREDATE > TO_DATE('19820101', 'YYYYMMDD');
인덱싱 대상인 'HIREDATE'는 그대로 두고 비교값만 변형해서 비교해주었습니다.
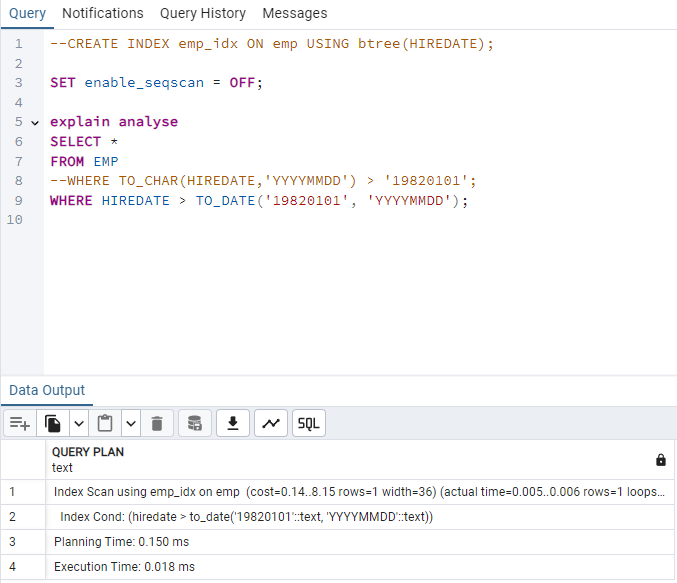
index scan이 수행된 것을 확인할 수 있습니다.
두 번째는 to_char를 사용한 쿼리입니다.
explain analyse
SELECT *
FROM EMP
WHERE TO_CHAR(HIREDATE,'YYYYMMDD') > '19820101';
인덱싱 대상인 'HIREDATE'에 to_char함수로 변형을 해주어 비교했습니다.
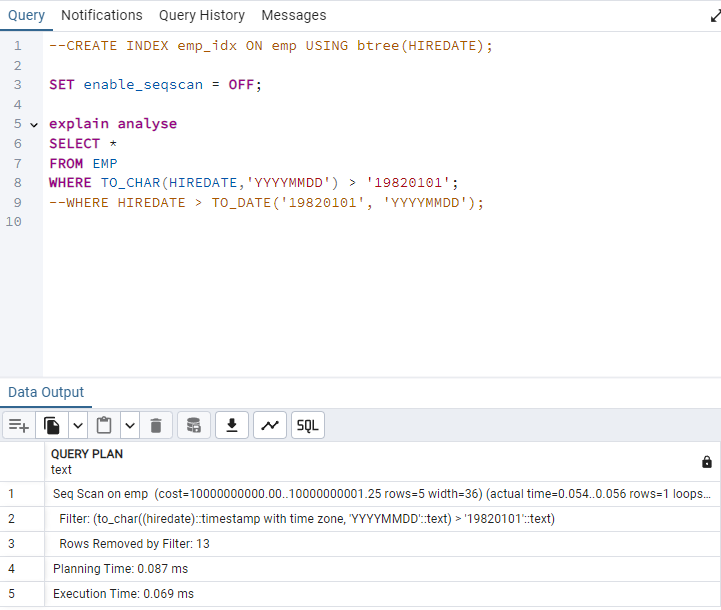
분명 seq scan을 OFF 했음에도 index scan이 불가능하여 seq scan이 수행된 것을 확인할 수 있습니다.
세번째는 to_char 대신 ::date를 사용한 쿼리입니다.
explain analyse
SELECT *
FROM EMP
WHERE HIREDATE::date > '19820101';
인덱싱 대상인 'HIREDATE'를 ::date를 통해 변형을 해주어 비교해주었지만,
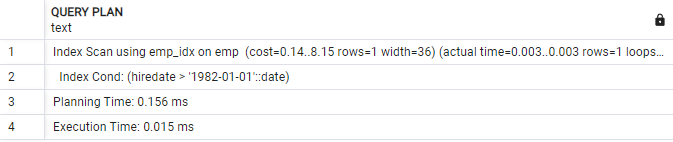
to_char와는 달리 index scan이 이루어졌습니다.
그렇지만 이 또한 권장하지 않는 방법이라고 합니다.
그외 테스트
WHERE date_trunc('day',HIREDATE) > '19820101';
-> Seq Scan

WHERE date_part('month',HIREDATE) > '1';
-> Seq Scan
결론
인덱스 컬럼의 값을 to_char 함수와 같이 변형해서 비교하게 되면 대부분의 경우 인덱스를 이용할 수 없다는 것을 확인했습니다.
따라서, 변형이 필요하다면 가능한 인덱스 컬럼 데이터의 비교값을 변형해주는 것이 좋습니다.
참고
https://stackoverflow.com/questions/36414624/does-to-char-use-more-cpu-than-between-in-postgresql