AI가 읽기 좋은 코드 구조는 무엇일까?
생성형 AI와 함께 개발하는 시대가 되면서 개발 방식은 빠르게 바뀌고 있다.
하지만 AI가 코드를 생성한다고 해서 기존 소프트웨어 공학의 문제가 사라진 것은 아니다.
오히려 과거에 사람을 중심으로 발생했던 코드 오너십과 커뮤니케이션 비용의 문제가 AI와 멀티 에이전트 환경에서 다시 등장하고 있다.
그리고 이 문제를 이해하는 데 도움이 되는 개념이 DDD의 Bounded Context, 즉 바운디드 컨텍스트다.
1. 바운디드 컨텍스트란 무엇인가
DDD에서 자주 등장하는 개념 중 하나가 Ubiquitous Language, 즉 유비쿼터스 랭귀지다.
쉽게 말하면 특정 업무 영역에서 사람들이 동일한 의미로 사용하는 언어다.
예를 들어 냉장고라는 단어를 생각해보자.
인테리어 업체에서 냉장고는 다음과 같은 의미가 중요하다.
- 가로
- 세로
- 높이
- 설치 공간
- 문이 열리는 방향
반면 전기 설비 담당자에게 냉장고는 전혀 다른 정보가 중요하다.
- 소비전력
- 전압
- 콘센트 위치
- 전기 용량
같은 냉장고라는 단어를 사용하지만 각 업무 영역에서 중요하게 바라보는 모델과 속성이 다르다.
즉,
같은 단어라도 컨텍스트에 따라 의미와 모델이 달라질 수 있다.
DDD에서는 이렇게 하나의 도메인 모델과 언어가 일관된 의미를 유지할 수 있는 경계를 Bounded Context라고 한다.
바운디드 컨텍스트 밖으로 나가면 같은 단어가 다른 의미를 가질 수도 있다.
그래서 서로 다른 컨텍스트 사이에서는 모델을 억지로 하나로 통합하기보다 명확한 인터페이스를 통해 연결하는 것이 좋다.
2. 바운디드 컨텍스트와 코드 오너십
실제 조직에서는 바운디드 컨텍스트가 팀 경계와 맞물리는 경우가 많다.
예를 들어 하나의 전자상거래 시스템이라도 다음과 같이 나뉠 수 있다.
회원
 ├─ 가입
 ├─ 인증
 └─ 프로필

주문
 ├─ 주문 생성
 ├─ 주문 상태
 └─ 주문 취소

결제
 ├─ 결제 승인
 ├─ 결제 취소
 └─ 정산
회원팀은 회원 모델을 가장 잘 알고 있고, 주문팀은 주문 모델을 가장 잘 알고 있다.
결국 자연스럽게 코드에도 오너십이 생긴다.
Membership Team
        ↓
membership domain

Order Team
        ↓
order domain

Payment Team
        ↓
payment domain
코드 오너십이라는 것은 단순히
"이 파일은 누가 만들었는가?"
를 의미하지 않는다.
더 중요한 것은
"이 코드가 왜 이렇게 동작하는지 설명할 수 있는 사람이 누구인가?"
이다.
예를 들어 어떤 개발자에게 물어보면 이런 대답이 나올 수 있다.
"그 로직은 일반 기간에는 동작하는데 프로모션 기간에는 다른 제휴 시스템과 연동되기 때문에 처리 방식이 달라집니다."
코드만 읽어서는 알기 어려운 업무 지식이 사람 머릿속에 들어 있는 것이다.
즉 과거의 개발 조직에서 사람은 일종의 도메인 지식 저장소 역할을 했다.
3. 코드가 커지면 사람이 늘어난다
문제는 시스템이 커질수록 한 사람이 이해할 수 있는 코드의 양에는 한계가 있다는 것이다.
예를 들어 처음에는 개발자 한 명이 시스템 전체를 이해할 수 있었다고 하자.
Developer
   ↓
전체 시스템
시스템이 커지면 더 이상 한 사람이 모든 코드를 이해할 수 없다.
결국 코드 오너를 늘린다.
Developer A → Membership
Developer B → Order
Developer C → Payment
Developer D → Settlement
Developer E → Notification
그런데 여기서 새로운 문제가 생긴다.
커뮤니케이션 비용이다.
두 사람이 있을 때 필요한 관계는 하나다.
A ↔ B세 명이 되면 관계가 늘어난다.
A ↔ B
A ↔ C
B ↔ C
사람이 많아질수록 가능한 커뮤니케이션 경로는 빠르게 증가한다.
수학적으로 가능한 1:1 관계의 수는
n(n-1) / 2이다.
10명이면 45개다.
20명이면 190개다.
100명이면 4,950개다.
물론 실제 조직에서 모든 사람이 모든 사람과 매번 대화하지는 않는다.
그래서 소프트웨어 공학과 조직 설계에서는 이 커뮤니케이션 비용을 줄이기 위한 수많은 방법이 등장했다.
- 모듈화
- API 계약
- 코딩 컨벤션
- 디자인 패턴
- 아키텍처 원칙
- 인터페이스
- 문서화
- 코드 리뷰
- 팀별 오너십
- Bounded Context
결국 좋은 소프트웨어 설계의 중요한 목적 중 하나는
모든 사람이 모든 사람과 계속 대화하지 않아도 시스템을 변경할 수 있도록 만드는 것
이라고 볼 수 있다.
4. 그런데 AI가 등장했다
처음 생성형 AI가 등장했을 때 이런 기대가 있었다.
"AI가 전체 코드를 이해하면 코드 오너십 문제가 없어지는 것 아닌가?"
하지만 실제로는 그렇지 않다.
AI에도 사람이 가진 것과 비슷한 제약이 존재한다.
바로 컨텍스트의 한계다.
아무리 컨텍스트 윈도우가 커져도 거대한 코드베이스 전체를 항상 넣어놓고 개발하는 것은 비효율적이다.
예를 들어 프로젝트에 코드가 수백만 줄 있다고 하자.
하나의 기능을 수정하기 위해 전체 프로젝트를 모두 읽히는 것은 낭비다.
실제로 필요한 것은 일부일 가능성이 높다.
전체 코드베이스

████████████████████████████████

실제 수정에 필요한 코드

        ████
AI 입장에서 중요한 것은
전체 코드를 얼마나 많이 읽었느냐가 아니라 필요한 코드를 얼마나 정확하게 가져왔느냐
다.
5. AI 시대에도 코드 오너십은 사라지지 않는다
AI가 코드를 이해한다고 해서 코드 오너십 개념이 없어지는 것은 아니다.
다만 오너십의 형태가 바뀐다.
과거에는
사람
 ↓
담당 코드
였다면 AI 시대에는
AI Session
   ↓
현재 컨텍스트에 로딩된 코드
가 된다.
즉 AI는 현재 세션에 들어온 코드만 사실상 소유하고 있다.
그래서 AI에게 다음과 같이 요청했다고 해보자.
회원 탈퇴 기능에 7일 유예 기간을 추가해줘.
AI가 문제를 해결하려면 필요한 코드를 찾기 시작한다.
MembershipController
        ↓
MembershipService
        ↓
Member
        ↓
WithdrawalPolicy
        ↓
MemberRepository
이렇게 문제 해결에 필요한 코드를 탐색해서 컨텍스트로 가져온다.
이때 컨텍스트에 로딩된 코드 집합이 사실상 이번 작업의 동적 모듈 역할을 한다.
6. 멀티 에이전트라고 문제가 해결되는 것은 아니다
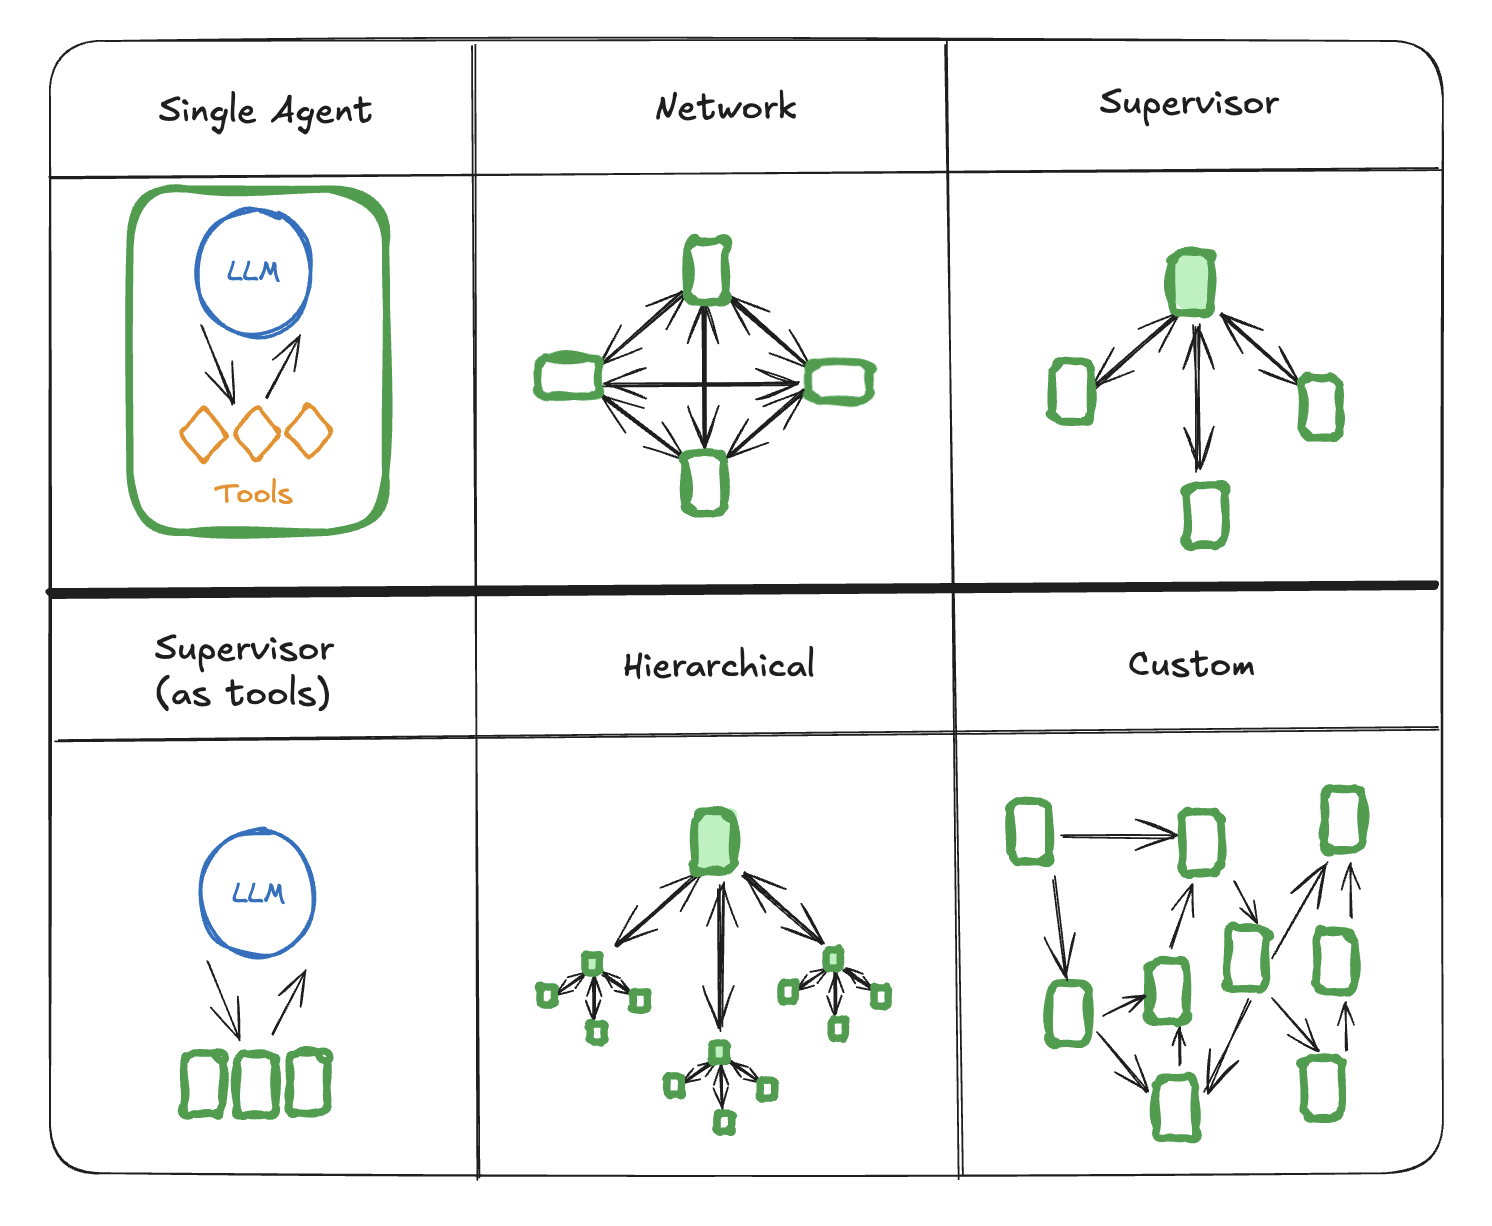
그렇다면 AI 여러 개를 동시에 사용하면 어떨까?
예를 들어
Agent A → Membership
Agent B → Order
Agent C → Payment
Agent D → Notification
처럼 역할을 나눌 수 있다.
처음에는 훨씬 좋아 보인다.
하지만 여기에서도 과거의 조직과 똑같은 문제가 다시 나타난다.
에이전트 간 커뮤니케이션 비용이다.
예를 들어 Agent A가 회원 상태를 변경했는데 Agent B가 그 사실을 모르면 주문 로직이 깨질 수 있다.
그래서 사람들이 이런 방법을 사용한다.
history.md
communication.md
status.md
handover.md
모든 에이전트가 이 파일을 읽게 하는 방식이다.
작은 프로젝트에서는 쓸 수 있다.
하지만 프로젝트가 커지면 문제가 발생한다.
history.md

10 KB
50 KB
100 KB
500 KB
1 MB
...
결국 새로운 에이전트가 작업할 때마다 엄청난 과거 기록을 읽어야 한다.
사람 조직으로 비유하면 이런 것이다.
"회사에서 지금까지 있었던 모든 회의록을 읽은 다음 오늘 업무를 시작하세요."
효율적일 리가 없다.
7. 모든 정보를 공유하는 것보다 필요한 정보를 찾게 해야 한다
AI 개발에서 더 중요한 전략은
모든 정보를 AI에게 제공한다가 아니라
필요한 정보를 AI가 찾아갈 수 있게 만든다이다.
즉 거대한 문서 하나보다 작은 문서들이 연결된 구조가 좋다.
예를 들어 다음과 같은 구조다.
README.md
   │
   ├── membership.md
   │      ├── withdrawal.md
   │      └── membership-events.md
   │
   ├── order.md
   │      ├── order-state.md
   │      └── payment-integration.md
   │
   └── payment.md
          ├── payment-policy.md
          └── refund.md
AI가 회원 탈퇴 기능을 수정한다고 하자.
처음에는 README만 읽는다.
README
   ↓
Membership
   ↓
Withdrawal
필요하면 추가로 이벤트 문서를 읽는다.
Withdrawal
   ↓
Membership Events
필요하지 않은 주문이나 결제 문서는 읽지 않는다.
이 방식이 훨씬 효율적이다.
8. 문서도 그래프 구조가 되어야 한다
AI에게 좋은 문서는 거대한 백과사전이 아니다.
좋은 문서는 탐색 가능한 구조다.
예를 들어 이런 방식이다.
Architecture
   ↓
Membership
   ↓
Withdrawal
   ↓
Domain Event
   ↓
Notification
AI는 필요한 만큼만 경로를 따라간다.
이를 그래프로 표현하면 다음과 같다.
Membership
   │
   ├── Profile
   │
   ├── Authentication
   │
   └── Withdrawal
           │
           └── MemberWithdrawnEvent
                     │
                     └── Notification
중요한 것은 모든 정보가 한 파일에 들어가는 것이 아니다.
필요한 정보를 연결을 따라가며 발견할 수 있어야 한다.
9. 코드도 같은 구조가 되어야 한다
문서만 이렇게 만들면 충분하지 않다.
코드 역시 AI가 필요한 부분만 탐색할 수 있어야 한다.
좋은 구조는 이런 형태다.
membership
 ├── controller
 ├── application
 ├── domain
 │    ├── Member
 │    └── WithdrawalPolicy
 ├── infrastructure
 └── docs
반대로 AI에게 가장 좋지 않은 구조 중 하나는 거대한 파일이다.
MemberService.java

5,000 lines
안에
가입
로그인
회원 수정
탈퇴
포인트
쿠폰
메일
SMS
결제
통계
배치
가 전부 들어 있다면?
회원 탈퇴 하나를 수정하기 위해 AI가 5,000줄 전체를 읽어야 한다.
컨텍스트 대부분이 불필요한 코드로 채워진다.
10. AI 시대의 모듈은 조금 다르게 볼 필요가 있다
기존 소프트웨어에서 모듈은 보통 물리적인 구조였다.
예를 들어
Gradle Module
Package
Library
Microservice
같은 것이다.
하지만 AI와 함께 개발할 때는 다른 관점도 중요해진다.
하나의 작업을 해결하기 위해 AI가 실제로 가져와야 하는 코드 집합
이다.
예를 들어
사용자 요청

"회원 탈퇴 시 7일 유예 기간 추가"
AI가 실제로 읽은 코드가
WithdrawalController
WithdrawalService
Member
WithdrawalPolicy
MemberRepository
라면 이 코드 집합이 이번 세션에서 하나의 작업 단위 모듈처럼 작동한다.
따라서 AI 친화적인 코드베이스는 이런 질문에 답할 수 있어야 한다.
하나의 기능을 수정하는 데 필요한 코드만 작게 모아서 이해할 수 있는가?
11. AI 친화적인 코드 구조의 핵심
결국 중요한 것은 컨텍스트 효율이다.
AI에게 좋은 코드베이스는 다음과 같은 특징을 가진다.
1. 기능의 경계가 명확하다
membership
order
payment
notification
도메인과 책임이 섞여 있지 않아야 한다.
2. 의존성 방향이 명확하다
가능하면 이런 구조가 좋다.
Controller
    ↓
Application
    ↓
Domain
    ↓
Port
의존성이 여러 방향으로 뒤엉키면 AI가 하나를 수정하기 위해 계속 다른 코드를 따라가야 한다.
3. 거대한 파일을 피한다
다음과 같은 파일은 사람에게도 AI에게도 좋지 않다.
CommonUtil.java
BaseService.java
CommonService.java
Manager.java
Helper.java
온갖 책임이 들어간 만물상 클래스는 수정 범위를 크게 만든다.
4. 진입점을 명확하게 만든다
AI가 탐색을 시작할 수 있는 위치가 있어야 한다.
예를 들어
README.md

Membership → docs/membership/README.md
Order      → docs/order/README.md
Payment    → docs/payment/README.md
같은 구조다.
5. 문서를 계층적으로 분리한다
다음 같은 문서 하나보다는
architecture.md
5000 lines
다음처럼 나누는 것이 좋다.
architecture/
 ├── overview.md
 ├── membership.md
 ├── order.md
 ├── payment.md
 └── event-flow.md
12. AI가 코드를 읽는 모습을 관찰해야 한다
AI 시대에는 새로운 리팩터링 기준이 하나 생긴다.
AI가 내 코드베이스를 탐색할 때 얼마나 많은 코드를 읽는가?
예를 들어 간단한 수정 요청 하나를 줬는데 AI가
30개 파일
15,000줄
을 읽어야 한다면 구조를 의심해볼 필요가 있다.
반대로
5개 파일
800줄
정도만 읽고 정확하게 문제를 해결한다면 기능 경계가 비교적 잘 나뉘어 있을 가능성이 크다.
따라서 앞으로는 AI를 단순 코드 생성기로만 사용하지 않고 코드 구조 진단 도구로도 사용할 수 있다.
AI가 계속 엉뚱한 파일을 따라간다면 이렇게 질문할 수 있다.
왜 이 기능을 수정하는 데 이렇게 많은 파일이 필요한가?
그리고 필요하면 구조를 바꾼다.
패키지 재구성
도메인 분리
서비스 분리
의존성 정리
문서 분리
공통 모듈 제거
이런 리팩터링을 반복하면 자연스럽게 AI 친화적인 코드베이스가 만들어진다.
13. 결국 핵심은 컨텍스트 엔지니어링이다
AI 시대의 개발에서는 프롬프트만 잘 쓰는 것이 중요한 게 아니다.
더 중요한 것은 AI가 필요한 컨텍스트를 적은 비용으로 찾아낼 수 있도록 코드와 문서를 설계하는 것이다.
즉,
Prompt Engineering
        ↓
Context Engineering
        ↓
Codebase Engineering
으로 관심 영역이 확장된다.
코드 구조 자체가 AI에게 하나의 컨텍스트 검색 시스템이 되는 것이다.
14. 바이브 코딩 시대에 다시 중요해지는 소프트웨어 공학
흥미로운 점은 여기서 새로운 기술처럼 보이는 것들이 사실 완전히 새로운 개념은 아니라는 것이다.
우리가 오래전부터 배웠던
- 낮은 결합도
- 높은 응집도
- 정보 은닉
- 모듈화
- 명확한 인터페이스
- 단방향 의존성
- 책임 분리
- Bounded Context
- API Contract
같은 원칙들이 AI 시대에 다시 중요해지고 있다.
이유는 단순하다.
사람도 모든 코드를 머릿속에 넣을 수 없었고,
AI도 모든 코드를 항상 컨텍스트에 넣을 수 없기 때문이다.
결론
AI 시대에도 코드 오너십 문제는 사라지지 않는다.
다만 오너십의 단위가 달라지고 있다.
과거에는
사람 → 담당 코드였다면 앞으로는
AI Session → 현재 문제를 해결하기 위해 로딩한 코드 집합이라는 형태가 점점 중요해질 수 있다.
그래서 AI 친화적인 코드 구조의 핵심은 거창하지 않다.
하나의 작업을 해결하는 데 필요한 코드와 문서를 최소한의 컨텍스트로 가져올 수 있게 만드는 것.
이를 위해서는 코드와 문서를 작은 책임 단위로 나누고, 의존성을 명확하게 만들며, 필요한 정보만 단계적으로 탐색할 수 있도록 만들어야 한다.
결국 바이브 코딩 시대의 좋은 코드란 단순히 AI가 코드를 잘 만들어주는 코드베이스가 아니다.
AI가 필요한 코드를 빠르게 찾고, 최소한만 읽고, 다른 영역을 깨뜨리지 않은 채 수정할 수 있는 코드베이스다.
그리고 역설적으로 그 방향은 우리가 오랫동안 좋은 소프트웨어 설계라고 불러왔던 원칙과 상당히 닮아 있다.
높은 응집도, 낮은 결합도, 명확한 경계.
AI가 등장했지만 좋은 설계의 기본은 사라지지 않았다.
오히려 AI 때문에 그 이유가 더 명확해지고 있다.