밑바닥부터 시작하는 딥러닝 깃허브: https://github.com/WegraLee/deep-learning-from-scratch
오차 역전파법: 수치 미분으로 구하면 오래걸리는 매개변수의 기울기를 효율적으로 계산한다.
계산 그래프
계산 과정을 그래프로 나타낸 것. 시각적으로 이해하기 좋다.
계산 그래프로 풀기
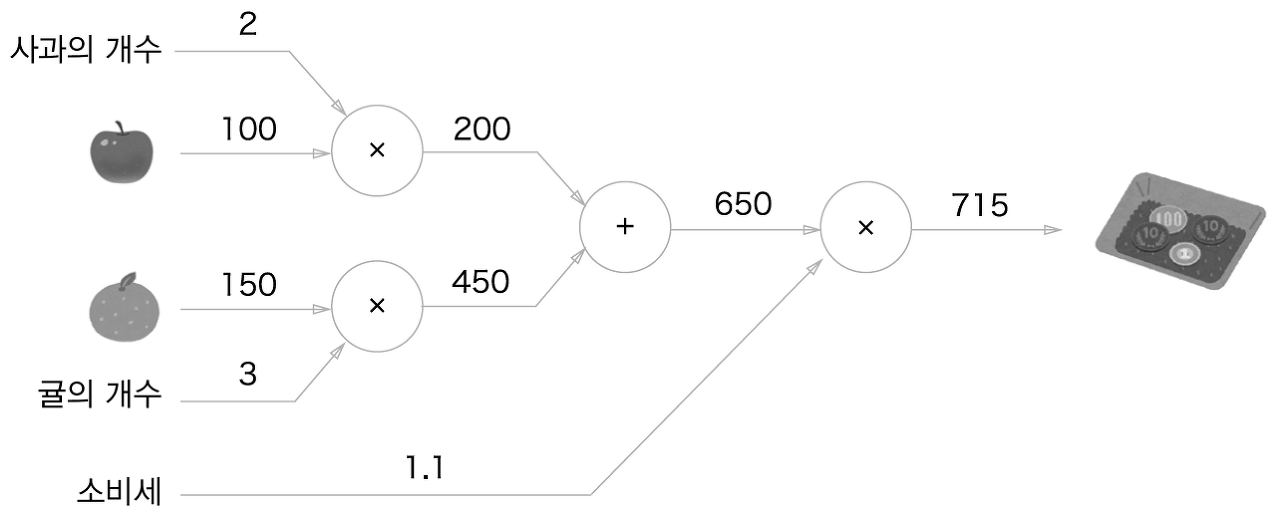
계산 그래프를 이용한 문제풀이 흐름
- 계산 그래프를 구성한다.
- 그래프에서 계산을 왼쪽에서 오른쪽으로 진행한다.(순전파(forward propagation))
순전파: 계산을 왼쪽에서 오른쪽으로 진행
역전파: 계산을 오른쪽에서 왼쪽으로 진행
국소적 계산
자신과 직접 관계된 작은 범위에서 계산을 실행함
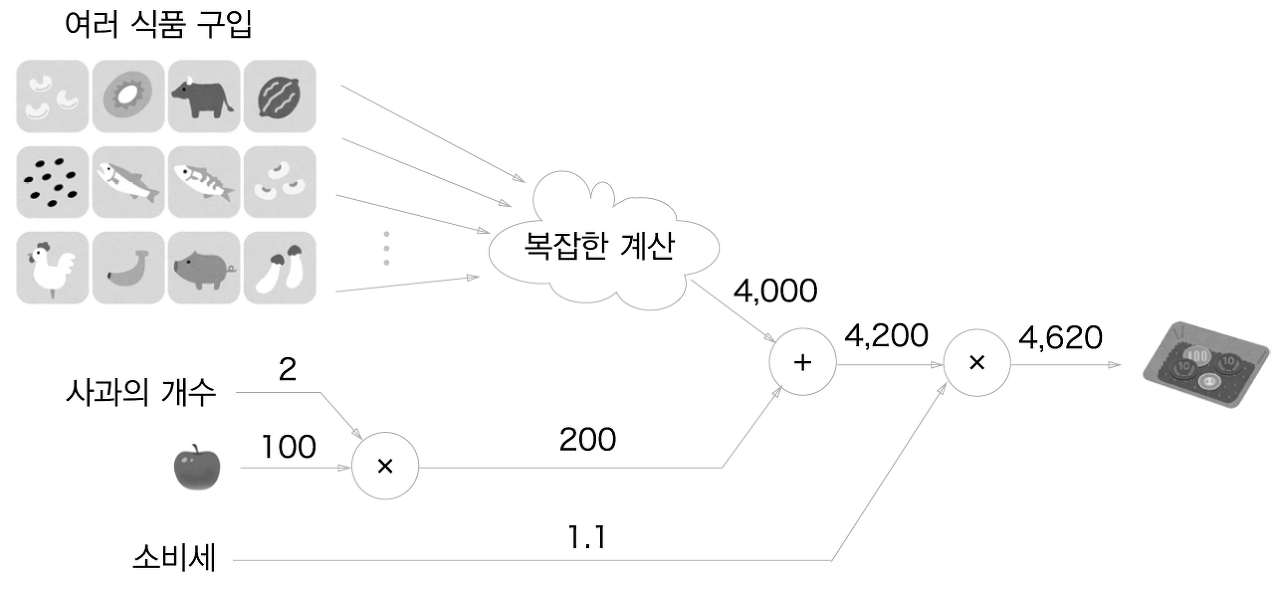
계산 그래프를 쓰는 이유
- 국소적 계산을 하여 문제를 단순화할 수 있다.
- 중간 계산 결과를 모두 보관할 수 있다.
- 역전파를 통해 '미분'을 효율적으로 계산할 수 있다.
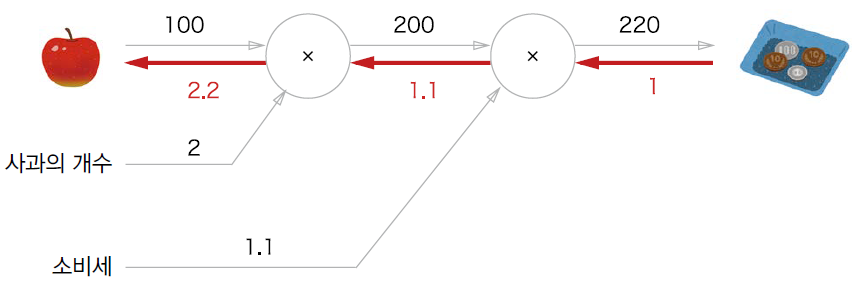
위 그림의 사과쪽 역전파 화살표에 표시된 2.2는 사과가 1원 오르면 최종 금액은 2.2원 오른다는 뜻이다.
- 위 그림을 보면 중간까지 구한 미분 결과를 공유할 수 있어서 다수의 미분을 효율적으로 계산할 수 있다.
연쇄법칙
위에서 보았던 국소적 미분을 전달하는 원리는 연쇄법칙(chain rule)에 따른 것이다.
계산 그래프의 역전파
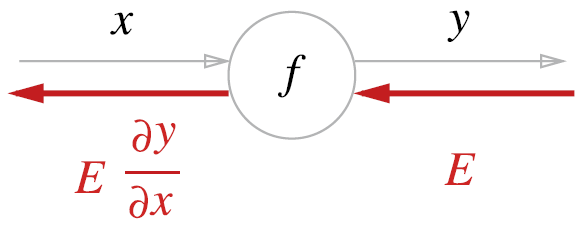
- 의 역전파
- 신호 에 국소적 미분를 곱한 후 다음 노드로 전달한다.
연쇄법칙?
여러 함수로 구성된 함수인 합성 함수를 미분하면 합성 함수를 구성하는 각 함수의 미분의 곱으로 나타낼 수 있다. 이 성질이 연쇄법칙이다.
연쇄법칙과 계산 그래프
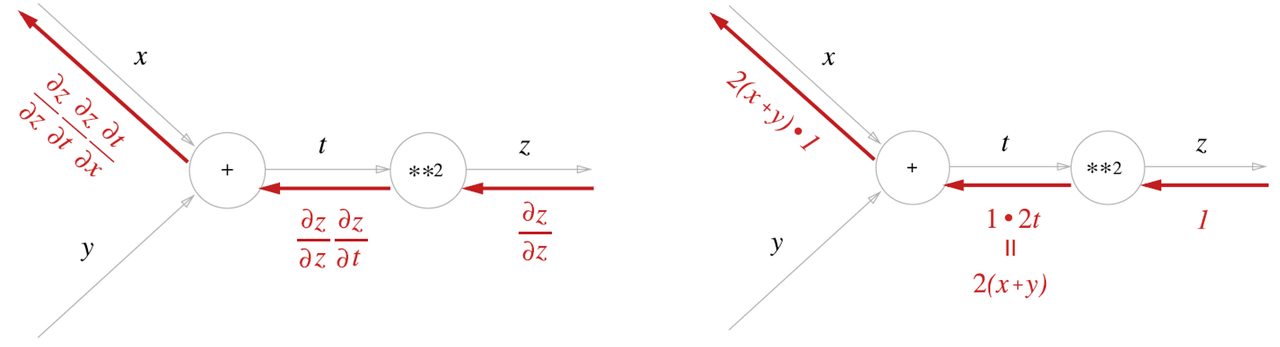
역전파
덧셈 노드 역전파
식 의 미분
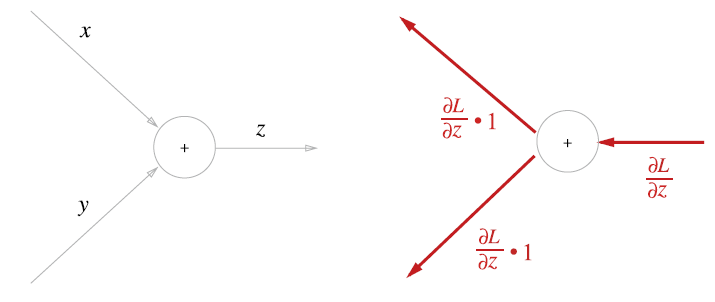
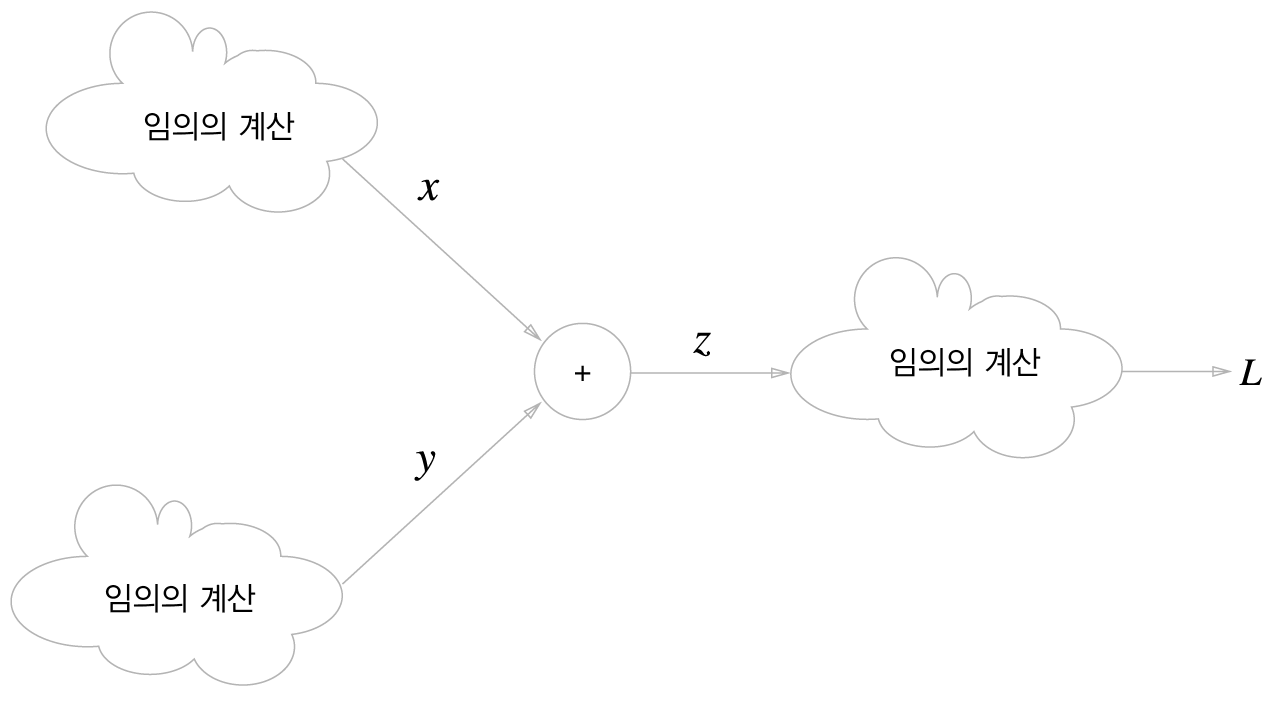
입력 값을 그대로 흘려보낸다. 상류층의 미분 값이 인 이유는 최종적으로 이라는 값을 출력하는 큰 계산 그래프를 가정하기 때문이다.
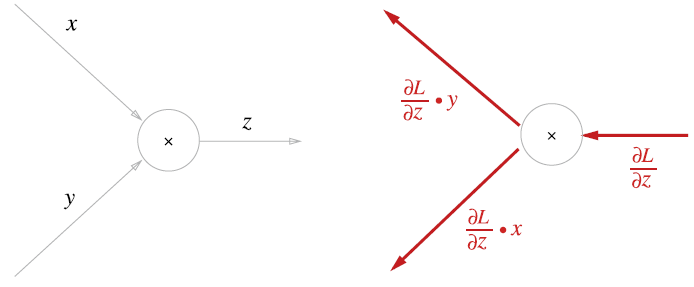
곱셈 노드 역전파
식 의 미분
단순한 계층 구현
곱셈 계층
class MulLayer:
	def __init__(self):
        self.x = None
        self.y = None

    def forward(self, x, y):
    	self.x = x
        self.y = y
        out = x * y
        return out

    def backward(self, dout):
    	dx = dout * self.y
        dy = dout * self.x
        return dx, dy
덧셈 계층
class AddLayer:
	def __init__(self):
        pass

    def forward(self, x, y):
    	return x + y

    def backward(self, dout):
    	dx = dout * 1
        dy = dout * 1
        return dx, dy
활성화 함수 계층 구현
ReLU 계층
- ReLU 계산식
- 미분식
- 계산 그래프
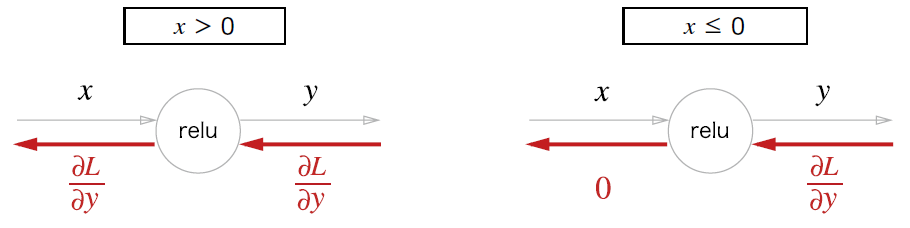
class Relu:
	def __init__(self):
        self.mask = None

    def forward(self, x, y):
    	self.mask = (x  <= 0)
        out = x.copu()
        out[self.mask] = 0
    	return out

    def backward(self, dout):
   		dout[self.mask] = 0
        dx = dout
        return dx
Sigmoid 계층
-
시그모이드 함수 식
-
미분식
-
계산 그래프
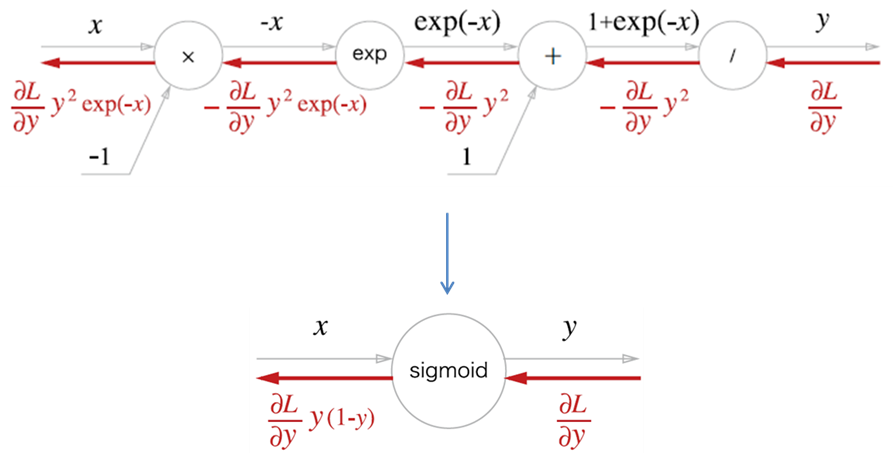
class Relu:
	def __init__(self):
        self.out = None

    def forward(self, x, y):
    	out = 1 / (1 + np.exp(-x))
        self.out = out
    	return out

    def backward(self, dout):
    	dx = dout * (1.0 - self.out) * self.out
        return dx
Affine/Softmax 계층 구현
Affine 계층
- 계산 그래프
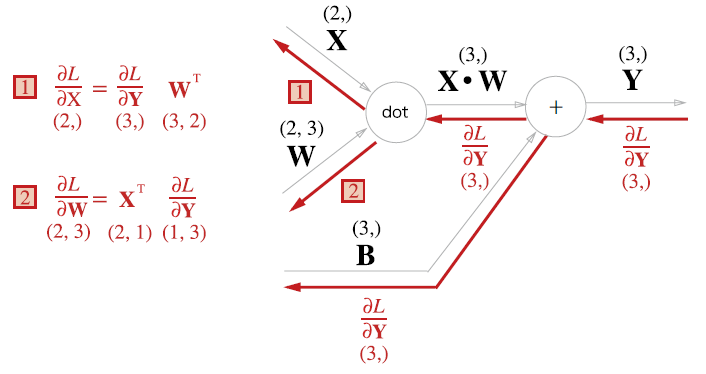
배치용 Affine 계층
- 계산 그래프
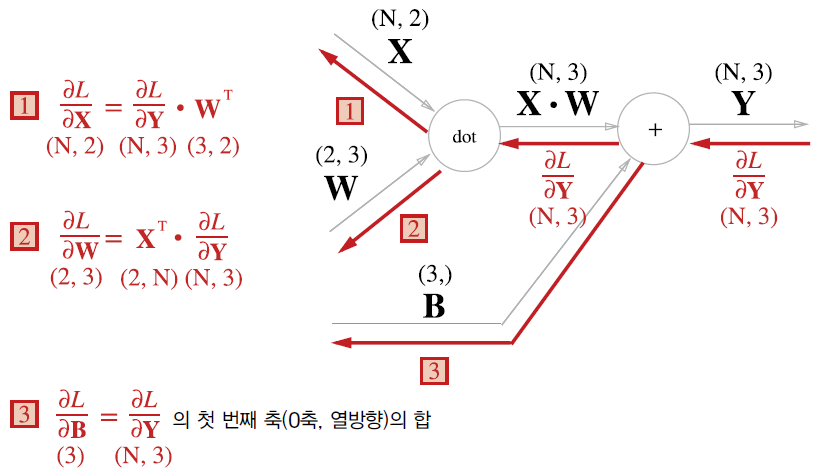
class Affine:
	def __init__(self, W, b):
    	self.W = W
        self.b = b
        self.x = None
        self.dW = None
        self.db = None

    def forward(self, x):
    	self.x = x
        out = np.dot(x, self.W) + self.b
        return out

    def backward(self, dout):
    	dx = np.dot(dout, self.W.T)
        self.dW = np.dot(self.x.T, dout)
        self.db = np.sum(dout, axis=0)
        return dx
Softmax-with-Loss 계층
- 계산 그래프
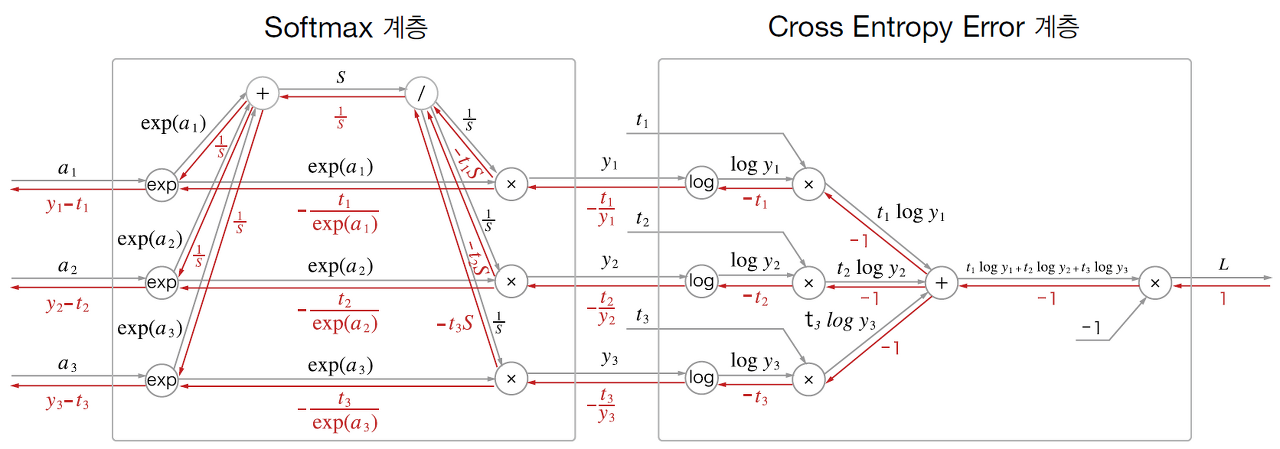
class SoftmaxWithLoss:
	def __init__(self):
    	self.loss = None
        self.y = None
        self.t = None

    def forward(self, x, t):
    	self.t = t
        self.y = softmax(x)
        self.loss = cross_entropy_error(self.y, self. t)
        return self.loss

    def backward(self, dout=1):
    	batch_size = self.t.shape[0]
        dx = (self.y - self.t) / batch_size

        return dx
오차역전파법 구현
class TwoLayerNet:
    def __init__(self, input_size, hidden_size, output_size, weight_init_std=0.01):
        # 가중치 초기화
        self.params = {}
        self.params['W1'] = weight_init_std * np.random.randn(input_size, hidden_size)
        self.params['b1'] = np.zeros(hidden_size)
        self.params['W2'] = weight_init_std * np.random.randn(hidden_size, output_size)
        self.params['b2'] = np.zeros(output_size)

        # 계층
        self.layers = OrderedDict()
        self.layers['Affine1'] = Affine(self.params['W1'], self.params['b1'])
        self.layers['Relu1'] = Relu()
        self.layers['Affine2'] = Affine(self.params['W2'], self.params['b2'])

        self.lastLayer = SoftmaxWithLoss()

    def predict(self, x):
        for layer in self.layers.values():
            x = layer.forward(x)

        return x

    def loss(self, x, t):
        y = self.predict(x)
        return self.lastLayer.forward(y, t)

    def accuracy(self, x, t):
        y = self.predict(x)
        y = np.argmax(y, axis=1)
        if t.ndim != 1 : t = np.argmax(t, axis=1)

        accuracy = np.sum(y == t) / float(x.shape[0])
        return accuracy

    def numerical_gradient(self, x, t):
        loss_W = lambda W: self.loss(x, t)

        grads = {}
        grads['W1'] = numerical_gradient(loss_W, self.params['W1'])
        grads['b1'] = numerical_gradient(loss_W, self.params['b1'])
        grads['W2'] = numerical_gradient(loss_W, self.params['W2'])
        grads['b2'] = numerical_gradient(loss_W, self.params['b2'])
        return grads

    def gradient(self, x, t):
        self.loss(x, t)

        dout = 1
        dout = self.lastLayer.backward(dout)

        layers = list(self.layers.values())
        layers.reverse()
        for layer in layers:
            dout = layer.backward(dout)

        grads = {}
        grads['W1'] = self.layers['Affine1'].dW
        grads['b1'] = self.layers['Affine1'].db
        grads['W2'] = self.layers['Affine2'].dW
        grads['b2'] = self.layers['Affine2'].db

        return grads
공부 정리