Join 은 둘 이상의 테이블을 결합하여 하나의 테이블처럼 사용하기 위한 기능으로
DB 에서 빼놓을 수 없는 핵심적인 개념 중 하나라고 할 수 있다.
그림처럼 어떤식으로 결합하냐에 따라 결합 방식이 Inner Join / Outer Join / Left Join 등등으로 나뉜다
결합 알고리즘
SQL 에서 Join 을 수행할 때 내부적으로 선택되는 알고리즘은 크게 3종류이다
- Nested Loops Join
- Hash Join
- Sort Merge Join
어떤 알고리즘을 선택할지는 데이터 크기, 결합키, 인덱스 등에 따라
내부의 옵티마이저가 전략을 결정한다
옵티마이저
SQL 쿼리문을 작성하여 실행시키면 쿼리는 옵타마이저(Optimizer) 로 전송
옵티마이저의 목적은 데이터에 어떻게 접근해 가장 효율적으로 결과를 도출할지 고민하는 것
위에 언급한 조건들을 고려해 가능한 많은 실행계획을 작성하고
각 선택지의 비용을 연산해 가장 낮은 비용을 가진 실행계획을 선택해준다.
Nested Loops Join
Nested Loops Join 는 중첩 반복을 그대로 사용하는 알고리즘.

- A 테이블과 B 테이블이 특정 key 를 기준으로 결합을 진행
- A 테이블 (구동 테이블) 의 첫번째 행에서 출발해 B 테이블 (내부 테이블) 의 모든 행을 스캔, 이때 결합 조건이 맞으면 값을 리턴
- A 테이블 첫번째 행의 스캔이 끝나면 두 번째 행으로 이동해 위의 작업 반복
자바에서의 예로 중복 for 문과 같은 메커니즘이라 생각하면 된다.
레코드 수를 각각 R(A), R(B) 라고 하면 R(A) * R(B) 만큼의 조회가 이루어지는데
해당 값을 낮출수록 성능이 개선된다는 것을 알 수 있다.
그럼 어떻게 R(A) * R(B) 값을 낮출 수 있을까?
- 구동테이블(Driving Table) 이 작을수록
- 내부 테이블(Inner Table) 의 결합 키 필드에 인덱스 설정
결론은 구동 테이블을 잘 선택하고 인덱스를 잘 거는 것이 중요하다
구동테이블
Join 이 진행될 때 먼저 다른 테이블의 결합키에 다가가 매칭을 시도하는 테이블
쉽게 말하면 기준이 되어 먼저 읽히는 테이블
인덱스
테이블의 칼럼을 색인화(따로 파일로 저장)하여 테이블의 검색속도를 향상
검색시 해당 테이블 레코드를 Full Scan 하는 것이 아니라
색인화 된 인덱스 파일을 검색하여 검색속도를 빠르게 해준다
다만 그만큼 공간을 할당해야 하므로 인덱스를 아무곳에나 남발하면 안된다.
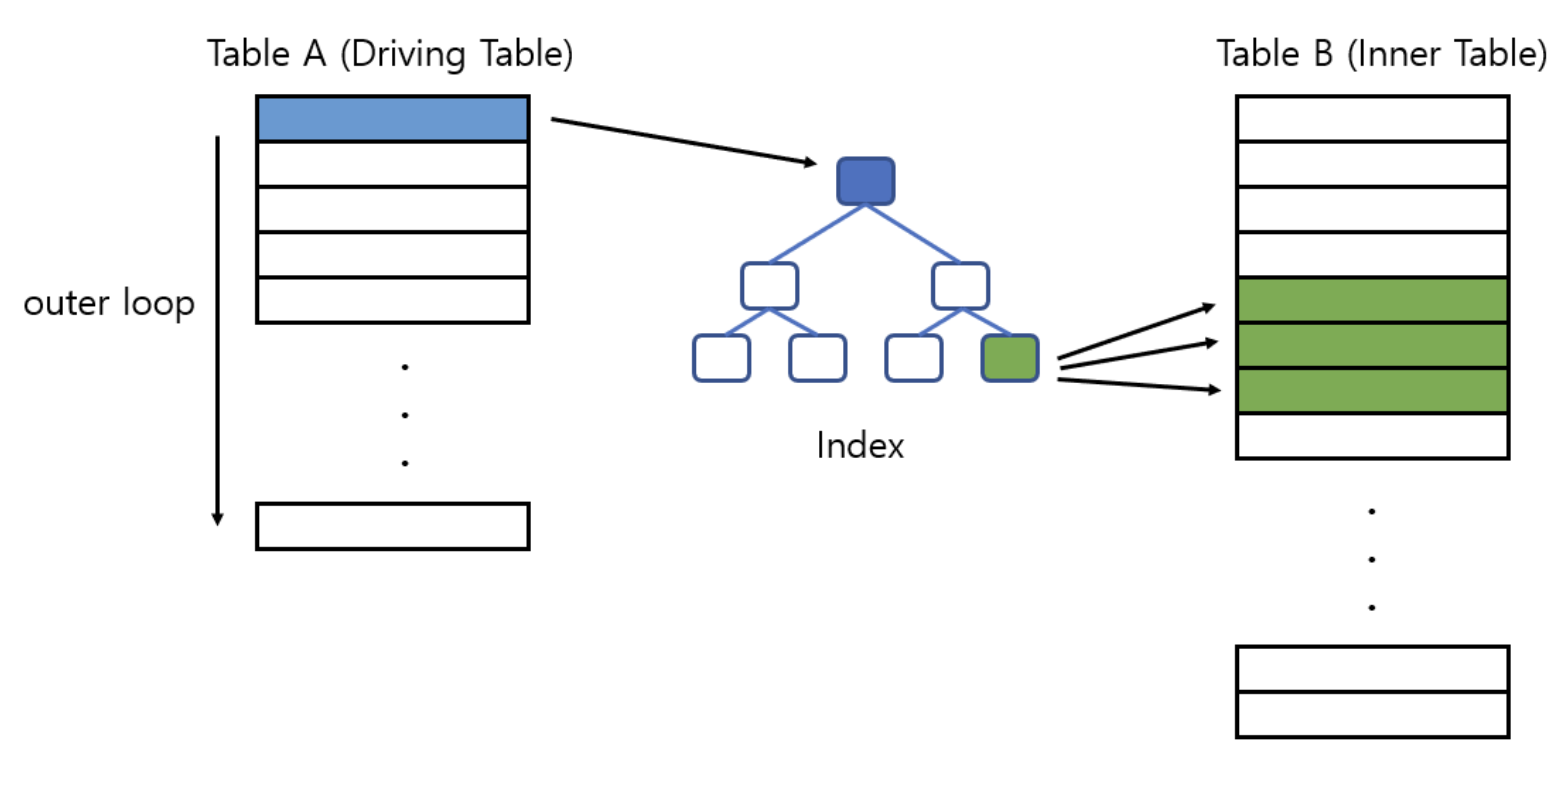
즉 위와 같이 인덱스가 걸려있다면 Join 된 내부 테이블을 스캔할 때 모든 행을 스캔하지 않기 때문에
R(A) * R(B) 값이 줄어들고 검색 성능이 개선된다.
구동 테이블은 어떻게 결정될까?
구동 테이블은 사용자가 함부로 결정하기 힘들다
옵티마이저가 최적의 실행 계확에 따라 스스로 결정하기 때문이다
따라서 옵티마이저는 구동테이블이 작고 내부 결합키에 인덱스가 존재하는 조건에 따라
비용이 최소화 되는 전략을 결정하여 구동 테이블을 결정한다
따라서 옵티마이저를 믿고 join 연산을 수행하면 된다
하지만 Outer Join 을 실행할 경우 반드시 Outer 가 되는 테이블을 먼저 읽어야 하기 때문에
옵티마이저가 Join 의 순서를 선택할 수 없다
즉 Left Outer Join 일 땐 왼쪽 테이블,
Right Outer Join 일 땐 오른쪽 테이블이 구동 테이블이 된다.
구동 테이블 지정 방법
DBMS 마다 다르지만 HINT 를 사용하면 실행 계획을 제어할 수 있다
하지만 HINT 를 사용하면 리스크가 존재하는데,
데이터 양과 Cardinality 는 DB를 운영하면서 계속 바뀌며
어떤 시점에 적절했던 실행 계획이
데이터가 수정됨에 따라 부적절해질 가능성이 존재한다.
(옵티마이저의 경우 비용 기반 동적 실행계획을 세워 이런 리스크를 커버한다)
따라서 주의해서 사용해야 하기 때문에 그냥 옵티마이저를 사용하는 게 안전한 방법이다
Cardinality
특정 칼럼에서 서로 다른 값의 개수 즉 유니크한 개수의 수를 의미
몸무게를 예로
100, 100, 100, 80, 60 의 값이 존재한다면
이 때 서로 다른 값의 개수는 총 3개이다
즉, 카디널리티는 3
카니널리티가 높으면(= 서로 다른 값이 많으면) 그만큼 인덱스의 효율이 좋다
그래서 보통 id 같은 유니크한 값에 인덱스를 자주 거는 것
결론
구동 테이블은 옵티마이저에게 맡긴다 하면
개발자 입장에서 성능적으로 신경써야 할 부분은 아래와 같이 정리할 수 있다.
- 인덱스를 어떻게 잘 걸어야 할까
- Join 의 수가 너무 많아지면 어떻게 줄여야 할까?
따라서 다음에는 인덱스에 대한 글과
실제 이중,삼중 이상의 Join 을 적용 시 발생할 수 있는 시나리오에 대한 글을 작성해보도록 하겠다.!