4.2 LSTM 과 GRU
4.2 LSTM과 GRU
딥러닝 스터디 4차 세션 과제 | 위키독스 「07-02 LSTM과 GRU」
들어가며
4.1은 이렇게 끝났다.
역전파가 시간을 거슬러 갈 때 같은 와 tanh 미분을 시점 수만큼 반복해서 곱하기 때문에, 문장이 길어지면 앞쪽 단어까지 기울기가 거의 닿지 않는다.
이번 편은 그 문제를 고친 두 셀, LSTM과 GRU를 다룬다. 결론부터 말하면 둘 다 바깥 모양은 4.1의 RNN과 같다. 입력 (배치, 시점, 차원)을 넣으면 outputs와 마지막 상태가 나온다. 바뀌는 건 셀 안쪽뿐이다.
1. 바닐라 RNN의 한계 — 장기 의존성
4.1의 기본 RNN을 LSTM과 구분해서 바닐라(vanilla) RNN이라고 부른다. 바닐라 RNN은 짧은 시퀀스에서만 잘 동작한다.
나는 프랑스에서 태어나 열다섯 살까지 그곳에서 자랐다. 그 뒤 한국으로 이사 와서 대학을 다녔고, 지금은 서울에서 개발자로 일한다. 그래서 나는 ___ 를 유창하게 한다.
빈칸에는 "프랑스어"가 들어가야 한다. 그런데 결정적인 단서인 "프랑스"는 수십 단어 앞에 있다. 바닐라 RNN의 은닉 상태는 매 시점 와 tanh를 거치며 덮어써진다. 그래서 그 사이에 앞쪽 정보가 거의 지워진다. 이렇게 필요한 정보가 멀리 떨어져 있어서 생기는 문제를 장기 의존성 문제(the problem of long-term dependencies) 라고 한다.
학습 쪽에서 보면 같은 문제다. 마지막 시점의 손실에서 앞쪽 입력까지 기울기가 가려면, 를 곱하고 tanh 미분(최대 1)을 곱하는 일을 시점 수만큼 반복해야 한다. 3.6에서 층을 깊게 쌓을 때 본 기울기 소실이, 여기서는 시간 방향으로 일어난다. 4절에서 직접 재 본다.
2. LSTM의 아이디어 — 기억을 두 줄로 나눈다
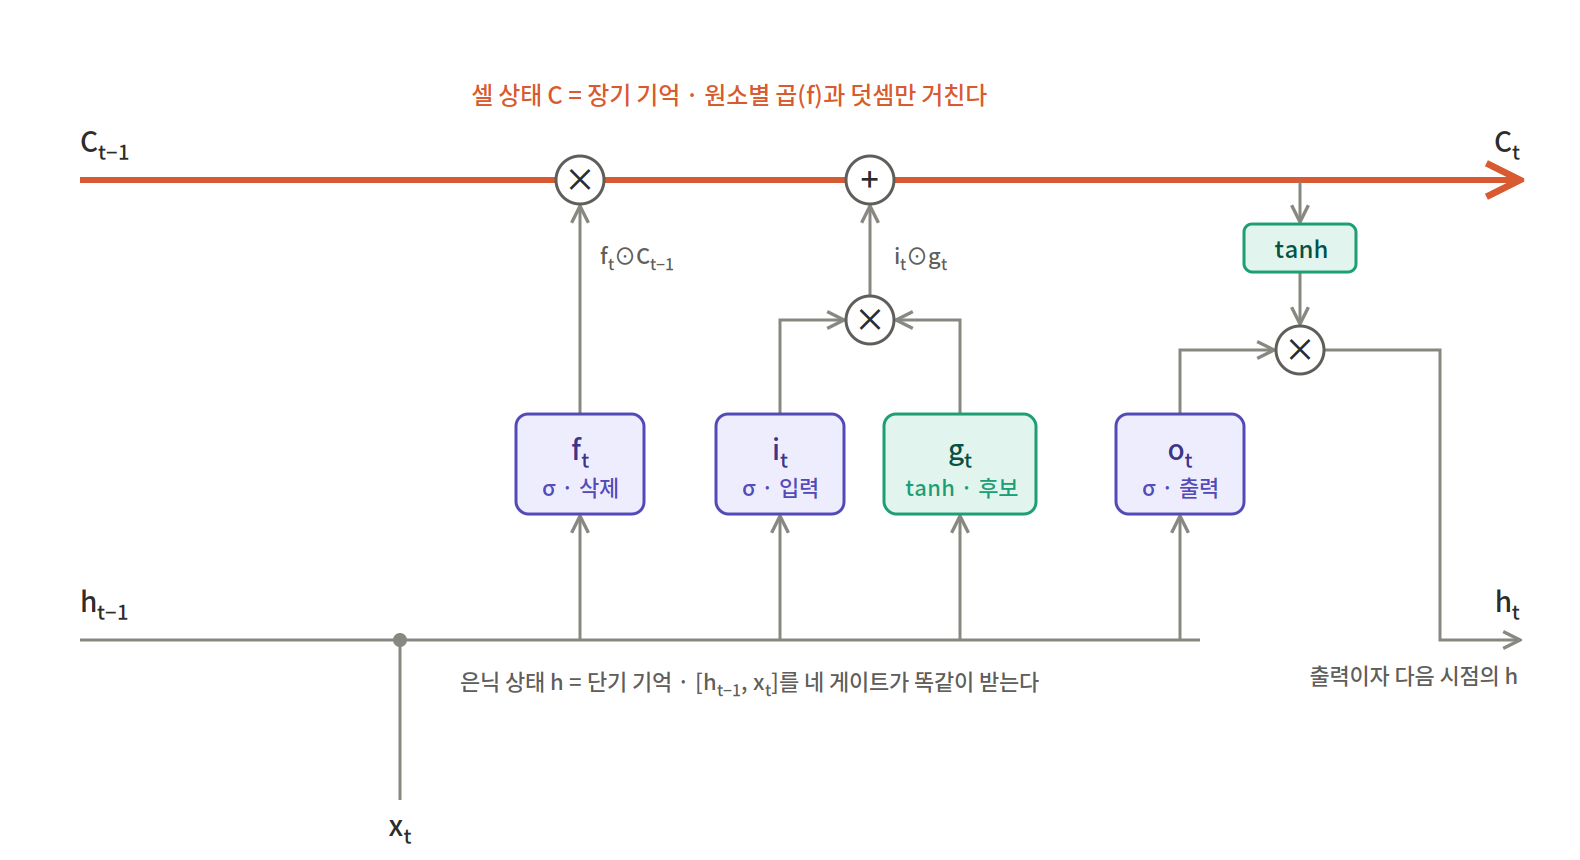
LSTM(Long Short-Term Memory) 은 기억을 두 줄로 들고 간다.
| 이름 | 역할 | |
|---|---|---|
| 셀 상태(cell state) | 장기 기억. 시점을 지나며 곱셈 한 번(삭제)과 덧셈 한 번(추가)만 거친다 | |
| 은닉 상태(hidden state) | 단기 기억. 셀 상태를 다듬어 꺼낸 값. 출력이자 다음 시점의 입력 |
셀 상태는 컨베이어 벨트처럼 생각하면 된다. 벨트는 그냥 흘러가고, 중간중간 게이트가 "무엇을 지울지", "무엇을 올릴지", "무엇을 꺼내 보일지"만 조절한다.
게이트 = 0~1 사이의 밸브
게이트는 시그모이드(σ) 를 거친 값이라 0~1 사이다. 이 값을 다른 벡터에 원소별로 곱한다.
- 1에 가까우면 → 거의 다 통과
- 0에 가까우면 → 거의 다 막힘
원소별 곱은 로 쓴다(위키독스는 로 쓴다). 2.4 소프트맥스에서 본 행렬곱이 아니라, 같은 위치끼리 곱하는 것이다. 파이토치에서는 그냥 *다.
3. LSTM의 수식 — 게이트 네 개
네 개 모두 4.1과 같은 모양이다
먼저 공통점부터 보자. LSTM 안의 값 네 개는 전부 4.1의 RNN 셀과 같은 식이다.
지금 입력과 직전 은닉 상태를 각자의 가중치로 곱해서 더한다. 다른 건 가중치 세트가 네 벌이라는 것과 활성화 함수뿐이다.
| 기호 | 이름 | 활성화 | 범위 | 하는 일 |
|---|---|---|---|---|
| 삭제 게이트 (forget) | σ | 0 ~ 1 | 이전 셀 상태를 얼마나 남길지 | |
| 입력 게이트 (input) | σ | 0 ~ 1 | 새 후보를 얼마나 넣을지 | |
| 후보 (candidate) | tanh | -1 ~ 1 | 넣을 내용 자체. 4.1의 계산과 똑같다 | |
| 출력 게이트 (output) | σ | 0 ~ 1 | 셀 상태를 얼마나 꺼내 보일지 |
💡 의 식은 4.1 바닐라 RNN의 식과 완전히 같다. 바닐라 RNN은 이 값을 그대로 새 기억으로 썼다. LSTM은 이 값을 후보로만 두고, 게이트로 얼마나 반영할지 정한다.
셀 상태 갱신 — 핵심은 덧셈
- 앞 항 : 이전 장기 기억 중 남길 만큼만 남긴다.
- 뒤 항 : 새 후보 중 넣을 만큼만 넣는다.
- 그리고 둘을 더한다.
게이트 값이 극단적일 때를 보면 의미가 분명해진다.
| 뜻 | |||
|---|---|---|---|
| 1 | 0 | 이번 단어는 무시하고 기억을 그대로 유지 | |
| 0 | 1 | 과거를 지우고 새로 씀 | |
| 1 | 1 | 과거를 유지하면서 새 내용을 추가 | |
| 0 | 0 | 0 | 다 비움 |
첫 줄이 장기 기억의 비결이다. 1절의 문장이라면 "프랑스"를 읽을 때 그 정보를 셀 상태에 넣는다. 그 뒤 상관없는 단어들에서는 으로 그대로 실어 나르면 된다. 바닐라 RNN에는 이렇게 "건드리지 않고 넘기는" 길이 없었다.
은닉 상태 — 셀 상태에서 꺼내 보이기
셀 상태를 tanh로 -1~1 사이로 다듬는다. 그다음 출력 게이트로 지금 필요한 부분만 꺼낸다. 이 가 그 시점의 출력이고, 다음 시점 네 게이트의 입력이다.
📌 위키독스에는 이 식이 로 소문자 로 적혀 있다. 셀 상태 와 같은 것이다.
한 시점을 코드로 쓰면
f = torch.sigmoid(x_t @ Wxf.T + h @ Whf.T + bf)   # 삭제 게이트
i = torch.sigmoid(x_t @ Wxi.T + h @ Whi.T + bi)   # 입력 게이트
g = torch.tanh(   x_t @ Wxg.T + h @ Whg.T + bg)   # 후보
o = torch.sigmoid(x_t @ Wxo.T + h @ Who.T + bo)   # 출력 게이트

c = f * c + i * g          # 셀 상태: 곱셈 한 번, 덧셈 한 번
h = o * torch.tanh(c)      # 은닉 상태
4.1의 반복문에서 한 줄이던 것이 여섯 줄이 됐다. 그래도 위 네 줄은 같은 모양의 반복이다.
4. 왜 LSTM은 기울기가 덜 사라지나
셀 상태 길의 미분
셀 상태 식 를 로 미분하면, 직접 경로에서는
바닐라 RNN은 한 시점 거슬러 갈 때마다 행렬 와 tanh 미분을 곱했다. LSTM의 셀 상태 길은 삭제 게이트 값 만 곱한다. 가 1에 가까우면 기울기가 거의 줄지 않고 앞으로 전달된다.
직접 재 보기
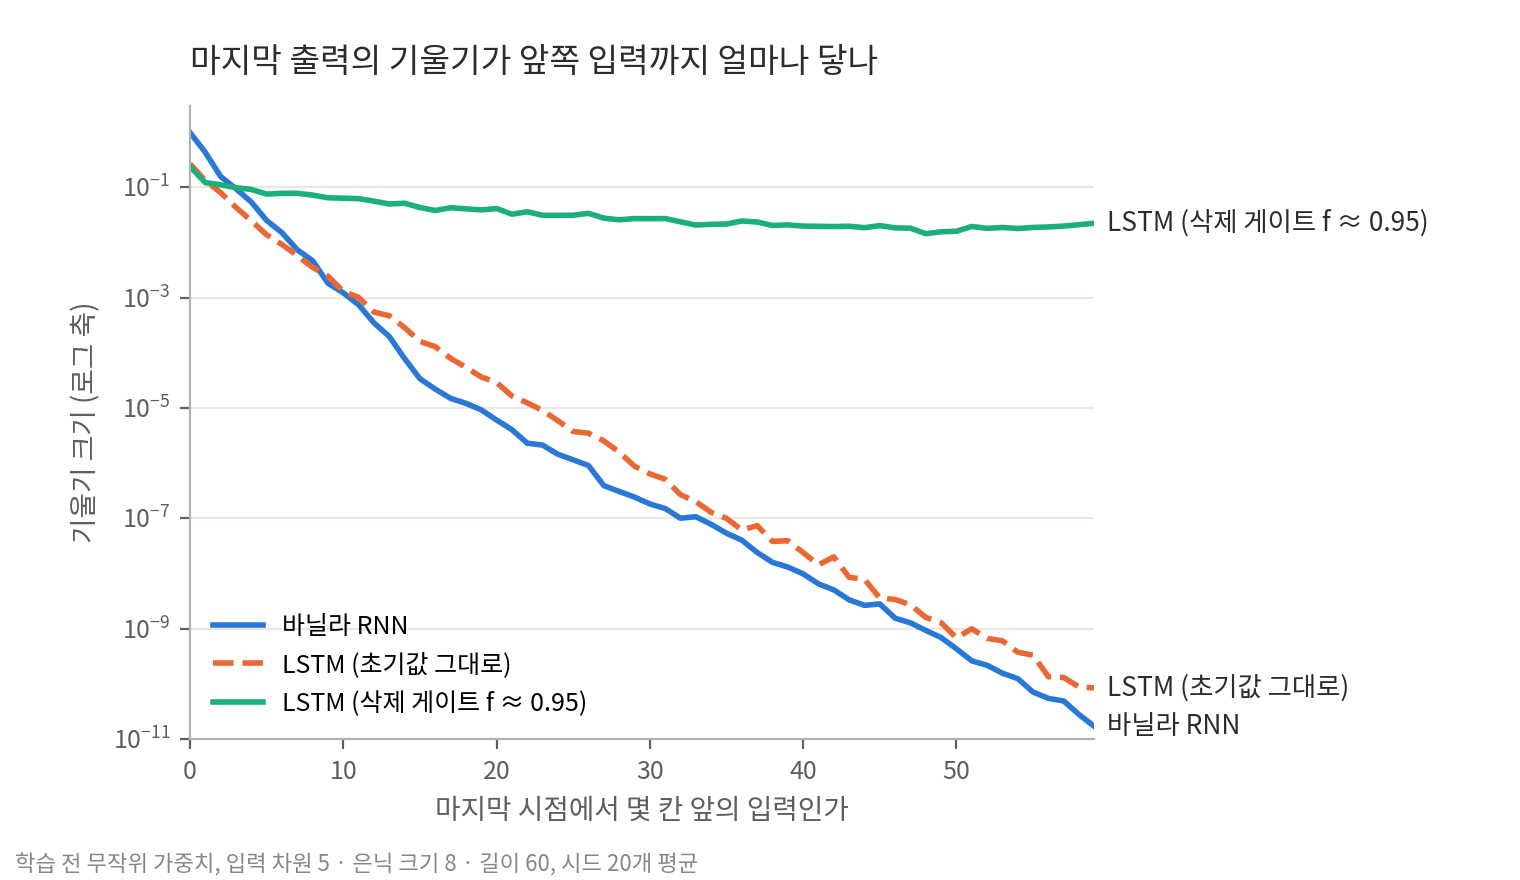
길이 60짜리 시퀀스를 넣었다. 그리고 마지막 출력의 기울기가 각 시점의 입력까지 얼마나 닿는지 재 봤다. 학습 전 무작위 가중치이고, 시드 20개의 평균이다.
x = torch.randn(1, 60, 5, requires_grad=True)
out = model(x)[0]
out[:, -1].sum().backward()       # 마지막 시점 출력에서 역전파
x.grad[0].norm(dim=1) # 시점마다 입력에 도착한 기울기 크기| 모델 | 바로 앞 (0칸) | 10칸 앞 | 30칸 앞 | 59칸 앞 |
|---|---|---|---|---|
| 바닐라 RNN | 9.8e-01 | 1.2e-03 | 1.8e-07 | 1.7e-11 |
| LSTM (초기값 그대로) | 2.6e-01 | 1.3e-03 | 6.4e-07 | 8.5e-11 |
| LSTM (삭제 게이트 f ≈ 0.95) | 2.3e-01 | 6.3e-02 | 2.7e-02 | 2.2e-02 |
여기서 중요한 관찰이 하나 있다. 초기값 그대로의 LSTM은 바닐라 RNN만큼 빠르게 사라진다. 파이토치는 게이트 편향을 0 근처로 초기화한다. 그래서 학습 전에는 이고, 매 시점 기억이 절반씩 줄어든다.
삭제 게이트의 편향을 3으로 바꿔서 로 만들면 이야기가 달라진다. 60칸 앞까지 기울기가 거의 그대로 남는다.
즉 LSTM은 기울기 소실을 자동으로 없애 주는 게 아니다. 기울기가 지나갈 수 있는 길(셀 상태)을 만들어 두고, 그 길을 열지 말지()를 학습하게 한 것이다. 오래 기억해야 하는 정보가 있으면, 학습하면서 해당 칸의 가 1 가까이 올라간다.
💡 그래서 실무에서는 삭제 게이트 편향을 처음부터 1 정도로 크게 잡아 두는 경우도 있다. "처음엔 일단 다 기억해 두고, 필요 없는 걸 지우는 법을 배워라"라는 뜻이다. 이 스터디의 4.5에서는 따로 건드리지 않는다.
5. 파이토치 nn.LSTM
사용법 — nn.RNN과 거의 같다
lstm = nn.LSTM(input_size=5, hidden_size=8, batch_first=True)

inputs = torch.randn(1, 10, 5)
outputs, (h_n, c_n) = lstm(inputs)

print(outputs.shape)   # torch.Size([1, 10, 8])
print(h_n.shape)       # torch.Size([1, 1, 8])
print(c_n.shape)       # torch.Size([1, 1, 8])
4.1과 다른 점은 반환값의 두 번째 자리가 튜플이라는 것 하나다.
| 반환값 | shape | 뜻 |
|---|---|---|
outputs | (배치, 시점, 은닉) | 모든 시점의 . 4.1과 같다 |
h_n | (층 × 방향, 배치, 은닉) | 마지막 시점의 . 4.1의 _status와 같다 |
c_n | (층 × 방향, 배치, 은닉) | 마지막 시점의 셀 상태 . LSTM에만 있다 |
⚠️
outputs, _status = lstm(inputs)로 받으면_status가 텐서가 아니라 튜플(h_n, c_n)이 된다._status.shape를 찍으면 에러가 난다. LSTM은 꼭outputs, (h_n, c_n)으로 풀어서 받자.
outputs에는 만 담기고 는 담기지 않는다. 셀 상태는 셀 안에서만 흐르는 기억이고, 바깥으로 보이는 건 은닉 상태다. 마지막 셀 상태만 c_n으로 따로 꺼내 준다.
층 하나에 단방향이면 4.1처럼 outputs[:, -1]과 h_n[0]이 같다. 4.5의 리뷰 분류 모델도 이 값을 쓴다. lstm_out, (hidden, cell) = self.lstm(embedded)로 받고, hidden.squeeze(0)으로 (1, 배치, 은닉)의 맨 앞 1을 없앤 뒤 fc층에 넣는다. 층이 여러 개라면 hidden[-1](마지막 층)을 쓰면 된다.
파라미터 — 정확히 4배
for name, p in lstm.named_parameters():
    print(name, tuple(p.shape))
weight_ih_l0 (32, 5) ← W_x 네 개를 세로로 쌓은 것 (8 × 4 = 32)
weight_hh_l0 (32, 8) ← W_h 네 개
bias_ih_l0 (32,)
bias_hh_l0 (32,)
게이트 네 개의 가중치를 따로 두지 않고 한 행렬에 세로로 쌓아 둔다. 행렬곱 한 번으로 네 개를 한꺼번에 계산한 뒤 넷으로 자른다. 쌓인 순서는 i, f, g, o다.
수식대로 직접 계산해서 비교
z = x_t @ lstm.weight_ih_l0.T + lstm.bias_ih_l0 + h @ lstm.weight_hh_l0.T + lstm.bias_hh_l0
i, f, g, o = z.chunk(4, dim=1)            # 32칸을 8칸씩 넷으로 자른다 (순서 i, f, g, o)
i, f, g, o = torch.sigmoid(i), torch.sigmoid(f), torch.tanh(g), torch.sigmoid(o)
c = f * c + i * g
h = o * torch.tanh(c)
이걸 10시점 반복하면 outputs, c_n과 정확히 같다(torch.allclose → True). 3절의 수식이 그대로 nn.LSTM 안에 들어 있다.
6. GRU — 게이트를 두 개로 줄인 LSTM
GRU(Gated Recurrent Unit) 는 2014년에 나왔다. LSTM의 아이디어는 살리면서 구조를 줄였다.
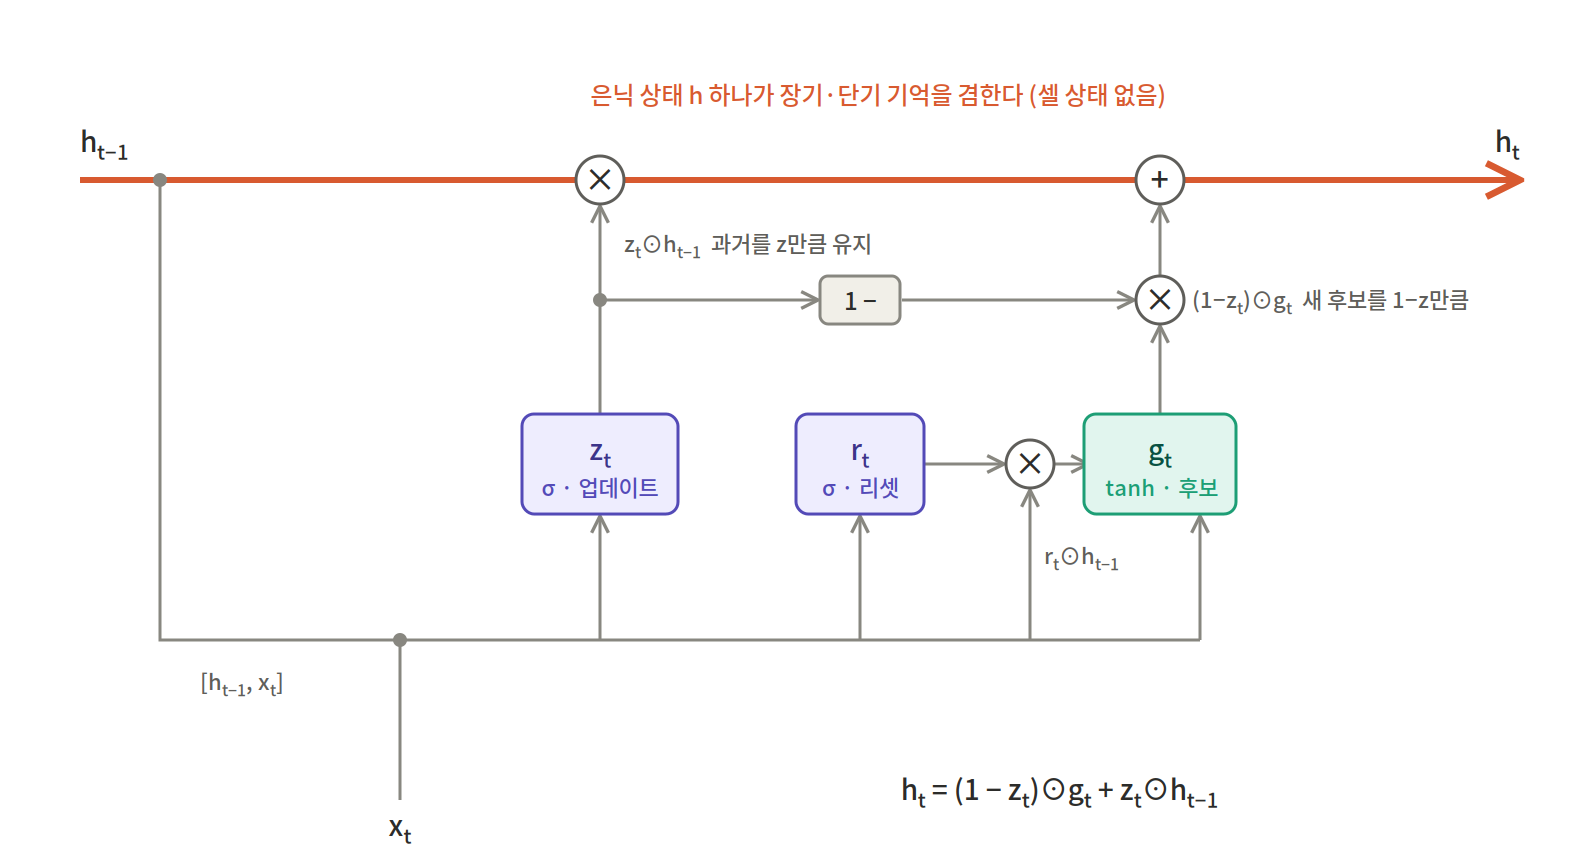
- 셀 상태가 없다. 은닉 상태 하나가 장기·단기 기억을 다 맡는다.
- 게이트가 두 개다. 리셋 게이트 , 업데이트 게이트 .
수식
업데이트 게이트 — 과거와 새것의 비율
마지막 식이 GRU의 핵심이다. 와 는 더하면 1이다. 그래서 는 과거 과 새 후보 를 비율로 섞은 것이 된다.
| 뜻 | ||
|---|---|---|
| 1 | 과거를 그대로 유지 (LSTM의 ) | |
| 0 | 새것으로 교체 (LSTM의 ) | |
| 0.5 | 반반 | 섞는다 |
LSTM은 삭제()와 입력()을 따로 정했다. GRU는 "남기는 만큼 덜 넣는다"로 하나로 묶었다. 그래서 게이트가 하나 줄었다.
리셋 게이트 — 후보를 만들 때 과거를 얼마나 볼지
후보 를 만들 때 직전 은닉 상태에 를 곱해서 넣는다. 이면 과거를 무시하고 지금 입력만으로 후보를 만든다. 문장이 새 주제로 넘어갈 때처럼 "앞 내용과 상관없이 새로 시작"하는 데 쓰인다.
📌 파이토치의 GRU는 리셋 게이트를 곱하는 위치가 조금 다르다. 위키독스(원 논문 방식)는 로 곱하기 전에 를 곱한다. 파이토치는 로 곱한 뒤에 곱한다. 계산이 빨라서 이렇게 하는 구현이 많다. 직접 계산해 보면 두 방식의 결과는 다르다. 하지만 학습하면 성능은 거의 같다. 파이토치 GRU를 수식으로 따라가 볼 때만 주의하면 된다.
7. 파이토치 nn.GRU
gru = nn.GRU(input_size=5, hidden_size=8, batch_first=True)
outputs, h_n = gru(inputs)

print(outputs.shape)   # torch.Size([1, 10, 8])
print(h_n.shape)       # torch.Size([1, 1, 8])
셀 상태가 없으니 반환값은 4.1의 nn.RNN과 똑같은 모양이다. 튜플이 아니라 텐서 하나다.
파라미터는 3배다. 가중치가 r, z, g 세 벌이고, 이 순서로 쌓여 있다.
weight_ih_l0 (24, 5)    ← 8 × 3
weight_hh_l0 (24, 8)
bias_ih_l0   (24,)
bias_hh_l0   (24,)
8. 셋 비교
| 바닐라 RNN | LSTM | GRU | |
|---|---|---|---|
| 기억 | (단기) + (장기) | ||
| 게이트 | 없음 | 3개 (f, i, o) + 후보 g | 2개 (r, z) + 후보 g |
| 기억 갱신 | 매번 덮어씀 | ||
| 가중치 세트 | 1벌 | 4벌 | 3벌 |
| 파라미터 (=5, =8) | 120 | 480 | 360 |
| 반환값 | outputs, h_n | outputs, (h_n, c_n) | outputs, h_n |
| 긴 시퀀스 | 약함 | 강함 | 강함 |
무엇을 쓸까? 둘 다 바닐라 RNN보다는 확실히 낫고, 둘 사이의 성능 차이는 문제마다 다르다. 흔히 쓰이는 경험칙은 다음과 같다.
- GRU: 파라미터가 적어서 빠르다. 데이터가 적을 때 유리한 편이다.
- LSTM: 데이터가 많을 때 유리한 편이다.
4.5의 네이버 영화 리뷰 분류는 LSTM을 쓴다.
정리
| 개념 | 한 줄 |
|---|---|
| 장기 의존성 | 필요한 정보가 멀리 있으면 바닐라 RNN은 잊는다 (시간 방향 기울기 소실) |
| 셀 상태 | LSTM의 장기 기억. 곱셈 한 번 + 덧셈 한 번으로만 갱신 |
| 게이트 | σ로 만든 0~1 밸브. 원소별로 곱해 통과량을 조절 |
| LSTM 게이트 | 삭제 , 입력 , 출력 + 후보 |
| 셀 상태 식 | |
| 은닉 상태 식 | |
| 기울기 | 셀 상태 길은 만 곱한다 → 이면 멀리까지 전달. 단, 그 값은 학습으로 정해진다 |
| GRU | 셀 상태 없음, 게이트 2개. |
nn.LSTM | outputs, (h_n, c_n). 파라미터 4배, 순서 i·f·g·o |
nn.GRU | outputs, h_n. 파라미터 3배, 순서 r·z·g |
말로 설명할 때의 한 문장
"바닐라 RNN은 매 시점 기억을 덮어써서 긴 문장의 앞부분을 잊습니다. LSTM은 셀 상태라는 별도 기억 통로를 두고, 삭제·입력·출력 게이트로 무엇을 지우고 넣고 꺼낼지 조절합니다. 셀 상태는 덧셈으로 갱신되기 때문에 기울기가 멀리까지 전달될 수 있습니다. GRU는 같은 아이디어를 게이트 두 개로 줄인 가벼운 버전입니다."
다음 편부터는 모델이 아니라 입력 쪽이다. 지금까지는 torch.randn으로 만든 가짜 단어 벡터를 넣었다. 4.3 토큰화와 4.4 임베딩에서 진짜 문장을 이 (배치, 시점, 차원) 텐서로 바꾸는 법을 본다.