1️⃣ 준비하기
학습 시킬 데이터는 게임 데이터를 csv로 제공해주는 사이트 에서 Challenger_Ranked_Games.csv를 다운받고
테스트 할 데이터는 게임 데이터를 csv로 제공해주는 사이트 에서 GrandMaster_Ranked_Games.csv를 다운받아 준비했다.
2️⃣ 분석하기
Challenger_Ranked_Games.csv의 데이터는 생김새가

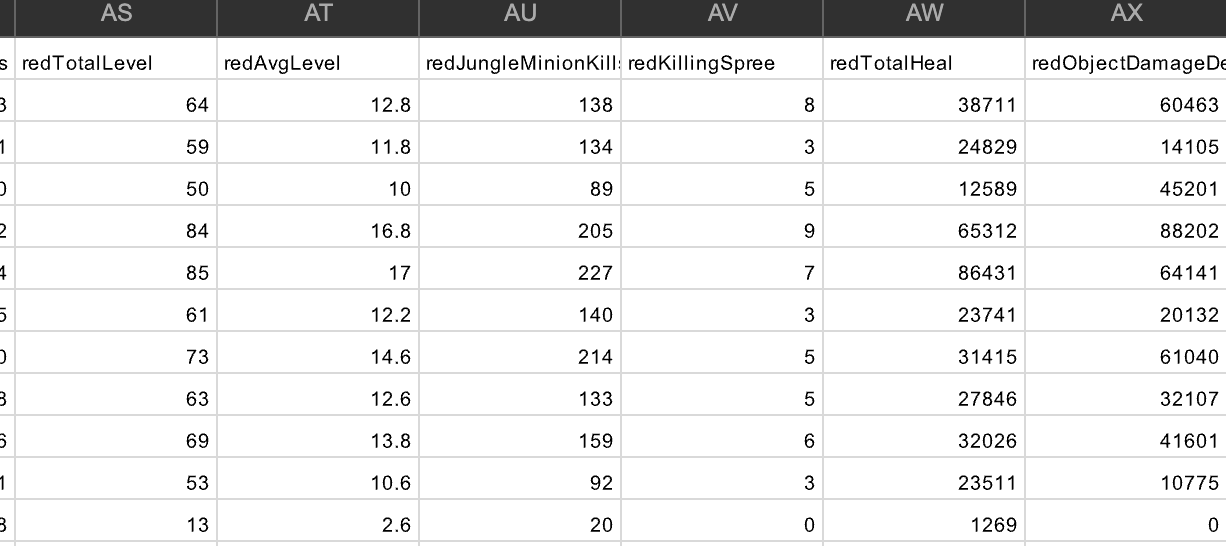
gameDuration 이후로 blue{값} 형식으로 쭉 컬럼이 있다가 어느순간부터 red{형식}으로 컬럼이 있다.
그래서 이 데이터 셋은 파랑과 빨강을 분류해서 학습해야겠다고 판단했다.
그리고 데이터 중에 승부에 관련이 없는 데이터가 있는 것 같아 전체를 학습시키기보단
따로 분류해서 학습시키는게 더 정확도가 높을것같다고 판단했다.
FirstBaron = 첫 바론
DragonKills = 용 처치 횟수
BaronKills = 바론 처치 횟수
TowerKills = 타워 부순 개수
WardPlaced = 와드 설치 횟수
Kills = 처치 횟수
Death = 데스 횟수
Assist = 어시스트 횟수
TotalGold = 획득한 골드
TotalMinionKills = 처치 미니언 수
TotalLevel = 총 레벨 합
이것들의 데이터가 중요하다고 판단해서 이 데이터만 짜집기 하기로 판단했다.
3️⃣ 실행하기
import numpy as np
import tensorflow as tf
from tensorflow.keras.layers import Dense
from tensorflow.keras.models import Sequential
import pandas as pd

#Challenger_Ranked_Games.csv 불러오기
df = pd.read_csv('/content/Challenger_Ranked_Games.csv')

# gameDuration 행 삭제
new_df = df.drop('gameDuraton', axis=1)

# blue값만 추출
blue_df = new_df.filter(like="blue")

#승패에 대한 데이터는 0과 1로만 나오게
blue_y = blue_df['blueWins']

#승부에 영향을 주는 행들을 따로 X에 저장
blue_X = blue_df[['blueFirstBaron','blueDragonKills','blueBaronKills','blueTowerKills','blueWardPlaced','blueKills','blueDeath','blueAssist','blueTotalGold','blueTotalMinionKills','blueTotalLevel']]

# 테스트 데이터

test_df =
# test가 학습 데이터와 같으면 테스트가 아니여서 다른 데이터 셋을 업로드함.
pd.read_csv('/content/GrandMaster_Ranked_Games.csv')

new_test_df = test_df.drop('gameDuraton', axis=1)

blueTest_df = new_test_df.filter(like="blue")

test_y = blueTest_df['blueWins']

test_X = blueTest_df[['blueFirstBaron','blueDragonKills','blueBaronKills','blueTowerKills','blueWardPlaced','blueKills','blueDeath','blueAssist','blueTotalGold','blueTotalMinionKills','blueTotalLevel']]


# blue model 만들기
blue_model = Sequential()
blue_model.add(Dense(30, input_dim = 11, activation = 'relu'))
#0과 1 둘 중 하나만 출력하니 sigmoid함수 사용
blue_model.add(Dense(1, activation = 'sigmoid'))


blue_model.compile(loss = 'binary_crossentropy', optimizer = 'adam', metrics = ['accuracy'])


# 정확도를 위해 epochs 500으로 지정
history = blue_model.fit(blue_X, blue_y, epochs=500, batch_size=16)

# test값으로 비교해보면
score = blue_model.evaluate(test_X, test_y)
#정확도를 알 수 있음
print(score[1])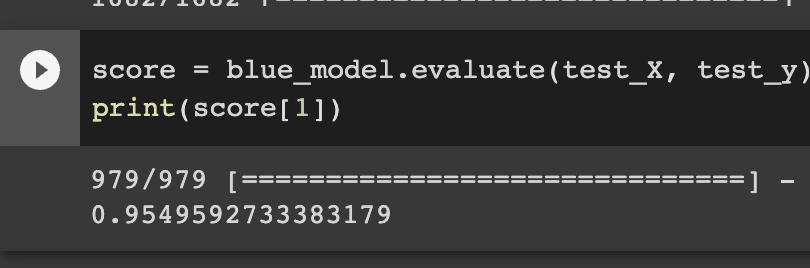
나의 정확도는 95.495%가 나왔다.
꿈틀꿈틀 지렁이입니다 😎