사실 나는 인강이 더 친숙한 사람이라서,
컴퓨터 관련 공부를 할 때 책보다 인강이나 기술블로그, 관련 페이지의 문서등을 보는 사람이었다.
하지만 최근에 혁펜하인님의 "Easy 딥러닝" 인강으로도 물론 들었지만 책과 함께 읽으면서, (물론.. 상반기에 인강을 너무많이 결재했던.. 금전적이슈도 있었지만)
책으로 공부하는것에 대해서 다시생각해보는 계기가 되었다.
그러던 와중에 우연히 redis관련 책을 추천하는 글을 보고, 이 책을 시작으로 내가 그동안에 부족했다고 느꼈던 부분을 인강에 의존하지 않고 책으로써 공부하고 정리하려고 한다.
우선 책으로 보니까 좋은점!
인강은 중간중간 딴짓을 하게되는데, 책은 내가 읽고 생각해서 이해를 하는 과정이 더 많다보니 아직까지는..? 더 머리속에 잘 들어가는 느낌이다. 중간중간 딴짓도 덜하게된다.
(인강은.. 뭔가 떠먹여주는 느낌이 강해서 생각을 덜 하게되는것같다)
그래서 이번에 읽은 책은 이거다!
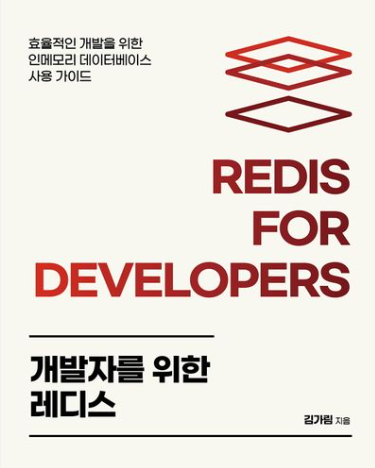
실제로 써보면서 레디스가 빠르고.. 메모리저장 막연하게 이런내용은 알았는데,
첫장을 보는순간.. 나는 헛공부했다라는 생각밖에는 안들었다..
동시에 그동안에 내가 생각했던것보다 더 많은곳에서 사용가능하고, 내가 썼던 기능들은 빙산에 일부밖에 되지 않았구나라는걸 깨닫게 해주었다.
아직 전부 읽은건 아니지만.. 정말 왜 사람들이 이 책이 좋다고 하는지 알 것 같다.
sql : standard query language
-> NoSql = not only sql
NoSql
- graph : 관계를 저장하고 표현할 때 유용, 너무 많은 속성을 저장할때는 x, 추천서비스에서 유용
- 칼럼유형 : 관게를 열 기준으로 저장한다. 대량의 데이터에대한 집계 쿼리에 빠름
- 문서 유형 : json형태로 데이터 저장, 효율적으로 직관적, 유연성이 크다, 트리구조를 갖는다. 저장하거나 검색하는데 효과적
- 키-값 유형 : 가장 단순하고 빠르다. 구조의 단순성으로 데이터 액세스와 처리 속도를 보장해준다.
redis : remomte dictionary server
- 키 값 인메모리
- 인메모리 : 모든 데이터가 컴퓨터의 메모리에서 관리됨 -> 디스크에 접근하는 과정이 필요x -> 데이터처리성능 fast, 데이터는 영구저장되지 않는다.
( <-> 온디스크 : 영구적으로 디스크에 저장되지만, 데이터를 찾을때에는 디스크의 데이터를 페이지 단위로 메모리에 올린뒤 메모리에서 데이터를 찾고, 없다면 다른 페이지를 디스크에서 가져와 메모리에 올린 뒤 찾는 과정을 반복한다) - 내장된 다양한 자료 구조를 통해 임피던스 불일치 ( 기존 관계형 데이터베이스의 프로그래밍 언어간 데이터 구조, 기능의 차이로 인해 발생하는 충돌 ) 를 해소하도록지원함.
- 싱글스레드로 동작한다 = cpu가 적은 서버에서도 좋은 성능을 낼 수 있음 / 느린 커맨드 조심 / 인적 장애 발생 가능성이 높다
- 복제를 통해 여러 서버에 분산가능하며, 센티널은 장애 상황을 탐지해 자동으로 페일오버를 시켜준다.
- 클러스터 모드를 활용한다면 수평적 확장이 가능하다. ( 클러스터 모드에서는 자동으로 샤딩된 후 저장되며, 클러스터 버스라는 프로트콜을 이용해 서로 감시하며, 마스터노드에 문제가 발생하면 자동으로 페일오버를 시킴)
--> 설치가 간편하고, 최소한의 리소스로 막대한 처리량을 낼 수 있으며, 다양한 자료 구조를 제공하면서도 사용이 간단해서 마이크로서비스의 요구사항에 맞는 데이터를 저장하기에 편하다.
또한, aof, rdb형식으로 디스크에 주기적으로 저장가능하다.
redis의 메세지 브로커기능
- push/pub : 간단한 메세징 기능으로 굉장이 빠르게 동작하며 간단하다. 하나의 채널에 데이터를 던지면 이 채널을 듣고있는 모든 소비자는 데이터를 빠르게 가져가며, 전달된 뒤 삭제되는 일회성으로 간단한 알림서비스에서 유용하다.
- list자료구조 : 메시징 큐로 사용하기 good, 대기하다가 새로운 데이터가 늘어오면 읽어갈 수 있는 블로킹 기능을 사용할 수 있다. -> 좀 더 알아봐야겠다.
- stream : 데이터를 추가되는 방식으로 저장된다( append-only), 데이터와 분산처리도 가능하며 저장된 데이터를 시간대별로 검색하는 것도 가능하다.
레디스 시작하기 : 소스 코드를 다운로드 하는것을 추천.
-
maxclients : 레디스 프로세스에서 받아들일 수 있는 최대 클라이언트의 개수를 의미한다. ( 기본 10000 ), 예약된 파일 시크립터수가 32개이므로, 기본값으로 지정하고싶다면최소 10032이상으로 지정해야 한다.
-
THT: 페이지를 크게 만든 뒤 자동으로 관리하는 기능
-> 레디스를 사용할 때는 퍼포먼스가 떨어지며 레이턴시가 올라가는 현상이 발생하므로 사용하지 않는것을 추천한다. -
vm.overcomment_memory 값을 1로 바꾸자( 기본 0)
-> 필요한 메모리를 초과해서 할당하는것을 허용해서, 메모리의 과도한 사용이나 잘못된 동작을 예방하고, 백그라운드에서 데이터를 저장하는 과정에서 성능 저하나 오류를 방지할 수 있게 설정해야한다. -
tcp-backlog : 레디스 인스턴스가 클라이언트와 통신 할 때 사용하는 tcp backlog큐의 크기를 지정한다.
tcp-backlog 값은 서버의 somaxconn, syn_backlog 값보다 클 수 없으므로, 서버 설정이 tcp-backlog의 기본값인 511보다 크도록 설정해야 한다.
redis 기본 개념
-
만약 하나의 키에 다른 값이 연결되어있었다면, 기존값은 새로 입력된 값으로 대체된다.
-
set과 함께 nx옵션을 사용한다면 지정된 키가 없을 때에만 새로운 키를 저장한다.( 데이터 덮어쓰기 방지 )
-
set과 함께 xx옵션을 사용하면 키가 이미 있을때에만 새로운 키를 덮어쓴다. ( 새로운 키 생성방지 )
-
레디스에서 incr, incrby와 같은 커맨드를 이용하면, string자료구조에 저장된 숫자를 원자적으로 조작 가능하다 -> 동시에 incr를 했을때 하나만 적용하는 일이 발생되지 않는다./ 하나의 프로세스가 incr할 때 다른 클라이언트가 이 키에 접근할 수 없음을 보장한다.
-
레디스의 자료구조
-
string : 키와 아이템이 일대일로 연결되는 유일한 자료구조이며, 다른 자료구조에서는 일대다 관계가된다. 최고 512mb 값을 저장 가능하다/.
=> INCR, INCRBY, MSET, MGET -
list : 순서를 가지는 문자열의 목록 ( 시간복잡도 n )
=> LPUSH, RPUSH, LRANGE, LPOP, LTRIM , LINSERT (BEFORE/AFTER), LINDEX -
hash : 필드-쌍을 가진 아이템의 집합, 필드 하나의 hash내에서 유일하며, 필드와 값 모두 문자열 데이터로 저장된다. 객체를 표현하기 적절한 자료구조, 각 아이템마다 서로 다른 필드를 갖을 수 있으며 동적으로 다양한 필드를 추가할 수 있다.-> 좀 더 유연한 개발이 가능하다.
=> HGET, HMGETM HGETALL -
set : 정렬되지 않은 문자열 모음, 중복해서 저장되지 않으며 교집합 합집합 차집합 등의 집합 연산과 관련한 커맨드를 제공하기 때문에 객체 간의 관계를 계산하거나 유일한 원소를 구해야 할 경우에 사용될 수 있다.
=> SADD, SREM, SPOP, SUNION, SINTER, SDIFF -
sorted set : score값에 따르 정렬되는 고유한 문자열의 집합, 데이터는 중복없이 유일하게 저장되며 아이템은 데이터의 사전 순으로 정렬된다. 인덱스를 이용해 아이템에 접근할 일이 많다면 list보다는 sorted set으로 활용하는것이 효율적이다. ( 시간복잡도 log(n))
=> ZADD (--option : XX, NX, LT, GT), ZRANGE -
비트랩 : string자료 구조에 bit연산을 수행할 수 있도록 확장한 형태, 2의 32승까지 저장 가능
=> SETBIT, GETBIT, BITFILED, BITCOUNT -
Hyperloglog : 집합의 원소 개수인 카디널리티를 추정할 수 있는 자료구조, 고유한 값을 집계될 때 유용하게 사용가능, set과는 다르게 데이터 그 자체를 저장하지 않고 자체적인 방법으로 데이터를 변경해 처리 -> 저장되는 데이터 개수에 구애받지 않고 계속 일정한 메모리를 유지가능, 중복되지 않는 유일한 원소를 계싼가능하다. 최도 12kb크기를 갖으며, 비교적 정확하게(오차는 0.81%) 데이터를 추정할 수 있다.
=> pFADD, PFCOUNT -
Geospatial : 경도, 위도 데이터 쌍의 집합으로 간편하게 지리 데이터를 저장 할 수 있다. 키는 중복돼어 저장되지 않는다.
=> GEOADD, GEOPOS, GEODIST, GEOSEARCH, BYRADIUS, BYBOX -
Stream : 메시지 브로커로서 사용할 수 있게 하는 자료구조, 소비자 그룹 개념을 도입해 데이터를 분산 처리 가능하다. 데이터를 계속해서 추가하는 방식으로 저장한다.
레디스의 키 관리
-
키가 존재하지 않을 때 아이템을 넣으면, 삽입 전 빈 자료구조를 생성한다.
-
모든 아이템을 삭제하면 키도 자동으로 삭제된다.(stream은 예외)
-
키가 없는 상태에서 읽기전용 커맨드(del, llen...) 를 수행하면 에러를 반환하는 대신 키가 있으나 아이템이 없는것처럼 동작한다.
-
키 전용 커맨드 : EXISTS, KEYS ( 글롭 패턴 으로 매칭 필터 가능), SCAN, SORT( list, set, sorted set에서만 사용 가능) , RENAME, RENAMEMX, COPY, TYPE, OBJECT, FLUSHALL, UNLINK, DEL, EXPIRE,
- KEYS는 위험한 커맨더이다. 잘못 실행하면 실행시간이 오래걸리기 때문. 조심하자 -> 특정 범위의 키만 조회할 수 있는 SCAN을 주로 사용하자!
- SCAN의 COUNT옵션을 이용하면 반환개수를 조정가능하지만, 메모리를 스캔하며 데이터가 저장된 형상에 따라 몇 개의 키를 더 읽는것이 효율적이라고 판단되면 1~2개의 키를 더 읽은뒤 함께 반환되기도 한다.
- FLUSHALL의 경우 기본적으로는 SYNC힌 방식으로 동작해서 다른 응답을 처리할 수 없지만, ASYNC옵션을 사용하면 백그라운드로 실행되고, 커맨드가 실행되었을 때 존재했던 키만 삭제해서 새로 생성된 키는 삭제되지 않는다.
- DEL은 동기적으로, UNLINK는 백그라운드로 실행되며 키와 연결된 데이터들의 연결을 끊는다. 따라서 키에 저장된 아이템이 많은 경우 UNLINK를 사용해서 데이터를 삭제하는 것이 좋다.
레디스의 활용사례
-
리더보드 : 주로 게임에서 스코어로 정렬돼 상위 경쟁자의 순위를 보여주는 용도
=> sorted set을 활용/ 주간스코어는 zuionstore활용해서 키별 데이터들을 더한다, weights옵션을 사용하여 가중치를 줄 수 있다. -
최근 검색 기록
=> sorted set활용/ zremrangebyrank 커맨드를 이용하면 일정개수 이상의 데이터가 저장되지 않도록 강제할 수 다. -
태그 기능
=> sorted set활용 / semembers커맨드를 활용하면 특정 태그를 갖고 있는 포스트를 쉽게 확인 할 있다, 집합 함수로도 조회가능. -
랜덤 데이터 추출
=> RANDOMKEY, HRANDFIELD -
데이터 카운팅
-
좋아요 처리하기
=> set -
읽지 않은 메시지 수 카운팅하기
=> 레디스와 같은 인메모리 데이터베이스에 일시적으로 저장한 뒤 필요한 시점에 한꺼번에 업데이트하는 방식을 사용한다. -
DAU(하루 동안 서비스에 방문한 사용자 수) 구하기
=> Set활용(but 너무 많은 값이 저장된다면.. 성능저하) => 비트맵을 사용하자. 특정 기간동안 방문한 사용자 등의 유저를 구하는 방식에 유리하다.