본 포스팅은 Java / Spring Boot 환경을 기준으로 작성되었다. 개념 자체는 언어에 무관하게 통용되지만, 코드 예시는 Java + Spring Boot 3.x 기준이다.
들어가며
백엔드 개발을 하다 보면 아래와 같은 상황을 마주할 수 있다.
서버의 CPU 사용률은 20%도 안 되는데, 요청은 타임아웃이 나고 있다.
직관적으로 느끼기에 이상하다. CPU는 한가한데 왜 느린가?
그 이유를 제대로 이해하려면 쓰레드(Thread) 와 CPU 코어(Core) 의 관계, 그리고 커넥션 풀(Connection Pool) 의 동작 원리를 함께 알아야 한다.
이것들은 개별적으로 외우는 지식이 아니라, 하나의 맥락으로 연결된 이야기다.
1. CPU 코어와 쓰레드
CPU 코어

이미지 출처 : https://blog.naver.com/techref/222254273021
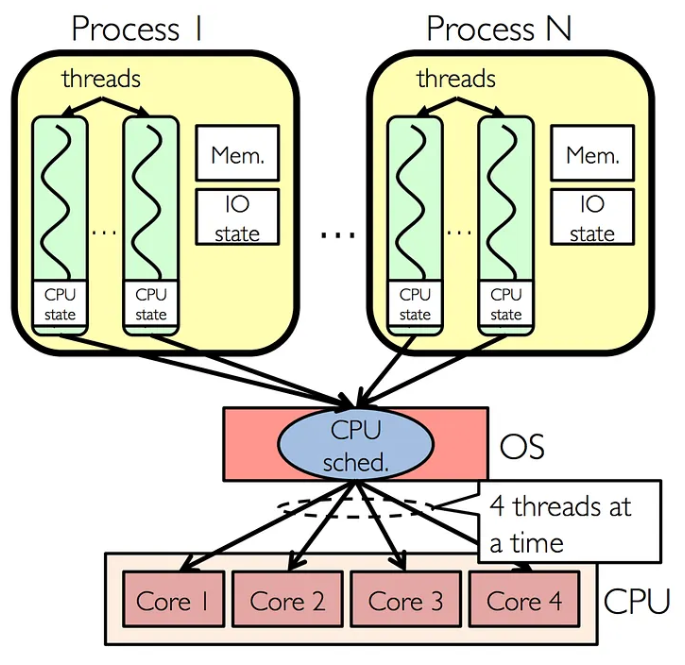
CPU 코어(Core)는 실제로 연산을 수행하는 물리적인 처리 단위다. 4코어 CPU는 물리적 코어 개수와 동일하게 동시에 4개의 작업을 수행할 수 있다.
[ CPU ]
 ├── Core 1  ← 실제 연산 단위
 ├── Core 2
 ├── Core 3
 └── Core 4
쓰레드
이미지 출처 : https://tarunjain07.medium.com/multi-vs-multi-cb9b0ec382ad
쓰레드(Thread)는 프로그램 내에서 실행되는 작업의 흐름 단위다. 하나의 프로세스 안에서 여러 쓰레드가 동시에 돌아갈 수 있다.
Java에서는 전통적으로 플랫폼 쓰레드(Platform Thread) 를 사용한다. 이것은 OS가 직접 관리하는 쓰레드로, 각각 약 1MB 내외의 스택 메모리를 소비한다.
핵심 관계 — 쓰레드 수 > 코어 수일 때
직관적으로 생각하면 "쓰레드가 많을수록 빠르다"고 느껴질 수 있다. 하지만 이건 절반만 맞는 이야기다.
코어 수보다 쓰레드 수가 많아지면, OS는 컨텍스트 스위칭(Context Switching) 을 통해 각 쓰레드에게 CPU 시간을 번갈아 나눠준다. 이 스위칭 자체가 오버헤드다.
[4코어 CPU, 100개 쓰레드 상황]

Core 1: Thread-1 실행 → Thread-5 실행 → Thread-23 실행 → ...
Core 2: Thread-2 실행 → Thread-8 실행 → Thread-31 실행 → ...
...

→ 코어는 4개인데 쓰레드 100개를 돌아가며 처리
→ 스위칭 비용이 누적됨
→ 쓰레드를 늘릴수록 오히려 느려질 수 있음
HikariCP 공식 Wiki에는 이런 문장이 있다.
"코어 수를 초과하는 쓰레드를 추가할수록 속도는 빠르지 않고 오히려 더 느려진다 (you're going slower by adding more threads, not faster)."
그렇다면 DB 작업에서는 어떻게 될까?
2. I/O 대기 — "쓰레드가 블로킹된다"는 게 무슨 말인가
DB 쿼리를 날리면 쓰레드는 결과가 올 때까지 그냥 기다린다 (Blocking). 이 시간 동안 CPU는 그 쓰레드를 위해 아무것도 하지 않는다. 즉, CPU 자원을 낭비하는 셈이다.
[쓰레드 A의 타임라인]

  ──── 요청 처리 ──── [DB 쿼리 전송] ──── 대기 대기 대기 ──── [결과 수신] ──── 응답 반환
                                          ↑
                                    CPU는 놀고 있음
이 대기 구간을 I/O Wait 라고 부른다. DB 디스크 읽기, 네트워크 응답 대기 등이 여기에 해당한다.
이 원리 덕분에 쓰레드 수를 코어 수보다 약간 더 늘려도 성능이 향상될 수 있다. 한 쓰레드가 I/O 대기 중일 때 다른 쓰레드가 CPU를 사용하면 되기 때문이다.
3. 그렇다면 "최적의 쓰레드(커넥션) 수"는?
HikariCP 공식 문서에서는 다음 공식을 제시한다.
connections = (CPU 코어 수 × 2) + 유효 스핀들 수(effective_spindle_count)- 스핀들(Spindle) : 물리적 하드디스크의 플래터(회전판) 수를 의미한다. SSD를 사용하면 1로 본다.
예시:
- 4코어 CPU + SSD →
(4 × 2) + 1 = 9 - 8코어 CPU + SSD →
(8 × 2) + 1 = 17
처음에는 이 숫자가 너무 작다고 느껴질 수 있다. 하지만 DB 쿼리가 효율적이라면, 실제로 적은 수의 커넥션이 매우 높은 처리량을 감당한다.
직관에 반하는 것처럼 보이지만, Oracle 실제 성능 그룹의 실험에서는 커넥션 수를 과도하게 늘렸을 때 오히려 처리량이 50배 차이나는 사례도 있다 (HikariCP Wiki 참고).
실제 개발 환경에서는 이 공식을 출발점으로 삼되, 모니터링을 통해 조정하는 방식이 현실적이다. 대부분의 웹 애플리케이션에서는 10 ~ 20 사이를 시작값으로 추천한다.
4. HikariCP란
개요
HikariCP (히카리CP, 일본어로 "빛"을 의미)는 Java 생태계에서 가장 널리 쓰이는 고성능 JDBC 커넥션 풀(Connection Pool) 라이브러리다.
- Spring Boot 2.x 이상에서 기본(default) 커넥션 풀로 내장되어 있다
- 별도 의존성 추가 없이
spring-boot-starter-data-jpa또는spring-boot-starter-jdbc포함 시 자동으로 활성화된다
커넥션 풀이 왜 필요한가
DB 커넥션을 요청마다 새로 만들면 아래 비용이 매번 발생한다:
- TCP 3-way 핸드셰이크
- DB 인증 (Authentication)
- 메모리 할당
- 세션 초기화
이 과정은 일반적으로 수십 ms ~ 수백 ms 수준의 오버헤드다. 커넥션 풀은 이 커넥션들을 미리 만들어 재사용함으로써 이 비용을 제거한다.
[풀 없이]                        [HikariCP 사용 시]

요청 → 커넥션 생성(비용 발생)     요청 → 풀에서 기존 커넥션 즉시 대여
     → 쿼리 실행                       → 쿼리 실행
     → 커넥션 종료                      → 커넥션 반납 (재사용됨)
5. HikariCP 주요 설정값
아래는 실제 개발 환경에서 반드시 이해해야 하는 핵심 파라미터들이다.
# application.yml (Spring Boot)

spring:
  datasource:
    hikari:
      # 풀의 최대 커넥션 수 (가장 중요한 값)
      # 기본값: 10 (Spring Boot 2.x 기준)
      # 공식: (CPU 코어 수 × 2) + 스핀들 수 를 출발점으로 사용
      maximum-pool-size: 10

      # 유휴 상태로 유지할 최소 커넥션 수
      # HikariCP 공식 권고: minimum-idle = maximum-pool-size (고정 풀 크기 권장)
      # 동적 풀은 예측 불가능한 성능 변화를 유발할 수 있음
      minimum-idle: 10

      # 풀에서 커넥션을 기다리는 최대 시간 (ms)
      # 이 시간 초과 시 SQLException 발생
      # 최솟값: 250ms / 기본값: 30000ms (30초)
      connection-timeout: 30000

      # 커넥션이 유휴 상태로 풀에 머물 수 있는 최대 시간 (ms)
      # minimum-idle < maximum-pool-size 일 때만 적용됨
      # 기본값: 600000ms (10분)
      idle-timeout: 600000

      # 커넥션의 최대 수명 (ms)
      # DB나 방화벽이 커넥션을 강제 종료하기 전에 미리 폐기하는 용도
      # 반드시 DB의 커넥션 타임아웃보다 몇 초 짧게 설정해야 함
      # 기본값: 1800000ms (30분)
      max-lifetime: 1800000

      # 커넥션이 살아있는지 주기적으로 확인하는 간격 (ms)
      # max-lifetime보다 반드시 작아야 함
      # 기본값: 120000ms (2분)
      keepalive-time: 120000

      # 커넥션 누수(Leak) 감지 임계값 (ms)
      # 이 시간 이상 커넥션이 반납되지 않으면 경고 로그 출력
      # 개발/스테이징 환경에서 설정 권장 (0 = 비활성화)
      leak-detection-threshold: 60000

      # 풀 이름 (모니터링 시 식별용)
      pool-name: MyAppPool
파라미터 관계 정리
keepalive-time < max-lifetime < DB의 실제 커넥션 타임아웃

예시 (PostgreSQL 기본 타임아웃 없음, RDS 기본 8시간 기준):
keepalive-time:  120,000ms (2분)
max-lifetime:    1,680,000ms (28분) ← DB 타임아웃보다 몇 분 짧게
6. 실제 프로젝트에 적용하기
Spring Boot 3.x 기본 설정 확인
spring-boot-starter-data-jpa만 포함해도 HikariCP는 자동으로 활성화된다. 별도 설정 없이도 동작하지만, 기본값은 보수적으로 설정되어 있어 트래픽이 늘어나면 튜닝이 필요하다.
<!-- pom.xml - 최신 버전 명시적 사용 시 (현재 기준 HikariCP 7.x) -->
<dependency>
    <groupId>com.zaxxer</groupId>
    <artifactId>HikariCP</artifactId>
    <version>7.0.0</version>
</dependency>
spring-boot-starter-data-jpa에 이미 포함되어 있으므로, 최신 버전을 직접 쓰고 싶을 때만 명시적으로 추가한다.
Java Config로 DataSource 직접 구성하기
application.yml 대신 코드로 설정할 수도 있다. 동적 설정이 필요하거나, 멀티 데이터소스 환경에서 자주 사용한다.
import com.zaxxer.hikari.HikariConfig;
import com.zaxxer.hikari.HikariDataSource;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

import javax.sql.DataSource;

@Configuration
public class DataSourceConfig {

    @Bean
    public DataSource dataSource() {
        HikariConfig config = new HikariConfig();

        // JDBC URL, 인증 정보
        config.setJdbcUrl("jdbc:postgresql://localhost:5432/mydb");
        config.setUsername("user");
        config.setPassword("password");

        // 드라이버 클래스 (대부분 자동 감지되지만 명시하면 더 안전)
        config.setDriverClassName("org.postgresql.Driver");

        // 풀 최대 크기 — CPU 공식 기반으로 계산
        int cores = Runtime.getRuntime().availableProcessors(); // JVM이 사용 가능한 코어 수
        int poolSize = (cores * 2) + 1; // 공식 적용 (SSD 환경)
        config.setMaximumPoolSize(Math.max(10, poolSize)); // 최소 10 보장

        // 고정 풀 사이즈 권장 (minimum-idle = maximum-pool-size)
        config.setMinimumIdle(Math.max(10, poolSize));

        // 커넥션 대기 타임아웃 (30초)
        config.setConnectionTimeout(30_000);

        // 최대 커넥션 수명 (28분 = DB 타임아웃보다 짧게)
        config.setMaxLifetime(1_680_000);

        // keepalive 주기 (2분, max-lifetime보다 짧아야 함)
        config.setKeepaliveTime(120_000);

        // 누수 감지 — 개발 환경에서 활성화 권장 (운영에서는 성능 고려하여 결정)
        config.setLeakDetectionThreshold(60_000);

        // 풀 이름 (로그, 모니터링 식별용)
        config.setPoolName("MainDBPool");

        return new HikariDataSource(config);
    }
}
커넥션 누수(Connection Leak)란
Connection Leak (커넥션 누수)은 커넥션을 가져갔지만 끝내 반납하지 않는 상황이다. 조용히 쌓이다가 풀이 고갈되면 그때서야 Connection is not available, request timed out 에러로 나타난다.
// ❌ 잘못된 예 — 예외 발생 시 커넥션이 반납되지 않을 수 있음
Connection conn = dataSource.getConnection();
Statement stmt = conn.createStatement();
stmt.execute("SELECT ...");
conn.close(); // 예외가 중간에 발생하면 이 줄은 실행되지 않음

// ✅ 올바른 예 — try-with-resources로 자동 반납 보장
try (Connection conn = dataSource.getConnection();
     Statement stmt = conn.createStatement()) {
    stmt.execute("SELECT ...");
} // 블록을 벗어나면 conn.close() 자동 호출 → 커넥션 풀에 반납됨
Spring의 JPA / JdbcTemplate 등을 사용하면 대부분 자동으로 처리되지만, 직접 DataSource를 다루는 경우 반드시 try-with-resources를 활용해야 한다.
7. 모니터링 — 설정했으면 반드시 들여다봐야 한다
HikariCP는 Micrometer (메트릭 수집 라이브러리)를 통해 지표를 외부에 노출할 수 있다.
# application.yml — Prometheus 메트릭 노출 설정
management:
  endpoints:
    web:
      exposure:
        include: health, metrics, prometheus
  metrics:
    tags:
      application: my-app  # 메트릭에 애플리케이션 이름 태그 추가 (Grafana 등에서 필터링 용도)
주요 모니터링 지표:
| 지표 이름 | 설명 | 확인 기준 |
|---|---|---|
hikaricp_connections_active | 현재 사용 중인 커넥션 수 | 최대치에 가까우면 풀 증설 검토 |
hikaricp_connections_pending | 커넥션을 대기 중인 쓰레드 수 | 0이 이상적 |
hikaricp_connection_acquired_seconds | 커넥션 획득에 걸린 시간 | 수백 ms 이상이면 이상 징후 |
hikaricp_connections_timeout_total | 타임아웃으로 실패한 총 횟수 | 0이어야 정상 |
8. Virtual Threads
이 내용은 Java 21+ 및 Spring Boot 3.2+ 기준이다. 레거시 환경(Java 8/11, Spring Boot 2.x)에는 해당하지 않으므로 참고만 할 것.
Java 21에서 가상 쓰레드(Virtual Threads, Project Loom) 가 정식 출시되었다. Spring Boot 3.2부터는 단 한 줄로 활성화할 수 있다.
# application.yml — Virtual Threads 활성화 (Spring Boot 3.2+, Java 21+)
spring:
  threads:
    virtual:
      enabled: true
가상 쓰레드는 JVM이 관리하는 경량 쓰레드다. 플랫폼 쓰레드 1개당 약 1MB를 쓰는 것과 달리, 수백만 개를 동시에 유지할 수 있다. I/O 대기 상태에서 OS 쓰레드를 점유하지 않기 때문에 동시성이 크게 향상된다.
중요 주의사항 — 가상 쓰레드와 HikariCP
가상 쓰레드를 활성화해도 DB 커넥션 수는 그대로 다. 가상 쓰레드가 아무리 많아도 HikariCP의 커넥션 풀 크기가 20이라면, 21번째 요청은 커넥션을 기다린다.
[ 잘못된 기대 ]
가상 쓰레드 10,000개 → 커넥션도 10,000개 생성됨 ← 틀림

[ 실제 동작 ]
가상 쓰레드 10,000개 → 커넥션 풀(예: 20개)에서 대기
                      → 쓰레드는 블로킹 상태로 대기하지만
                        OS 쓰레드를 점유하지 않으므로 효율적으로 대기 가능
추가로, 현재(2025~2026년 기준) HikariCP와 가상 쓰레드를 함께 쓸 때 synchronized 블록에서의 Thread Pinning 이슈가 일부 환경에서 보고된 바 있다. Java 24의 JEP 491이 이를 개선했으나 완전히 해결된 것은 아니므로, 도입 전에는 반드시 부하 테스트를 수행하는 것이 권장된다.
가상 쓰레드는 레거시 플랫폼 쓰레드 환경을 당장 전환해야 할 기술은 아니다. 기존 시스템이 안정적으로 동작한다면 무리하게 도입할 필요는 없고, 신규 프로젝트 또는 동시 요청 수가 많은 I/O 집약적인 서비스에서 도입을 검토하는 것이 현실적이다.
9. 정리 — 세 가지가 연결되는 구조
HTTP 요청 수신
    ↓
[Tomcat 쓰레드 풀] ← 여기서 CPU 코어 수와 관계
    ↓
비즈니스 로직 처리
    ↓
[HikariCP 커넥션 풀] ← 여기서 DB 처리량 결정
    ↓
DB 쿼리 실행
    ↓
응답 반환- CPU 코어 수가 적은데 쓰레드가 너무 많으면 → 컨텍스트 스위칭 오버헤드
- HikariCP 풀이 너무 작으면 → 커넥션 대기로 타임아웃 발생
- HikariCP 풀이 너무 크면 → DB 서버가 오히려 과부하 (Too many connections)
- 이 두 값을 CPU 코어 수 기준 공식으로 맞추면 → 불필요한 낭비 없이 최대 처리량 달성
처음에 언급했던 "CPU 20%인데 타임아웃이 난다"는 상황은 대부분 HikariCP 풀이 소진된 상태에서 쓰레드들이 커넥션을 기다리며 블로킹되어 있는 경우다. CPU는 일이 없어 쉬고 있고, 쓰레드들은 커넥션을 기다리며 줄 서 있는 것이다.
마치며
쓰레드, 코어, 커넥션 풀은 각각 독립적인 개념처럼 보이지만, 백엔드 서버의 성능은 이 셋이 균형을 이룰 때 비로소 제대로 발휘된다. 처음에는 공식과 설정값만 외우는 것처럼 느껴질 수 있지만, 그 이면에 있는 "왜"를 이해하고 나면 설정 하나하나가 다르게 보인다.
모니터링 없는 튜닝은 의미가 없다. 설정하고 → 부하를 주고 → 지표를 보고 → 조정하는 사이클을 반복하는 것이 실력이 되는 가장 빠른 길이다.
참고 자료
- HikariCP GitHub — Official Documentation
- HikariCP Wiki — About Pool Sizing
- Baeldung — Configuring HikariCP with Spring Boot 3
- OneUptime — How to Tune HikariCP for Maximum Throughput (Jan 2026)
- Medium — Exploring the Hikari Connection Pool Configuration (Jan 2025)
- Spring Blog — Embracing Virtual Threads
- Virtual Threads + HikariCP Java 24 Analysis (Jun 2025)
- javathinking.com — Default maximumPoolSize for HikariCP in Spring Boot