🌟 개요
AI Agent 실습 프로젝트에서 나는 DB 구축을 맡게 되었다. 스터디 멘토님께서 Knowledge Graph에 대해 찾아보고, Neo4j를 활용해 보라고 조언해 주셨다.
문제는 DB 구축 자체가 처음이었다는 것이다. SQL 기반의 관계형 DB는 학습한 적이 있었지만 실제로 프로젝트에 직접 구축해본 경험은 없었고, 그 상황에서 일반적인 관계형 DB도 아닌 그래프 DB인 Neo4j를 다뤄야 했다.
그래서 Claude Code의 도움을 받아 DB를 구축하게 되었는데, Claude Code는 Neo4j 외에도 SQLite와 ChromaDB까지 총 3개의 DB를 함께 사용하는 방식으로 구현했다.
이 코드를 본 멘토님께서 Neo4j 하나로 다 해결할 수 있는데 굳이 왜 DB를 3개로 나눈건지 여쭤보셨다.
사실 나는 왜 3개가 필요한지, Neo4j만으로는 왜 안 되는지조차 제대로 이해하지 못한 채 코드를 사용하고 있었다. 그래서 다시 Claude Code의 도움을 받아 3개의 DB를 Neo4j 하나로 통합하는 작업을 진행했다.
이 글은 그 과정에 대한 기록이다. 단순히 코드를 바꾼 것으로 끝내지 않고, SQLite·ChromaDB·Neo4j가 각각 어떤 DB인지, 기존 프로젝트에서 어떤 역할을 했는지, 그리고 왜 Neo4j 하나로 통합이 가능했는지를 제대로 이해하고 넘어가고자 한다.
🌟 사용했던 DB 소개
🗄️ SQLite
- 한 줄 정의: 파일 하나로 동작하는 경량 관계형 데이터베이스
- 개요
- SQLite는 서버 없이 로컬 파일(
.db) 하나에 모든 데이터를 저장하는 관계형 DB이다. - 별도의 DB 서버를 설치하거나 실행할 필요 없이, 파일만 있으면 바로 SQL을 사용할 수 있다.
- 스마트폰 앱, 브라우저, 데스크탑 소프트웨어 등 어디서나 내장 DB로 널리 쓰인다.
- SQLite는 서버 없이 로컬 파일(
- 데이터 저장 방식
- 관계형 DB답게 데이터를 테이블(행과 열) 형태로 저장한다.
influencers 테이블 | id | name | categories | engagement_rate | |----|--------|-----------------|-----------------| | 1 | 홍길동 | ["뷰티", "패션"] | 0.05 | | 2 | 김철수 | ["테크"] | 0.08 | - 데이터 간의 관계는 외래키(Foreign Key)로 연결하고, SQL로 조회한다.
SELECT * FROM influencers WHERE engagement_rate > 0.05;
- 관계형 DB답게 데이터를 테이블(행과 열) 형태로 저장한다.
- 장점
- 설치·설정이 거의 없음 (파일 하나로 끝)
- SQL 표준을 지원해서 학습 자료가 풍부함
- 가볍고 빠름 (소규모 데이터에 최적)
- 로컬 개발·프로토타입에 적합
- 단점
- 동시 접속(멀티 유저) 환경에 취약
- 대용량 데이터에 부적합
- 복잡한 관계 분석이 어려움
- 사용 시나리오
- 정형화된 데이터를 정확하게 저장하고, 키워드 기반으로 빠르게 조회할 때
- 프로토타입이나 소규모 프로젝트의 메인 DB로 적합하다.
🗄️ ChromaDB
- 한 줄 정의: 텍스트의 "의미"를 숫자 벡터로 변환해서 저장하는 벡터 데이터베이스
- 개요
- ChromaDB는 벡터 데이터베이스(Vector DB)이다.
- 일반 DB가 텍스트를 그대로 저장하는 것과 달리, 텍스트를 임베딩(Embedding)이라는 과정을 거쳐 수백~수천 개의 숫자 배열(벡터)로 변환한 뒤 저장한다.
- 이 벡터는 텍스트의 의미를 수치로 표현한 것이다.
- AI/LLM 관련 프로젝트에서 시맨틱 검색과 RAG(Retrieval-Augmented Generation) 구현에 많이 사용된다.
- 데이터 저장 방식
- 텍스트를 임베딩 모델에 통과시켜 벡터로 변환한 뒤, 원본 텍스트·메타데이터와 함께 저장한다.
"20대 여성 타겟 친환경 화장품 인플루언서" ↓ 임베딩 모델 (bge-m3) [0.231, -0.847, 0.103, 0.562, ...] ← 1024개의 숫자 - 검색할 때도 쿼리를 벡터로 변환한 뒤, 저장된 벡터들과 코사인 유사도를 계산해서 가장 가까운 것을 반환한다.
"친환경 뷰티"라고 검색하면
→ "친환경 뷰티"의 벡터와 가장 유사한 벡터를 가진 문서 반환
→ 키워드가 하나도 안 겹쳐도 의미가 비슷하면 검색됨
- 텍스트를 임베딩 모델에 통과시켜 벡터로 변환한 뒤, 원본 텍스트·메타데이터와 함께 저장한다.
- 장점
- 키워드가 정확히 일치하지 않아도 의미 기반으로 검색 가능
- 자연어 쿼리(예: "MZ세대 감성 피부케어 인플루언서")로 검색 가능
- LlamaIndex, LangChain 등 AI 프레임워크와 연동이 쉬움
- 로컬 파일로 영구 저장 가능 (
PersistentClient)
- 단점
- 로컬 파일로 저장되므로 서버 배포 시 관리가 번거로움
- 정확한 값 조회(ID로 특정 데이터 찾기 등)에는 부적합
- 임베딩 생성에 시간과 연산 비용이 듦
- 데이터가 바뀌면 인덱스를 다시 빌드해야 함
- 사용 시나리오
- 자연어 쿼리로 의미 기반 검색이 필요할 때
- "이 광고 컨셉과 가장 비슷한 과거 사례를 찾아줘"처럼 키워드가 아닌 의미로 검색해야 할 때 적합하다.
🗄️ Neo4j
- 한 줄 정의: 데이터를 노드와 관계로 저장하는 그래프 데이터베이스
- 개요
- Neo4j는 그래프 데이터베이스(Graph DB)이다.
- 데이터를 테이블이 아닌 노드(Node, 점)와 관계(Relationship, 선)로 표현한다.
- 사람과 사람 사이의 관계, 상품과 카테고리 사이의 연결처럼 데이터 간의 관계 자체가 중요한 도메인에서 강력하다.
- 소셜 네트워크, 추천 시스템, Knowledge Graph 구축에 많이 쓰인다.
- 데이터 저장 방식
- 모든 데이터는 노드와 관계로 표현된다.
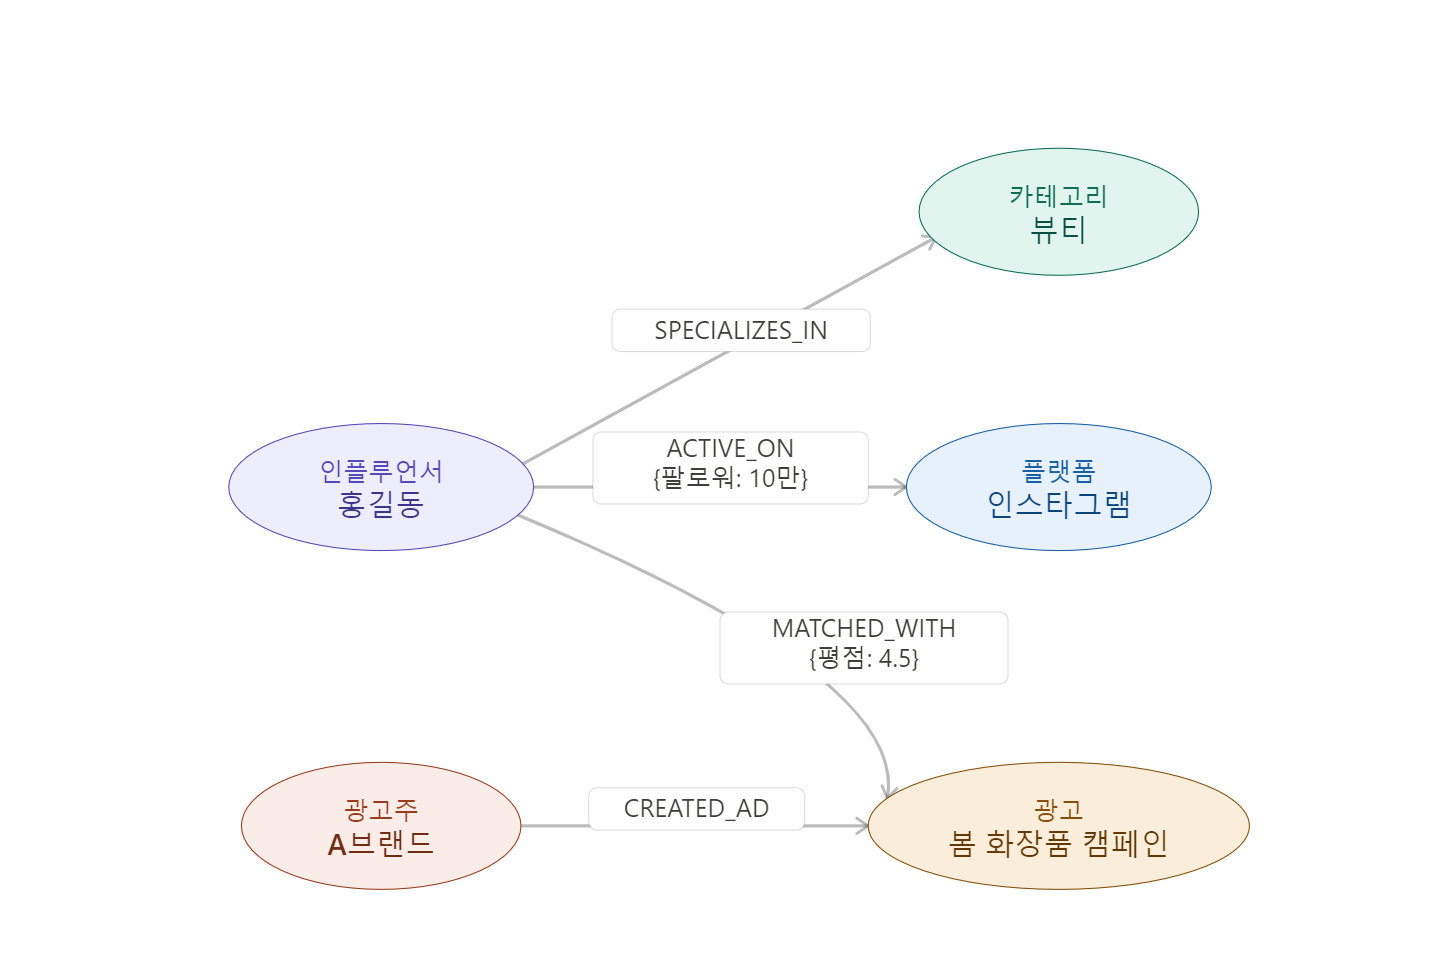
- 조회는 Cypher라는 Neo4j 전용 쿼리 언어를 사용한다.
-- 뷰티 카테고리 인플루언서 중 과거 광고 평점이 4점 이상인 사람 찾기 MATCH (i:Influencer)-[:SPECIALIZES_IN]->(c:Category {name: "뷰티"}) MATCH (i)-[m:MATCHED_WITH]->(ad:Advertisement) WHERE m.rating >= 4.0 RETURN i.name, m.rating - SQL의
JOIN으로 여러 테이블을 엮는 것과 달리, 그래프는 관계를 따라 자연스럽게 탐색한다.
- 모든 데이터는 노드와 관계로 표현된다.
-
Neo4j의 3가지 핵심 기능
기능 설명 그래프 저장 노드·관계 기반 데이터 저장 및 Cypher 쿼리 Knowledge Graph 개체 간 관계를 LLM이 이해할 수 있도록 구조화 Vector Index(5.11+) 벡터 임베딩 저장 및 시맨틱 유사도 검색 ❗ 특히 Vector Index는 5.11 버전 이후 추가된 기능으로, ChromaDB처럼 임베딩 벡터를 저장하고 유사도 검색을 할 수 있다. 이 기능 덕분에 ChromaDB를 따로 쓸 필요가 없어졌다.
- 장점
- 복잡한 관계 탐색이 SQL보다 직관적이고 빠름
- Knowledge Graph 구축에 최적화
- Vector Index로 시맨틱 검색까지 지원 (5.11+)
- AuraDB를 통해 클라우드 환경 제공
- 그래프 시각화 도구 내장
- 단점
- 학습 곡선이 있음 (Cypher 쿼리 언어 별도 학습 필요)
- 단순한 CRUD만 필요한 경우엔 오버스펙
- 대용량 단순 데이터 처리는 관계형 DB보다 느릴 수 있음
- 사용 시나리오
- 데이터 간의 관계가 중요할 때
- "이 인플루언서와 비슷한 카테고리에서 활동하며, 과거에 좋은 평점을 받은 인플루언서는 누구인가?"처럼 여러 단계의 관계를 따라가며 분석해야 할 때 진가를 발휘한다.
🗄️ 세 DB 한눈에 비교
| SQLite | ChromaDB | Neo4j | |
|---|---|---|---|
| 분류 | 관계형 DB | 벡터 DB | 그래프 DB |
| 저장 단위 | 행 (Row) | 벡터 (임베딩) | 노드, 관계 |
| 검색 방식 | 키워드 일치 | 의미 유사도 | 관계 탐색 |
| 쿼리 언어 | SQL | Python API | Cypher |
| 강점 | 정형 데이터 CRUD | 자연어 시맨틱 검색 | 관계 분석, kG |
| 저장 위치 | 로컬 파일 | 로컬 파일 | 클라우드 or 로컬 |
🌟 수정 전: 프로젝트에서 3개 DB의 쓰임
이 프로젝트는 광고주가 광고 컨셉과 아이템을 입력하면, AI Agent가 DB에서 최적의 인플루언서를 검색해 추천해주는 시스템이다.
수정 전에는 SQLite, ChromaDB, Neo4j가 각자 다른 역할을 맡아 함께 동작했다.
🗄️ SQLite - 인플루언서 원본 데이터 저장소
- 역할
- 정형 데이터의 단일 진실 공급원(Source of Truth)
- 50명의 인플루언서 데이터를
influencers테이블 하나에 저장했다. 모든 인플루언서 정보의 원본이 여기에 있었다.
- 저장 데이터
influencers 테이블
 - id, name, email
 - categories (JSON)       예: ["뷰티", "패션"]
 - platforms (JSON)        예: {"인스타그램": 80000, "유튜브": 20000}
 - base_price_amount       기본 광고 단가
 - engagement_rate         참여율
 - description             프로필 설명
 - is_active, created_at
-
사용되는 시점
Agent의 5개 기본 Tool이 SQLite를 직접 조회했다.Tool SQLite 쿼리 search_influencers_by_category카테고리 이름으로 필터링 search_influencers_by_platform플랫폼 이름으로 필터링 search_influencers_by_followers팔로워 범위로 필터링 get_influencer_detailsID로 단일 조회 calculate_match_score전체 목록 조회 후 점수 계산
- 한계
- 키워드가 정확히 일치해야만 검색된다.
- "친환경 뷰티"로 검색하면 DB에 "친환경"이라는 카테고리가 없을 경우 결과가 없다.
- 자연어 의미 기반 검색이 불가능하다.
🗄️ ChromaDB - 시맨틱 검색용 벡터 저장소
- 역할
- 자연어 의미 기반 검색
- SQLite의 키워드 한계를 보완하기 위해 존재했다.
- 텍스트를 벡터로 변환해 저장해두고, 자연어 쿼리가 들어오면 의미적으로 가장 유사한 결과를 반환했다.
- 로컬 파일(
./chroma_db/)에 저장되었으며, 총 3개의 컬렉션을 운영했다.
- 컬렉션 1:
influencer_profiles- 저장 데이터: 인플루언서 프로필을 자연어 문장으로 변환한 임베딩
- 예시 문장: "홍길동: 뷰티/패션 전문 인플루언서. 카테고리: 뷰티, 패션. 플랫폼: 인스타그램. 팔로워: 10000명. 참여율: 0.05"
- 사용 Tool:
semantic_search_influencers - 사용 시점: "MZ세대 감성 피부케어 인플루언서 찾아줘"처럼 카테고리 이름을 정확히 모를 때
- 컬렉션 2:
match_history- 저장 데이터: Neo4j에서 읽어온 과거 매칭 이력 임베딩
PROMOTED관계: 실제 광고 진행 이력 + 좋아요/댓글/조회수MATCHED_WITH관계: 캠페인 계약 이력 + 평점
- 사용 Tool:
analyze_match_history,search_similar_campaigns - 사용 시점: "뷰티 브랜드 광고에서 성과가 좋았던 인플루언서 찾아줘"처럼 과거 실적 기반 추천이 필요할 때
- 저장 데이터: Neo4j에서 읽어온 과거 매칭 이력 임베딩
- 컬렉션 3:
notion_ad_campaigns- 저장 데이터: Notion에서 수집한 실제 광고 캠페인 CSV 데이터 임베딩 (인플루언서명, 광고주, 제품, 컨셉 키워드, 성과 수치 등)
- 사용 Tool:
search_notion_ad_data - 사용 시점: 실제 집행된 광고 캠페인 원본 데이터를 자연어로 검색할 때
- 한계
- 로컬 파일로 저장되기 때문에 서버에 배포하려면 파일도 함께 관리해야 한다.
- ChromaDB를 위해 별도의 인덱스 빌드 과정이 필요하다.
🗄️ Neo4j - 관계 그래프 저장소
- 역할
- 인플루언서·광고·광고주 간의 관계 분석
- 단순한 데이터 저장을 넘어, 엔티티 간의 관계 자체를 저장하고 탐색했다.
- 누가 누구와 협업했는지, 어떤 카테고리에서 활용하는지 등의 관계 데이터를 그래프로 표현했다.
- 노드(Node) 구조
 - Influencer   : id, name, email, engagement_rate, base_price_amount
 - Advertiser   : id, name, industry, total_budget
 - Advertisement: id, title, concept, item, budget, status
 - Category     : name
 - Platform     : name
- 관계(Relationship) 구조
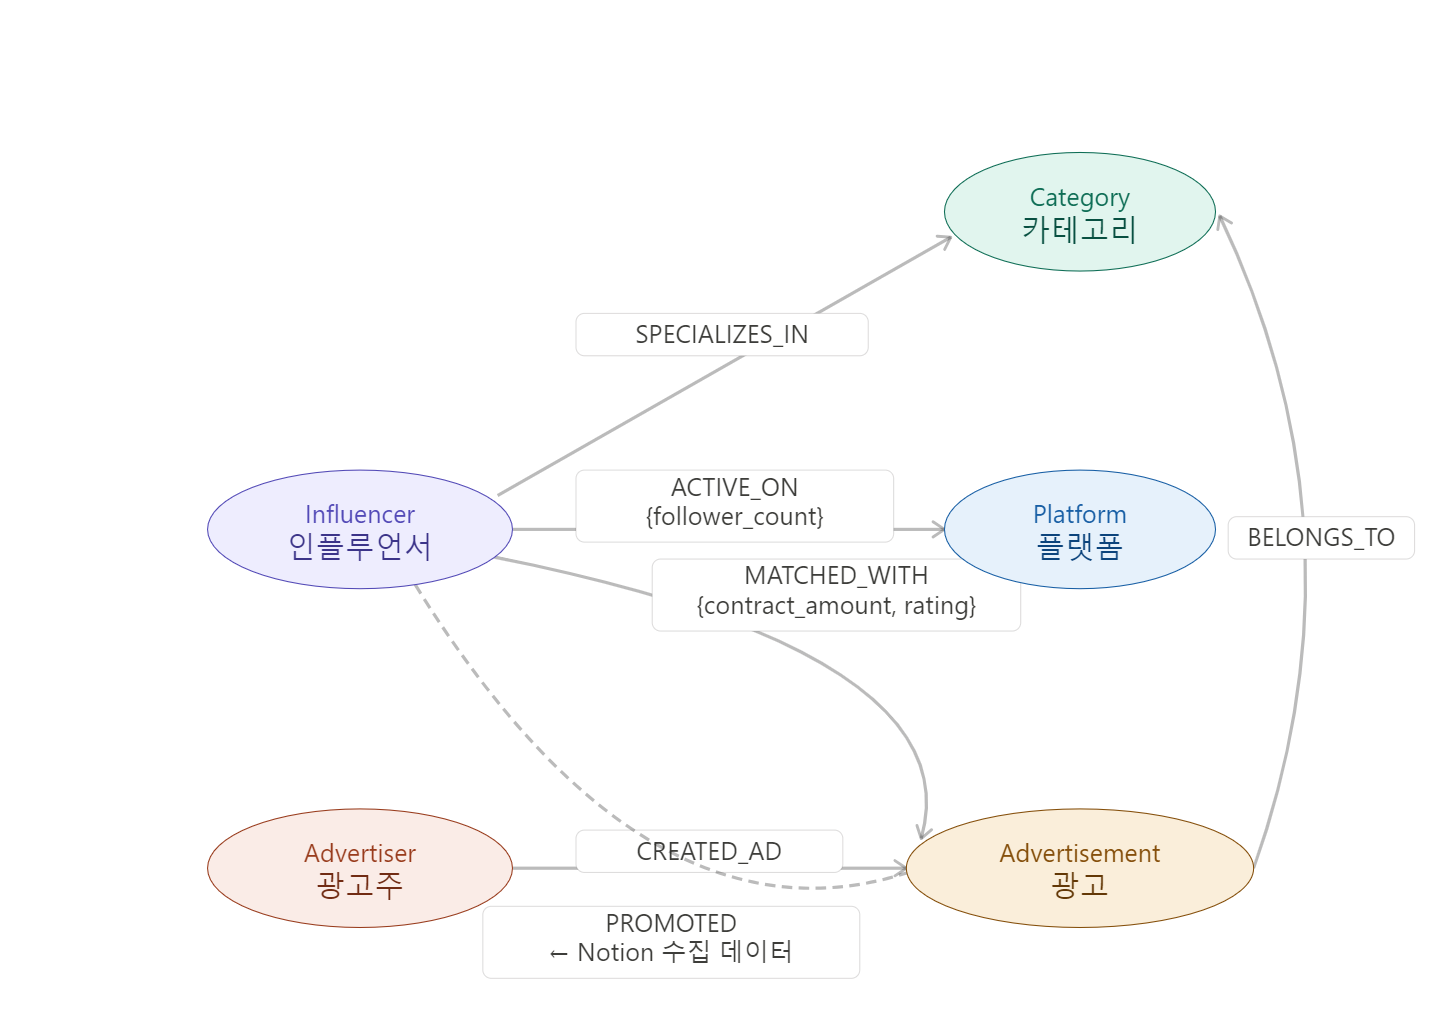
-
사용되는 시점
Tool Neo4j 역할 find_similar_influencers같은 카테고리/플랫폼 공유 인플루언서 탐색 find_best_match_for_ad광고 조건에 맞는 인플루언서 그래프 탐색 get_influencer_ad_historyMATCHED_WITH 관계 따라 과거 캠페인 조회 query_kg_natural_language자연어를 Cypher로 변환해 그래프 탐색 ❗ 추가로 ChromaDB의 데이터 소스 역할도 했다.
match_history컬렉션을 빌드할 때 Neo4j에서PROMOTED,MATCHED_WITH관계 데이터를 읽어와 임베딩했다.
🗄️ 수정 전 전체 데이터 흐름
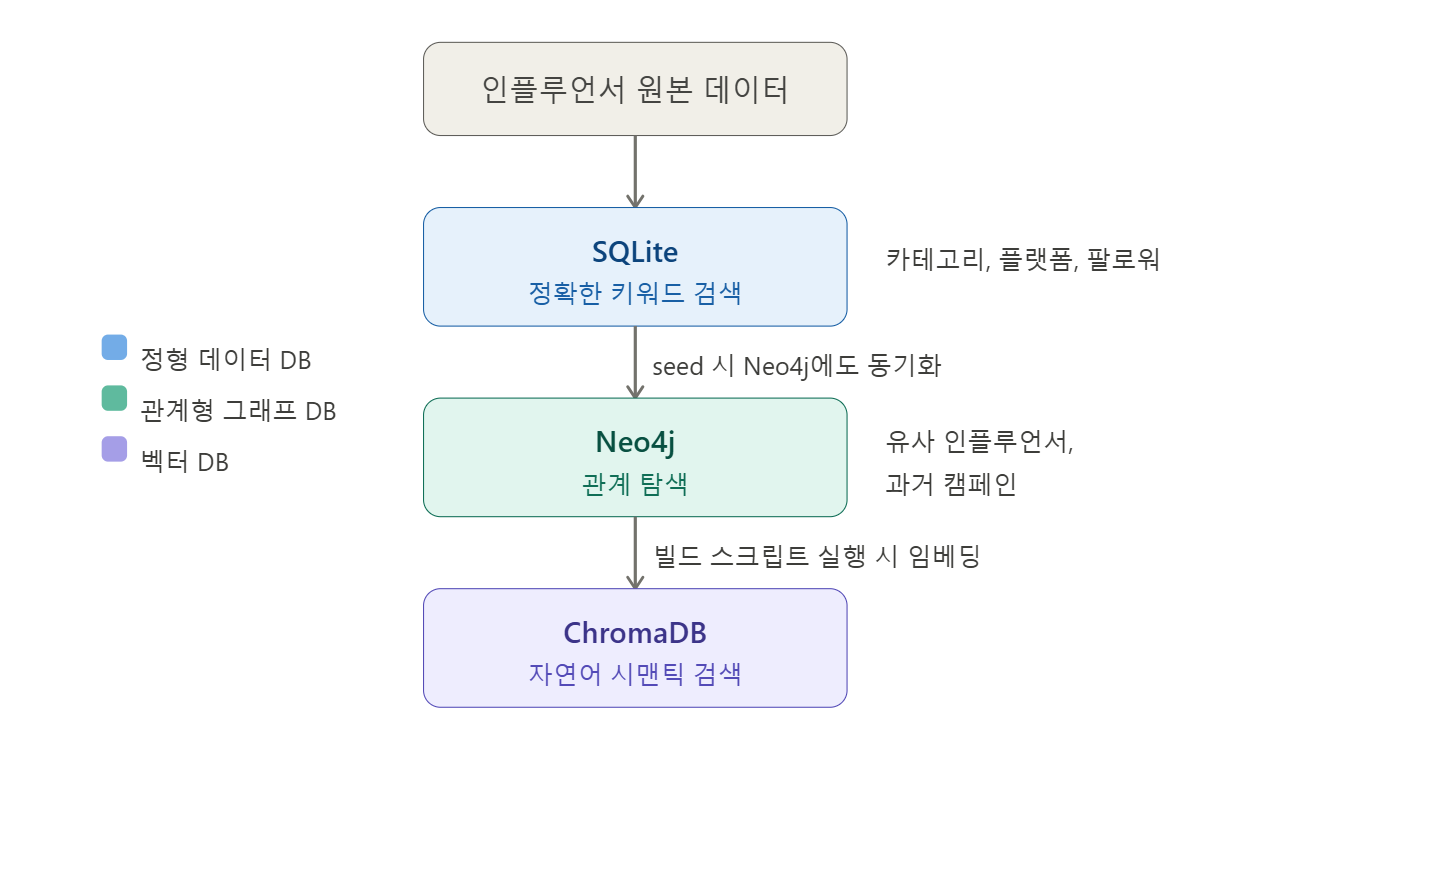
-
역할 분담 요약
DB 담당 영역 검색 방식 SQLite 인플루언서 정형 데이터 저장·조회 키워드 일치 ChromaDB 자연어 의미 기반 시맨틱 검색 벡터 유사도 Neo4j 인플루언서·광고·광고주 관계 분석 그래프 탐색 이처럼 각 DB가 서로 다른 역할을 맡고 있었지만, 이는 곧 세 가지 DB를 모두 유지·관리해야 한다는 복잡성을 의미하기도 했다.
🌟 Neo4j 하나로 통합한 이유
수정 전 구조에서 가장 큰 문제는 복잡성이었다.
세 가지 DB가 각자 다른 역할을 맡고 있었기 때문에, 유지보수 측면에서 신경 써야 할 것이 많았다.
- SQLite 데이터가 바뀌면 Neo4j에도 동기화해야 한다.
- ChromaDB는 로컬 파일(
./chroma_db/)로 저장되기 때문에 서버 배포 시 파일 관리가 따로 필요하다. - 세 DB의 연결 설정과 의존성을 모두 따로 관리해야 한다.
멘토님께서 "굳이 왜 3개의 DB를 사용하냐"고 하셨을 때, 나는 그 이유를 제대로 설명할 수 없었다. 실제로 Neo4j가 이미 두 가지 기능을 모두 지원하고 있었기 때문이다.
🤔 Neo4j가 SQLite를 대체할 수 있는 이유
SQLite가 담당하던 역할은 인플루언서 정형 데이터의 저장 및 조회였다.
Neo4j는 그래프 DB이지만, 노드에 일반 속성(이름, 이메일, 참여율 등)을 얼마든지 저장할 수 있다.
관계형 DB의 행(row) 하나가 Neo4j에서는 노드 하나에 대응된다.
-- SQLite의 INSERT와 동일한 역할
CREATE (i:Influencer {
    id: "uuid",
    name: "홍길동",
    engagement_rate: 0.05,
    base_price_amount: 500000
})
이미 인플루언서 노드가 Neo4j에 존재하고 있었기 때문에, SQLite 없이도 동일한 데이터를 조회할 수 있다.
🤔 Neo4j가 ChromaDB를 대체할 수 있는 이유
ChromaDB가 담당하던 역할은 벡터 임베딩 저장과 시맨틱 유사도 검색이었다.
Neo4j는 5.11 버전부터 Vector Index 기능을 공식 지원한다. 노드의 속성으로 임베딩 벡터를 저장하고, 코사인 유사도 기반의 시맨틱 검색을 할 수 있다. ChromaDB가 하던 일을 그대로 할 수 있다는 뜻이다.
-- Neo4j Vector Index 생성
CREATE VECTOR INDEX influencer_vector_idx
FOR (n:InfluencerEmbedding) ON n.embedding
OPTIONS {indexConfig: {`vector.dimensions`: 1024, `vector.similarity_function`: 'cosine'}}
현재 프로젝트에서 사용 중인 AuraDB가 Neo4j 5.27 버전임을 확인했고, Vector Index를 실제로 생성해서 동작도 확인했다. ChromaDB를 제거할 조건이 충족된 것이다.
🤗 최종 정리
| 역할 | 기존 담당 | Neo4j 대체 기능 |
|---|---|---|
| 정형 데이터 저장·조회 | SQLite | 노드(Node) 속성 저장 + Cypher 쿼리 |
| 시맨틱 유사도 검색 | ChromaDB | Vector Index (5.11+) |
| 관계 분석 | Neo4j | Neo4j (기존 유지) |
SQLite가 하던 일도, ChromaDB가 하던 일도 Neo4j 안에서 모두 처리할 수 있다. 굳이 세 개의 DB를 따로 유지할 이유가 없었던 것이다.
DB를 하나로 줄이면 연결 설정, 데이터 동기화, 인덱스 빌드 등 관리 포인트가 자연스럽게 줄어든다. 코드도 단순해지고, 배포 환경에서도 Neo4j 하나만 신경 쓰면 된다.
🌟 코드 수정 과정
🤔 패키지 교체 (requirements.txt)
requirements.txt에서 ChromaDB 관련 패키지를 제거하고, Neo4j Vector Store 패키지를 추가하였다.
# 제거
chromadb>=0.5.0
llama-index-vector-stores-chroma>=0.5.0

# 추가
llama-index-vector-stores-neo4jvector>=0.5.0
🤔 ChromaDB → Neo4j Vector Index
ChromaDB를 사용하던 파일이 총 3개였다.
influencer_index.py- 인플루언서 프로필 시맨틱 검색match_history_index.py- 과거 매칭 이력 RAG 검색notion_csv_index.py- Notion CSV 광고 데이터 검색
세 파일 모두 변경 패턴이 동일하므로, influencer_index.py의 수정 과정만 서술한다.
-
생성자 변경
# 수정 전 - ChromaDB (로컬 파일) def __init__(self, persist_path: str = "./chroma_db"): self._chroma_client = chromadb.PersistentClient(path=persist_path) self._collection = self._chroma_client.get_or_create_collection("influencer_profiles") self._vector_store = ChromaVectorStore(chroma_collection=self._collection) # 수정 후 - Neo4j Vector (클라우드) def __init__(self, neo4j_uri: str, neo4j_username: str, neo4j_password: str): self._vector_store = Neo4jVectorStore( username=neo4j_username, password=neo4j_password, url=neo4j_uri, embedding_dimension=1024, # bge-m3 차원 수 index_name="influencer_vector_idx", # Neo4j에 생성될 Vector Index 이름 node_label="InfluencerEmbedding", # 저장될 노드 레이블 )persist_path(로컬 파일 경로) 대신 Neo4j 접속 정보(URI, 사용자명, 비밀번호)를 받도록 바뀌었다.
embedding_dimension=1024는 사용 중인 임베딩 모델인bge-m3의 출력 차원 수이다. 모델마다 고정된 값이 있고, 이 값을 잘못 지정하면 인덱스 생성 시 오류가 난다.
-
reset()변경# 수정 전 - ChromaDB 컬렉션 삭제 def reset(self): self._chroma_client.delete_collection("influencer_profiles") self._collection = self._chroma_client.get_or_create_collection("influencer_profiles") self._vector_store = ChromaVectorStore(chroma_collection=self._collection) self._index = None # 수정 후 - Neo4j 노드 삭제 (Cypher) def reset(self): driver = GraphDatabase.driver(self._neo4j_uri, auth=(...)) with driver.session() as session: session.run("MATCH (n:InfluencerEmbedding) DETACH DELETE n") driver.close() self._vector_store = Neo4jVectorStore(...) self._index = NoneChromaDB는 Python API(
delete_collection)로 초기화했지만, Neo4j는 Cypher 쿼리로 해당 레이블의 노드를 전부 삭제하는 방식으로 바뀌었다.
DETACH DELETE는 노드와 연결된 관계까지 함께 삭제하는 Cypher 구문이다.
build_index(),retrieve(),query()는 변경 없음
이 세 메서드는 코드를 전혀 건드리지 않았다. LlamaIndex의VectorStoreIndex가 내부적으로 어떤 벡터 저장소를 쓰는지 추상화해주기 때문에, 저장소가 ChromaDB에서 Neo4j로 바뀌어도 상위 코드는 동일하게 동작한다.🗝️ 핵심: VectorStoreIndex가 저장소를 직접 다루지 않는다.
코드 구조를 보면,
# build_index() - 어떤 vector_store든 동일한 코드 storage_context = StorageContext.from_defaults(vector_store=self._vector_store) self._index = VectorStoreIndex.from_documents(documents, storage_context=storage_context) # retrieve() - 어떤 vector_store든 동일한 코드 index = self.get_index() retriever = index.as_retriever(similarity_top_k=top_k) nodes = retriever.retrieve(query_text)VectorStoreIndex는self._vector_store가 ChromaDB인지 Neo4j인지 전혀 모른다. 그냥 "벡터 저장소"라는 인터페이스로만 다룬다.
나머지 두 파일(match_history_index.py, notion_csv_index.py)도 동일한 패턴으로 수정했다. 노드 레이블과 인덱스 이름만 다르다.
| 파일 | 노드 레이블 | Vector Index 이름 |
|---|---|---|
influencer_index.py | InfluencerEmbedding | influencer_vector_idx |
match_history_index.py | MatchRecord | match_record_vector_idx |
notion_csv_index.py | NotionCampaign | notion_campaign_vector_idx |
🤔 SQLite → Neo4j
가장 큰 변경이었다. SQLite 리포지토리를 대체하는 Neo4j 리포지토리를 새로 만들어야 했다.
이 프로젝트는 헥사고날 아키텍처(Ports & Adapters)를 사용하고 있었다. Agent Tool 5개는 SQLite 클래스를 직접 참조하는 게 아니라, InfluencerRepositoryPort라는 추상 인터페이스에만 의존하고 있었다.
# search_tools.py - Tool은 인터페이스 타입만 받음
def create_search_by_category_tool(repo: InfluencerRepositoryPort):
    @tool
    def search_influencers_by_category(...):
results = repo.find_by_categories(categories) # 인터페이스 메서드 호출repo가 SQLite인지 Neo4j인지 Tool은 전혀 모른다. 그래서 Tool 5개, AgentService, Streamlit UI는 코드를 전혀 건드리지 않아도 됐다.
🔍 헥사고날 아키텍처란?
- 핵심 아이디어: 애플리케이션의 핵심 비즈니스 로직을 외부 세계(DB, UI, API 등)로부터 완전히 격리한다.
- 구조
- 3가지 구성 요소 (포트, 어댑터, 애플리케이션)
- Port(포트): "무엇을 할 수 있어야 하는가?"
인터페이스(추상 클래스)로 정의된 계약서. 구체적인 구현이 없고, 메서드 목록만 있다.💡 "DB가 뭔지 모르겠지만, 이 메서드들은 반드시 있어야 한다"는 약속이다.# application/ports/outbound/influencer_repository_port.py class InfluencerRepositoryPort(ABC): @abstractmethod def find_by_categories(self, categories): ... @abstractmethod def find_by_platform(self, platform): ...- Adapter(어댑터): "어떻게 구현할 것인가?"
Port를 실제로 구현하는 클래스. 외부 세계(DB, API 등)와 통신하는 코드가 여기에 있다.💡 Port라는 계약만 지키면, 내부 구현은 뭐든 상관없다.# 어댑터: Neo4j 구현체 (현재) class Neo4jInfluencerRepository(InfluencerRepositoryPort): def find_by_categories(self, categories): return self.db.execute_query("MATCH ...") # Cypher 쿼리- Application Core(핵심): "비즈니스 로직"
Port만 알고, Adapter는 모르는 코드. 외부 세계에 대한 의존이 없다.💡# adapters/outbound/agent/tools/search_tools.py def create_search_by_category_tool(repo: InfluencerRepositoryPort): # Port 타입만 받음 @tool def search_influencers_by_category(categories: str) -> str: influencers = repo.find_by_categories(category_list) # 그냥 호출repo가 SQLite인지 Neo4j인지 이 코드는 알 수 없고, 알 필요도 없다.- Container(조립): "어떤 어댑터를 쓸지 결정"
# infrastructure/container.py
def influencer_repository(self) -> InfluencerRepositoryPort:
  return Neo4jInfluencerRepository(self.neo4j_database)
  # ↑ 여기만 바꾸면 전체 DB가 교체됨
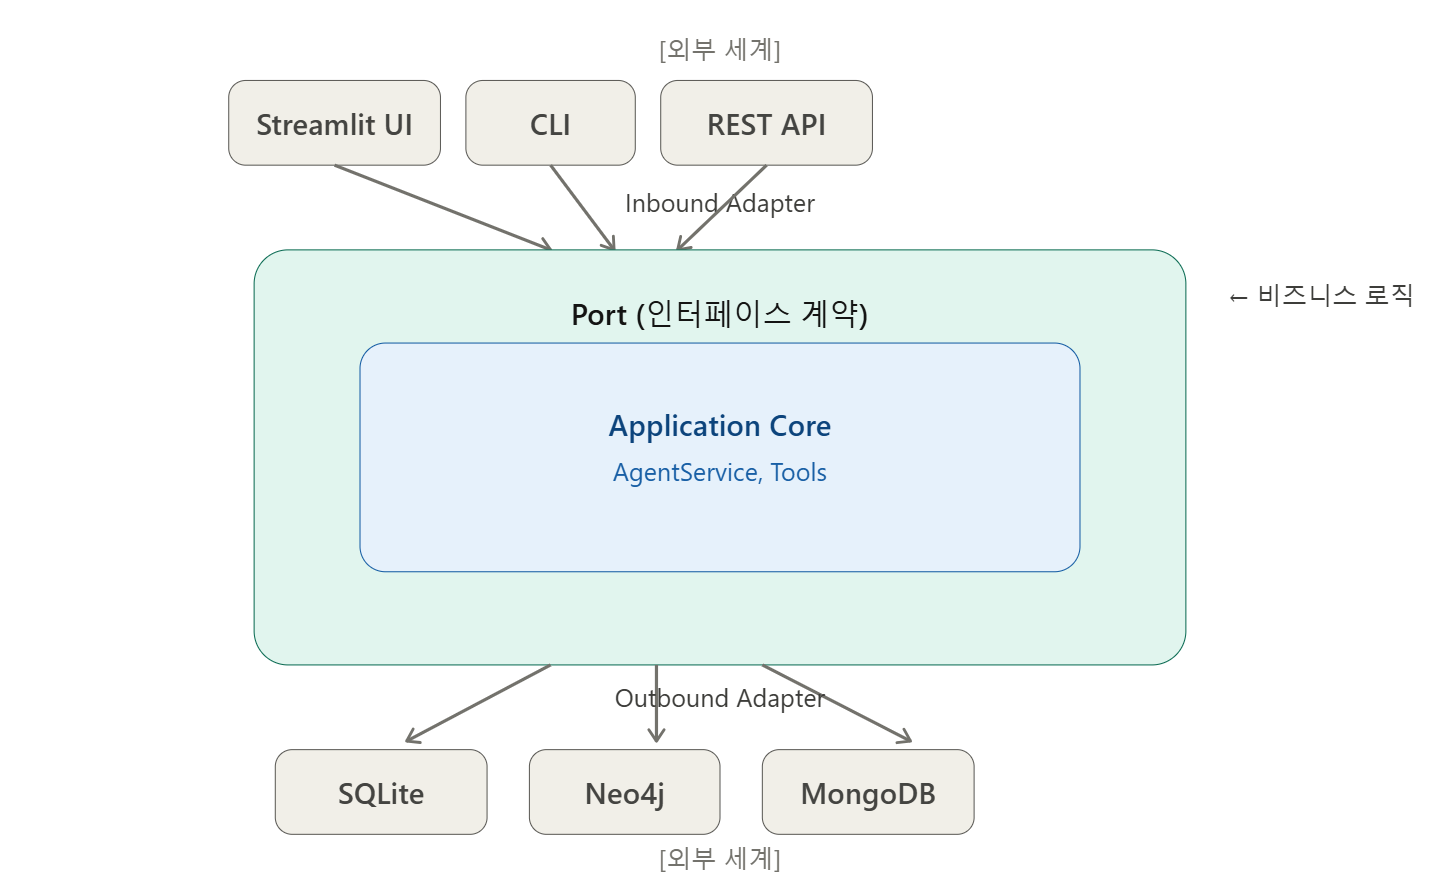
실제로 바꿔야 할 것은 딱 두 가지였다.
- Neo4jInfluencerRepository 클래스 신규 생성
neo4j_influencer_repository.py에InfluencerRepositoryPort가 요구하는 10개 메서드를 모두 Cypher로 구현했다.
SQLite는 테이블에서 행을 가져와 엔티티로 변환했다면, Neo4j는 그래프를 탐색해서 노드와 관계를 조합한 뒤 엔티티로 변환한다.class Neo4jInfluencerRepository(InfluencerRepositoryPort): ... # find_by_categories 메서드 구현 def find_by_categories(self, categories: List[str]) -> List[Influencer]: records = self.db.execute_query(""" MATCH (i:Influencer {is_active: true})-[:SPECIALIZES_IN]->(c:Category) WHERE toLower(c.name) IN $categories OPTIONAL MATCH (i)-[:SPECIALIZES_IN]->(allC:Category) OPTIONAL MATCH (i)-[r:ACTIVE_ON]->(p:Platform) RETURN DISTINCT i, collect(DISTINCT allC.name) as categories, collect(DISTINCT {platform: p.name, followers: r.follower_count}) as platforms """, {"categories": [c.lower() for c in categories]}) return self._records_to_entities(records) ...
핵심은SPECIALIZES_IN,ACTIVE_ON관계를 따라가며 카테고리와 플랫폼 정보를 수집하는 것이다.
-
container.py에서 반환 객체만 교체# 수정 전 @lru_cache def influencer_repository(self) -> SQLiteInfluencerRepository: return SQLiteInfluencerRepository(self.database) # SQLite DB 연결 # 수정 후 @lru_cache def influencer_repository(self) -> InfluencerRepositoryPort: return Neo4jInfluencerRepository(self.neo4j_database) # Neo4j 연결반환 타입도 구체 클래스(
SQLiteInfluencerRepository)에서 인터페이스(InfluencerRepositoryPort)로 바꿨다. 이렇게 하면 나중에 또 다른 DB로 교체하더라도 이 한 줄만 바꾸면 된다.
🌟 수정 후: Neo4j만으로 동작하는 과정
🧐 데이터 저장 구조 변화
-
수정 전
인플루언서 원본 데이터 → SQLite (로컬 파일: ad_matching.db) → Neo4j (관계 그래프) → ChromaDB (로컬 파일: ./chroma_db/) -
수정 후
인플루언서 원본 데이터  →  Neo4j 하나로 전부 저장
                            ├── Influencer 노드 (원본 데이터)
                            ├── InfluencerEmbedding 노드 (벡터 임베딩)
                            ├── MatchRecord 노드 (매칭 이력 임베딩)
                            ├── NotionCampaign 노드 (Notion 데이터 임베딩)
                            └── 관계 그래프 (기존 유지)
➡️ 로컬 파일이 사라지고 AuraDB 클라우드 하나로 통합됐다.
🧐 Agent Tool 동작 흐름
Agent가 "뷰티 카테고리 인플루언서 찾아줘"라는 요청을 받으면 내부적으로 이렇게 동작한다.
-
키워드 기반 검색 (기존 5개 Tool)
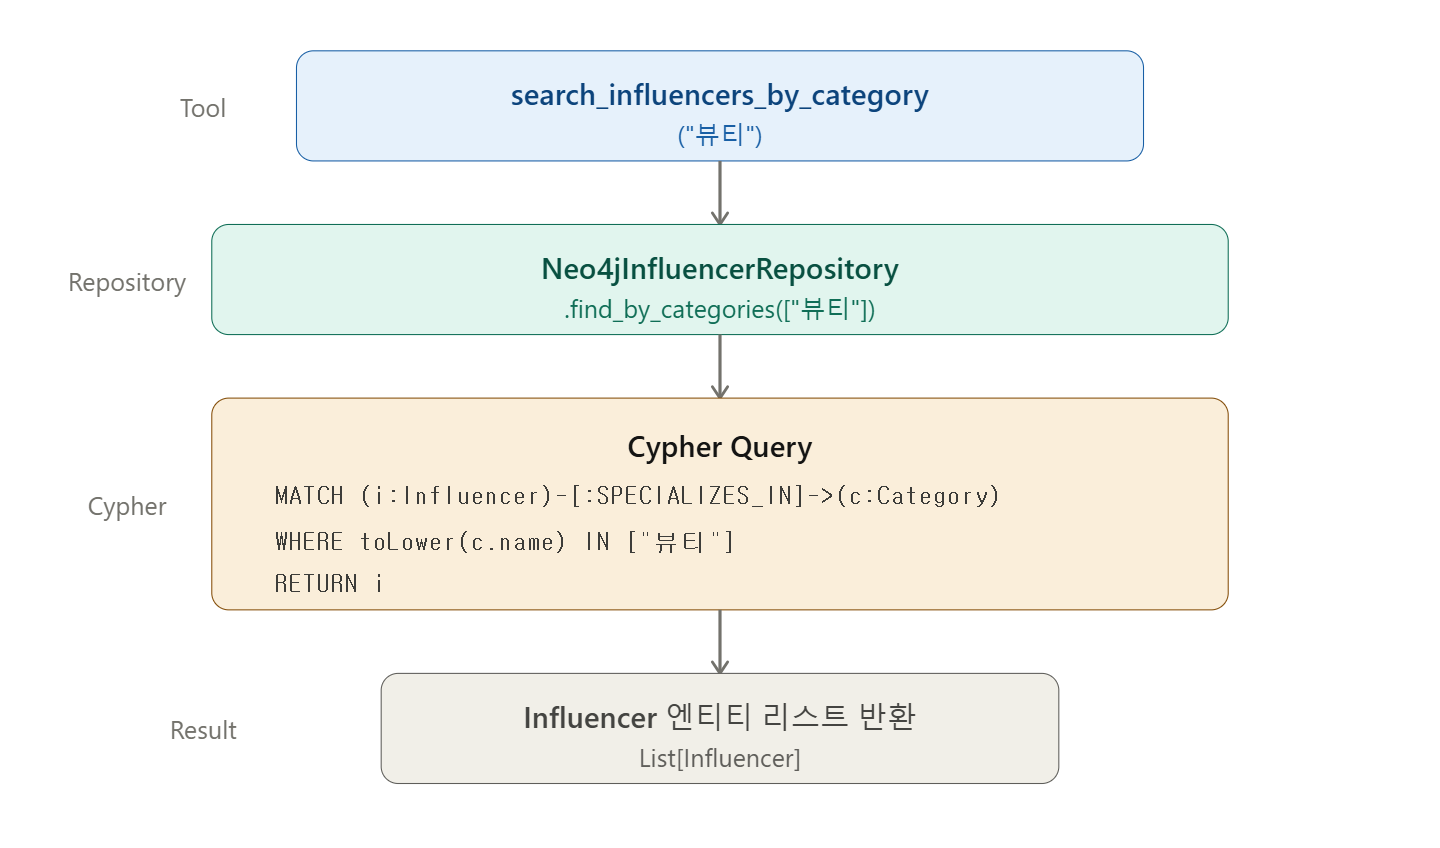 ➡️ 기존에는 SQLite가 처리하던 역할을 이제 Neo4j가 담당한다. 코드 상으로는
influencer_repository()가Neo4jInfluencerRepository를 반환하는 것 외에 달라진 게 없다. -
자연어 시맨틱 검색 (LlamaIndex Tool)
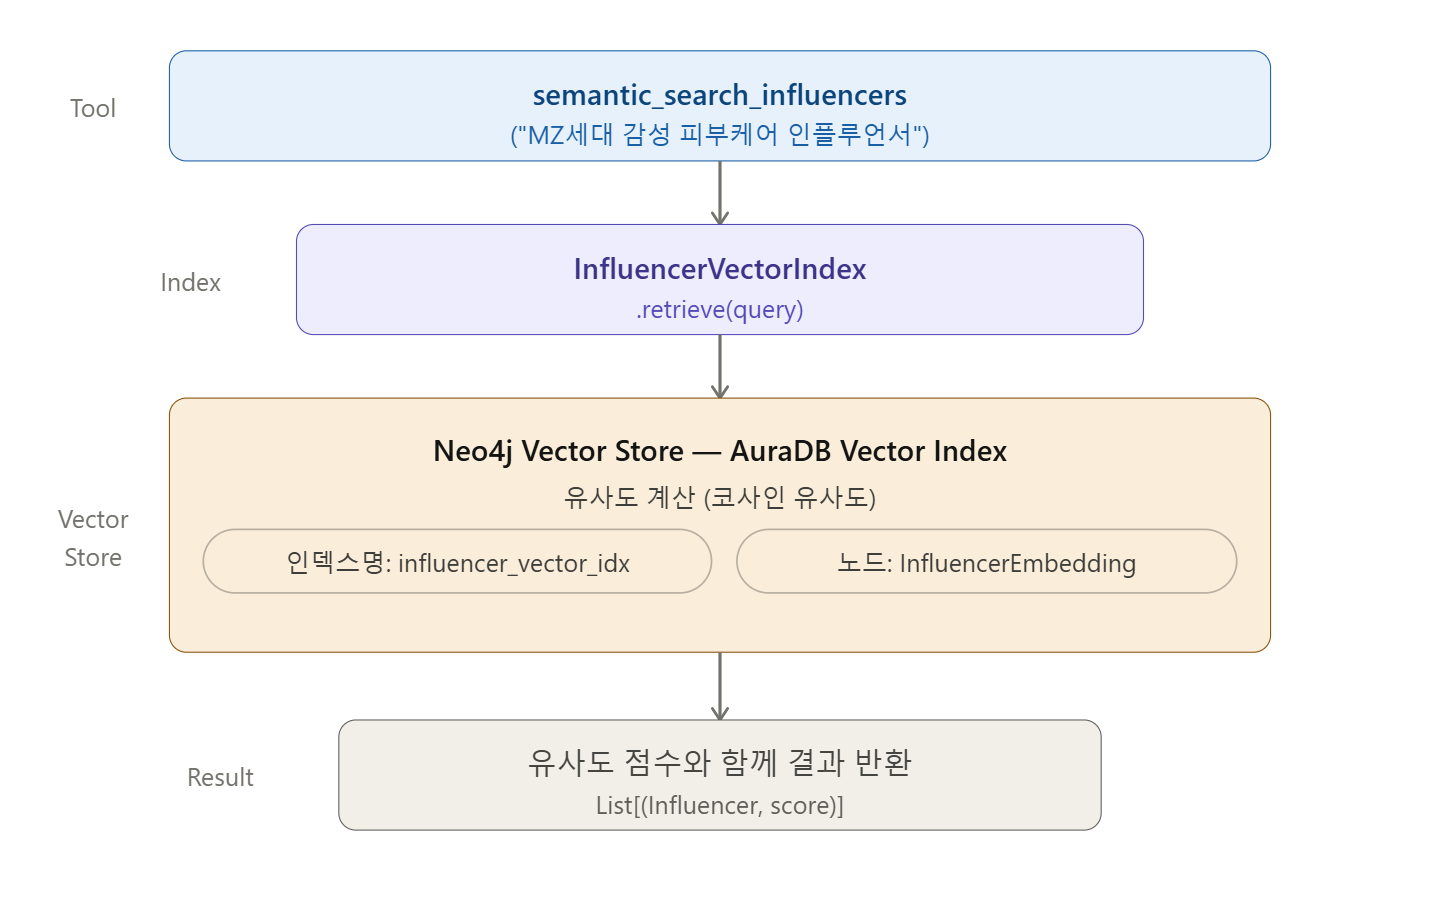 ➡️ 기존에는
./chroma_db/파일에서 처리하던 것이 이제 AuraDB에서 처리된다.
🧐 Neo4j 내부에서 공존하는 노드들
수정 후 AuraDB에는 다음 노드들이 함께 존재한다.
| 노드 레이블 | 역할 | 수 |
|---|---|---|
Influencer | 인플루언서 데이터 (seed 50명 + Notion 36명) | 86개 |
Advertisement | 광고 캠페인 (Notion 수집 데이터) | 36개 |
Advertiser | 광고주 (Notion 수집 데이터) | 23개 |
Category | 카테고리 (뷰티, 패션 등) | 18개 |
Platform | 플랫폼 (인스타그램, 유튜브 등) | 5개 |
Entity | LlamaIndex KG 인덱스가 텍스트에서 자동 추출한 개체 | 272개 |
InfluencerEmbedding | 인플루언서 프로필 벡터 임베딩 | 86개 |
MatchRecord | 매칭 이력 벡터 임베딩 | 36개 |
NotionCampaign | Notion 광고 데이터 벡터 임베딩 | 36개 |
Influencer 노드는 관계 그래프용으로도 쓰이고, InfluencerEmbedding 노드는 시맨틱 검색용 벡터를 저장하는 용도로 쓰인다. 둘은 별개의 노드이지만 같은 DB 안에 있다.
🧐 달라진 점 한눈에 비교
| 수정 전 | 수정 후 | |
|---|---|---|
| DB 개수 | 3개 (SQLite, ChromaDB, Neo4j) | 1개 (Neo4j) |
| 저장 위치 | 로컬 파일 2개 + 클라우드 1개 | 클라우드 1개 |
| 키워드 검색 | SQLite | Neo4j (Cypher) |
| 시맨틱 검색 | ChromaDB (로컬) | Neo4j Vector Index (클라우드) |
| 관계 분석 | Neo4j | Neo4j |
| 관리 포인트 | DB 3개 + 인덱스 빌드 스크립트 | DB 1개 |
| 배포 시 | 로컬 파일도 함께 관리 필요 | AuraDB 접속 정보만 관리 |
🌟 회고
DB를 3개에서 1개로 바꿀 때, 그동안 구현했던 코드가 많이 바뀔까봐 걱정했었다.
그런데 이 프로젝트의 핵심인 Agent Tool 5개는 한 줄도 고치지 않았다.
이는 InfluencerRepositoryPort라는 인터페이스 덕분이었다. DB를 바꿔도 Tool은 인터페이스만 바라보고 있었기 때문에, 내부 구현이 SQLite든 Neo4j든 Tool 입장에서는 아무 상관이 없었다. 헥사고날 아키텍처가 실제로 효과가 있다는 걸 코드로 체감한 순간이었다.
이 과정을 작성하면서 새롭게 알게 된 부분도 있었다. 벡터 검색은 텍스트를 임베딩으로 변환하는 사전 처리가 필요하기 때문에 별도의 빌드 스크립트가 필요하다는 것이다. ChromaDB의 단점이라고 생각했던 게 사실은 벡터 검색 자체의 특성이었고, Neo4j로 DB를 통합하더라도 빌드 스크립트는 그대로 필요하다.
DB가 3개에서 1개로 줄면서 신경 써야 할 부분도 많이 줄었다. .env에서 연결 설정 3개를 관리하던 게 1개로 줄었고, 팀원마다 로컬에 ad_matching.db와 chroma_db/ 폴더를 직접 만들어야 했던 번거로움도 사라졌다. 클라우드(Neo4j AuraDB)에 데이터가 한 곳에 모이면서 팀원 모두가 같은 데이터를 보는 게 자연스러워졌다.
