🌟 개요
실제 인스타그램에서 수집한 과거 광고 캠페인 데이터가 검색에 활용되지 못하고 그냥 쌓이고 있었다.
인플루언서 프로필은 Neo4j에 저장되어 있지만, 실제로 어떤 광고주와 어떤 컨셉으로 협업했는지는 에이전트가 전혀알 수 없는 상태였다.
이번 작업에서는 수집된 광고 캠페인 CSV를 Neo4j 그래프와 벡터 인덱스 두 곳에 자동으로 적재하는 파이프라인을 구축했다.
광고 집행 이력 전체를 자연어 문서로 변환하여 임베딩함으로써, "화장품 브랜드와 협업 경험 있는 인플루언서"처럼 캠페인 맥락 기반의 시맨틱 검색이 가능해졌다.
🌟 구현 구조와 인덱싱 파이프라인
📌 개요
실제 인스타그램 광고 캠페인 CSV 데이터를 LlamaIndex 기반 벡터 인덱스로 자동 변환하는 파이프라인을 구축했다.
단순히 인플루언서 프로필만 저장하는 게 아니라, 실제 광고 집행 이력(광고주, 제품, 컨셉 키워드, 성과 지표)까지 임베딩하여 캠페인 맥락 기반 검색이 가능해졌다.
⚠️ 기존 방식의 문제
기존에는 과거 광고 캠페인 데이터를 수집해도 Neo4j 그래프 DB에 인플루언서 노드와 관계만 저장하고, 실제 캠페인 내용(어떤 광고주와 일했는지, 컨셉 키워드가 뭔지, 성과는 어땠는지)은 검색에 전혀 활용되지 않았다.
"뷰티 화장품 캠페인 경험 있는 인플루언서"를 찾으려면 카테고리 필터만 가능했고, 실제 협업 이력 기반의 의미 검색은 불가능했다.
✨ 자동 인덱싱 파이프라인 적용 후
CSV → Document 변환 → Neo4j Vector Store까지 원클릭으로 처리된다.
CSV 파일을 준비하고 스크립트를 실행하면, 각 캠페인 행이 풍부한 자연어 문서로 변환되어 CollectedAdRecord 노드로 벡터 인덱스에 자동 저장된다.
이후 "피트니스 단백질 보충제 캠페인"으로 검색하면, 정확한 카테고리명 없이도 실제 광고 집행 이력이 있는 인플루언서를 유사도 순으로 조회할 수 있다.
🔀 2가지 독립적인 임포트 흐름
파이프라인은 목적에 따라 두 흐름으로 분리된다.
-
그래프 임포트 (
import_collected_ad_data.py)
CSV → Neo4j 그래프 노드/관계 생성 흐름이다.
Influencer,Advertiser,Advertisement노드를 만들고,PROMOTED,CREATED_AD,TARGETS_CATEGORY관계를 구성한다.
MERGE기반이라 재실행해도 중복 노드가 생기지 않는다. -
벡터 인덱스 빌드 (
build_collected_ad_index.py+CollectedAdIndex)
CSV에서 Neo4j 그래프를 거치지 않고 직접 LlamaIndex Document로 변환하여 Neo4j Vector Store에 저장한다.
그래프 임포트와 완전히 독립적으로 실행 가능하다.
🧩 Document 텍스트 구성 전략
단순히 CSV 행을 그대로 저장하는 게 아니라, 검색 정확도를 높이기 위해 캠페인 컨텍스트를 자연어 문장으로 조합했다.
인플루언서 '홍길동'(@example). 광고주 '올리브영'(업종: 뷰티)의 '선크림' 캠페인에 참여.
카테고리: 뷰티. 제품 카테고리: 스킨케어. 컨셉: 자외선 차단, 여름, 데일리.
콘텐츠 형식: Reel. 콘텐츠 스타일: 튜토리얼. CTA: 링크 클릭.
성과: 좋아요 12000, 댓글 340, 조회수 85000. 팔로워: 95000명.
빈 값이나 "확실하지 않음" 필드는 자동으로 제외하여 노이즈가 섞이지 않도록 했다.
이렇게 구성된 텍스트에 광고주명, 제품, 컨셉 키워드가 함께 임베딩되므로, 캠페인 경험 기반 검색이 의미적으로 잘 동작한다.
🛡️ 데이터 품질 보정 장치
임포트 과정에서 데이터 품질을 자동으로 보정하는 로직이 3가지 포함된다.
-
engagement_rate사전 계산
전체 CSV를 1패스로 읽어 인플루언서별 평균(likes + comments) / follower_count를 미리 계산한 뒤 임포트한다.
여러 행에 걸쳐 있는 동일 인플루언서의 게시물을 종합한 수치이다. -
결정론적 UUID
instagram_handle기반으로uuid5를 생성하므로, 같은 인플루언서를 재임포트해도 항상 동일한 노드 ID가 부여된다. -
팔로워 0 대화형 보정
팔로워 수가 누락된 인플루언서는 임포트 중 콘솔에서 직접 입력받거나, 0 입력 시 해당 인플루언서의 모든 광고 행을 건너뛴다.
🌟 관련 파일 목록
| 파일 | 역할 |
|---|---|
import_collected_ad_data.py | 벡터 인덱싱 파이프라인 핵심 로직 (Document 변환, 인덱스 빌드, retrieve) |
collected_ad_index.py | CSV → Neo4j 그래프 임포트 (Influencer / Advertiser / Advertisement 노드 + 관계) |
build_collected_ad_index.py | 인덱스 초기화 + 재빌드 + 테스트 검색 스크립트 |
container.py | collected_ad_index() 싱글톤 관리 |
llamaindex_tools.py | 과거 광고 캠페인 검색 에이전트 도구 정의 |
collected_ad_index.py가 CSV를 Document로 변환하고 벡터 인덱스를 빌드하는 핵심이고, import_collected_ad_data.py가 동일한 CSV를 Neo4j 그래프로 적재하는 독립적인 흐름을 담당한다.
🌟 import_collected_ad_data.py 파일 분석
1. 파일 소개
이 파일은 수집된 과거 광고 캠페인 CSV 데이터를 Neo4j 그래프 DB에 적재하는 임포트 스크립트이다. 크게 두 가지 역할을 한다.
- 그래프 임포트: CSV 행을 파싱·정제하여
Influencer,Advertiser,Advertisement노드와 그 사이의 관계(PROMOTED,CREATED_AD,TARGETS_CATEGORY)를 Neo4j에 생성한다. - 데이터 보강: 임포트된 인플루언서의
description을 웹 검색으로 자동 생성해 프로필을 채운다.
Neo4j에 데이터를 쓸 때 MERGE를 사용하기 때문에 스크립트를 반복 실행해도 중복 노드가 생기지 않는다.
또한 instagram_handle 기반의 결정론적 UUID(uuid5)를 사용해 동일한 인플루언서는 재임포트 시에도 항상 같은 노드 ID를 갖는다.
description 자동 생성은 시간이 오래 걸리기 때문에 --no-enrich 옵션으로 건너뛸 수 있으며, 임포트만 빠르게 처리할 수 있다.
2. CSV 데이터 구조
CSV 데이터는 크게 3가지 정보 그룹으로 구성된다.
-
인플루언서 정보
컬럼 설명 category인플루언서 활동 카테고리 (뷰티, 패션 등) influencer_name인플루언서 이름 instagram_handle인스타그램 핸들 (고유 식별자로 사용) profile_url프로필 URL (instagram/youtube 판별에도 활용) follower_count팔로워 수
-
광고주 정보
컬럼 설명 advertiser광고주명 industry업종
-
광고 캠페인 정보
컬럼 설명 product광고 제품명 product_category제품 카테고리 concept_keywords캠페인 컨셉 키워드 format게시물 형식 (Reel, Feed 등) post_date게시 날짜 post_url게시물 URL (광고 노드 고유 키로 사용) likes/comments/views성과 지표
값이 없거나 불확실한 경우 "확실하지 않음"으로 입력되어 있어, 파싱 단계에서 이를 0 또는 빈 문자열로 정규화하는 처리가 필요하다.
3. 데이터 전처리 함수들
임포트 전에 CSV 원본 데이터를 정제하는 함수가 4개 있다.
normalize_category()
수집된 데이터에서 직접 입력한 카테고리명과 Neo4j에 이미 저장된 seed 데이터의 카테고리명이 다를 수 있다.category_map = { '테크/가전': '테크', '육아': '라이프스타일', ... } return category_map.get(category.strip(), '라이프스타일')
예를 들어 수집 데이터에는"테크/가전"으로 입력했지만 DB에는"테크"로 저장되어 있으면 관계가 연결되지 않는다.
이를 방지하기 위해 매핑 테이블로 통일한다. 매핑에 없는 값은 기본값"라이프스타일"로 처리한다.
parse_follower_count()/parse_engagement()
두 함수는 구조가 동일하다. 수집 데이터에서 숫자를if not value or value == "확실하지 않음": return 0 return int(str(value).replace(',', '').strip())"12,000"형식으로 입력하는 경우가 있어 쉼표를 제거하고,"확실하지 않음"또는 빈 값은0으로 반환한다.
parse_follower_count()는 인플루언서 노드 생성에,parse_engagement()는 좋아요·댓글·조회수 파싱에 사용된다.
parse_date()
정형화되지 않은 날짜 형식(# "2026년 1월 18일" → "2026-01-18" parts = date_str.replace('년', '-').replace('월', '-').split('-') return f"{year}-{month.zfill(2)}-{day.zfill(2)}""2026년 1월 18일")을 Neo4j에 저장 가능한 ISO 형식("2026-01-18")으로 변환한다.
zfill(2)로 월·일을 두 자리로 맞춰 정렬 및 비교가 일관되게 동작하도록 한다. 파싱 실패 시None을 반환해 노드 생성을 막지 않는다.
4. 핵심 로직: import_collected_ad_data()
-
1단계:
engagement_rate사전 계산engagement_rates = calc_engagement_rate(data)본격적인 임포트 전에 전체 CSV를 한 번 순회(1패스)해서 인플루언서별 평균
engagement_rate를 미리 계산한다.
한 인플루언서가 여러 행에 걸쳐 여러 캠페인을 가질 수 있기 때문에, 행을 하나씩 처리하는 도중에는 전체 평균을 낼 수 없다.
사전에 계산해두고 딕셔너리로 조회하는 방식을 택했다.# avg((likes + comments) / follower_count) per influencer posts[handle].append((likes + comments) / followers) -
2단계: 인플루언서 노드 생성
influencer_id = str(uuid.uuid5(uuid.NAMESPECE_URL, instagram_handle))

MERGE (i:Influencer {instagram_handle: $instagram_handle})
ON CREATE SET i.id = $id, ...
ON MATCH SET i.follower_count = CASE WHEN $follower_count > 0 ...
두 가지 안전장치가 함께 동작한다.
- 결정론적 UUID:
instagram_handle을 시드로uuid5를 생성하기 때문에 동일한 인플루언서를 재임포트해도 항상 같은 ID가 부여된다.uuid4()처럼 랜덤 생성하면 재실행마다 중복 노드가 쌓인다. - MERGE + ON CREATE/ON MATCH 분기: 노드가 없으면 새로 생성하고, 이미 있으면 일부 필드만 업데이트한다. 특히 팔로워 수는
CASE WHEN으로 0이 아닐 때만 덮어써 기존 데이터를 보호한다.
- 결정론적 UUID:
-
3단계: 팔로워 0 대화형 보정
if follower_count == 0:
   raw = input("팔로워 수를 입력하세요 (0 입력 시 건너뜀): ")
   if follower_count == 0:
      skipped_influencers.add(instagram_handle)
      continue
팔로워 수가 누락된 인플루언서는 임포트 중 콘솔에서 직접 입력받는다.
0을 입력하면skipped_influencers세트에 추가되어, 해당 인플루언서의 이후 광고 행들도 자동으로 건너뛴다.
첫 등장 시에만 프롬프트가 뜨고 이후 실행에서는 세트 조회로 즉시 스킵된다. -
4단계: 광고주/광고 노드 + 관계 생성
노드 생성 순서와 관계 방향은 아래와 같다.Influencer -[PROMOTED]-> Advertisement Advertiser -[CREATED_AD]-> Advertisement Adertisement -[TARGETS_CATEGORY]-> CategoryAdvertisement의 고유 키는post_url이다.
같은 게시물을 재임포트해도MERGE (ad:Advertisement {post_url: $post_url})로 중복 없이 처리된다.post_url이 없는 행은 광고 노드 생성을 건너뛴다. -
전체 흐름 요약
CSV 로드
    ↓
1패스: engagement_rate 사전 계산
    ↓
행별 순회
   ├─ 팔로워 0 → 콘솔 보정 or 스킵
   ├─ Influencer 노드 MERGE (첫 등장 시)
   ├─ Advertiser 노드 MERGE (첫 등장 시)
   ├─ Advertisement 노드 MERGE + 3개 관계 생성
   ↓
enrich_descriptions() (--no-enrich 아닌 경우)
5. Neo4j 그래프 구조
-
노드 구조
노드 주요 프로퍼티 비고 Influencerid,name,instagram_handle,platform,follower_count,engagement_rate,average_views,is_active:Real레이블 추가로 seed 데이터와 구분Advertiserid,name,industry광고주명을 고유 키로 MERGE Advertisementid,product,product_category,concept_keywords,post_date,format,likes,comments,viewspost_url을 고유 키로 MERGECategoryname기존 그래프의 카테고리 노드 재사용 Platformname기존 그래프의 플랫폼 노드 재사용
- 관계 구조
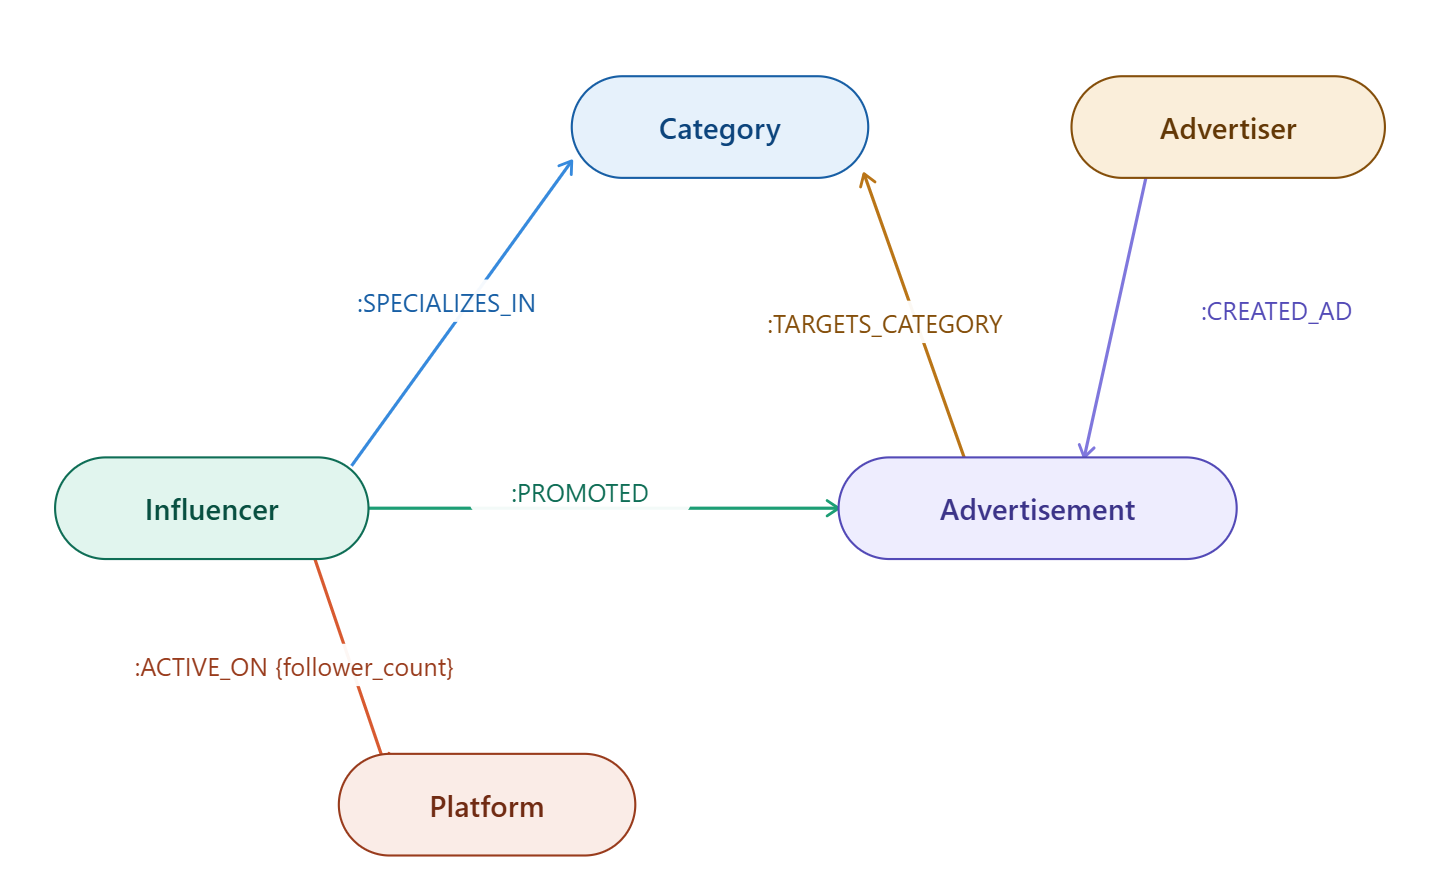
ACTIVE_ON관계에는follower_count가 프로퍼티로 저장된다.
플랫폼별 팔로워 수를 관계 자체에 보관하는 기존 seed 데이터 설계 방식을 그대로 따른 것이다.
- 기존 그래프와의 호환성
Category와Platform노드는 새로 만들지 않고MERGE로 기존 노드에 연결한다. seed 데이터로 구축된 그래프 위에 수집된 광고 데이터를 자연스럽게 얹는 구조이다.
Influencer노드에:Real레이블을 추가해 seed의 가상 데이터와 실제 수집 데이터를 레이블로 구분할 수 있다.
6. enrich_description(): description 자동 생성
enrich_description()는 임포트가 끝난 직후 신규 인플루언서들의 description을 자동으로 채워주는 함수이다.
- 동작 흐름
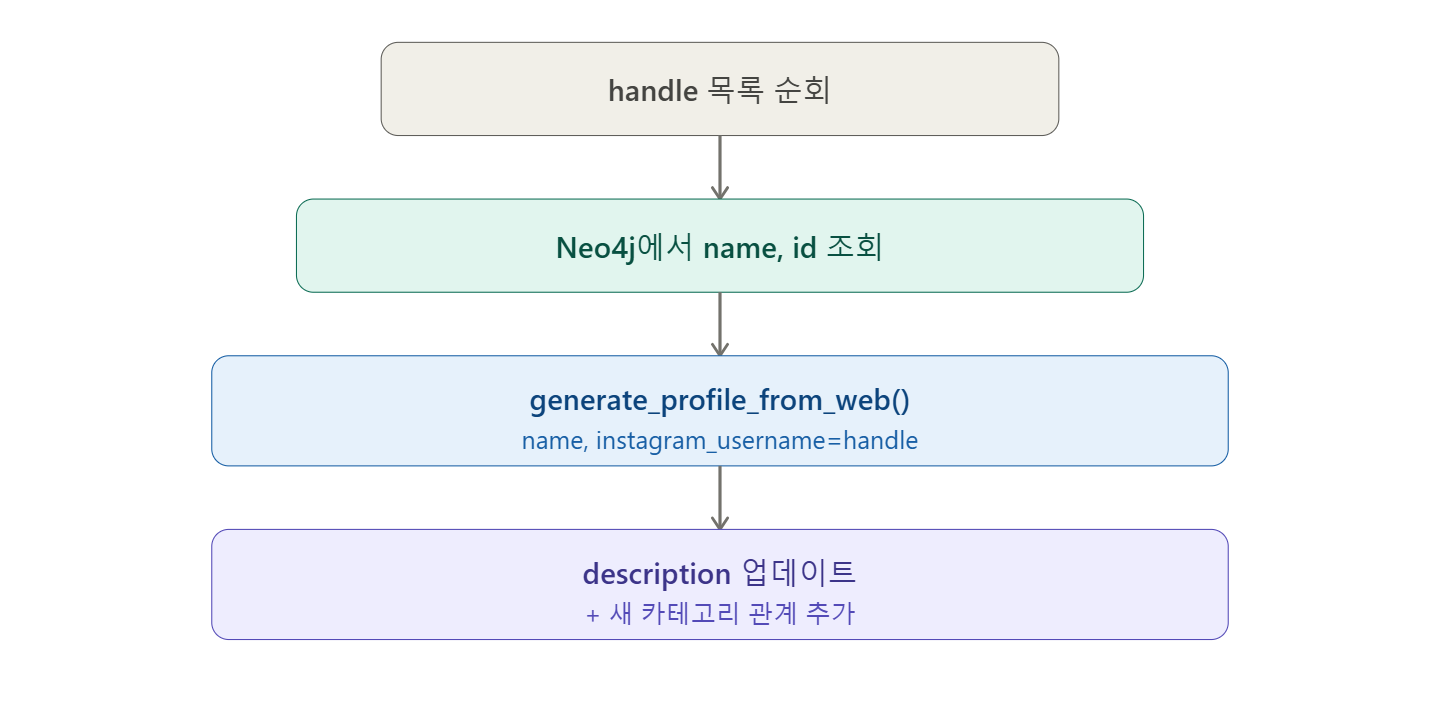
generate_profile_from_web()은 인플루언서 이름과 핸들로 웹 검색을 수행해description,categories,confidence를 반환한다.
직접 프로필 텍스트를 작성하는 게 아니라 실제 웹 정보를 기반으로 생성한다.
- Neo4j 업데이트 방식
id가 있는 경우와 없는 경우를 분기해서 처리한다.id가 있으면id로 매칭MATCH (i:Influencer {id: $id}) SET i.description = $descid가 없으면handle로 매칭MATCH (i:Influencer {instagram_handle: $handle}) SET i.description = $desc
description업데이트와 함께 웹 검색에서 새로운 카테고리 정보가 나오면SPECIALIZES_IN관계도 추가로 연결한다.
임포트 시점에 CSV에 없던 카테고리가 보강될 수 있다.
- 과부하 방지
인플루언서 1명당 약 15~30초가 소요되며, 각 처리 사이에 1초 딜레이를 둔다.time.sleep(1.0) # LLM 과부하 방지
인플루언서가 많으면 전체 시간이 길어지기 때문에 빠른 임포트가 필요한 경우--no-enrich옵션으로 이 단계를 건너뛸 수 있다.
7. CLI 인터페이스
argparse로 두 가지 옵션을 제공한다.
# 임포트 + description 자동 생성
uv run python scripts/import_collected_ad_data.py

# 임포트만 (description 생성 건너뜀)
uv run python scripts/import_collected_ad_data.py --no-enrich

# CSV 경로 직접 지정
uv run python scripts/import_collected_ad_data.py --csv path/to/file.csv| 옵션 | 기본값 | 설명 |
|---|---|---|
--no-enrich | False | enrich_descriptions() 건너뜀 |
--csv | data/influencer_ads_collected_notion.csv | CSV 파일 경로 지정 |
CSV 경로를 별도로 지정하지 않으면 프로젝트 루트의 data/ 디렉토리를 기본으로 사용한다. 파일이 존재하지 않으면 경로를 출력하고 종료한다.
🌟 collected_ad_index.py 파일 분석
1. 파일 소개
이 파일은 CollectedAdIndex 클래스 하나로 구성되어 있으며, import_collected_ad_data.py와 같은 CSV 파일을 입력으로 받지만 목적이 다르다.
import_collected_ad_data.py가 CSV를 Neo4j 그래프 노드와 관계로 변환하는 반면, 이 파일은 Neo4j 그래프를 전혀 거치지 않고 CSV에서 직접 벡터 인덱스를 생성한다. 크게 두 가지 역할을 한다.
- 인덱스 빌드: CSV 행을 자연어 문장으로 조합한 LlamaIndex
Document로 변환하고, 임베딩 벡터로 변환해 Neo4j Vector Store에CollectedAdRecord노드로 저장한다. - 시맨틱 검색: 자연어 쿼리를 벡터로 변환해 저장된 캠페인 벡터와 유사도를 비교하고, 가장 유사한 광고 캠페인을 반환한다.
벡터 저장소는 기존 InfluenceEmbedding 노드와 동일한 Neo4j를 사용하되, 노드 레이블을 CollectedAdRecord으로 분리해 관리한다.
인플루언서 프로필 벡터(InfluencerEmbedding)와 광고 캠페인 벡터(CollectedAdRecord)가 같은 DB 안에 독립적으로 공존하는 구조이다.
2. 모듈 레벨 헬퍼 함수
CollectedAdIndex 클래스 외부에 모듈 레벨 함수로 정의된 헬퍼가 2개 있다.
_parse_number()
팔로워 수, 좋아요, 댓글, 조회수 등 숫자 필드를 파싱한다.def _parse_number(value: str) -> int: if not value or value.strip() == "확실하지 않음": return 0 return int(str(value).replace(",", "").strip())
import_collected_ad_data.py의parse_follower_count()/parse_engagement()와 역할이 동일하지만, 이 파일에서는 두 함수를 하나로 합쳐 단순화했다.
_clean_value()
텍스트 필드에서 의미 없는 값을 빈 문자열로 정리한다.def _clean_value(value: str) -> str: value = value.strip() if value in ("확실하지 않음", "없음"): return "" return value
import_collected_ad_data.py에는 없던 함수로,"없음"도 추가로 처리한다.
_load_csv_documents()에서 각 필드를 추출할 때 전처리 용도로 사용되며, 빈 문자열이 반환된 필드는 Document 텍스트에서 자동으로 제외된다.
두 함수 모두 앞에 _가 붙어 있어 모듈 외부에서 직접 사용하지 않는 내부 함수임을 나타낸다.
3. __init__(): Vector Store 초기화
self._vector_store = Neo4jVectorStore(
   username=neo4j_username,
   password=neo4j_password,
   url=neo4j_uri,
   embedding_dimension=1024,
   index_name="collected_ad_vector_idx",
   node_label="CollectedAdRecord",
)
생성자에서 Neo4j 연결 정보와 함께 Neo4jVectorStore를 즉시 초기화한다. 주목할 설정값은 3가지이다.
-
embedding_dimension=1024
저장할 벡터의 차원 수이다. 사용하는 임베딩 모델의 출력 차원과 반드시 일치해야 한다. 차원이 다르면 인덱스 저장 시 오류가 발생한다.
1번(시맨틱 검색)에서 구축한InfluencerEmbedding인덱스와 동일한 차원을 사용한다. -
index_name="collected_ad_vector_idx"
Neo4j 내부에서 관리되는 벡터 인덱스의 이름이다.
InfluencerEmbedding이 사용하는 인덱스명(influencer_vector_idx)과 분리되어 있어, 두 인덱스가 충돌 없이 독립적으로 동작한다. -
node_label="CollectedAdRecord"
벡터가 저장될 Neo4j 노드의 레이블이다.Influencer,InfluencerEmbedding등 기존 노드와 완전히 분리된 레이블을 사용한다.
reset()시에도MATCH (n:CollectedAdRecord) DETACH DELETE n으로 이 레이블만 정확히 삭제할 수 있다.
self_index는 None으로 초기화해두고, 실제 인덱스 객체는 build_index() 또는 get_index() 호출 시점에 생성된다.
불필요한 Neo4j 쿼리를 생성자에서 실행하지 않는 지연 초기화 패턴이다.
4. _load_csv_documents(): Document 텍스트 구성 전략
CollectedAdIndex의 핵심 메서드로, CSV 행을 LlamaIndex Document로 변환한다.
- 빈 값 필터링
instagram_handle = row.get("instagram_handle", "").strip() if not instagram_handle: continueinstagram_handle이 없는 행은 즉시 건너뛴다. 이름이 없는 경우에는 handle에서@를 제거해 대체한다.if not influencer_name: influencer_name = instagram.handle.replace("@", "")
- Document 텍스트 구성 전략
단순히 CSV 컬럼을 나열하는 게 아니라, 값이 존재하는 필드만 골라 자연어 문장으로 조합한다.text_parts = ["인플루언서 '홍길동'(@example)"] if advertiser: text_parts.append("광고주 '올리브영'(업종: 뷰티)의 '선크림' 캠페인에 참여") if category: text_parts.append("카테고리: 뷰티") if concept_keywords: text_parts.append("컨셉: 자외선 차단, 여름, 데일리") ... text = ". ".join(text_parts) + "."_clean_value()로"확실하지 않음","없음"이 걸러진 필드는if조건을 통과하지 못해 자동으로 제외된다. 빈 값이 문장에 섞이지 않아 임베딩 품질이 저하되는 것을 방지한다.
성과 데이터 (좋아요, 댓글, 조회수)는 별도로 묶어서 처리한다.
세 값 모두 0이면 성과 문장 자체가 생략된다.performance_parts = [] if likes > 0: performance_parts.append(f"좋아요 {likes}") if comments > 0: performance_parts.append(f"댓글 {comments}") if views > 0: performance_parts.append(f"조회수 {views}") if performance_parts: text_parts.append(f"성과: {', '.join(performance_parts)}")
- metadata 구성
doc = Document( text=text, metadata={ "influencer_name": influencer_name, "instagram_handle": instagram_handle, "category": category, "advertiser": advertiser, "product_category": product_category, "likes": likes, "comments": comments, "views": views, "follower_count": follower_count, }, )text는 임베딩 대상이고,metadata는 검색 결과에서 구조화된 데이터를 꺼내기 위한 용도이다.
retrieve()가 JSON으로 결과를 반환할 때node.medadata를 그대로 활용한다.
text에 포함된 정보와 일부 중복되지만, 에이전트가 후처리하기 쉽도록 필드를 분리해 저장한다.
5. build_index() vs. get_index(): 빌드와 로드 분리
build_index(): 신규 빌드
CSV를 읽어 Document로 변환하고, 각 Document를 임베딩 벡터로 변환해 Neo4j에 저장한다.def build_index(self) -> VectorStoreIndex: documents = self._load_csv_documents() storage_context = StorageContext.from_defaults(vector_store=self._vector_store) self._index = VectorStoreIndex.from_documents( documents, storage_context=storage_context ) return self._index
VectorStoreIndex.from_documents()가 내부적으로 임베딩 모델을 호출하기 때문에 문서 수만큼 API 호출이 발생한다.
처음 인덱스를 구축하거나 데이터가 변경되어 재빌드가 필요할 때 사용한다.
get_index(): 기존 인덱스 로드
이미 Neo4j에 저장된 벡터를 그대로 불러온다.def get_index(self) -> VectorStoreIndex: if self._index is None: storage_context = StorageContext.from_defaults(vector_store=self._vector_store) self._index = VectorStoreIndex.from_vector_store( vector_store=self._vector_store, storage_context=storage_context, ) return self._indexfrom_vector_store()는 임베딩 API를 호출하지 않고 기존 인덱스에 연결만 하기 때문에 훨씬 빠르다.
self._index가 이미 있으면 Neo4j 조회도 생략하는 지연 초기화 패턴이다.
query()와retrieve()는 모두get_index()를 통해 인덱스를 가져오기 때문에, 앱 실행 중에는 항상 로드 경로를 탄다.build_index()는build_collected_ad_index.py스크립트에서만 명시적으로 호출한다.
-
두 메서드 비교
build_index()get_index()사용 시점 최초 구축 / 재빌드 앱 실행 중 검색 임베딩 API 호출 O (문서 수만큼) X 진입점 build_collected_ad_index.pyquery(),retrieve()
6. query() vs. retrieve(): 검색 방식 2가지
두 메서드는 같은 벡터 인덱스를 사용하지만 결과 반환 방식이 다르다.
query(): LLM 요약 응답
벡터 검색으로 유사한 Document를query_engine = index.as_query_engine( similarity_top_k=top_k, response_mode="tree_summarize", ) response = query_engine.query(query_text) return str(response)top_k개 찾은 뒤, 그 결과를 LLM에 넘겨 자연어로 요약한 응답을 반환한다.
response_mode="tree_summarize"는 검색된 문서들을 계층적으로 요약하는 방식으로, 문서가 많을수록 품질이 올라간다.
사람이 읽기 좋은 형태지만 LLM 요약 과정에서 정보가 손실될 수 있고, 에이전트가 후처리하기 어렵다.🤔 LlamaIndex의
tree_summarize동작 방식검색된 문서가 많아서 LLM 컨텍스트 윈도우에 한 번에 다 들어가지 않을 때를 가정한다.
일반 요약(simple_summarize)이라면 전체 문서를 그냥 잘라서 LLM에 한 번 넘긴다. 잘린 부분은 유실된다.
tree_summarize는 다르게 동작한다.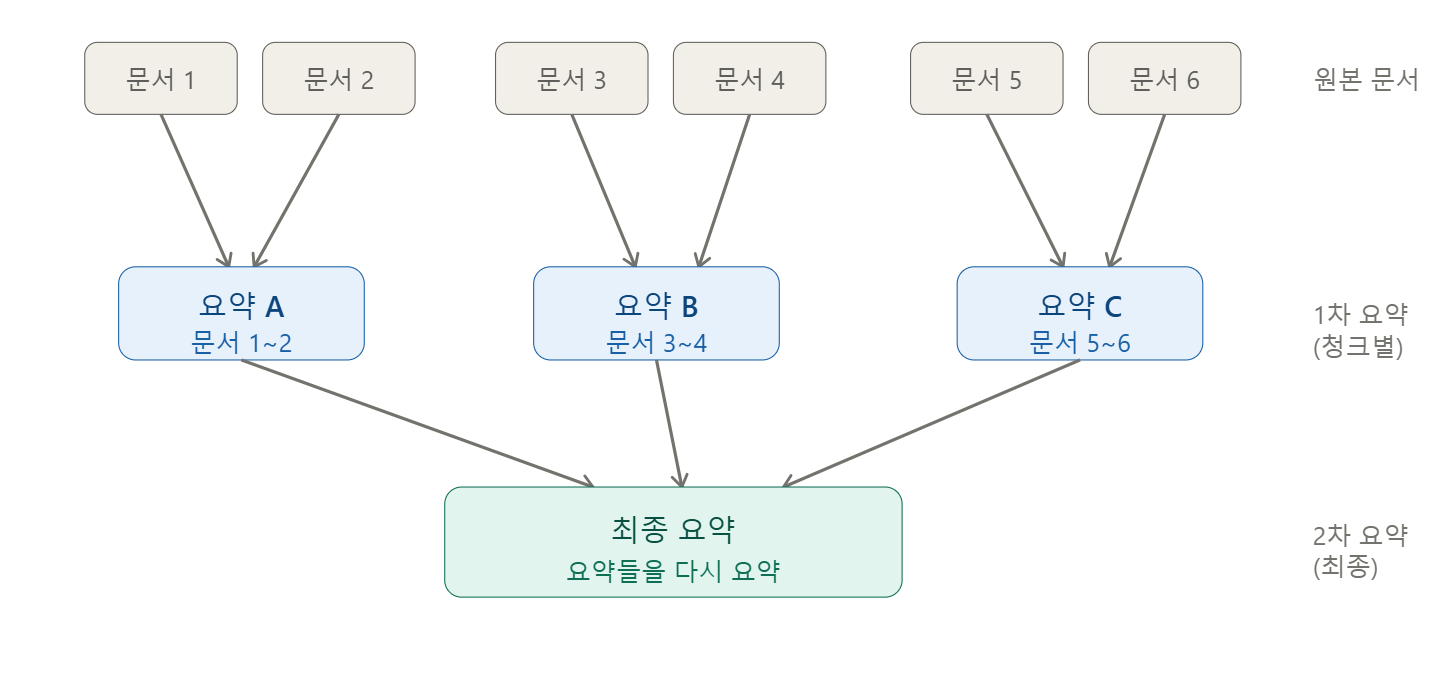 문서를 청크 단위로 나눠 1차 요약을 만들고, 그 요약들을 다시 LLM에 넘겨 최종 요약을 만드는 트리 구조이다.
문서가 아무리 많아도 정보 유실 없이 전체 내용을 반영할 수 있다.
-
retrieve(): 유사도 점수 포함 JSON 반환retriever = index.as_retriever(similarity_top_k=top_k) nodes = retriever.retrieve(query_text) results.append({ "text": node.get_text(), "score": round(node.get_score(), 4), "metadata": node.metadata, }) return json.dumps(results, ensure_ascii=False, indent=2)LLM 요약 없이 벡터 검색 결과를 그대로 JSON으로 반환한다.
각 결과에 유사도score과metadata가 포함되어 있어 에이전트가 구조화된 데이터로 바로 활용할 수 있다.
llamaindex_tools.py에서 에이전트 도구로 연결되는 메서드가 바로 이retrieve()이다.
-
두 메서드 비교
query()retrieve()LLM 호출 O (요약) X 반환 형식 자연어 문자열 JSON 유사도 점수 X O 에이전트 도구 활용 어려움 적합함 사용 목적 사람이 읽는 요약 에이전트 후처리
7. reset(): 안전한 재빌드
def reset(self) -> None:
   driver = GraphDatabase.driver(self._neo4j_uri, auth=(...))
   with driver.session() as session:
      session.run("MATCH (n:NotionCampaign) DETACH DELETE n")
   driver.close()
   self._vector_store = Neo4jVectorStore(...)
self._index = Nonebuild_index()를 그냥 재실행하면 기존 CollectedAdRecord 노드 위에 새 벡터가 중복으로 쌓인다. reset()은 재빌드 전에 기존 데이터를 완전히 비워주는 역할을 한다.
reset()은 총 3단계로 동작한다.
- Neo4j에서
CollectedAdRecord노드 전체 삭제
DETACH DELETE로 노드와 연결된 관계를 함께 제거한다.
CollectedAdRecord레이블만 정확히 타겟하기 때문에Influencer,InfluencerEmbedding등 다른 노드에는 영향이 없다. Neo4jVectorStore재초기화
삭제 후 기존self._vector_store인스턴스는 이미 삭제된 인덱스를 바라보고 있는 상태이다.
동일한 설정값으로 새 인스턴스를 생성해 깨끗한 상태로 교체한다.self._index = None
메모리에 캐싱된 인덱스 참조를 초기화한다. 이후get_index()호출 시 새로 로드하도록 강제한다.
build_collected_ad_index.py에서 항상 reset() → build_index() 순서로 호출하는 이유가 바로 이 때문이다.
🌟 build_collected_ad_index.py 파일 분석
1. 파일 소개
이 파일은 CollectedAdIndex의 실행 진입점 스크립트이다.
클래스 로직은 collected_ad_index.py에 모두 있고, 이 스크립트는 그것을 실제로 언제 실행할지 결정하는 역할만 한다.
CSV 데이터가 바뀌었을 때, 즉 새로운 광고 캠페인이 추가되거나 기존 데이터가 수정된 경우 이 스크립트를 실행해 벡터 인덱스를 최신 상태로 갱신한다.
앱 실행 중에는 get_index()로 기존 인덱스를 로드하기 때문에 이 스크립트를 따로 실행할 필요가 없고, 데이터 변경 시에만 수동으로 한 번 실행하는 오프라인 파이프라인이다.
빌드 스크립트는 다음 명령을 통해 실행할 수 있다.
uv run python scripts/build_collected_ad_index.py2. 전체 코드 + 흐름 분석
container = Container.get_instance()
collected_ad_index = container.collected_ad_index()
collected_ad_index.reset()
collected_ad_index.build_index()- 1단계: DI 컨테이너에서 인스턴스 가져오기
container = Container.get_instance() collected_ad_index = container.collected_ad_csv_index()CollectedAdIndex를 직접 생성하지 않고Container에서 꺼낸다.
Neo4j 연결 정보(uri,username,password)와 CSV 경로를 스크립트에서 직접 하드코딩하지 않아도 되고,settings.py에서 환경변수로 관리되는 설정값이 자동으로 주입된다.
싱글톤이기 때문에 앱 전체에서 같은 인스턴스를 공유한다.
- 2단계: 기존 인덱스 초기화
collected_ad_index.reset()reset()없이build_index()를 바로 실행하면 기존CollectedAdRecord노드 위에 새 백터가 중복으로 쌓인다.
항상reset()→build_index()순서를 지켜야 한다.
- 3단계: 인덱스 빌드
CSV를 읽어 Document로 변환하고 임베딩 벡터를 생성해 Neo4j에 저장한다.collected_ad_index.build_index()
완료되면 처리된 Document 수가 출력된다.
3. 테스트 검색 쿼리
test_queries = [
   "뷰티 화장품 광고에 참여한 인플루언서",
   "피트니스 단백질 쉐이크 캠페인 성과",
   "테크 가전 리뷰 광고 사례",
]

for query in test_queries:
   result = collected_ad_index.retrieve(query, top_k=3)
   print(result)
인덱스 빌드 직후 3개의 쿼리로 검색이 정상 동작하는지 바로 확인한다.
별도의 테스트 파일 없이 스크립트 실행 한 번으로 빌드와 검증을 동시에 끝낼 수 있다.
3개 쿼리는 각각 다른 카테고리를 커버하도록 의도적으로 구성되어 있다.
| 쿼리 | 검증 목적 |
|---|---|
"뷰티 화장품 광고에 참여한 인플루언서" | 카테고리 + 인플루언서 맥락 검색 |
"피트니스 단백질 쉐이크 캠페인 성과" | 제품 + 성과 데이터 검색 |
"테크 가전 리뷰 광고 사례" | 제품 카테고리 + 콘텐츠 형식 검색 |
query() 대신 retrieve()를 사용하기 때문에 유사도 score와 metadata가 JSON으로 출력된다.
점수가 낮거나 엉뚱한 결과가 나오면 Document 텍스트 구성이나 임베딩 모델 설정을 재검토하는 기준점이 된다.
🌟 container.py 파일 분석
1. 파일 소개
container.py는 애플리케이션 전체의 의존성 주입(DI) 컨테이너 역할을 하는 파일이다.
Neo4j 연결, LlamaIndex 인덱스, Agent 서비스 등 모든 주요 인스턴스를 한 곳에서 생성하고 관리한다.
Container 클래스 자체가 싱글톤으로 동작해 애플리케이션 전반에서 동일한 인스턴스를 공유한다.
이 글에서는 CollectedAdIndex와 직접 연관된 두 부분만 살펴본다.
- LlamaIndex 글로벌 설정:
CollectedAdIndex를 포함한 모든 LlamaIndex 인덱스가 공유하는 임베딩 모델과 LLM 설정 collected_ad_index()싱글톤:settings에서 Neo4j 연결 정보와 CSV 정보를 가져와CollectedAdIndex에 주입하는 부분
2. LlamaIndex 글로벌 설정
def __init__(self, settings=None):
   self.settings = settings or Settings()
   ...
   if self.settings.llm_provider == "openai":
      LlamaSettings.embed_model = OpenAIEmbedding(...)
      LlamaSettings.llm = OpenAILLM(...)
   elif self.settings.llm_provider == "anthropic":
      LlamaSettings.embed_model = OllamaEmbedding(...) # 임베딩은 Ollama 유지
      LlamaSettings.llm = AnthropicLLM(...)
   else: # ollama (기본값)
      LlamaSettings.embed_model = OllamaEmbedding(...)
LlamaSettings.llm = OllamaLLM(...)LlamaSettings는 LlamaIndex의 글로벌 설정 객체이다. 여기에서 embed_model과 llm을 한 번 설정해두면 InfluencerVectorIndex, MatchHistoryIndex 등 모든 인덱스 클래스가 별도 설정 없이 자동으로 이 값을 사용한다. 각 인덱스 클래스에서 임베딩 모델을 따로 주입받지 않아도 되는 이유가 여기에 있다.
Container.__init__에서 설정하기 때문에 컨테이너 인스턴스가 생성되는 시점에 즉시 적용된다.
llm_provider에 따라 세 가지로 분기한다.
| provider | embed_model | llm |
|---|---|---|
openai | OpenAiEmbedding | OpenAILLM |
anthropic | OllamaEmbedding | AnthropicLLM |
ollama (기본값) | OllamaEmbedding | OllamaLLM |
anthropic 분기에서 임베딩 모델로 OllamaEmbedding을 사용하는 점이 눈에 띈다. Anthropic은 별도의 임베딩 API를 제공하지 않기 때문에, LLM은 Anthropic을 쓰더라도 임베딩은 Ollama로 유지하는 혼합 구성을 택했다.
3. collected_ad_index() 싱글톤
def collected_ad_index(self) -> CollectedAdIndex:
   """과거 광고 데이터 벡터 인덱스 (싱글턴)"""
   if self._collected_ad_index is None:
      self._collected_ad_index = CollectedAdIndex(
         neo4j_uri=self.settings.neo4j_uri,
         neo4j_username=self.settings.neo4j_username,
         neo4j_password=self.settings.neo4j_password,
      )
return self._collected_ad_indexself._collected_ad_index가 None인 경우에만 인스턴스를 생성하고, 이후 호출에서는 기존 인스턴스를 그대로 반환한다.
build_collected_ad_index.py와 llamaindex_tools.py 양쪽에서 container.collected_ad_index()를 호출해도 항상 동일한 인스턴스를 공유한다.
주입되는 값은 Neo4j 연결 정보 3가지뿐이다. csv_path는 별도로 주입하지 않아 CollectedAdIndex 생성자의 기본값인 ./data/influencer_ads_collected_notion.csv를 그대로 사용한다.
CSV 경로를 바꿀 필요가 있다면 build_collected_ad_index.py에서 직접 인스턴스를 생성하거나 settings.py에 별도 설정값을 추가해야 한다.
🌟 llamaindex_tools.py 파일 분석
1. 파일 소개
이 파일은 LlamaIndex 인덱스 클래스들을 LangChain @tool 데코레이터로 감싸 Agent가 직접 호출할 수 있는 도구로 변환하는 역할을 한다. 크게 두 가지 역할을 한다.
- 도구 정의: 각 인덱스 클래스의 검색 메서드를 Agent 도구로 래핑한다.
- 도구 노출:
LLAMAINDEX_TOOLS리스트로 묶어agent_factory.py에 일괄 전달한다.
파일 안에 도구가 5개 정의되어 있지만, 이 글에서는 Notion CSV 인덱스와 직접 연결된 search_collected_ad_data 하나에 집중한다.
이 파일의 전체 구조나 도구 공통 구조를 알고 싶다면, 이 글을 참고하면 된다.
2. search_collected_ad_data() 상세 분석
@tool
def search_collected_ad_data(query: str) -> str:
   """수집한 과거 인플루언서 광고 캠페인 데이터를 검색합니다.

   실제 인스타그램/유튜브에서 수집한 광고 캠페인 원본 데이터를 기반으로 검색합니다.
   인플루언서, 광고주, 제품, 성과(좋아요/댓글/조회수), 콘텐츠 형식 등
   실제 집행된 광고 데이터를 자연어로 검색할 때 사용하세요.
   예: "뷰티 화장품 광고에 참여한 인플루언서",
       "피트니스 관련 단백질 제품 캠페인 사례",
       "팔로워 10만 이상 인플루언서의 광고 성과"
    """
    container = Container.get_instance()
    collected_ad_index = container.collected_ad_index()
    results = collected_ad_index.retrieve(query, top_k=5)
    return results
구현 자체는 단순하다. container에서 CollectedAdIndex 인스턴스를 꺼내 retrieve()를 호출하고 JSON 결과를 그대로 반환한다. 핵심은 구현보다 docstring에 있다.
LangChain Agent는 도구를 선택할 때 docstring을 읽고 어떤 상황에서 이 도구를 써야 하는지 판단한다. docstring에 3가지 정보가 담겨 있다.
- 데이터 출처: "실제 인스타그램/유튜브에서 수집한 광고 캠페인 원본 데이터"
➡️ seed 데이터가 아닌 실제 집행 이력임을 명시 - 검색 가능한 필드: 인플루언서, 광고주, 제품, 성과, 콘텐츠 형식
➡️ 에이전트가 어떤 질문에 이 도구를 쓸지 범위를 알려줌 - 예시 쿼리 3개: 에이전트가 쿼리를 어떻게 구성해야 하는지 패턴을 제시
🌟 회고
📝 광고 집행 이력 기반 시맨틱 검색
이번 작업 전까지는 인플루언서의 프로필 정보(카테고리, 팔로워 수, 플랫폼 등)만 검색할 수 있었다. 즉, "뷰티 카테고리 인플루언서를 찾아줘"는 가능했지만, "올리브영과 실제로 협업한 경험이 있는 인플루언서를 찾아줘"는 불가능했다. 광고 집행 이력 자체가 검색 대상이 아니었기 때문이다.
이번에 수집된 광고 캠페인 데이터를 벡터 인덱스에 적재하면서, 실제 협업 이력 기반의 시맨틱 검색이 가능해졌다. 카테고리 필터로는 절대 찾을 수 없었던 맥락까지 검색 범위에 들어온 셈이다.
📝 도구 종속 네이밍에서 벗어나기
NotionCampaign, notion_ad처럼 특정 도구 이름을 그대로 쓰던 네이밍을 CollectedAdRecord, collected_ad로 바꾼 것도 의미 있는 변화였다.
처음에는 실제 인스타그램 광고 데이터를 Notion 표에 직접 정리하고, 그걸 CSV로 내보내서 사용했다. 그러다 보니 매번 Notion에서 수동으로 내보내야 하는 비효율이 생겼고, 결국 CSV를 자동으로 생성해주는 코드를 따로 구현하게 되었다.
이 시점에서 "이건 더 이상 Notion 전용 데이터가 아니다"라는 게 명확해졌고, 네이밍도 자연스럽게 바꾸게 되었다.
데이터 출처가 Notion이든, 다른 어디든, 파이프라인은 수집된 광고 데이터를 처리한다는 본질에 집중해야 한다. 이를 통해 이름 하나가 코드의 유연성과 확장 가능성을 결정한다는 걸 느꼈다.
