0. 프롤로그: 클럭(Clock)의 한계를 넘어서
지난 포스팅에서 폰 노이만 구조의 병목 현상에 대해 다뤘다. 하지만 CPU 엔지니어들은 단순히 병목을 해결하는 것에 그치지 않고, "어떻게 하면 클럭당 처리량(IPC: Instructions Per Clock)을 늘릴 수 있을까?"를 고민했다.
명령어 하나가 끝날 때까지 기다렸다가 다음을 실행하는 건 하수다. 진정한 속도는 "겹쳐서 실행하기"에서 나온다. 오늘은 현대 CPU 성능의 핵심인 파이프라이닝(Pipelining)과, 멈추지 않기 위해 미래를 점치는 분기 예측(Branch Prediction)의 세계를 파헤쳐 본다.
1. 파이프라이닝 (Pipelining): 빨래방 이론

CPU가 명령어를 처리하는 과정은 일반적으로 4단계로 나뉜다: Fetch(인출) → Decode(해석) → Execute(실행) → Writeback(기록).
파이프라이닝이 없는 CPU(Single Cycle)는 한 명령어가 4단계를 모두 마쳐야 다음 명령어를 가져온다. 이는 마치 세탁기가 돌아가는 동안 건조기는 놀고 있는 것과 같다.
1.1. 파이프라이닝의 적용
현대 CPU는 각 단계를 쉼 없이 돌린다.
- 명령어 A가
Decode될 때, - 명령어 B를
Fetch한다.
마치 빨래방에서 [세탁]→[건조]→[개기]를 손님마다 엇갈리게 진행하여, 쉴 새 없이 공장을 돌리는 것과 같다. 이로 인해 이론적으로는 매 클럭(Tick)마다 명령어 하나가 완료되는 엄청난 처리량(Throughput)을 얻게 된다.
2. 파이프라인의 적: 해저드 (Hazard)
하지만 세상은 이상적이지 않다. 파이프라인을 멈추게(Stall) 만드는 3가지 방해꾼이 존재하는데, 이를 해저드(Hazard)라고 한다.
- 구조적 해저드 (Structural Hazard): 메모리 포트가 하나라서 Fetch와 Write를 동시에 못 할 때. (→ 해결책: 하버드 구조 L1 캐시 사용)
- 데이터 해저드 (Data Hazard): 앞 명령어의 계산이 안 끝났는데 뒷 명령어가 그 결과값을 필요로 할 때. (→ 해결책: Data Forwarding)
- 제어 해저드 (Control Hazard): (가장 치명적 ⭐)
if문 같은 분기를 만났을 때, 다음 명령어로True쪽을 가져와야 할지False쪽을 가져와야 할지 모르는 상황.
📝 Velog 추가 섹션: [심화] 전방 전달 (Data Forwarding) - 기다림을 없애는 숏컷
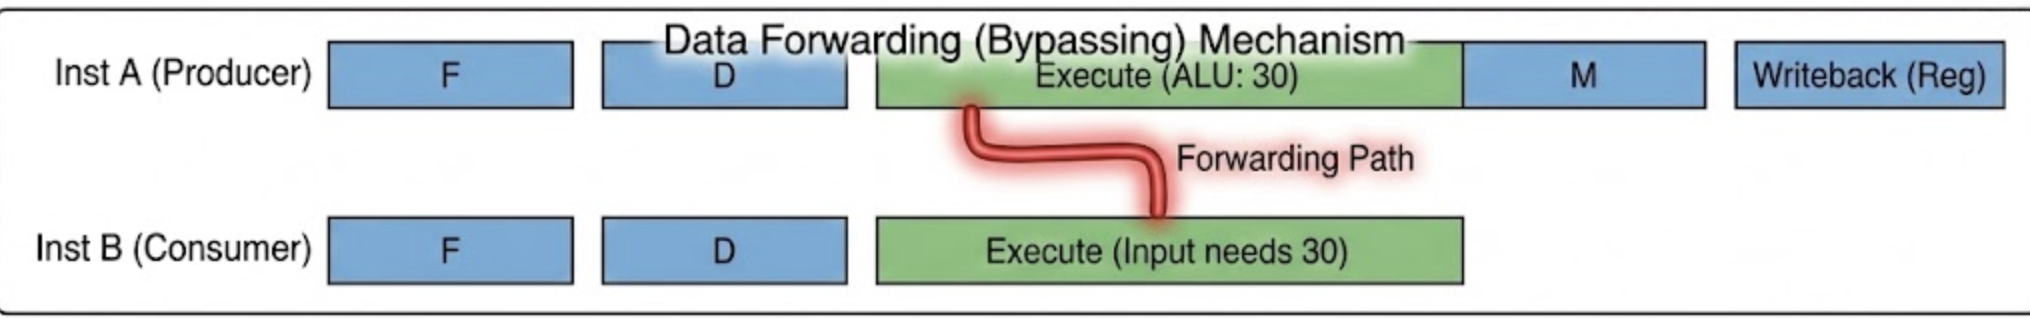
데이터 해저드(Data Hazard)는 앞 명령어의 결과가 아직 레지스터에 저장(Writeback)되지 않았는데, 뒷 명령어가 그 값을 필요로 할 때 발생한다.
가장 무식한 해결책은 값이 저장될 때까지 파이프라인을 멈추는 Stall(대기)이지만, 이는 성능 저하를 일으킨다. 똑똑한 CPU는 전방 전달(Data Forwarding, 또는 Bypassing)이라는 기술로 이 문제를 해결한다.
1. 문제 상황: "아직 냉장고에 안 넣었어!"
int a = 10 + 20; // (1) 결과 30이 나옴
int b = a - 5;   // (2) 30이 필요함
- (1)번 명령어가
Execute단계에서30을 계산했다. 하지만 이 값이 레지스터(냉장고)에 영구 저장되려면Writeback단계까지 가야 한다. (아직 2단계나 남음) - (2)번 명령어는 당장
Execute를 해야 하는데, 레지스터를 열어보니 아직30이 없다. - Stall: 결국 (1)번이 끝날 때까지 (2)번은 하염없이 기다려야 한다.
2. 해결책: "그냥 도마에서 바로 넘겨!" (Forwarding)
CPU 설계자들은 깨달았다. "어차피 (1)번의 Execute 단계가 끝나면 계산 결과(30)는 이미 CPU 내부 어딘가(파이프라인 레지스터)에 존재하잖아?"
굳이 레지스터 파일(Writeback)까지 갔다가 다시 가져올 필요가 없다.
그냥 전선(Wire)을 하나 더 연결해서, 연산 결과를 다음 명령어의 입력으로 바로 쏘아주면 된다.
- Before (Stall): 연산 끝 -> 메모리 -> [저장] -> [다시 읽기] -> 다음 연산 (느림)
- After (Forwarding): 연산 끝 -> [지름길(Bypass)] -> 다음 연산 (빠름 🚀)
3. 직관적인 비유: 주방의 연계 플레이
- 요리사 A (앞 명령어): 양파를 썰었다. (연산 완료)
- 원칙: 썬 양파를 밀폐 용기에 담아 냉장고에 넣는다(Writeback).
- 요리사 B (뒷 명령어): 냉장고를 열어 양파를 꺼내 볶으려 한다.
- Stall: A가 냉장고에 넣고 문 닫을 때까지 B는 멍하니 서 있어야 한다.
- Forwarding: A가 양파를 썰자마자, 냉장고에 넣기도 전에 칼질한 도마째로 B의 프라이팬에 부어준다. B는 딜레이 없이 바로 요리를 시작한다.
💡 Senior Insight:
물론 모든 상황에서 포워딩이 가능한 건 아니다. 데이터를 계산하는 게 아니라, 메모리에서 아주 느리게 읽어와야 하는 경우(Load-Use Hazard)에는 포워딩을 해도 시간이 부족해서 어쩔 수 없이 1 사이클을 쉬어야(Stall) 할 때도 있다. 컴파일러는 이런 상황을 피하기 위해 명령어 순서를 요리조리 바꾸는(Reordering) 최적화를 수행한다.
3. 제어 해저드의 극복: 추측 실행 (Speculative Execution)
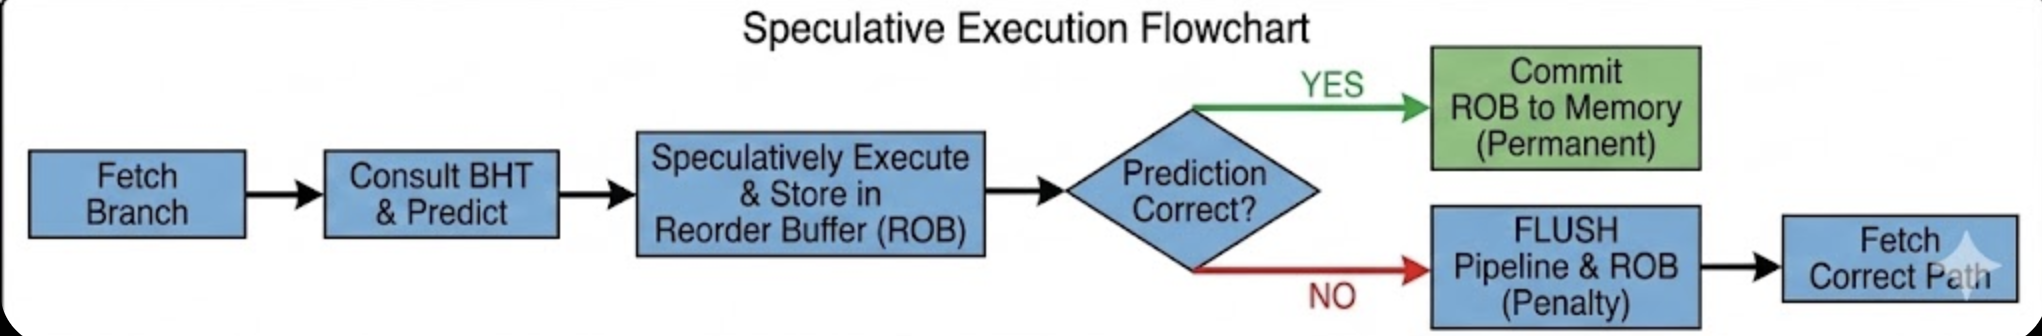
CPU는 멈추는 것을 죽기보다 싫어한다. 그래서 if문을 만나면 결과를 기다리는 대신, 도박(예측)을 감행한다.
3.1. 비유: 성격 급한 샌드위치 알바생
- 상황: 점심시간, 줄이 길다.
- 예측: 단골손님 김철수 씨 입장. "저 사람은 항상 에그마요만 먹어."
- 추측 실행: 주문도 안 했는데 미리 빵을 굽고 에그마요를 바른다. (아직 포장은 안 함)
- 검증:
- "에그마요 주세요" (적중) → 바로 포장해서 건네줌. (대기시간 0초)
- "오늘은 스테이크요" (실패) → 만들던 거 쓰레기통에 버리고 새로 만듦. (Flush 비용 발생)
3.2. 기술적 메커니즘 (Step-by-Step)
이 "알바생의 감"과 "만들던 샌드위치 보관함"은 CPU 내부의 특수 장치들로 구현된다.
- BHT (Branch History Table): "과거 기록 수첩". 해당 분기문이 지난 100번 동안
True였는지False였는지 통계를 기록한다. CPU는 이걸 보고 찍는다. - ROB (Reorder Buffer): "임시 대기실". 예측해서 실행한 결과(
a=30)를 바로 메모리에 쓰지 않고, 이곳에 임시 저장한다. - Commit / Flush:
- 예측 성공: ROB의 값을 메모리에 반영(Commit).
- 예측 실패: ROB를 싹 비우고(Flush), 파이프라인을 초기화한 뒤 올바른 경로로 재실행.
4. [Java Backend] 실무 연결: 개발자가 알아야 할 것
하드웨어의 이런 특성은 소프트웨어 성능에 직접적인 영향을 미친다.
(1) 정렬된 배열이 더 빠른 이유 (Branch Prediction)
// Case A: 정렬된 데이터 (TTTTTFFFFF...) -> 패턴 명확 -> CPU 예측 성공 -> 빠름 🚀
// Case B: 랜덤 데이터 (TFTFTFFT...) -> 패턴 없음 -> CPU 예측 실패(Flush 반복) -> 느림 🐢
if (data[i] > 128) { sum += data[i]; }
Sorted Array는 BHT의 예측 적중률을 100%에 가깝게 만들어주므로, 파이프라인이 풀가동되어 훨씬 빠르다.
(2) 다형성의 비용 (Indirect Branch Prediction)
// Dog, Cat, Bird가 섞여 있다면?
animal.cry();
이 경우 if문(O/X)이 아니라 "어떤 함수의 주소로 점프할까?"를 맞춰야 한다. CPU는 BTB(Branch Target Buffer)를 사용해 주소를 예측한다. 구현체가 하나뿐이거나(Monomorphic), 타입이 일정하다면 CPU는 미리 해당 코드를 로딩해 실행할 수 있다. 반대로 타입이 계속 바뀌면 예측 실패 비용을 치러야 한다.
(3) 루프와 데이터 프리패칭 (Prefetching)
CPU는 배열처럼 접근 패턴이 일정(예: +4바이트씩 이동)하면, Prefetcher를 가동해 사용자가 요청하기도 전에 데이터를 미리 캐시에 올려둔다. LinkedList가 느린 이유는 메모리 주소가 불규칙하여 이 프리패칭 기능을 활용할 수 없기 때문이다.
5. 심화 Insight: 파이프라인 깊이와 클럭의 딜레마
"그럼 파이프라인 단계를 100개로 쪼개면 클럭을 엄청 높일 수 있지 않을까?"
실제로 인텔이 과거(펜티엄 4)에 시도했던 방식(Super-pipelining)이다. 하지만 실패했다.
-
이유: 파이프라인이 깊을수록, 분기 예측이 한 번 틀렸을 때 버려야 할 작업량(Flush Penalty)이 너무 커진다.
-
The Iron Law:
-
현대의 전략: 무작정 클럭(Frequency)을 높이는 대신, 파이프라인 깊이를 적절히 유지(14~19단계)하면서 한 번에 여러 명령어를 처리하는(IPC 향상) 슈퍼스칼라(Superscalar) 방식으로 진화했다.
6. 마무리
CPU는 단순히 계산만 하는 기계가 아니다. 멈추지 않기 위해 끊임없이 과거를 학습(BHT)하고, 미래를 예측하며, 틀릴 경우를 대비해 임시 저장소(ROB)까지 운영하는 고지능 시스템이다.
우리가 작성하는 코드의 패턴(정렬 여부, 객체 타입의 일관성 등)이 이 고지능 시스템을 도와줄 수도, 방해할 수도 있다는 점을 기억하자. "Predictable Code is Fast Code."