Django 경험을 바탕으로 FastAPI를 빠르게 익히고, 실제 AI API(LLM, 이미지 생성, TTS)와 연결하는 과정을 정리한 글입니다.
1. Django와 FastAPI의 차이점
| 항목 | Django | FastAPI |
|---|---|---|
| 라우팅 | urls.py 별도 파일 | 데코레이터로 직접 정의 |
| 데이터 검증 | Form / Serializer | Pydantic 자동 검증 |
| 비동기 | 기본 동기 | async/await 기본 지원 |
| API 문서화 | 별도 설정 필요 | /docs 자동 생성 |
FastAPI는 Django와 달리 다음과 같은 특징이 있습니다.
- DB 없이도 활용 가능: Django는 Model(DB)을 중심으로 설계되지만, FastAPI는 DB 없이 AI 모델 서빙 등에 많이 활용됩니다.
- Template 미제공: Django REST Framework처럼 API 전용으로 사용합니다.
- ORM, Admin, Auth 미제공: 필요한 경우 서드파티 패키지를 설치해서 사용합니다.
2. FastAPI 실습 환경 세팅
가상환경 생성 및 활성화
python -m venv venv
source venv/Scripts/activate
패키지 설치 (requirements.txt)
fastapi==0.128.0
uvicorn==0.40.0
python-dotenv==1.2.1
requests==2.32.5fastapi: FastAPI 패키지uvicorn: HTTP 서버 패키지 (FastAPI는 Django와 달리 자체 서버가 없음)python-dotenv: 환경변수 관리requests: REST 요청용 패키지
기본 서버 실행 (main.py)
from fastapi import FastAPI

app = FastAPI()  # 웹 API 서버 앱 객체 생성

@app.get("/")
async def root():
    return {"message": "Hello World"}
uvicorn main:app --reloadhttp://127.0.0.1:8000— 기본 응답 확인http://127.0.0.1:8000/docs— 자동 생성된 API 문서 확인
3. API 테스트
Postman vs curl
| 도구 | 장점 | 단점 |
|---|---|---|
| Postman | GUI 기반, 직관적, 컬렉션으로 요청 관리 가능 | 리소스 사용량 있음, 팀 협업 기능은 유료 |
| curl | 가볍고 빠름, 스크립트 자동화 적합, 대부분 OS에 기본 포함 | 명령어 문법 학습 필요 |
curl 기본 사용법
curl -X GET http://127.0.0.1:8000/쉘 스크립트로 테스트 자동화
반복적인 API 테스트를 매번 수동으로 수행하는 대신, 쉘 스크립트로 자동화할 수 있습니다.
# test_api.sh
BASE_URL="http://127.0.0.1:8000"
echo "API 테스트 시작"
echo ""
echo "------------------------------"
echo ""
echo "1. /hello GET 요청 결과"

response=$(curl -s -X GET "$BASE_URL/hello")

echo "서버 응답:"
echo "$response"
echo ""
chmod +x test_api.sh # 실행 권한 부여
./test_api.sh # 스크립트 실행4. Pydantic으로 요청/응답 타입 검증
Python은 동적 타입 언어라 런타임에서 타입을 자동으로 제한하지 않습니다. Pydantic을 사용하면 입력 데이터의 타입을 자동으로 검증할 수 있습니다.
Pydantic 모델 정의
from pydantic import BaseModel

class MessageRepeatRequest(BaseModel):
    message: str
    count: int

class MessageRepeatResponse(BaseModel):
    new_message: str
    success: bool
FastAPI에 적용
@app.post("/repeat-test", response_model=MessageRepeatResponse)
def repeat_test(request: MessageRepeatRequest):
    message = request.message
    count = request.count

    repeated_message = message * count

    return MessageRepeatResponse(
        new_message=repeated_message,
        success=True
)- 잘못된 타입 입력 시 자동으로 400 에러 반환
response_model로 응답 구조도 자동 검증
curl로 POST 요청 테스트
curl -d '{"message": "hi", "count": 3}' \
    -H "Content-Type: application/json" \
    "http://127.0.0.1:8000/repeat-test"
{"new_message": "hihihi", "success": true}-d: 서버로 보낼 요청 본문(body) 데이터-H: HTTP 헤더 추가 (Content-Type으로 JSON 형식임을 서버에 알림)
5. AI 모델 서빙
API가 AI 모델의 요청과 응답을 처리하는 것을 모델 서빙이라고 합니다. LLM 외에도 Hugging Face 모델, 직접 파인튜닝한 모델 등 다양한 목적으로 사용합니다.
환경변수 설정 (.env)
GMS_KEY=your_api_key_here.gitignore
.env
venv/
__pycache__/
LLM API 연결 코드
from fastapi import FastAPI
from pydantic import BaseModel
from dotenv import load_dotenv
import os
import requests

load_dotenv(".env")

app = FastAPI()

GMS_KEY = os.getenv("GMS_KEY")
GMS_URL = "https://gms.ssafy.io/gmsapi/api.openai.com/v1"

headers = {
    "Authorization": f"Bearer {GMS_KEY}",
    "Accept": "application/json",
}

class ChatRequest(BaseModel):
    messages: list[dict]

class ChatResponse(BaseModel):
    content: str

@app.post("/api/v1/chat", response_model=ChatResponse)
def get_chat_response(chat_request: ChatRequest):
    messages = chat_request.messages

    payload_data = {"model": "gpt-5-nano", "messages": messages}
    response = requests.post(
        f"{GMS_URL}/chat/completions", headers=headers, json=payload_data
    )

    content = response.json()["choices"][0]["message"]["content"]
    return {"content": content}
테스트 스크립트 (run_test.sh)
#!/bin/bash

URL="http://localhost:8000/api/v1/chat"
MESSAGE="안녕, 간단히 자기소개 해줘"

echo "$URL 요청"
echo "메시지: $MESSAGE"
echo "----------------------------------------"

curl -X POST "$URL" \
  -H "Content-Type: application/json" \
  -d @- <<EOF
{
  "messages": [
    {"role": "user", "content": "$MESSAGE"}
  ]
}
EOF
<<EOF ... EOF는 여러 줄 JSON을 curl에 그대로 전달하기 위한 Here Document 문법입니다.
6. Response Format — 구조화된 응답 받기
LLM의 답변을 원하는 형식으로 받으려면 프롬프트를 상세히 작성해야 하지만, response_format 파라미터를 사용하면 응답 형식을 더 안정적으로 고정할 수 있습니다.
실습: 질문-답변 점수 평가 API
import json
from pydantic import BaseModel

class ChatScoreRequest(BaseModel):
    prompt: str
    answer: str

class ChatScoreResponse(BaseModel):
    score: int
    reason: str

@app.post("/api/v1/chat/score", response_model=ChatScoreResponse)
def get_chat_score(chat_score_request: ChatScoreRequest):
    prompt = chat_score_request.prompt
    answer = chat_score_request.answer

    messages = [
        {
            "role": "developer",
            "content": """너는 질문 prompt에 대한 답변 answer이 몇 점짜리인지 판단하는 시스템이다.
            질문에 대한 적절한 답변인지의 점수를 0 ~ 100점으로 리턴하라.
            또한, 해당 이유에 대해서도 reason에 기입한다.
            응답은 반드시 JSON 형식으로 작성해야 한다."""
        },
        {
            "role": "user", "content": f"prompt: {prompt}, answer: {answer}"
        }
    ]

    response_format = {
        "type": "json_schema",
        "json_schema": {
            "name": "score_response",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "score": {
                        "type": "integer",
                        "description": "질문에 대한 답변 점수를 0점부터 100점 사이로 반환",
                    },
                    "reason": {
                        "type": "string",
                        "description": "score가 도출된 이유에 대한 간단한 설명",
                    },
                },
                "required": ["score", "reason"],
                "additionalProperties": False,
            },
        },
    }

    payload_data = {
        "model": "gpt-5-nano",
        "messages": messages,
        "response_format": response_format,
    }
    response = requests.post(
        f"{GMS_URL}/chat/completions", headers=headers, json=payload_data
    )

    content_str = response.json()["choices"][0]["message"]["content"]
    result = json.loads(content_str)  # str → dict 변환
    return result
response_format 주요 파라미터
| 파라미터 | 설명 |
|---|---|
strict: True | 반드시 지정된 형식을 따르도록 강제 |
properties | 각 필드의 타입 지정 (integer, string, boolean 등) |
required | 필수 필드 명시 |
additionalProperties: False | 정의되지 않은 추가 필드 생성 방지 |
json.loads()를 통해 응답 문자열(str)을 딕셔너리(dict)로 변환해야 합니다.
7. 중간 서버 (API Gateway) 패턴
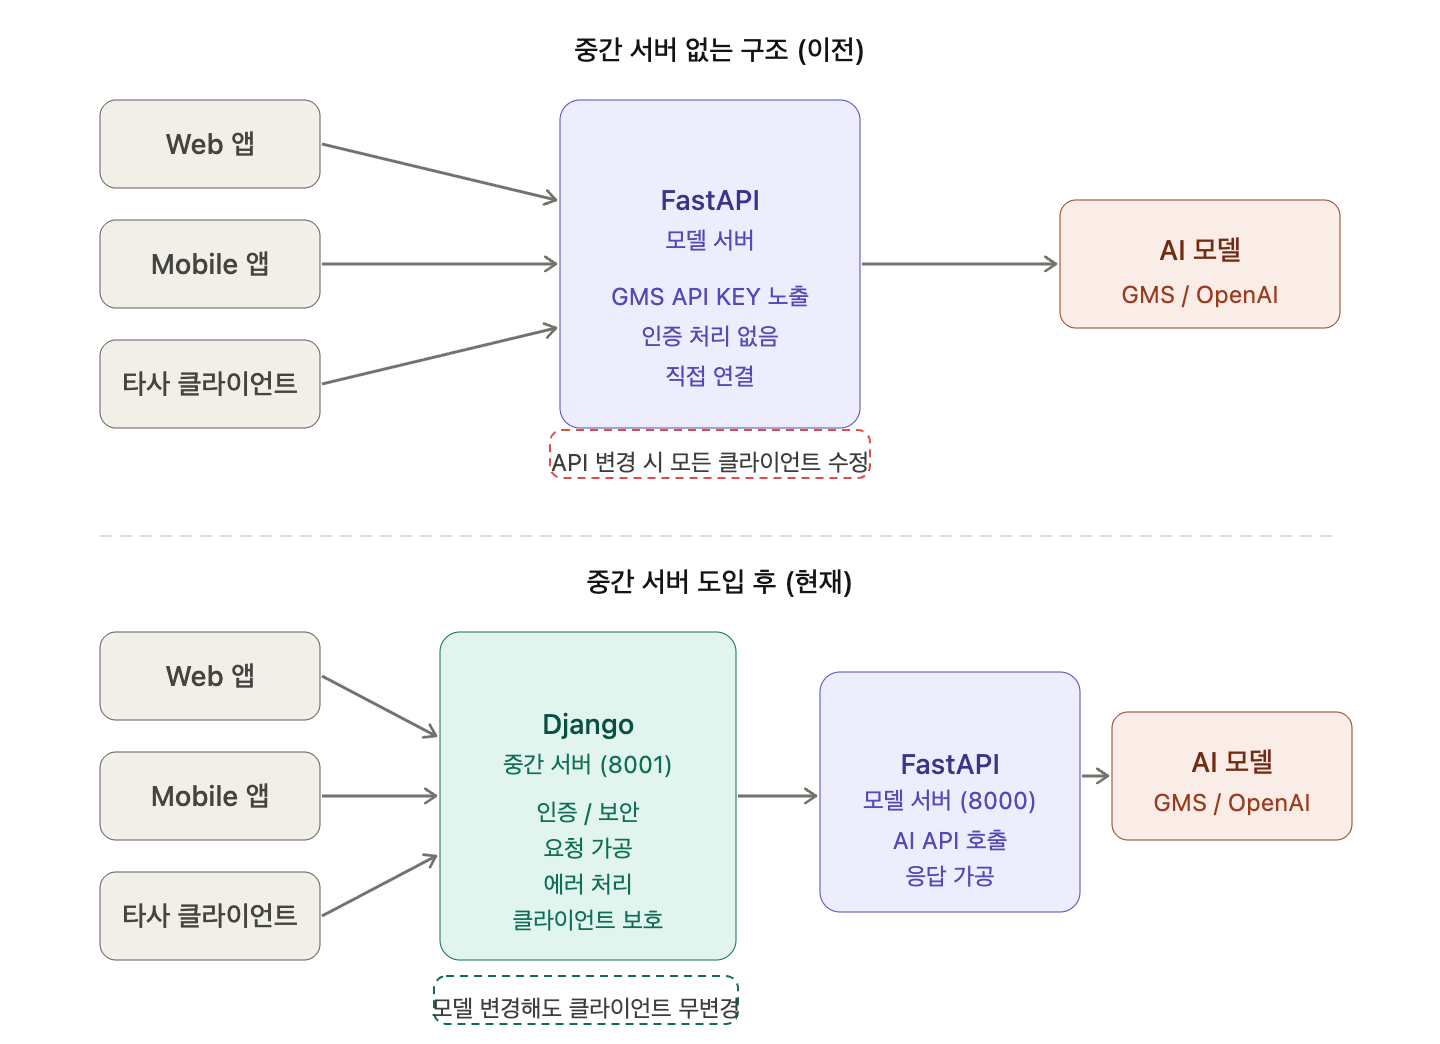
모델 서버 API에 변경사항이 생겼을 때 프론트엔드까지 함께 수정해야 한다면, 클라이언트가 여러 개인 경우 큰 문제가 됩니다.
FastAPI(모델 서버)와 프론트엔드 사이에 Django 중간 서버를 두면:
- 보안 강화: 인증된 사용자만 서비스 사용 가능
- 사용 편의성: 복잡한 API를 단순하게 래핑
- 변경 안정성: 모델 서버 변경 시 중간 서버만 수정, 프론트는 그대로
Django 중간 서버 구성
settings.py
import os
from pathlib import Path
from dotenv import load_dotenv

load_dotenv(BASE_DIR / ".env")

MODEL_SERVER_URL = os.getenv("MODEL_SERVER_URL")

INSTALLED_APPS = [
    'corsheaders',
    # ...
]

MIDDLEWARE = [
    'corsheaders.middleware.CorsMiddleware',  # 반드시 최상단에 위치
    # ...
]

CORS_ALLOW_ALL_ORIGINS = True       # 모든 Origin 허용 (개발 환경용)
CORS_ALLOW_CREDENTIALS = True       # 쿠키, 인증 헤더 전송 허용

CORS_ALLOW_METHODS = [
    "DELETE", "GET", "OPTIONS", "PATCH", "POST", "PUT",
]
.env
MODEL_SERVER_URL="http://localhost:8000/api/v1"serializers.py (Pydantic 대신 Django Serializer 사용)
from rest_framework import serializers

class ChatRequestSerializer(serializers.Serializer):
    messages = serializers.ListField(
        child=serializers.DictField()
    )

class ChatResponseSerializer(serializers.Serializer):
    content = serializers.CharField()
views.py
import requests
from django.conf import settings
from rest_framework.decorators import api_view
from rest_framework.response import Response
from rest_framework import status
from .serializers import ChatRequestSerializer, ChatResponseSerializer

@api_view(["POST"])
def chat_view(request):
    serializer = ChatRequestSerializer(data=request.data)

    if not serializer.is_valid():
        return Response(serializer.errors, status=status.HTTP_400_BAD_REQUEST)

    messages = serializer.validated_data["messages"]
    payload_data = {"messages": messages}

    try:
        model_response = requests.post(
            f"{settings.MODEL_SERVER_URL}/chat",
            json=payload_data
        )
    except requests.RequestException as e:
        return Response(
            {"error": "Model server request failed"},
            status=status.HTTP_502_BAD_GATEWAY
        )

    content = model_response.json().get("content")

    response_serializer = ChatResponseSerializer(data={"content": content})
    response_serializer.is_valid(raise_exception=True)

    return Response(response_serializer.data, status=status.HTTP_200_OK)
python manage.py runserver 0.0.0.0:8001전체 구조
각 서버의 실질적인 역할
-
FastAPI (포트 8000) — AI 전용 서버
- GMS/OpenAI에 실제 요청을 보내고 응답을 가공하는 역할만 합니다.
- AI API Key를 여기서만 관리하니 외부에 노출되지 않습니다.
- 나중에 모델을 바꾸거나 API 형식이 바뀌어도 여기만 수정하면 됩니다.
-
Django (포트 8001) — 클라이언트 전용 서버
- 클라이언트의 요청을 받아 FastAPI에 전달(프록시)합니다.
- 인증, CORS, 에러 처리 등 "서비스 운영" 관련 로직을 담당합니다.
- 클라이언트 입장에서는 FastAPI의 존재를 알 필요가 없습니다.
코드에서 핵심 차이
중간 서버 Django views.py의 핵심은 딱 이 한 줄입니다.
model_response = requests.post(
    f"{settings.MODEL_SERVER_URL}/chat",  # FastAPI 호출
    json=payload_data
)
Django가 클라이언트 요청을 받아서 → FastAPI로 그대로 전달하고 → 응답을 다시 클라이언트에 돌려줍니다. 이게 프록시 패턴입니다.
중간 서버 패턴은 역할이 다른 두 서버를 분리 운영하는 아키텍처입니다. FastAPI는 AI와 대화하고, Django는 사용자와 대화합니다.
8. 멀티모달 — 이미지 생성 & TTS
이미지 생성 API
class ImageGenerationRequest(BaseModel):
    prompt: str

class ImageGenerationResponse(BaseModel):
    url: str

@app.post("/api/v1/images/generations", response_model=ImageGenerationResponse)
def get_image_generation_response(image_generation_request: ImageGenerationRequest):
    prompt = image_generation_request.prompt

    payload_data = {"model": "dall-e-3", "prompt": prompt, "size": "1024x1024"}

    response = requests.post(
        f"{GMS_URL}/images/generations", headers=headers, json=payload_data
    )

    url = response.json()["data"][0]["url"]
    return {"url": url}
TTS API
import base64

class TTSRequest(BaseModel):
    input: str

class TTSResponse(BaseModel):
    audio_data: str

@app.post("/api/v1/audio/speech", response_model=TTSResponse)
def get_tts_response(tts_request: TTSRequest):
    input_text = tts_request.input

    response = requests.post(
        f"{GMS_URL}/audio/speech",
        headers=headers,
        json={
            "model": "gpt-4o-mini-tts",
            "input": input_text,
            "response_format": "mp3",
        },
    )
    audio_data = base64.b64encode(response.content).decode("utf-8")
    return {"audio_data": audio_data}
음성 파일(바이너리)은 JSON으로 직접 전송할 수 없으므로, base64로 인코딩해서 문자열로 변환합니다.
TTS 중간 서버 (Django)
@api_view(["POST"])
def audio_speech_view(request):
    """TTS 요청을 모델 서버로 프록시"""
    try:
        model_response = requests.post(
            f"{settings.MODEL_SERVER_URL}/audio/speech",
            json=request.data,
            timeout=60,
        )
        model_response.raise_for_status()
        return Response(model_response.json(), status=model_response.status_code)
    except requests.RequestException:
        return Response(
            {"error": "Model server request failed"},
            status=status.HTTP_502_BAD_GATEWAY,
        )
프론트엔드에서 base64 오디오 재생
<div class="input-wrapper">
    <input class="user-input" type="text" />
    <button class="send-btn">생성</button>
</div>
<div class="audio-result-container"></div>
const userInput = document.querySelector(".user-input");
const sendBtn = document.querySelector(".send-btn");
const audioResultContainer = document.querySelector(".audio-result-container");
// base64 문자열을 <audio> 태그의 src에 적용해서 재생마무리
이번 학습을 통해 FastAPI의 기본 구조부터 실제 AI API 연동까지 다뤘습니다. 핵심 흐름을 정리하면:
- FastAPI — 모델 서버 역할, AI API 호출 및 응답 가공
- Pydantic — 요청/응답 타입 자동 검증
- response_format — LLM 응답을 구조화된 JSON으로 강제
- Django 중간 서버 — 보안, 유지보수, 클라이언트 안정성 확보
- 멀티모달 — 텍스트 외에 이미지 생성, TTS까지 확장
좋습니다!