원래 개발은 전부 끝내고 리뷰형식으로 작성하려 했으나 중요한 에러를 해결한 기록을 남기고싶어 트러블슈팅부터 작성해봅니다.
간략한 소개
저는 현재 위 대회에 참여하며 MCP 개발 중입니다.
제 MCP는 서버의 로그, Metrics 를 가져와 LLM에게 분석한 결과를 알려주는 도구입니다.
사용자 서버 -> Forwarder(
py) -> MCP 서버 -> LLM -> 사용자 GPT
이렇게 흐름이 이어집니다. 포워더를 이용하여 사용자 서버의 로그를 수집합니다.
(자세한 내용은 대회 제출 후 기술하겠습니다.)
문제점
/**
     * [1] 데이터 수집 (Ingest)
     * - DB 저장
     * - 80% 초과 시 디스코드 알림
     */
    @Transactional
    public void saveMetric(String serverName, MetricIngestDto dto, String mcpToken, String discordWebhookUrl) {
        log.info("Metric 수신: {}", serverName);

        // 1. 서버 조회 및 토큰 검증
        TargetServer server = targetServerRepository.getByServerName(serverName);
        verifyToken(server, mcpToken);

        MetricIngestDto.MetricData data = dto.getData();

        // 2. 단위 변환 및 Entity 생성 (DB에 맞게 변환)
        Double cpuPercent = data.getCpuUsage() * 100.0;
        Double memUsedMb = data.getMemoryUsed() / 1024.0 / 1024.0;
        Double memMaxMb = data.getMemoryMax() / 1024.0 / 1024.0;

        ServerMetric metric = ServerMetric.createMetric(dto.getTs(), server, cpuPercent, memUsedMb, memMaxMb);

        // 3. DB 저장
        serverMetricRepository.save(metric);

        // 4. HeartBeat 갱신
        server.updateHeartbeat();

        // 5. 위험 감지 및 알림 (80% 초과 시)
        // (Memory Percent 계산)
        ...
    }
위 메소드는 Forwarder 에게 로그를 수신받는 service 로직입니다.
서버 조회 -> 로그 저장 -> HeartBeart 갱신
이런 흐름입니다.
데드락 발생
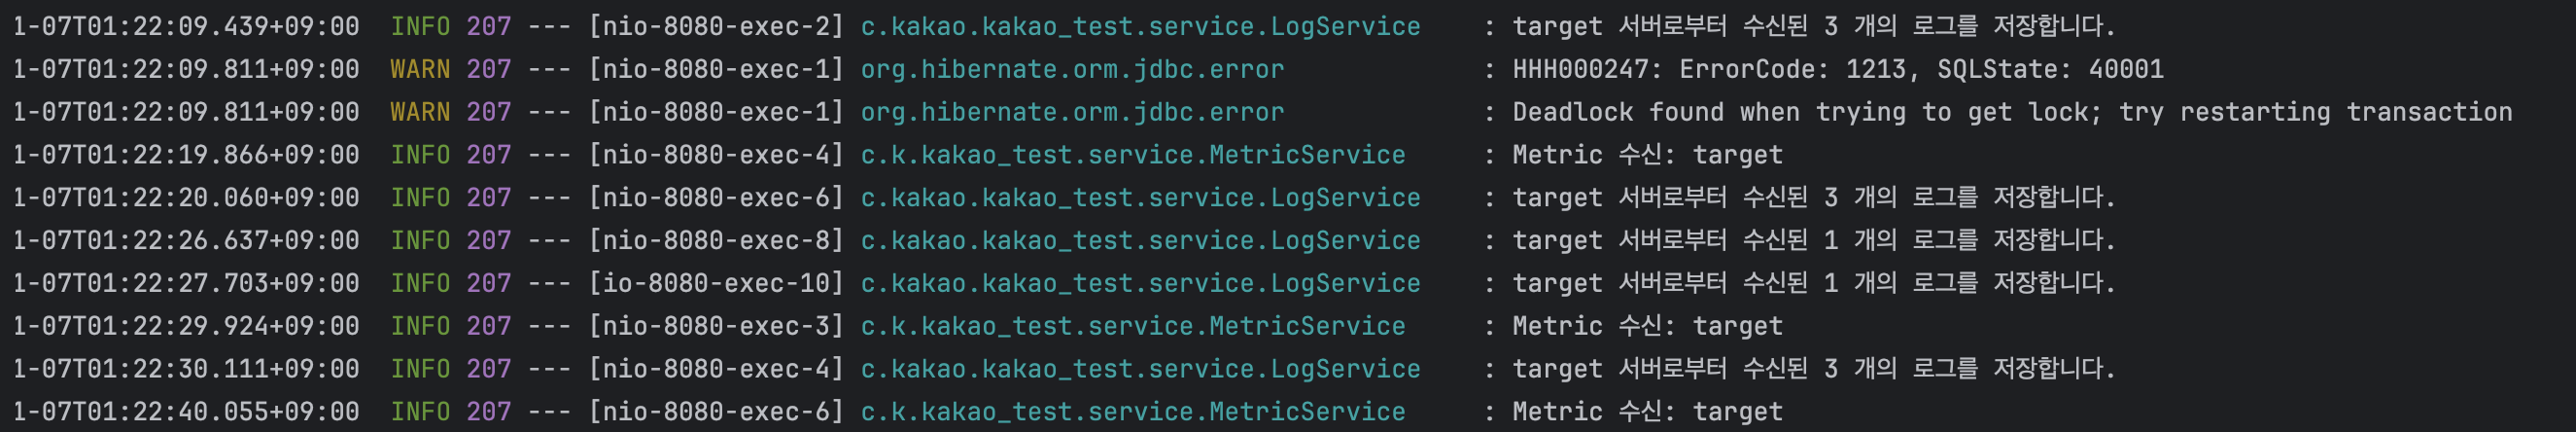
테스트 중 DeadLock이 발생했단 로그를 발생했습니다.
더 정확한 테스트를 위해 K6를 이용한 테스트를 진행했습니다.
// --- 설정 영역 ---
const BASE_URL = 'http://localhost:8080/api/servers';
const SERVER_NAME = 'target'; // DB에 등록된 서버 이름
const MCP_TOKEN = '1d5e5978-683e-4fdc-9181-27903342c923';

// 부하 테스트 시나리오 설정
export const options = {
    scenarios: {
        // 1. 데드락 유발용
        deadlock_spike: {
            executor: 'ramping-vus',
            startVUs: 0,
            stages: [
                { duration: '5s', target: 50 },  // 5초 만에 50명 동시 접속 (급상승)
                { duration: '10s', target: 50 }, // 10초간 유지 (여기서 데드락 터져야 함)
                { duration: '5s', target: 0 },   // 종료
            ],
            gracefulStop: '0s', // 테스트 끝나면 바로 끊기
        },
    },
    // 실패율이 1% 넘으면 테스트 실패로 간주
    thresholds: {
        http_req_failed: ['rate<0.01'],
        http_req_duration: ['p(95)<500'], // 95% 요청이 0.5초 안에 끝나야 함
    },
};

export default function () {
    const url = `${BASE_URL}/${SERVER_NAME}/ingest/logs`;

    const payload = JSON.stringify([
        {
            ts: Date.now(),
            level: 'INFO',
            message: `[K6 Load Test] Log message ${randomString(10)} generated by k6`,
        },
        {
            ts: Date.now(),
            level: 'WARN',
            message: `[K6 Load Test] Warning check ${randomString(8)}`,
        }
    ]);

    const params = {
        headers: {
            'Content-Type': 'application/json',
            'X-MCP-TOKEN': MCP_TOKEN
        },
    };

    // 요청 전송
    const res = http.post(url, payload, params);

    // 결과 검증
    check(res, {
        'status is 200': (r) => r.status === 200,
        'error rate check': (r) => r.status !== 500, // 500 에러(데드락)가 안 나야 함
    });

    // 너무 빠르면 로컬 PC가 못 버틸 수 있으므로 미세한 텀 (0.01초~0.1초)
    sleep(Math.random() * 0.1);
}
스크립트를 설명하자면 5초간 50개의 로그 수신을 10초간 유지합니다.
만약 DeadLock 발생이 우연이라면 실패율은 0%를 보장해야합니다.
결과
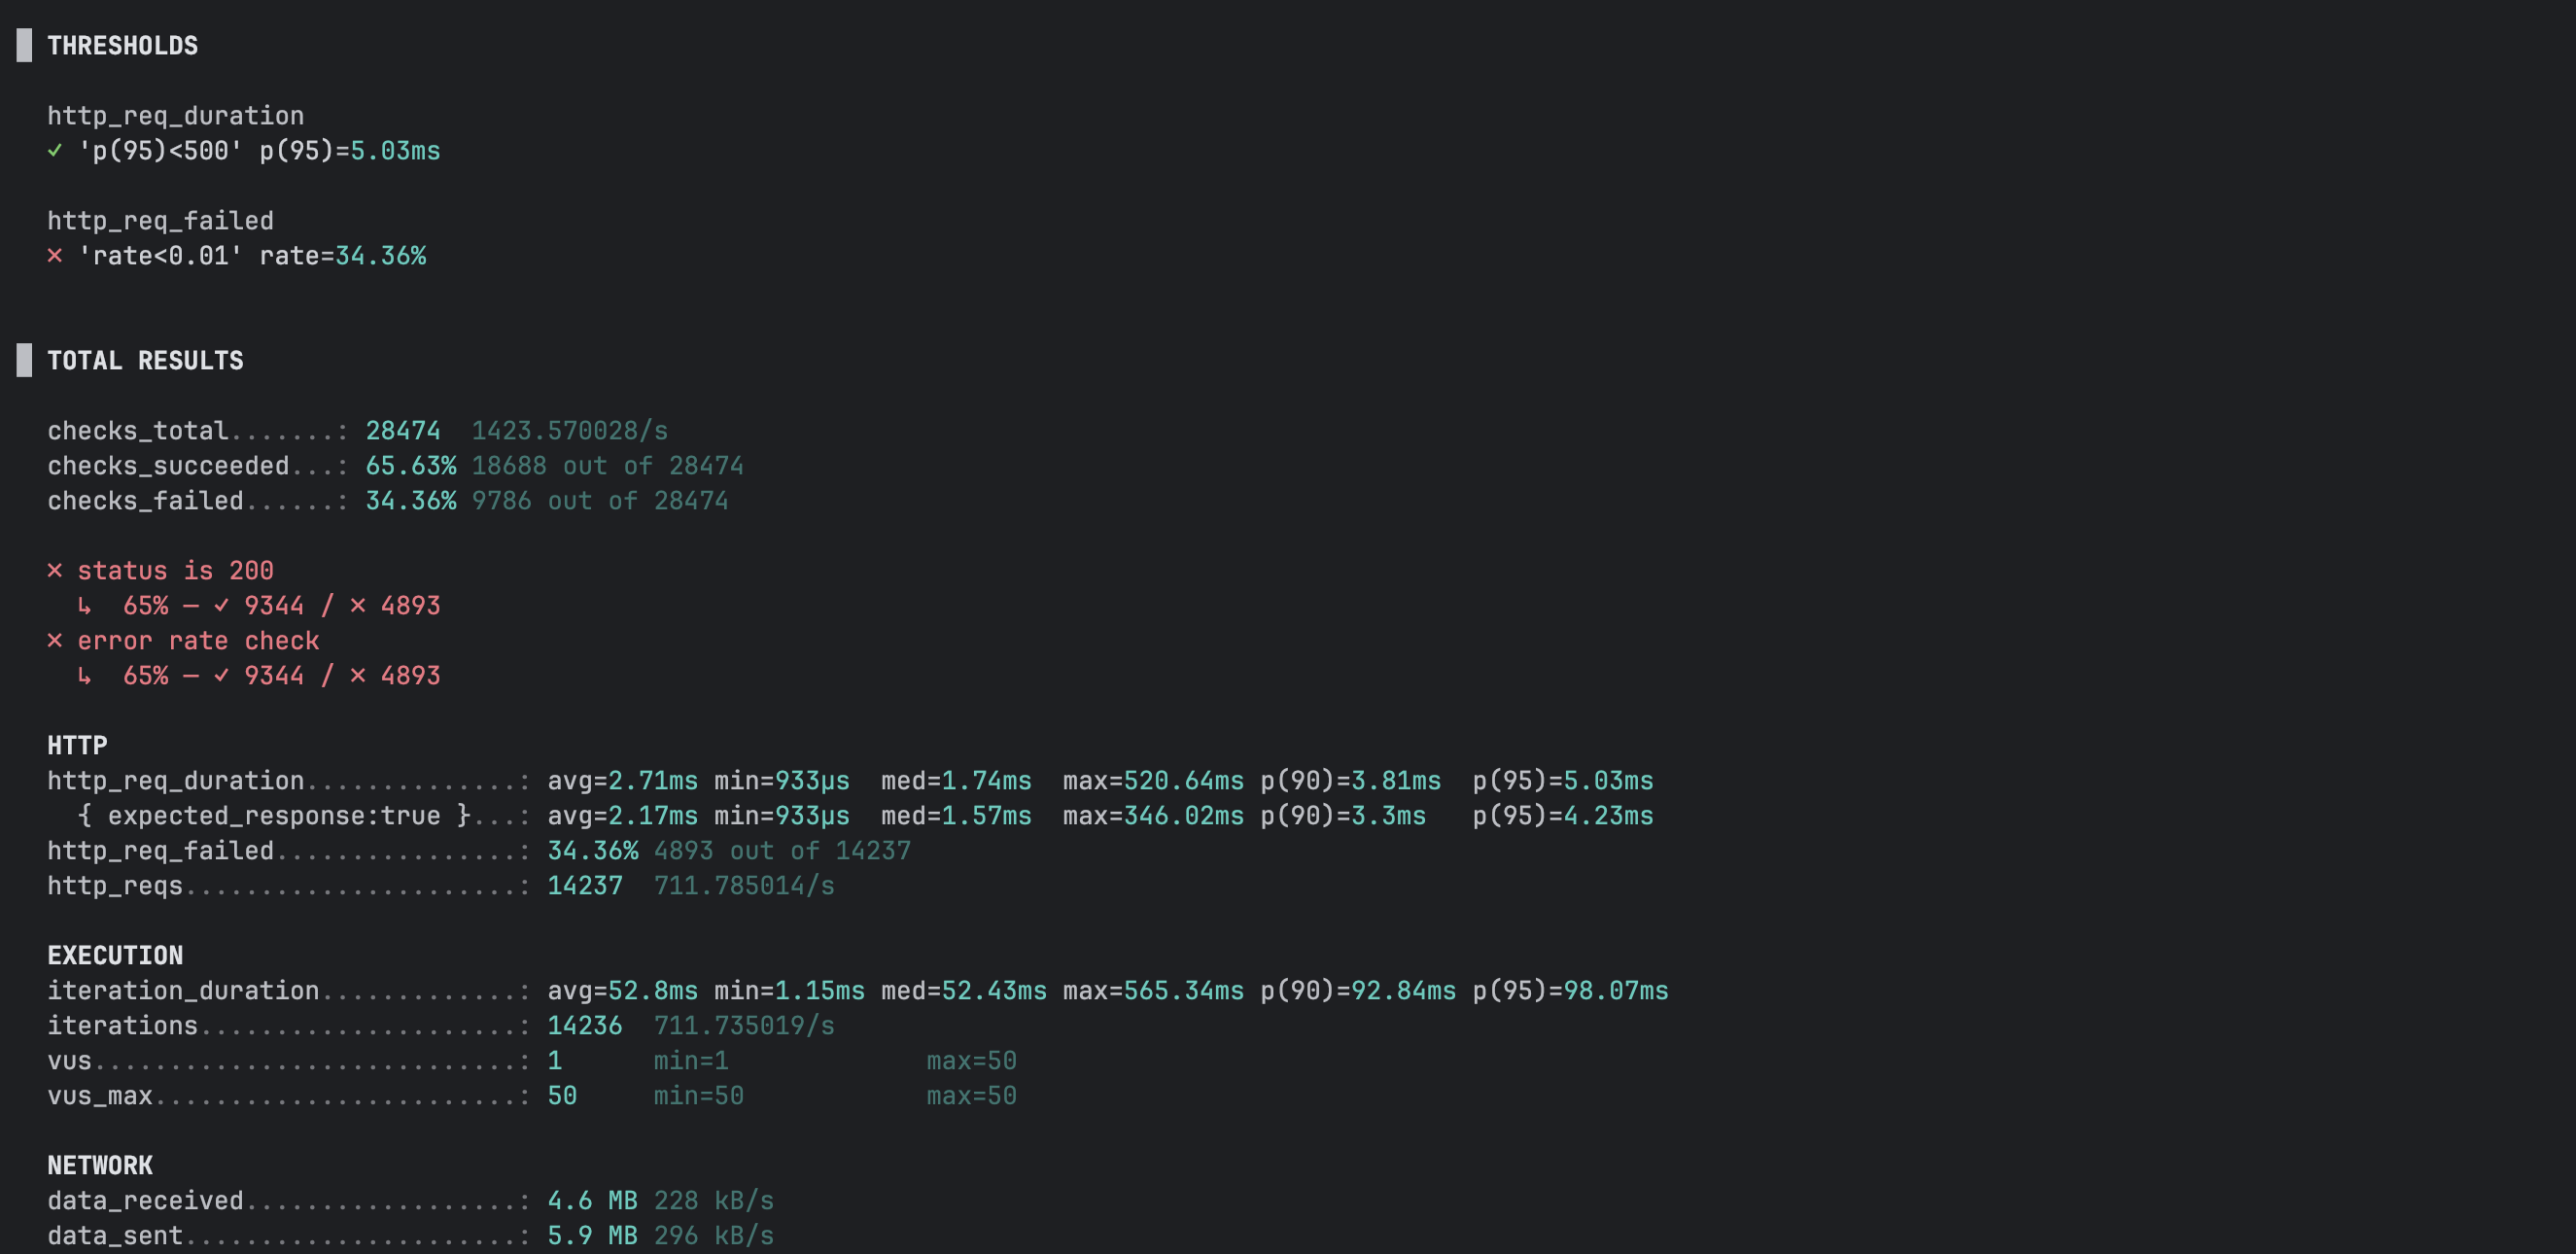
실패율이 34.36% 입니다. 즉 3개의 요청 중 1개는 오류로 수신에 실패했습니다.
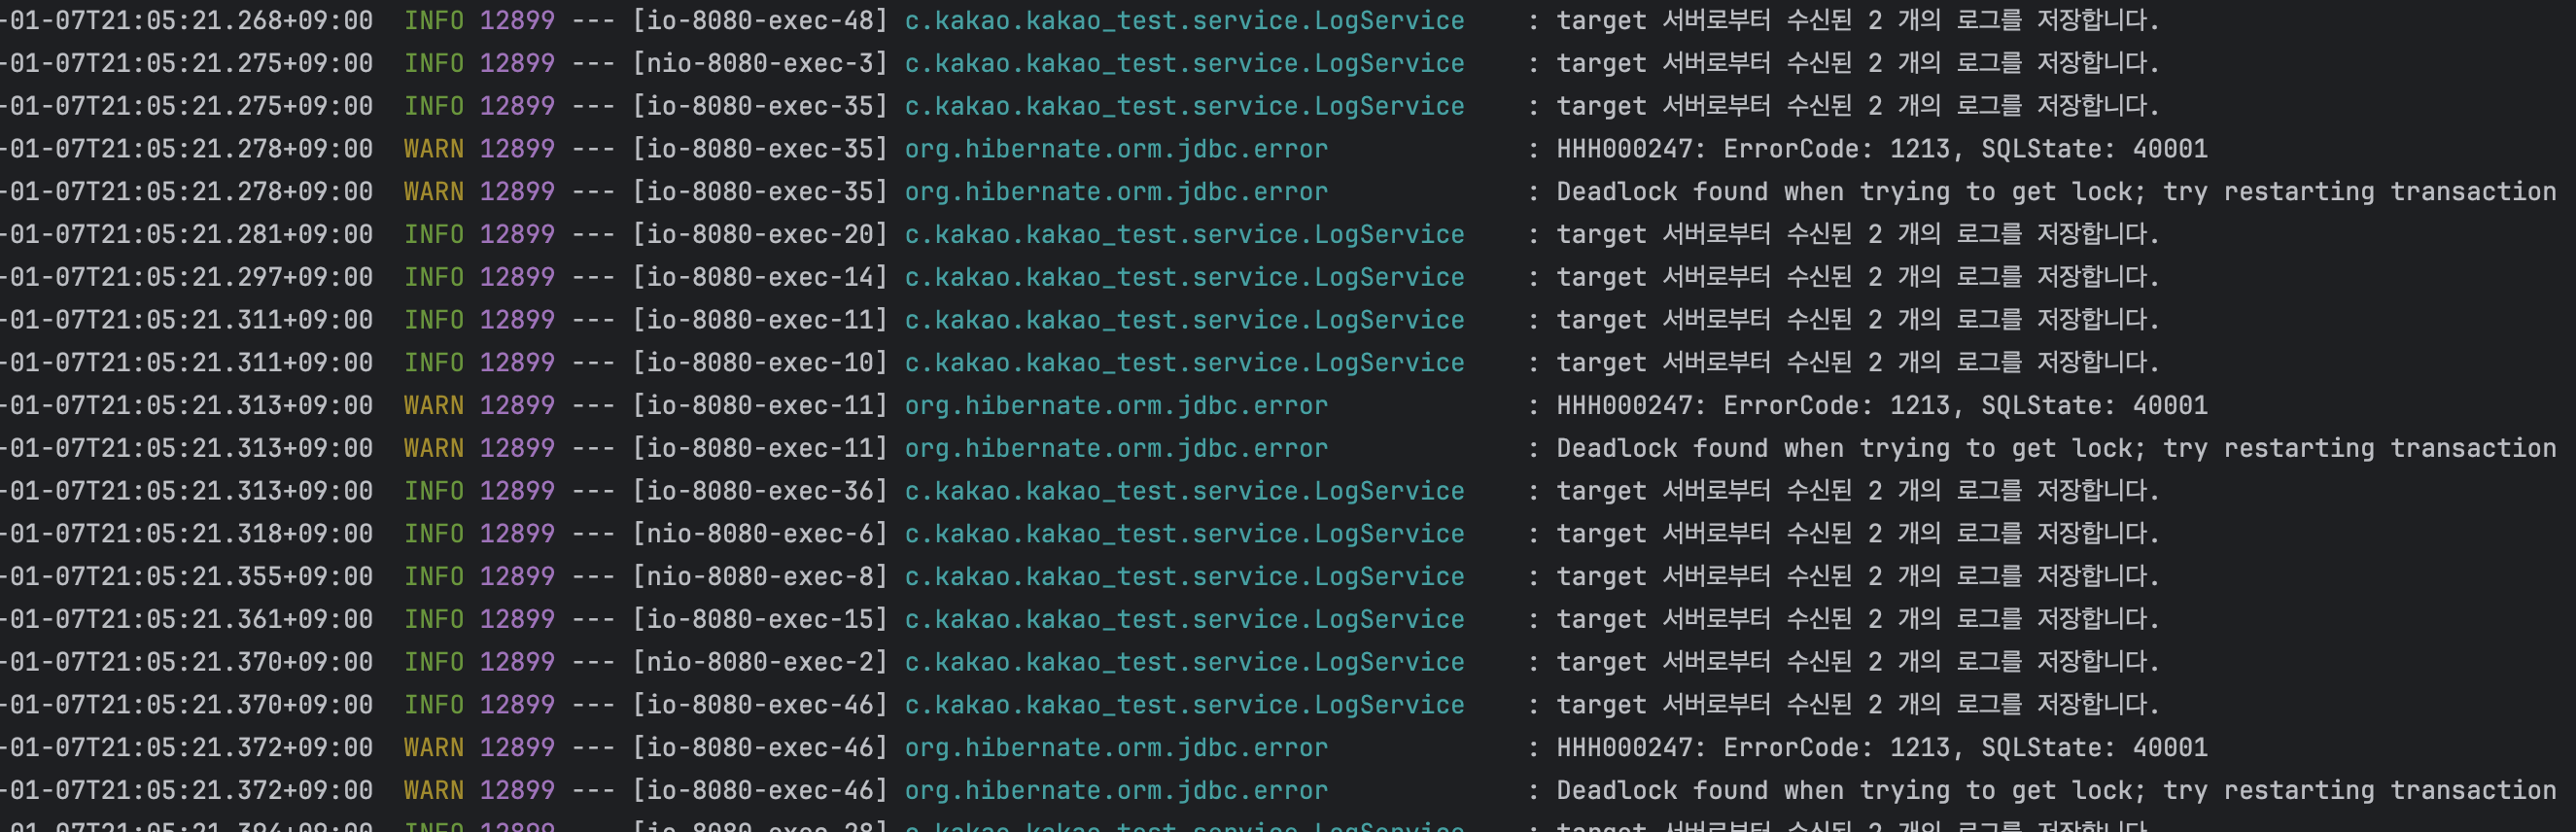
또한 로그를 확인해보니 DeadLock 발생이 정말 빈번히 발생했습니다.
DeadLock 발생 원인
발생 원인은 s-lock과 x-lock에 있습니다.
시나리오
(로그 저장의 테이블과 HeartBeat 갱신의 테이블은 별도입니다.)
(같은 서버의 로그를 수신할 경우입니다.)
스레드(A) 로그 수신 -> 스레드(B) 로그 수신 (A와 약 0.001초 차이) -> 스레드(A)의
server검증을 위한s-lock획득 -> 로그 저장 ->
스레드(A)의 HeartBeat 갱신을 위한s-lock -> x-lockPromotion 진행 -> 스레드(B)가s-lock을 가지고 있으므로 스레드(A)는 대기
-> 스레드(B) 도 로그 저장 후HeartBeat갱신을 위한x-lockPromotion 진행
-> 스레드(A), 스레드(B) 는 서로의s-lock을 포기하길 기다리며DeadLock발생!
즉, 읽기 락을 얻고 쓰기 락으로 Promotion 중 DeadLock이 발생했습니다.
해결 방법
-
HeartBeat의 로직을 맨 위로 옮기며 처음부터x-lock을 얻기.
문제점 : 처음부터x-lock을 잡을 경우 다른 요청들은s-lock을 얻지 못하므로 대기하며 처리량이 급속히 떨어짐. -
EventListener,kafka, rebbit MQ도입.
문제점 : Spring의 이벤트 리스너는 메모리를 많이 이용함, 메시지 큐 또한 관리 포인트의 증가 및 유지보수가 어려워짐.
또한, 아직MVP단계이므로 오버엔지니어링이 될 수 있음. -
다른 트렌젝션으로 분리.
로그 저장,HeartBeat갱신 로직을 서로 다른 트렌젝션에서 실행하면Target_server테이블의Lock은 로그 수신 트렌젝션에서는s-lock만 필요하고HeartBeat갱신 로직에는x-lock만 필요로 하므로DeadLock발생 조건을 피할 수 있습니다.
저는 빠른 해결 및 유지보수가 쉬운 3번을 택했습니다.
해결
해결 자체는 간단합니다.
HeartBeat 갱신 로직을 다른 트렌젝션으로 분리시키면 됩니다.
/**
     * 로그 수신(PUSH) 및 저장
     * 1. 토큰 검증
     * 2. DB 저장
     * 3. 에러 감지 시 카카오 알림
     */
    @Transactional
    public IngestResultDto ingestLogs(String serverName, String mcpToken, String discordWebhookUrl, List<LogEventDto> events) {
        TargetServer server = getServerOrThrow(serverName);
        verifyToken(server, mcpToken);

        if (events == null || events.isEmpty()) {
            return new IngestResultDto(serverName, 0, "수신할 로그가 없습니다.");
        }
        // 1. 하트비트 갱신 (x-lock 을 얻어야 하므로 다른 트렌젝션으로 빼며 데드락을 회피)
        serverHeartbeatService.updateHeartbeatQuickly(server.getId());

        // 2. DTO -> Entity 변환
        List<ServerLog> logsToSave = events.stream()
                .map(e -> ServerLog.builder()
                        .server(server)
                        .level(e.getLevel())
                        .message(e.getMessage())
                        .occurredAt(convertTimestamp(e.getTs()))
                        .build())
                .toList();

        log.info("{} 서버로부터 수신된 {} 개의 로그를 저장합니다.", serverName, logsToSave.size());
        // 3. DB 저장 (Batch Insert 효과)
        serverLogRepository.saveAll(logsToSave);

        ...
    }
HeartBeat 갱신 로직을 새로운 service로직으로 분리해야합니다.
분리하지 않고 같은
class의 메소드로 둘 경우 다른 트렌젝션으로 분리가 안됩니다.
@Service
@RequiredArgsConstructor
public class ServerHeartbeatService {

    private final TargetServerRepository targetServerRepository;

    /**
     * 부모 트랜잭션(ingestLogs)이 있더라도, 새로운 트렌젝션에서 수행.
     * 이 메서드가 끝나면 즉시 Commit 되고, X-Lock도 즉시 반납됨.
     */
    @Transactional(propagation = Propagation.REQUIRES_NEW)
    public void updateHeartbeatQuickly(Long serverId) {
        targetServerRepository.updateHeartbeatNow(serverId);
    }
}REQURIES_NEW를 통해 새로운 트렌젝션에서 실행하도록 합니다.
테스트
위와 같은 스크립트로 다시 테스트해봤습니다.
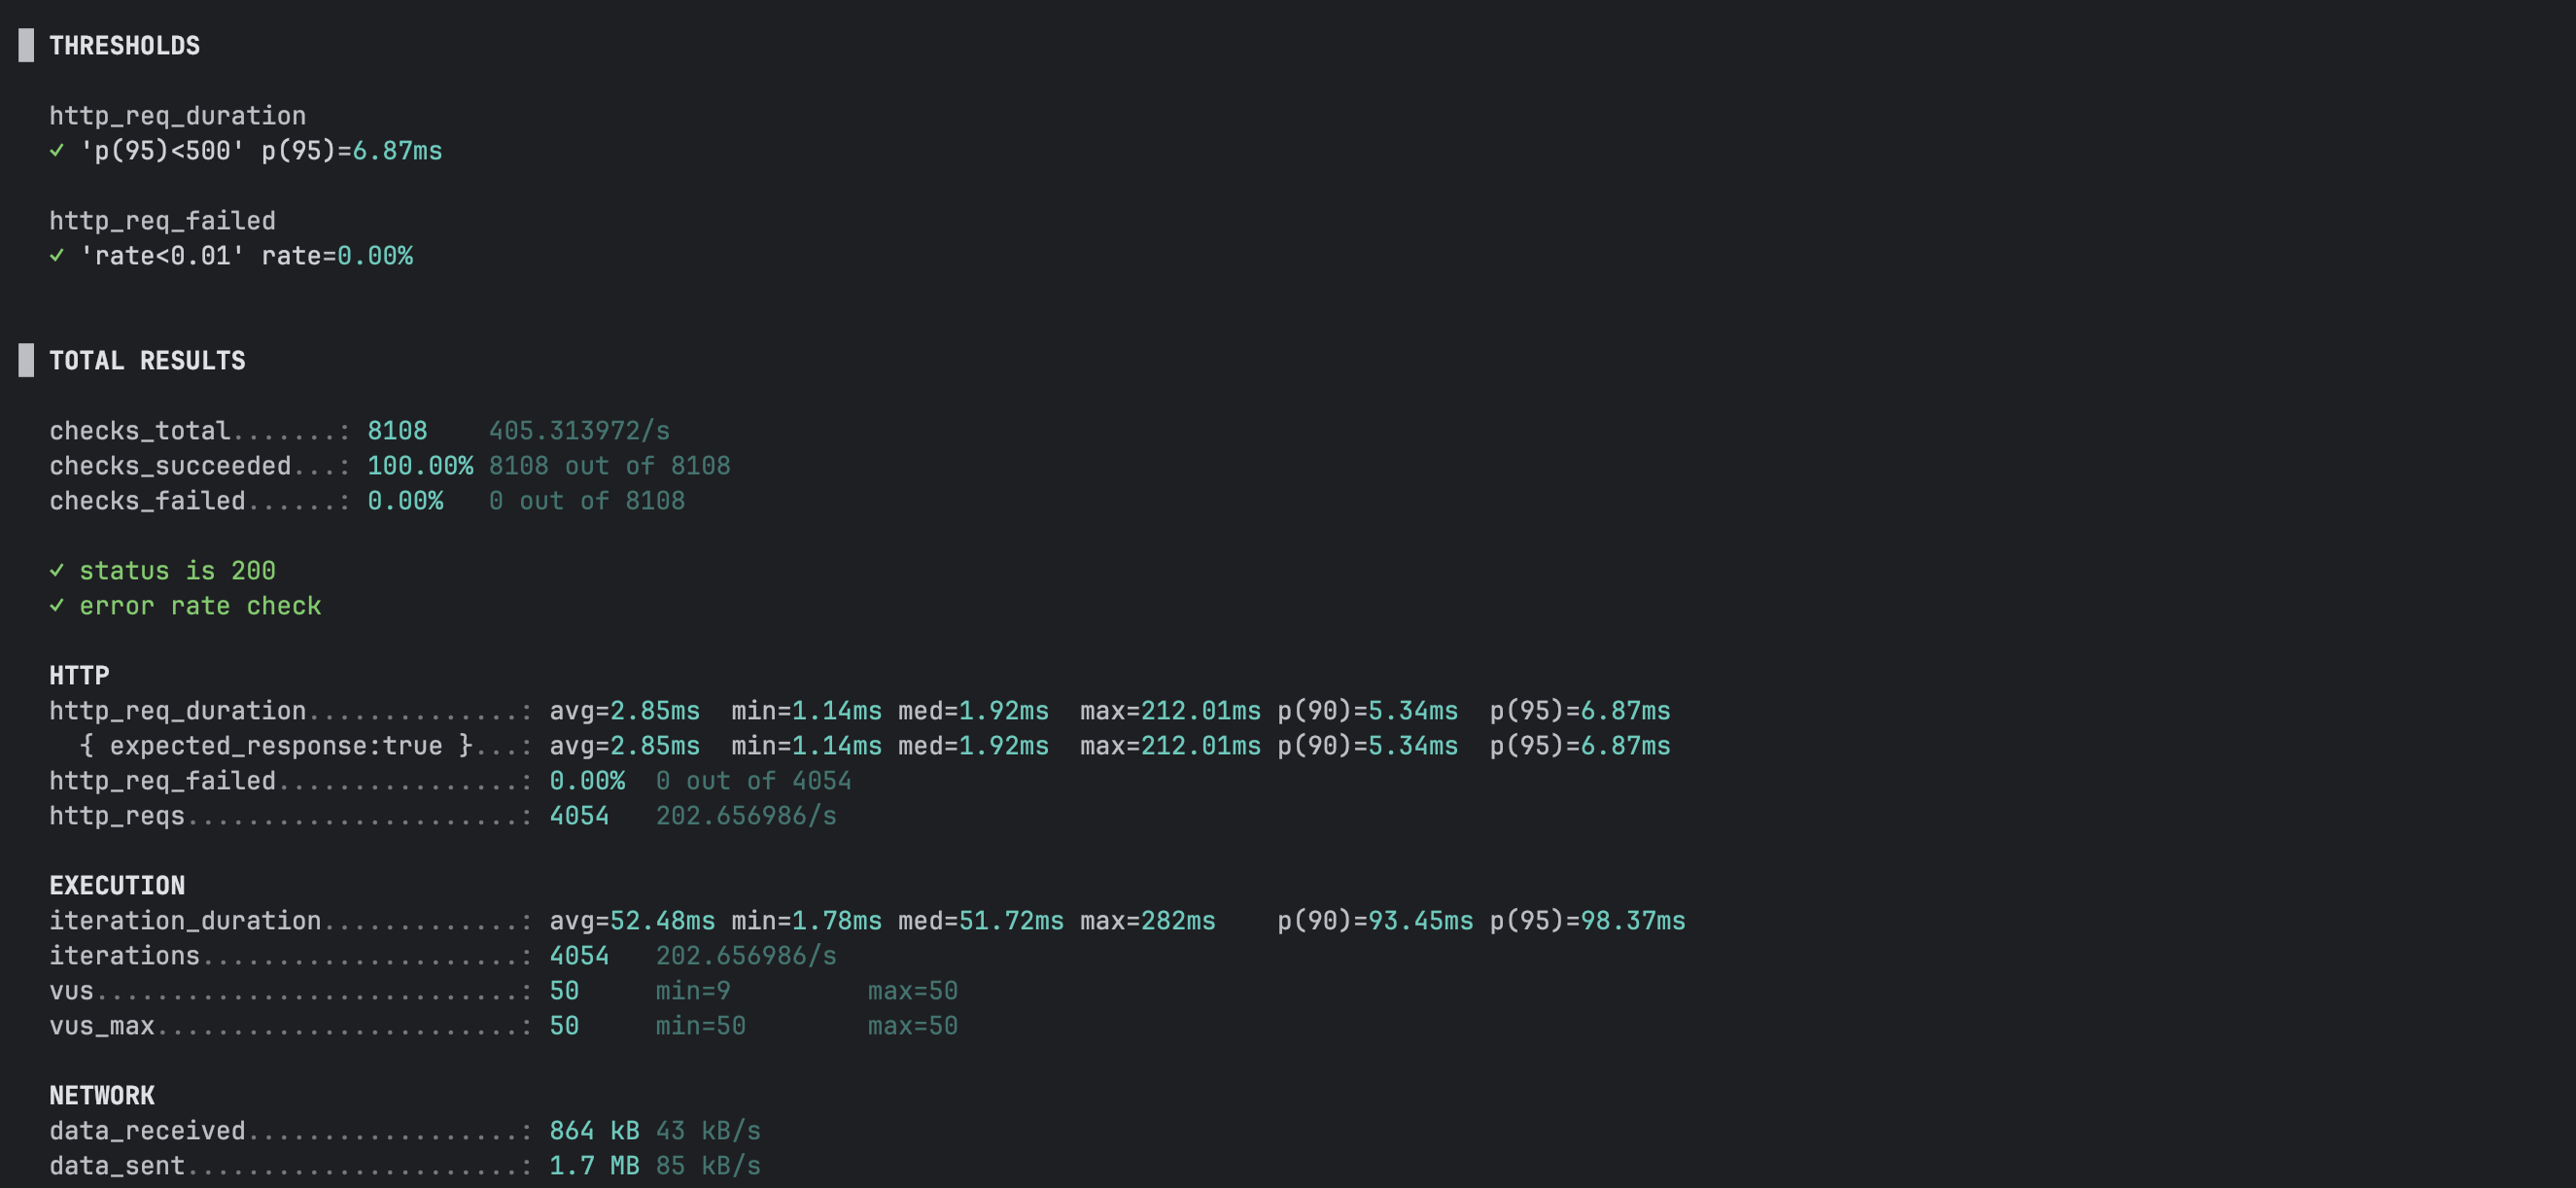
5초간 50개의 로그 수신을 10초간 유지하며 4054개의 요청을 100%로 처리했습니다.
또한, 처리 속도의 평균값이
2.85ms이므로 동시 접속자 50명까진 빠른 속도로 처리할 수 있습니다.
남아있는 문제점
트렌젝션 분리의 문제점이 남아있습니다.
DB커넥션 풀을 2개 이용.
로그 저장을 위한 커넥션 1개 +HeartBeat갱신을 위한 커넥션 1개 를 이용합니다.
->HeartBeat갱신을 위한 커넥션은 갱신만 하고 바로 반납하여 괜찮습니다.하지만, 찰나의 순간에 2개를 이용하게 되며 동시 접속 인원에서 문제가 생깁니다.
만약, 커넥션 풀이 10개이고 10명이 같은 시간에 로그를 수신할 경우 한번에 5명만 가능합니다.
또한, 로그 수신에 실패하더라도 HeartBeat 갱신에 성공해도 롤백되지 않습니다.
(하지만, 이 부분은 서버가 살아있다는 증거이므로 제 서비스에선 괜찮습니다.)
따라서, 서비스의 크기가 커지게되면 가장 먼저 비동기 / 메시지 큐로 바꾸는 전략을 택해야합니다.
결론
이 방식은 데드락은 완벽하게 잡았지만, 트랜잭션을 분리함에 따라 DB 커넥션을 2배로 점유한다는 단점이 있습니다. 현재는 트래픽이 적어 문제가 없지만, 추후 사용자가 급증하면 HikariCP 고갈(Pool Starvation)이 발생할 수 있습니다. 그때는 RabbitMQ나 Kafka를 도입하여 비동기 처리로 아키텍처를 고도화할 예정입니다.
개발 완료 후 설명 및 후기로 찾아오겠습니다!