1. 트리 순회와 무엇이 다른가
트리 순회는 규칙만 정하면 끝이었습니다. 왼쪽을 보고 자신을 보고 오른쪽을 보면 모든 노드를 한 번씩 지납니다. 같은 노드로 되돌아올 일이 없기 때문입니다.
그래프는 사이클이 있습니다. 1에서 2로 갔다가 3을 거쳐 다시 1로 돌아올 수 있습니다. 규칙만으로 돌면 같은 정점을 무한히 맴돕니다.
그래서 그래프 순회에는 반드시 "이미 방문했는가"를 기록하는 장치가 붙습니다. 방문한 정점에는 표시를 남기고, 표시가 있으면 들어가지 않습니다.
2. 깊이 우선이라는 전략
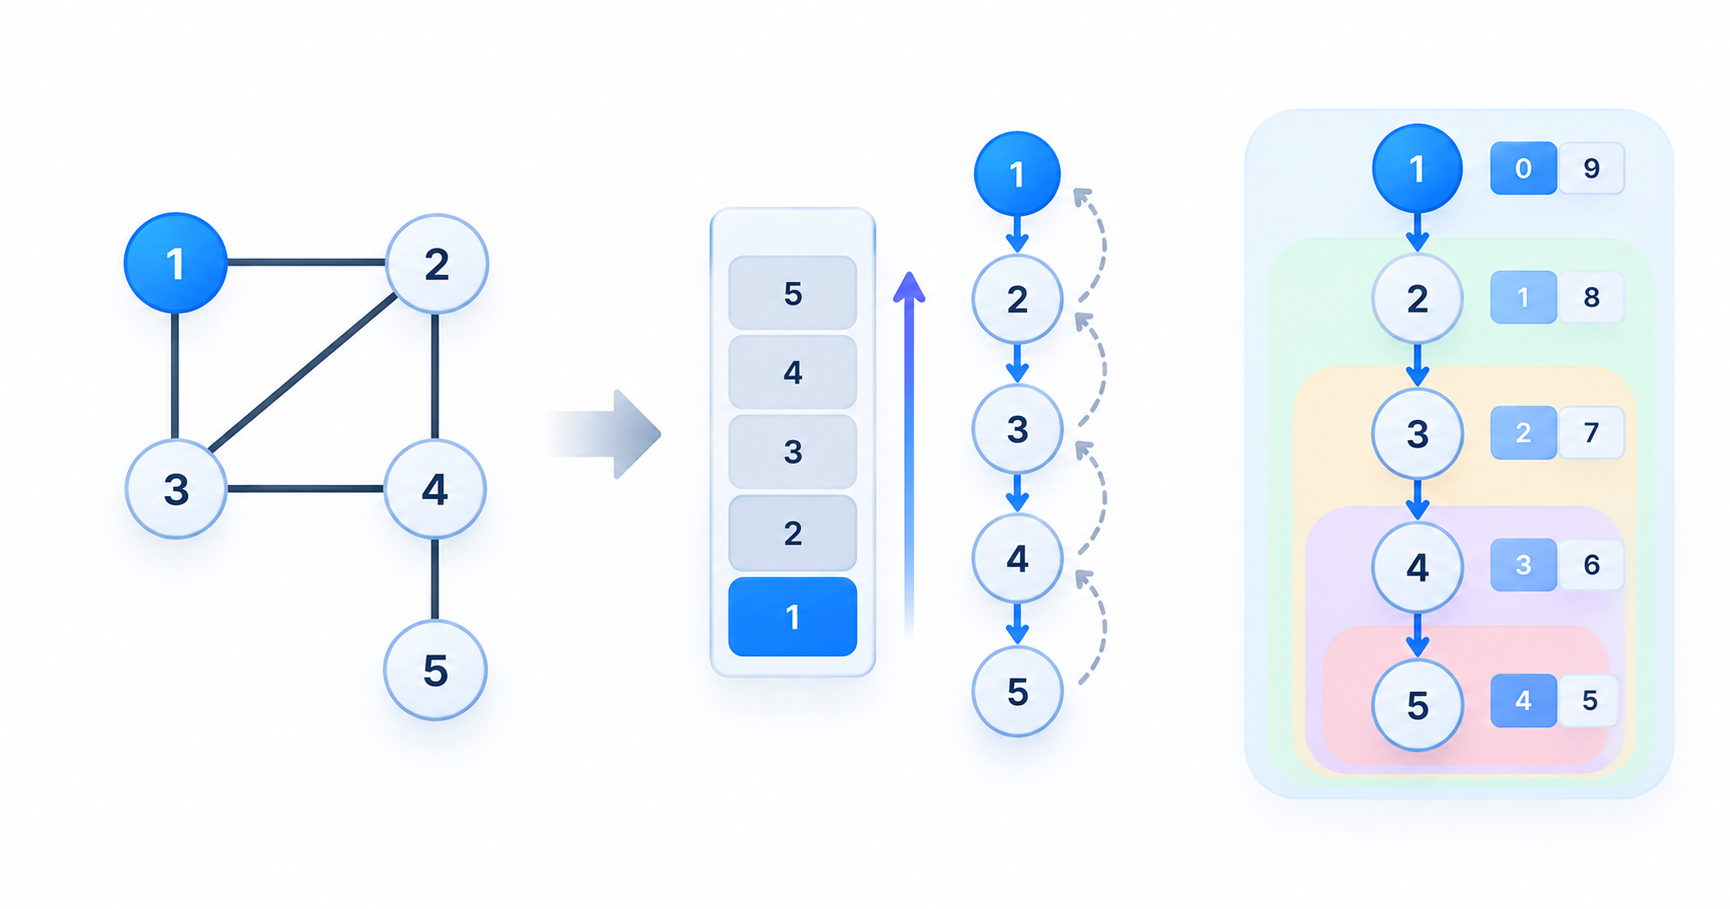
DFS는 갈 수 있는 데까지 깊이 들어갑니다. 더 갈 곳이 없으면 한 발 물러나 아직 안 가 본 갈래를 찾고, 거기서 다시 끝까지 들어갑니다.
      (1)---(2)
       |   / |
       |  /  |
      (3)---(4)
             |
            (5)

   인접 리스트
   1: 2, 3
   2: 1, 3, 4
   3: 1, 2, 4
   4: 2, 3, 5
   5: 4
1에서 출발하면 1 → 2 → 3 → 4 → 5 순서로 방문합니다. 2에서 1로 돌아가는 간선과 3에서 1, 2로 가는 간선은 이미 방문 표시가 있어 그냥 지나칩니다. 5에서 막히면 되돌아 나오는데, 그때는 모두 방문한 뒤라 그대로 끝납니다.
3. 구현
def dfs(v):
    global curr_time
    mark[v] = "visited"           # 방문 표시
    pre[v] = curr_time            # 들어온 시각
    curr_time += 1

    for w in G[v]:                # v의 이웃들
        if mark[w] != "visited":
            dfs(w)                # 아직 안 갔으면 들어간다

    post[v] = curr_time           # 빠져나온 시각
    curr_time += 1
for 루프가 v의 이웃을 훑는 부분입니다. 16편에서 인접 리스트가 유리하다고 한 작업이 바로 이것입니다. 인접 행렬이면 이웃이 아닌 칸까지 n개를 전부 확인해야 합니다.
재귀가 끝나고 돌아오는 것이 "한 발 물러나는" 동작에 해당합니다. 되돌아갈 자리를 따로 관리하지 않아도 되는 것은 03편의 콜 스택이 대신 기억해 주기 때문입니다.
그래프가 여러 덩어리로 나뉘어 있으면 한 번의 dfs로 전부 닿지 못합니다. 그래서 바깥에서 모든 정점을 돌며 아직 방문하지 않은 곳에서 다시 시작합니다.
for v in range(n):
    if mark[v] != "visited":
        dfs(v)
이 루프가 dfs를 부른 횟수가 그래프의 연결 요소 개수입니다.
4. 방문 시각 기록
pre[v]는 v에 들어간 시각, post[v]는 v에서 빠져나온 시각입니다. curr_time을 하나씩 올리며 찍습니다.
   방문 순서 1 -> 2 -> 3 -> 4 -> 5

   정점   pre   post
    1      0      9
    2      1      8
    3      2      7
    4      3      6
    5      4      5
이 두 숫자가 유용한 이유는 구간이 되기 때문입니다. v의 [pre, post] 구간 안에 w의 구간이 통째로 들어 있으면, w는 v에서 출발해 도달한 정점입니다. 두 구간이 겹치지 않으면 서로 다른 갈래에 있습니다. 구간은 포함하거나 떨어지거나 둘 중 하나이고, 절반만 겹치는 경우는 생기지 않습니다.
덕분에 "u가 v의 조상인가" 같은 질문에 숫자 두 개 비교로 답할 수 있습니다.
5. DAG와 사이클
방향 그래프 중 사이클이 없는 것을 DAG(directed acyclic graph)라고 합니다. 작업들 사이의 선후 관계, 빌드 의존성, 데이터 처리 파이프라인처럼 "A가 끝나야 B를 할 수 있다"는 관계가 DAG입니다. 사이클이 있으면 서로를 기다리게 되어 순서를 정할 수 없습니다.
DFS로 사이클이 있는지 판정할 수 있습니다. 아직 빠져나오지 않은 정점, 즉 지금 재귀 호출이 진행 중인 정점으로 돌아가는 간선을 만나면 사이클입니다. pre는 찍혔는데 post가 아직 비어 있는 정점이 그 조건에 해당합니다.
6. 시간복잡도
| 항목 | 인접 리스트 | 인접 행렬 |
|---|---|---|
| DFS 전체 | O(n + m) | O(n²) |
| 정점 하나 처리 | O(deg(v)) | O(n) |
추가 메모리 (mark, pre, post) | O(n) | O(n) |
| 재귀 호출 스택 | O(n) | O(n) |
각 정점을 한 번씩 방문하고 각 간선을 양쪽에서 한 번씩 확인하므로 O(n+m)입니다. 간선이 적은 그래프라면 이 차이가 큽니다.