1. 필요할 때만 올린다
프로그램을 실행할 때 주소 공간 전체를 메모리에 올릴 필요는 없습니다. 오류 처리 코드처럼 한 번도 실행되지 않는 부분이 많기 때문입니다.
요구 페이징(demand paging)은 페이지가 실제로 참조될 때 메모리에 올리는 방식입니다. 얻는 것이 분명합니다.
- 메모리에 올리는 양이 줄어 더 많은 프로세스를 동시에 띄울 수 있습니다
- 디스크 입출력이 줄고 프로그램 시작이 빨라집니다
- 물리 메모리 크기보다 큰 프로그램도 실행할 수 있습니다
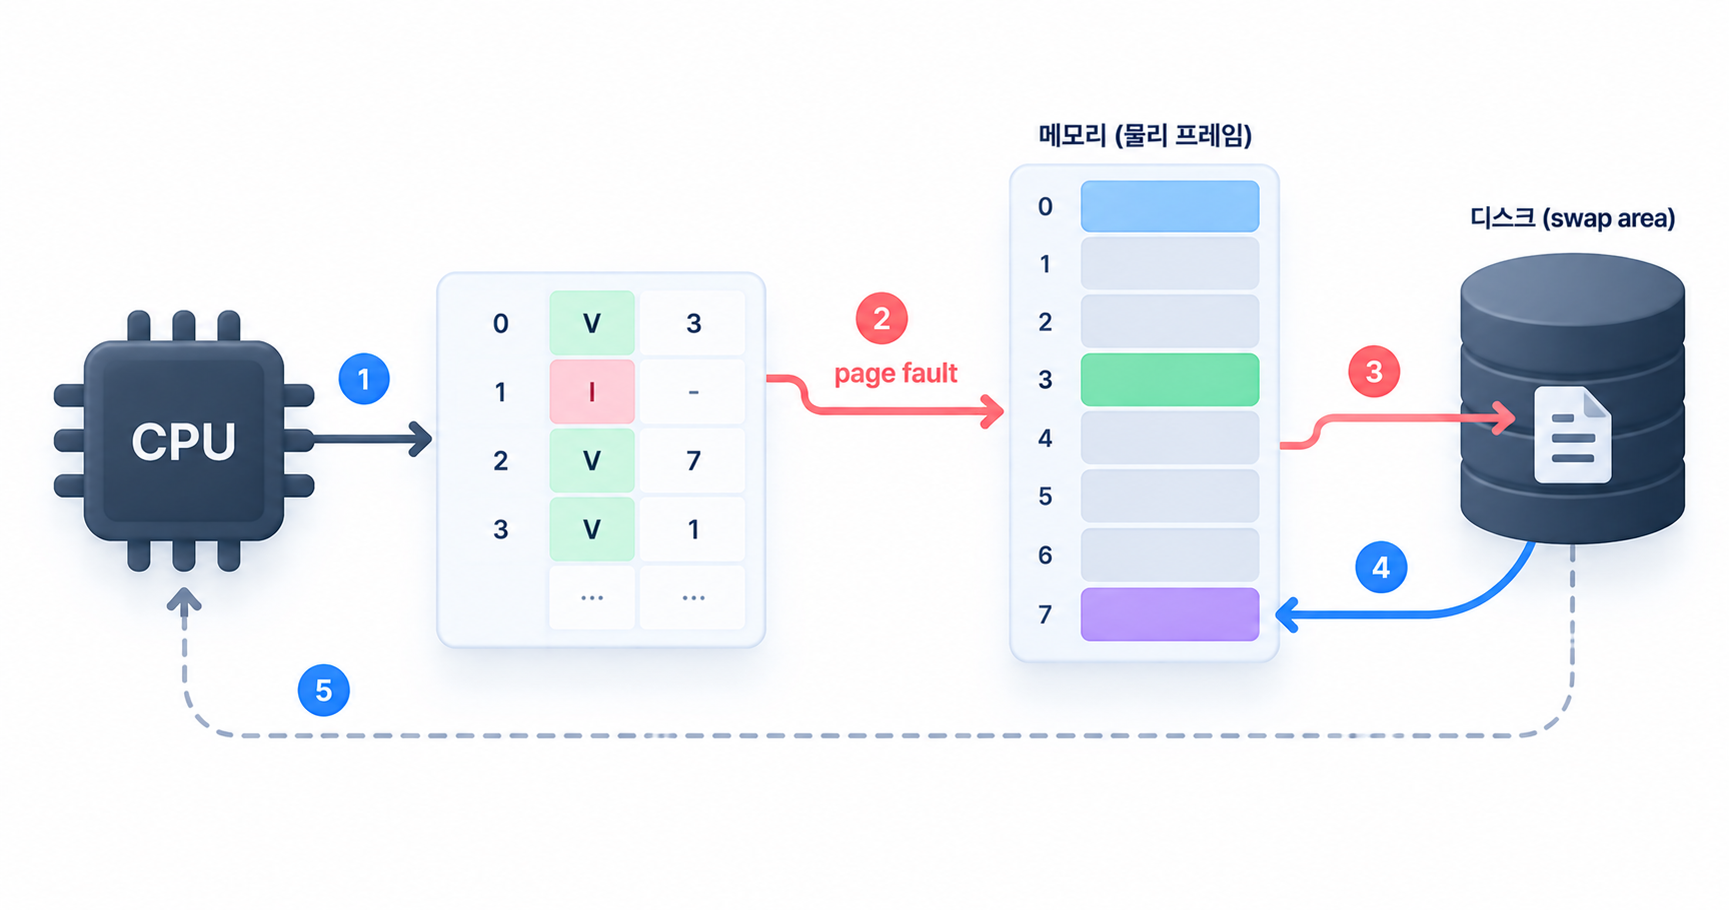
구분은 valid-invalid bit으로 합니다. 메모리에 올라와 있으면 valid, 디스크에 있거나 안 쓰는 영역이면 invalid입니다.
2. page fault
CPU가 invalid인 페이지를 참조하면 page fault가 발생합니다. 주소 변환은 하드웨어가 하다가 멈추고, 이때부터는 운영체제가 처리합니다.
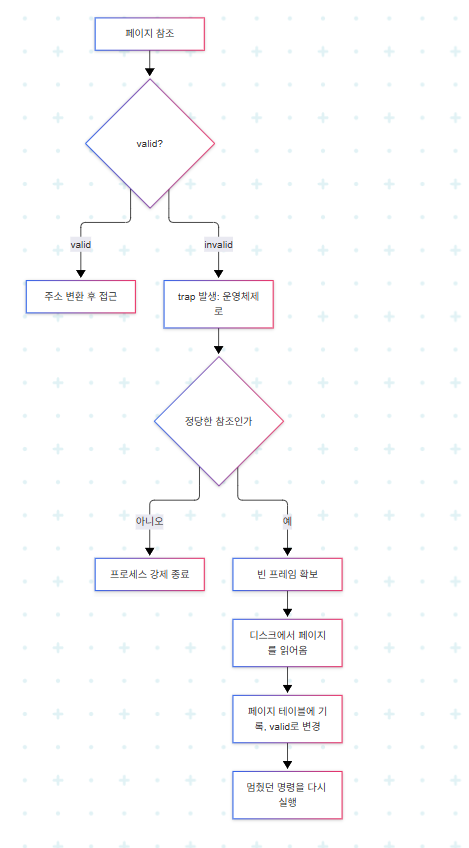
중요한 점은 마지막 단계입니다. 중단된 명령을 처음부터 다시 실행합니다. 그리고 디스크 입출력이 끼어 있으므로 그동안 그 프로세스는 Blocked 상태가 되고 CPU는 다른 프로세스에게 갑니다.
3. 비용은 얼마나 큰가
page fault가 얼마나 자주 나는지를 page fault rate라고 하며 0과 1 사이 값입니다. 0이면 한 번도 발생하지 않는 것이고 1이면 모든 참조에서 발생하는 것입니다.
작은 예제
메모리 접근이 100ns, page fault 한 번 처리에 8ms(= 8,000,000ns)가 든다고 합시다. 디스크가 끼어 있어서 자릿수가 다릅니다.
- page fault가 없을 때: 100ns
- page fault rate가 0.1%(p = 0.001)일 때:
EAT = (0.999 × 100) + (0.001 × 8,000,000) = 99.9 + 8,000 = 약 8,100ns - 1000번에 한 번 틀렸을 뿐인데 평균 접근 시간이 80배가 됐습니다
결론은 하나입니다. page fault는 어쩌다 한 번도 비싸기 때문에, 발생 횟수를 줄이는 것이 전부입니다.
4. 빈 프레임이 없다면
2절의 "빈 프레임 확보" 단계에서 free frame이 하나도 없을 수 있습니다. 그러면 메모리에 있는 페이지 중 하나를 골라 쫓아내야 합니다. 이것이 페이지 교체(page replacement)이고, 무엇을 쫓아낼지 정하는 것이 교체 알고리즘입니다.
목표는 page fault rate를 최소화하는 것입니다. 3절의 숫자가 이유입니다.
아래 예제는 모두 같은 참조열을 씁니다.
1 2 3 4 1 2 5 1 2 3 4 5Optimal 알고리즘은 가장 먼 미래에 참조될 페이지를 쫓아냅니다. 이 참조열에 프레임 3개로 적용하면 page fault가 7번으로, 어떤 알고리즘도 이보다 적을 수 없습니다. 다만 미래의 참조를 미리 알아야 하므로 실제 시스템에서는 쓸 수 없습니다. 다른 알고리즘이 얼마나 잘하는지 재는 기준(offline 알고리즘)으로만 씁니다. MIN, OPT, Belady의 알고리즘이라고도 부릅니다.
FIFO는 가장 먼저 들어온 페이지를 쫓아냅니다. 구현이 쉽지만 "오래 전에 들어왔지만 계속 쓰이는 페이지"도 그냥 내보냅니다. 프레임 3개로 돌리면 page fault가 9번입니다.
작은 예제 (Belady's anomaly)
보통 프레임을 늘리면 page fault가 줄어야 합니다. FIFO로 같은 참조열을 프레임 4개에 돌려 봅니다.
| 참조 | 3개 프레임 | 3개 결과 | 4개 프레임 | 4개 결과 |
|---|---|---|---|---|
| 1, 2, 3 | 채움 | fault 3 | 채움 | fault 3 |
| 4 | 1을 쫓아냄 | fault | 그냥 채움 | fault |
| 1 | fault | fault | 있음 | hit |
| 2 | fault | fault | 있음 | hit |
| 5 | fault | fault | 1을 쫓아냄 | fault |
| 1, 2 | 있음 | hit 2회 | 모두 쫓겨남 | fault 2회 |
| 3, 4, 5 | 2회 fault | - | 모두 fault | fault 3회 |
| 합계 | 9번 | 10번 |
프레임을 늘렸는데 page fault가 더 늘었습니다. 이 현상을 Belady의 이상 현상(Belady's anomaly)이라고 하며 FIFO에서 나타납니다.
5. LRU와 LFU
미래를 모르니 과거를 보고 추측합니다. 보는 방향이 둘입니다.
- LRU(Least Recently Used): 가장 오래 전에 참조된 페이지를 쫓아냅니다. 최근에 쓴 것은 또 쓸 가능성이 높다는 가정입니다
- LFU(Least Frequently Used): 참조 횟수가 가장 적은 페이지를 쫓아냅니다. 자주 쓰인 것은 또 쓰일 가능성이 높다는 가정입니다
둘 다 완벽하지 않습니다. LRU는 방금 한 번 참조된 페이지를 무조건 살려 두므로, 어쩌다 한 번 쓰인 페이지가 자리를 차지합니다. LFU는 횟수만 보므로 옛날에 많이 쓰이고 지금은 안 쓰는 페이지가 계속 남습니다. 반대로 방금 올라온 페이지는 횟수가 적어 바로 쫓겨납니다.
6. 구현과 시간 복잡도
두 알고리즘은 자료구조에서도 갈립니다.
LRU는 참조 시각 순으로 이어진 연결 리스트를 씁니다. 페이지가 참조되면 그 노드를 떼어 맨 뒤로 보내면 끝이고, 쫓아낼 때는 맨 앞을 꺼냅니다. O(1)입니다.
LFU는 그렇게 되지 않습니다. 참조 횟수가 1 늘면 그 페이지가 리스트의 어디로 가야 하는지 다시 찾아야 하므로 연결 리스트로는 O(n)입니다. 그래서 횟수를 기준으로 하는 힙(heap)으로 구현해 O(log n)으로 줄입니다. LRU보다 구현이 복잡하고 비용이 큰 이유입니다.
7. 알고리즘 비교
| 알고리즘 | 쫓아내는 기준 | 장점 | 단점 | 구현 비용 |
|---|---|---|---|---|
| Optimal | 가장 먼 미래에 쓰일 페이지 | 이론상 최소 fault | 실제 사용 불가 | - |
| FIFO | 가장 먼저 들어온 페이지 | 단순함 | 자주 쓰는 페이지도 쫓아냄, Belady's anomaly | 낮음 |
| LRU | 가장 오래 전에 참조된 페이지 | 지역성을 잘 반영 | 한 번 쓴 페이지도 살려 둠 | O(1) |
| LFU | 참조 횟수가 가장 적은 페이지 | 장기적 인기를 반영 | 과거 인기에 집착, 새 페이지에 불리 | O(log n) |