1. 설계 없이 CREATE TABLE부터 쓰면
앞 편까지는 student, department, course, enroll이 주어진 상태에서 질의만 썼습니다. 그런데 이 네 테이블은 어디서 나왔을까요. 요구사항을 듣자마자 CREATE TABLE부터 쓰면, 빠진 요구사항은 데이터가 쌓인 뒤에야 드러나고 그때는 테이블 구조를 바꾸는 비용이 이미 커져 있습니다.
데이터베이스 설계(database design)는 한 조직체의 운영과 목적을 지원하기 위해 데이터베이스를 생성하는 과정입니다. 핵심은 테이블을 만들기 전에 "무엇을 저장해야 하는가"를 DBMS와 무관한 언어로 먼저 확정하는 데 있습니다.
2. 요구사항에서 찾아내는 네 가지
요구사항을 분석할 때는 다음 네 가지를 뽑아냅니다. 공통 스키마의 학사 시스템을 예로 들면 이렇습니다.
| 항목 | 의미 | 학사 시스템 예 |
|---|---|---|
| 엔티티(entity) | 데이터베이스에 나타내려는 객체 | 학생, 학과, 과목 |
| 관계(relationship) | 엔티티들 사이의 연관 | 학생은 학과에 소속된다 |
| 프로세스(process) | 관련 업무 활동 | 수강신청, 성적 입력 |
| 무결성 제약조건(integrity constraint) | 데이터의 정확성, 비즈니스 규칙 | 학년은 1~4, 학기당 18학점 이하 |
무결성 제약조건은 결국 CHECK, 외래키, 트리거로 구현됩니다(2·3편). 요구사항 단계에서 빠뜨리면 구현 단계에서 넣을 방법이 없습니다.
3. 설계 과정 여덟 단계
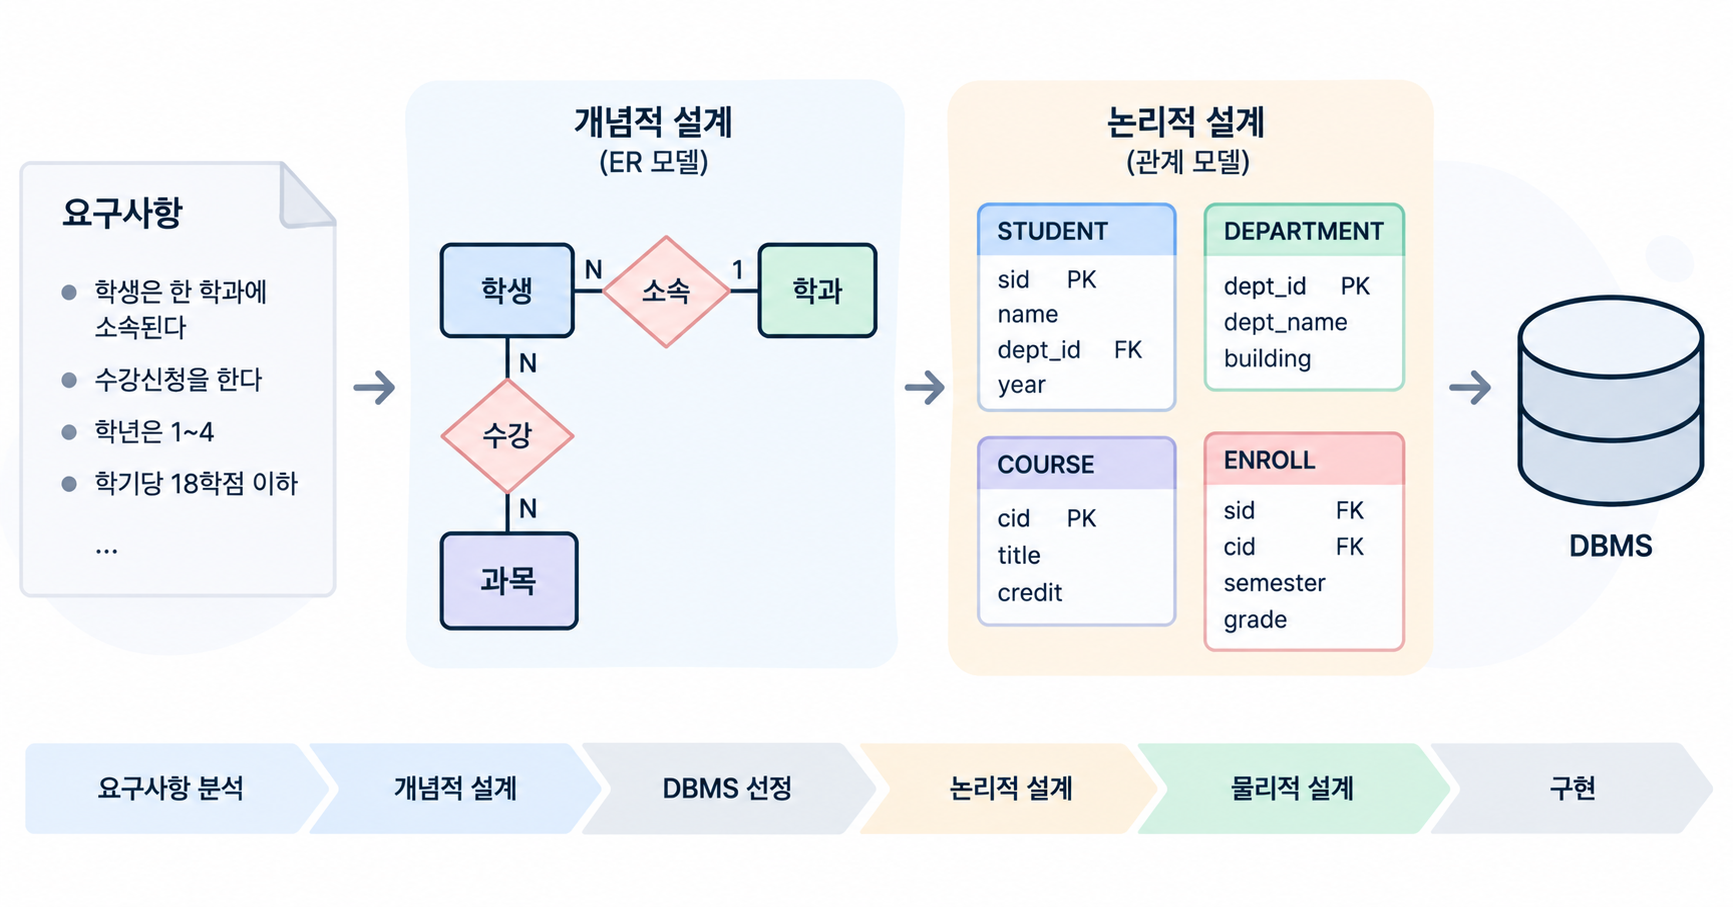
설계는 크게 개념적 설계, 논리적 설계, 물리적 설계로 나뉘고, 세부적으로는 여덟 단계를 거칩니다. 같은 요구사항 한 줄이 단계마다 어떻게 모습을 바꾸는지 따라가 보겠습니다.
| 단계 | 산출물 | "학생은 한 학과에 소속된다" | DBMS |
|---|---|---|---|
| 요구사항 분석 | 요구사항 명세 | 문장 그대로 | 독립 |
| 개념적 설계 | 개념적 스키마 | 학생 —소속— 학과 | 독립 |
| DBMS 선정 | 데이터 모델 결정 | 관계 모델 선택 | - |
| 논리적 설계 | 논리적 스키마 | student.dept_id가 department 참조 | 의존 |
| 스키마 정제 | 정제된 스키마 | 중복·이상 현상 점검 (7편) | 의존 |
| 물리적 설계 | 물리적 스키마 | dept_id 인덱스, 파일 조직 (5·6편) | 의존 |
| 보안 설계 | 권한 설계 | 학과 조교는 자기 학과만 조회 | 의존 |
| 구현 | DDL, 초기 데이터 | FOREIGN KEY ... REFERENCES | 의존 |
경계는 DBMS 선정입니다. 개념적 설계까지는 어떤 DBMS를 쓸지 몰라도 되고, 논리적 설계부터는 선택한 데이터 모델에 묶입니다. 단계는 한 방향으로만 흐르지 않고, 뒤에서 문제가 발견되면 앞 단계로 돌아가 고칩니다.
4. ER 모델: 엔티티와 엔티티 타입
개념적 설계에는 DBMS와 무관한 표현 수단이 필요합니다. 관계 모델의 테이블로 바로 그리면 이미 논리적 설계를 하고 있는 셈이기 때문입니다. ER 모델(Entity-Relationship model)은 데이터베이스 설계를 쉽게 하려고 제안된 모델로, 1976년 피터 첸(Peter Chen)이 발표했습니다. 실세계를 엔티티와 관계의 모임으로 보는 관점입니다.
엔티티는 서로 구분되면서, 조직체가 데이터베이스에 나타내려는 객체입니다. 김민수라는 학생 한 명, 데이터베이스라는 과목 하나가 각각 엔티티입니다.
엔티티들은 엔티티 타입(entity type)으로 묶입니다. 같은 애트리뷰트(학번, 이름, 학년)를 갖는 엔티티들의 집합이 "학생" 엔티티 타입입니다. 1편의 릴레이션 스키마와 인스턴스의 관계와 같은 구도입니다. 엔티티 타입이 틀이고, 엔티티가 그 틀에 들어가는 개별 값입니다.
5. 관계
관계는 두 개 이상의 엔티티 사이의 연관입니다. 학생과 과목 사이의 "수강", 학생과 학과 사이의 "소속"이 여기에 해당합니다. 공통 스키마를 ER 관점으로 다시 그리면 다음과 같습니다.
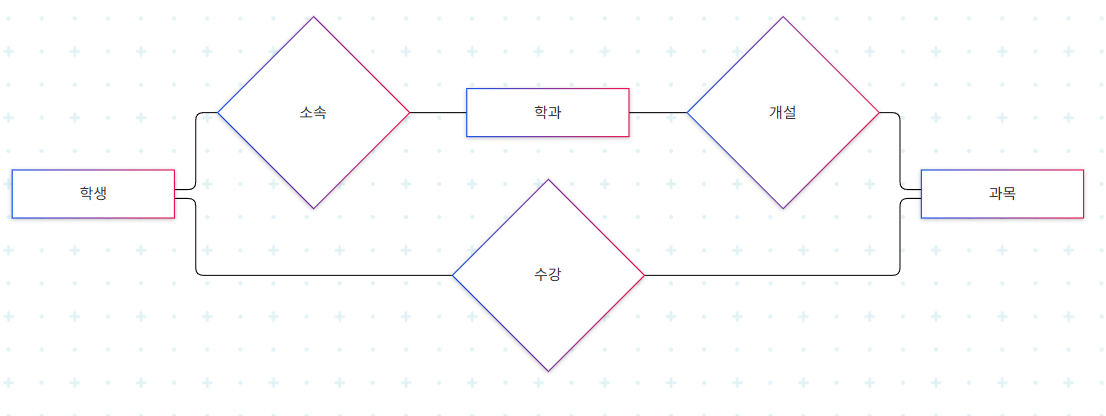
사각형이 엔티티 타입, 마름모가 관계입니다. 여기서 눈여겨볼 점은 앞 편의 enroll 테이블이 엔티티가 아니라 "수강"이라는 관계에서 나왔다는 사실입니다.